
Last chance! 50% off DataCamp Premium
Sale ends in
Tutorial ini akan memandu Anda melalui beberapa konsep dan langkah dasar untuk persiapan data. Persiapan data adalah langkah pertama setelah Anda mendapatkan dataset apa pun. Ini adalah langkah saat Anda memproses data mentah menjadi bentuk yang mudah dan akurat untuk dianalisis. Persiapan data yang tepat memungkinkan analisis yang efisien — dapat menghilangkan kesalahan dan ketidakakuratan yang mungkin terjadi selama proses pengumpulan data dan dengan demikian membantu mengurangi sebagian bias akibat kualitas data yang buruk. Karena itu, banyak waktu analis dihabiskan pada langkah penting ini.
Memuat data, membersihkan data (menghapus data yang tidak perlu atau keliru), mengubah format data, dan menata ulang data adalah berbagai langkah yang terlibat dalam persiapan data. Dalam tutorial ini, Anda akan bekerja dengan pustaka Pandas di Python untuk persiapan data.
Pastikan Anda memahami konsep seperti Pandas DataFrame, Series, dan sebagainya karena Anda akan sering membacanya di tutorial ini. Anda dapat mempelajari pandas lebih mendalam di tutorial Pandas dari DataCamp.
Dalam tutorial ini:
Sepanjang jalan, ada beberapa tips, trik, dan juga rujukan ke materi mendalam lainnya jika Anda ingin menggali lebih jauh suatu topik.
Mari mulai dengan pengantar singkat tentang Pandas...
Pandas adalah pustaka perangkat lunak yang ditulis untuk Python. Pustaka ini sangat populer di komunitas data science karena menawarkan struktur data yang andal, ekspresif, dan fleksibel yang memudahkan manipulasi serta analisis data DAN tersedia secara gratis. Selain itu, jika Anda memiliki use case yang spesifik dan baru, Anda bahkan dapat membagikannya di salah satu milis Python atau di situs GitHub pandas — faktanya, sebagian besar fungsionalitas di pandas didorong oleh use case dunia nyata.
Untuk pengantar yang sangat baik tentang pandas, pastikan untuk melihat kursus Pandas Foundation dari DataCamp. Kursusnya sangat interaktif, dan bab pertama gratis!
Untuk menggunakan pustaka pandas, Anda perlu mengimpornya terlebih dahulu. Cukup ketik ini di konsol Python Anda:
import pandas as pdLangkah pertama persiapan data adalah... ya, mendapatkan data. Jika Anda memiliki file .csv, Anda dapat dengan mudah memuatnya ke sistem Anda menggunakan fungsi .read_csv() di pandas. Anda kemudian dapat mengetik:
data = pd.read_csv('path_to_file.csv')
Namun, untuk tutorial ini, Anda akan bekerja dengan beberapa DataFrame dan Series yang lebih kecil dan mudah dipahami yang dibuat secara langsung.
Ini adalah masalah yang sangat umum di dunia analisis data.
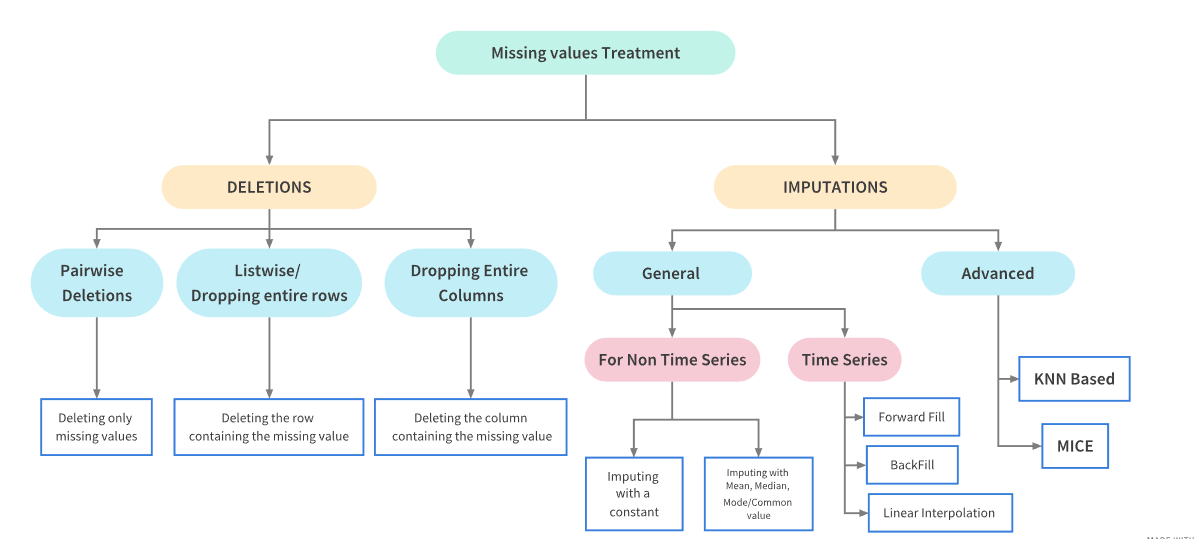
Data hilang dapat muncul di dataset karena berbagai alasan: data untuk field tertentu tidak ditambahkan oleh pengguna/aplikasi pengumpulan data, data hilang saat transfer manual, kesalahan pemrograman, dan lain-lain. Terkadang penting untuk memahami penyebabnya karena hal ini akan memengaruhi cara Anda menangani data tersebut. Namun ini akan dibahas nanti dalam tutorial ini. Untuk saat ini, mari fokus pada apa yang harus dilakukan jika Anda memiliki data hilang...
Untuk data numerik, pandas menggunakan nilai floating point NaN (Not a Number) untuk merepresentasikan data hilang. Ini adalah nilai unik yang didefinisikan oleh pustaka Numpy sehingga kita juga perlu mengimpornya. NaN adalah penanda nilai hilang default karena alasan kecepatan komputasi dan kemudahan. Ini adalah nilai sentinel, dalam arti nilai dummy atau flag yang dapat dengan mudah dideteksi dan diolah menggunakan fungsi di pandas.
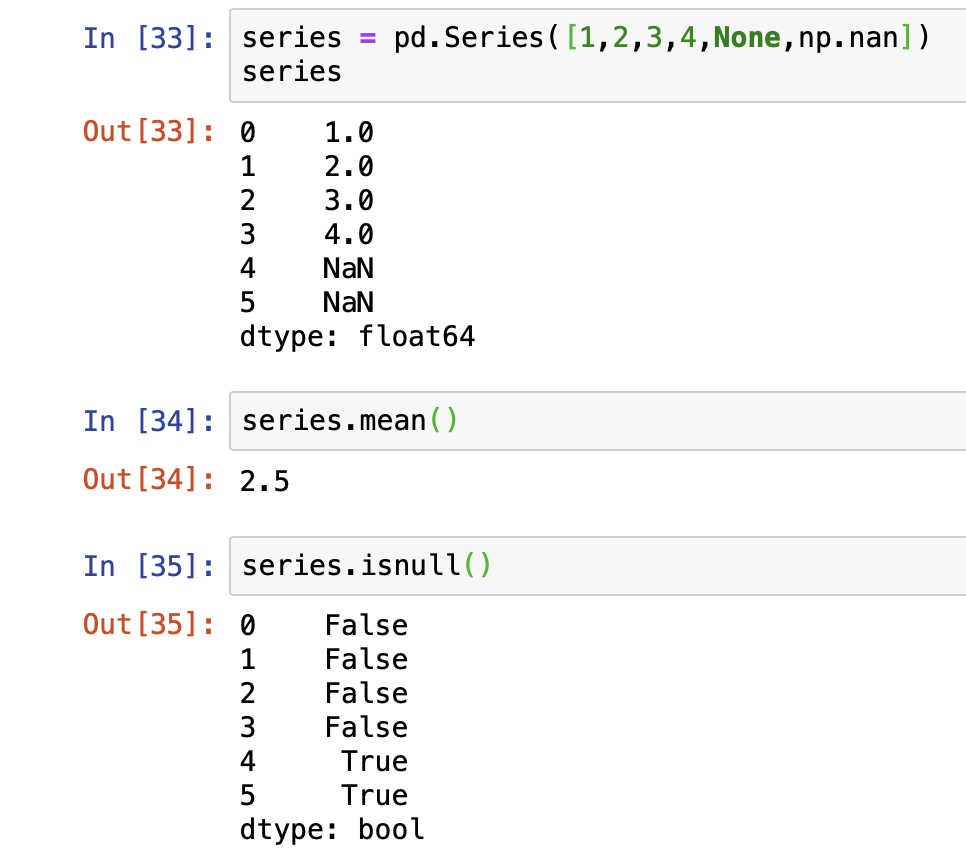
Mari bermain dengan sedikit data...
import numpy as np

# Creating a pandas series
data = pd.Series([0, 1, 2, 3, 4, 5, np.nan, 6, 7, 8])

# To check if and what index in the dataset contains null value
data.isnull()
0    False
1    False
2    False
3    False
4    False
5    False
6     True
7    False
8    False
9    False
dtype: bool
Di atas, kita menggunakan fungsi isnull() yang mengembalikan nilai boolean true atau false. True, ketika data pada indeks tertentu benar-benar hilang atau NaN. Kebalikannya adalah fungsi notnull().
# To check where the dataset does not contain null value - opposite of isnull()
data.notnull()
0     True
1     True
2     True
3     True
4     True
5     True
6    False
7     True
8     True
9     True
dtype: bool
Selain itu, kita dapat menggunakan fungsi dropna() untuk menyaring data hilang dan menghapus nilai null (hilang) dan hanya melihat nilai non-null. Namun, nilai NaN sebenarnya tidak benar-benar dihapus dan masih dapat ditemukan di dataset asli.
# Will not show the index 6 cause it contains null (NaN) value
data.dropna()
0    0.0
1    1.0
2    2.0
3    3.0
4    4.0
5    5.0
7    6.0
8    7.0
9    8.0
dtype: float64
data
0    0.0
1    1.0
2    2.0
3    3.0
4    4.0
5    5.0
6    NaN
7    6.0
8    7.0
9    8.0
dtype: float64
Yang dapat Anda lakukan untuk benar-benar "menghapus" atau menghilangkan nilai NaN adalah menyimpan dataset baru (tanpa NaN) agar Series data asli tidak diutak-atik atau menerapkan drop secara inplace. Argumen inplace memiliki nilai default false.
not_null_data = data.dropna()
not_null_data
0    0.0
1    1.0
2    2.0
3    3.0
4    4.0
5    5.0
7    6.0
8    7.0
9    8.0
dtype: float64
# Drop the 6th index in the original 'data' since it has a NaN place
data.dropna(inplace = True)
data
0    0.0
1    1.0
2    2.0
3    3.0
4    4.0
5    5.0
7    6.0
8    7.0
9    8.0
dtype: float64
Namun, dataframe bisa lebih kompleks dan berdimensi 2, artinya berisi baris dan kolom. Pandas tetap mendukung Anda...
# Creating a dataframe with 4 rows and 4 columns (4*4 matrix)
data_dim = pd.DataFrame([[1,2,3,np.nan],[4,5,np.nan,np.nan],[7,np.nan,np.nan,np.nan],[np.nan,np.nan,np.nan,np.nan]])
data_dim
| 0 | 1 | 2 | 3 | |
|---|---|---|---|---|
| 0 | 1.0 | 2.0 | 3.0 | NaN |
| 1 | 4.0 | 5.0 | NaN | NaN |
| 2 | 7.0 | NaN | NaN | NaN |
| 3 | NaN | NaN | NaN | NaN |
Sekarang misalnya Anda hanya ingin menghapus baris atau kolom yang semuanya null atau hanya yang berisi sejumlah nilai null tertentu. Perhatikan berbagai skenario berikut, ingat bahwa penghapusan tidak terjadi secara inplace, sehingga dataset sebenarnya tidak diutak-atik. Perhatikan argumen yang diteruskan ke fungsi dropna() untuk menentukan bagaimana Anda menghapus data hilang.
# Drop all rows and columns containing NaN value
data_dim.dropna()
| 0 | 1 | 2 | 3 |
|---|
# Drop all rows and columns containing entirely of NaN value
data_dim.dropna(how = 'all')
| 0 | 1 | 2 | 3 | |
|---|---|---|---|---|
| 0 | 1.0 | 2.0 | 3.0 | NaN |
| 1 | 4.0 | 5.0 | NaN | NaN |
| 2 | 7.0 | NaN | NaN | NaN |
# Drop only columns that contain entirely NaN value
# Default is 0 - which signifies rows
data_dim.dropna(axis = 1, how = 'all')
| 0 | 1 | 2 | |
|---|---|---|---|
| 0 | 1.0 | 2.0 | 3.0 |
| 1 | 4.0 | 5.0 | NaN |
| 2 | 7.0 | NaN | NaN |
| 3 | NaN | NaN | NaN |
# Drop all columns that have more than 2 NaN values
data_dim.dropna(axis = 1, thresh = 2)
| 0 | 1 | |
|---|---|---|
| 0 | 1.0 | 2.0 |
| 1 | 4.0 | 5.0 |
| 2 | 7.0 | NaN |
| 3 | NaN | NaN |
# Drop all rows that have more than 2 NaN values
data_dim.dropna(thresh = 2)
| 0 | 1 | 2 | 3 | |
|---|---|---|---|---|
| 0 | 1.0 | 2.0 | 3.0 | NaN |
| 1 | 4.0 | 5.0 | NaN | NaN |
Sekarang Anda tahu cara mengidentifikasi dan menghapus nilai hilang — apakah hanya untuk melihat dataset hasilnya atau melakukan penghapusan secara inplace. Dalam banyak kasus, sekadar menghapus nilai null bukanlah opsi yang layak, dan Anda mungkin ingin mengisi data yang hilang dengan nilai lain. Mari lihat bagaimana Anda dapat melakukannya...
Untuk mengganti atau lebih tepatnya "mengisi" data null, Anda dapat menggunakan fungsi fillna(). Misalnya, mari coba gunakan dataset yang sama seperti di atas dan coba isi nilai NaN dengan 0.
# Check what the dataset looks like again
data_dim
| 0 | 1 | 2 | 3 | |
|---|---|---|---|---|
| 0 | 1.0 | 2.0 | 3.0 | NaN |
| 1 | 4.0 | 5.0 | NaN | NaN |
| 2 | 7.0 | NaN | NaN | NaN |
| 3 | NaN | NaN | NaN | NaN |
# Fill the NaN values with 0
data_dim_fill = data_dim.fillna(0)
data_dim_fill
| 0 | 1 | 2 | 3 | |
|---|---|---|---|---|
| 0 | 1.0 | 2.0 | 3.0 | 0.0 |
| 1 | 4.0 | 5.0 | 0.0 | 0.0 |
| 2 | 7.0 | 0.0 | 0.0 | 0.0 |
| 3 | 0.0 | 0.0 | 0.0 | 0.0 |
Dan seperti pada dropna() Anda juga dapat melakukan banyak hal lain tergantung pada jenis argumen yang Anda berikan. Juga pengingat bahwa memberikan argumen inplace = True akan membuat perubahan pada dataset asli.
# Pass a dictionary to use differnt values for each column
data_dim_fill = data_dim.fillna({0: 0, 1: 8, 2: 9, 3: 10})
data_dim_fill
| 0 | 1 | 2 | 3 | |
|---|---|---|---|---|
| 0 | 1.0 | 2.0 | 3.0 | 10.0 |
| 1 | 4.0 | 5.0 | 9.0 | 10.0 |
| 2 | 7.0 | 8.0 | 9.0 | 10.0 |
| 3 | 0.0 | 8.0 | 9.0 | 10.0 |
Anda dapat memberikan argumen method ke fungsi fillna() yang secara otomatis mempropagasi nilai non-null ke depan (ffill atau pad) atau ke belakang (bfill atau backfill).
# Pass method to determine how to fill-up the column - forward here
data_dim_fill = data_dim.fillna(method='ffill')
data_dim_fill
| 0 | 1 | 2 | 3 | |
|---|---|---|---|---|
| 0 | 1.0 | 2.0 | 3.0 | NaN |
| 1 | 4.0 | 5.0 | 3.0 | NaN |
| 2 | 7.0 | 5.0 | 3.0 | NaN |
| 3 | 7.0 | 5.0 | 3.0 | NaN |
Anda juga dapat membatasi jumlah isian seperti di atas. Misalnya, isi hanya dua tempat di kolom... Selain itu, jika Anda memberikan axis = 1 ini akan mengisi nilai baris sesuai.
# Pass method to determine how to fill-up the column - forward here
data_dim_fill = data_dim.fillna(method='ffill', limit = 2)
data_dim_fill
| 0 | 1 | 2 | 3 | |
|---|---|---|---|---|
| 0 | 1.0 | 2.0 | 3.0 | NaN |
| 1 | 4.0 | 5.0 | 3.0 | NaN |
| 2 | 7.0 | 5.0 | 3.0 | NaN |
| 3 | 7.0 | 5.0 | NaN | NaN |
# Pass method to determine how to fill-up the row - forward here
data_dim_fill = data_dim.fillna(axis = 1, method='ffill')
data_dim_fill
| 0 | 1 | 2 | 3 | |
|---|---|---|---|---|
| 0 | 1.0 | 2.0 | 3.0 | 3.0 |
| 1 | 4.0 | 5.0 | 5.0 | 5.0 |
| 2 | 7.0 | 7.0 | 7.0 | 7.0 |
| 3 | NaN | NaN | NaN | NaN |
Dengan sedikit pemahaman tentang data dan use case Anda, Anda dapat menggunakan fungsi fillna() dengan banyak cara lain selain sekadar mengisinya dengan angka. Anda bisa mengisinya menggunakan mean dengan mean() atau nilai median median() juga...
# Check the data_dim dataset
data_dim
| 0 | 1 | 2 | 3 | |
|---|---|---|---|---|
| 0 | 1.0 | 2.0 | 3.0 | NaN |
| 1 | 4.0 | 5.0 | NaN | NaN |
| 2 | 7.0 | NaN | NaN | NaN |
| 3 | NaN | NaN | NaN | NaN |
# Fill the NaN value with mean values in the corresponding column
data_dim_fill = data_dim.fillna(data_dim.mean())
data_dim_fill
| 0 | 1 | 2 | 3 | |
|---|---|---|---|---|
| 0 | 1.0 | 2.0 | 3.0 | NaN |
| 1 | 4.0 | 5.0 | 3.0 | NaN |
| 2 | 7.0 | 3.5 | 3.0 | NaN |
| 3 | 4.0 | 3.5 | 3.0 | NaN |
Sejauh ini, Anda hanya bekerja dengan data hilang (NaN), tetapi bisa ada situasi di mana Anda ingin mengganti nilai non-null dengan nilai lain. Atau mungkin nilai null dicatat sebagai angka acak, sehingga perlu diproses sebagai NaN alih-alih angka. Di sinilah fungsi replace() berguna...
Mari buat dataset yang berbeda kali ini.
data = pd.Series([1,2,-99,4,5,-99,7,8,-99])
data
0     1
1     2
2   -99
3     4
4     5
5   -99
6     7
7     8
8   -99
dtype: int64
# Replace the placeholder -99 as NaN
data.replace(-99, np.nan)
0    0.0
1    1.0
2    2.0
3    3.0
4    4.0
5    5.0
7    6.0
8    7.0
9    8.0
dtype: float64
Anda tidak lagi melihat -99, karena telah diganti oleh NaN dan karenanya tidak ditampilkan. Demikian pula, Anda dapat meneruskan banyak nilai untuk diganti. Untuk melakukan ini, kita akan membuat series lain lalu menggabungkan series data asli dengan series baru dan kemudian menerapkan fungsi penggantian banyak nilai.
Untuk melakukan ini, kita dapat menggunakan fungsi concat() di pandas. Untuk melanjutkan penomoran indeks setelah melakukan penggabungan, Anda dapat memberikan argumen ignore_index = True.
# Create a new Series
new_data = pd.Series([-100, 11, 12, 13])
combined_series = pd.concat([data, new_data], ignore_index = True)
combined_series
0       1
1       2
2     -99
3       4
4       5
5     -99
6       7
7       8
8     -99
9    -100
10     11
11     12
12     13
dtype: int64
# Let's replace -99 and -100 as NaN in the new combined_series
data_replaced = combined_series.replace([-99, -100], np.nan)
data_replaced
0      1.0
1      2.0
2      NaN
3      4.0
4      5.0
5      NaN
6      7.0
7      8.0
8      NaN
9      NaN
10    11.0
11    12.0
12    13.0
dtype: float64
# Argument passed can also be a dictionary with separate values
data_replaced = combined_series.replace({-99: np.nan, -100: 0})

# Same as: new_data.replace([-99, -100], [np.nan, 0])
data_replaced
0      1.0
1      2.0
2      NaN
3      4.0
4      5.0
5      NaN
6      7.0
7      8.0
8      NaN
9      0.0
10    11.0
11    12.0
12    13.0
dtype: float64
Dalam beberapa situasi, Anda mungkin ingin menambahkan lebih banyak wawasan pada apa yang sudah Anda miliki berdasarkan suatu logika. Saat itulah Anda dapat memanfaatkan peta dan kombinasi fungsi untuk mencapai apa yang Anda inginkan. Logikanya bisa menjadi lebih rumit, tetapi cobalah memahaminya dengan bantuan contoh ini.
Misalkan Anda memiliki sebuah dataframe berisi angka yang dipetakan ke hitungannya dalam bahasa Inggris.
data_number = pd.DataFrame({'english': ['zero','one','two','three','four','five'],
'digits': [0,1,2,3,4,5]})
data_number
| english | digits | |
|---|---|---|
| 0 | zero | 0 |
| 1 | one | 1 |
| 2 | two | 2 |
| 3 | three | 3 |
| 4 | four | 4 |
| 5 | five | 5 |
Katakanlah sekarang Anda ingin menambahkan kolom lain yang menunjukkan kelipatan dua sebagai 'Yes' dan sisanya sebagai 'No'. Anda dapat menuliskan pemetaan setiap sebutan bahasa Inggris yang berbeda ke 'Yes' atau 'No' yang sesuai.
english_to_multiple = {
    'two': 'yes',
    'four': 'yes'
}
Kemudian Anda dapat memanggil fungsi map untuk menambahkan kolom ketika entri English merupakan kelipatan 2. Apa yang terisi pada kolom angka yang bukan kelipatan? Mari cari tahu...
data_number['multiple'] = data_number['english'].map(english_to_multiple)
data_number
| english | digits | multiple | |
|---|---|---|---|
| 0 | zero | 0 | NaN |
| 1 | one | 1 | NaN |
| 2 | two | 2 | yes |
| 3 | three | 3 | NaN |
| 4 | four | 4 | yes |
| 5 | five | 5 | NaN |
Kolom lainnya terisi dengan nilai NaN, dan Anda sudah tahu cara lanjut bekerja dengan nilai hilang. Ini adalah contoh sederhana. Namun semoga Anda bisa mendapat inspirasi dari sini untuk menggunakan fungsi map guna melakukan lebih banyak hal dan memanfaatkannya dalam use case spesifik Anda.
Terkadang Anda mungkin ingin mengelompokkan berdasarkan suatu logika dan menempatkan semua data ke dalam keranjang atau bin diskret untuk tujuan analisis. Anda dapat menggunakan fungsi cut() untuk ini. Misalnya, mari terlebih dahulu membuat dataset berisi 30 angka acak antara 1 - 100.
import random

data = random.sample(range(1, 101), 30)
# data
[45,
 39,
 25,
 83,
 27,
 6,
 73,
 43,
 36,
 93,
 97,
 17,
 15,
 99,
 37,
 5,
 31,
 22,
 65,
 30,
 3,
 26,
 91,
 12,
 52,
 76,
 63,
 84,
 59,
 53]
Misal kita ingin mengelompokkan menurut keranjang yang kita tetapkan sendiri: angka antara 1 - 25, lalu 25 - 35, 40 - 60 lalu 60 - 80 dan sisanya. Jadi kita mendefinisikan keranjang...
Kemudian kita akan menggunakan fungsi cut.
# Defining the starting value for each bucket
bucket = [1, 25, 35, 60, 80, 100]

cut_data = pd.cut(data, bucket)
cut_data
[(35, 60], (35, 60], (1, 25], (80, 100], (25, 35], ..., (60, 80], (60, 80], (80, 100], (35, 60], (35, 60]]
Length: 30
Categories (5, interval[int64]): [(1, 25] < (25, 35] < (35, 60] < (60, 80] < (80, 100]]
cut() adalah fungsi yang sangat berguna, dan ada banyak hal lagi yang dapat Anda lakukan dengannya. Sangat disarankan untuk melihat dokumen Pandas untuk mempelajarinya lebih lanjut.
Topik ini sangat berguna saat Anda ingin mengonversi data kategorikal menjadi nilai numerik agar dapat digunakan dalam model analisis data Anda. Ini sangat praktis, terutama saat membuat model machine learning, di mana konsep one-hot encoding sangat dikenal. Dalam istilah yang lebih teknis: one-hot encoding adalah proses mengonversi nilai kategorikal menjadi vektor numerik 1-dimensi.
Salah satu cara melakukannya dengan pandas adalah menggunakan fungsi get_dummies(). Jika sebuah kolom di dataframe Anda memiliki 'n' nilai yang berbeda, fungsi ini akan menghasilkan matriks dengan 'n' kolom yang berisi semua 1 dan 0. Mari lihat dengan contoh untuk memahami konsepnya dengan lebih baik...
# Creating a DataFrame consiting individual characters in the list
data = pd.Series(list('abcdababcdabcd'))
data
0     a
1     b
2     c
3     d
4     a
5     b
6     a
7     b
8     c
9     d
10    a
11    b
12    c
13    d
dtype: object
Katakanlah sekarang Anda ingin memiliki vektor individual yang menunjukkan kemunculan setiap karakter untuk diberikan ke suatu fungsi.
Kira-kira seperti ini: untuk 'a' = [1,0,0,0,1,0,1,0,0,0,1,0,0,0] di mana 1 berada pada posisi saat 'a' ada dan 0 untuk saat tidak ada. Menggunakan fungsi get_dummies() akan memudahkan tugasnya.
pd.get_dummies(data)
| a | b | c | d | |
|---|---|---|---|---|
| 0 | 1 | 0 | 0 | 0 |
| 1 | 0 | 1 | 0 | 0 |
| 2 | 0 | 0 | 1 | 0 |
| 3 | 0 | 0 | 0 | 1 |
| 4 | 1 | 0 | 0 | 0 |
| 5 | 0 | 1 | 0 | 0 |
| 6 | 1 | 0 | 0 | 0 |
| 7 | 0 | 1 | 0 | 0 |
| 8 | 0 | 0 | 1 | 0 |
| 9 | 0 | 0 | 0 | 1 |
| 10 | 1 | 0 | 0 | 0 |
| 11 | 0 | 1 | 0 | 0 |
| 12 | 0 | 0 | 1 | 0 |
| 13 | 0 | 0 | 0 | 1 |
Namun, ini adalah contoh sederhana untuk membantu Anda mulai. Dalam aplikasi dunia nyata, keanggotaan sebuah karakter dapat termasuk dalam berbagai kategori pada saat yang sama, sehingga Anda perlu mempelajari metode yang lebih canggih. Juga untuk data yang jauh lebih besar, fungsi ini mungkin tidak terlalu efisien dari sisi kecepatan. Handling Categorical Data in Python dari DataCamp membahas kasus seperti itu dan topiknya secara lebih mendalam.
Nah, Anda telah sampai di akhir tutorial, dan Anda telah mempelajari beberapa alat dasar untuk memulai langkah pertama dalam jalur analisis data Anda. Keterampilan lain yang perlu dipelajari untuk langkah persiapan data termasuk cara mendeteksi dan menyaring outlier dalam dataset Anda dan jika dataset sangat besar — mungkin mulai dengan pengambilan sampel acak. Namun ini sekali lagi adalah topik yang luas dan sulit untuk digeneralisasi.
Use case dunia nyata sering kali lebih kompleks dan mungkin memerlukan solusi uniknya sendiri, tetapi idenya adalah mulai dari yang kecil, belajar sepanjang jalan, menjelajah lebih jauh, dan langsung praktik dengan berbagai dataset! Pastikan untuk melihat kursus Cleaning Data in Python dari DataCamp untuk mempelajari lebih banyak alat dan trik dan pada akhirnya, Anda akan bekerja pada dataset dunia nyata yang berantakan dari Gapminder Foundation. Ayo mulai!
Kursus Python
Kursus
Kursus
Kursus
blogs
David Woods
13 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
Dario Radečić
15 mnt
blogs
Javier Canales Luna
14 mnt



