Khóa học
Nhập môn Python
4 giờ
7.1M
Hướng dẫn này sẽ đưa bạn qua một số khái niệm và bước cơ bản để chuẩn bị dữ liệu. Chuẩn bị dữ liệu là bước đầu tiên sau khi bạn có trong tay bất kỳ tập dữ liệu nào. Đây là bước bạn tiền xử lý dữ liệu thô thành dạng có thể được phân tích dễ dàng và chính xác. Chuẩn bị dữ liệu đúng cách cho phép phân tích hiệu quả - nó có thể loại bỏ lỗi và sai lệch có thể phát sinh trong quá trình thu thập dữ liệu, từ đó giúp giảm bớt một số thiên lệch do chất lượng dữ liệu kém. Vì vậy, rất nhiều thời gian của nhà phân tích được dành cho bước quan trọng này.
Nạp dữ liệu, làm sạch dữ liệu (loại bỏ dữ liệu không cần thiết hoặc dữ liệu sai), chuyển đổi định dạng dữ liệu và sắp xếp lại dữ liệu là các bước khác nhau trong giai đoạn chuẩn bị dữ liệu. Trong hướng dẫn này, bạn sẽ làm việc với thư viện Pandas của Python để chuẩn bị dữ liệu.
Hãy đảm bảo bạn hiểu các khái niệm như Pandas DataFrame, Series, v.v. vì bạn sẽ đọc về chúng rất nhiều trong hướng dẫn này. Bạn có thể học sâu hơn về pandas trong hướng dẫn Pandas của DataCamp.
Trong hướng dẫn này:
Trong quá trình này, sẽ có một số mẹo, thủ thuật, và cả tham chiếu tới tài liệu chuyên sâu khác nếu bạn muốn đào sâu hơn vào một chủ đề.
Hãy bắt đầu với phần giới thiệu ngắn về Pandas...
Pandas là một thư viện phần mềm viết cho Python. Nó rất nổi tiếng trong cộng đồng khoa học dữ liệu vì cung cấp các cấu trúc dữ liệu mạnh mẽ, biểu đạt và linh hoạt giúp thao tác, phân tích dữ liệu trở nên dễ dàng VÀ hoàn toàn miễn phí. Hơn nữa, nếu bạn có một trường hợp sử dụng cụ thể và mới, bạn thậm chí có thể chia sẻ trên một trong các mailing list của Python hoặc trên trang GitHub của pandas - thực tế, hầu hết chức năng trong pandas được thúc đẩy bởi các trường hợp sử dụng thực tế như vậy.
Để có phần giới thiệu xuất sắc về pandas, nhớ xem khóa Pandas Foundation của DataCamp. Khóa học rất tương tác, và chương đầu tiên miễn phí!
Để dùng thư viện pandas, trước tiên bạn cần import nó. Chỉ cần gõ dòng này trong console python của bạn:
import pandas as pdBước đầu tiên để chuẩn bị dữ liệu là... đúng vậy, lấy dữ liệu. Nếu bạn có tệp .csv, bạn có thể dễ dàng nạp nó vào hệ thống bằng hàm .read_csv() trong pandas. Sau đó bạn có thể gõ:
data = pd.read_csv('path_to_file.csv')
Tuy nhiên, trong hướng dẫn này, bạn sẽ làm việc với một số DataFrame và Series nhỏ, dễ hiểu được tạo trực tiếp.
Đây là một vấn đề rất phổ biến trong thế giới phân tích dữ liệu.
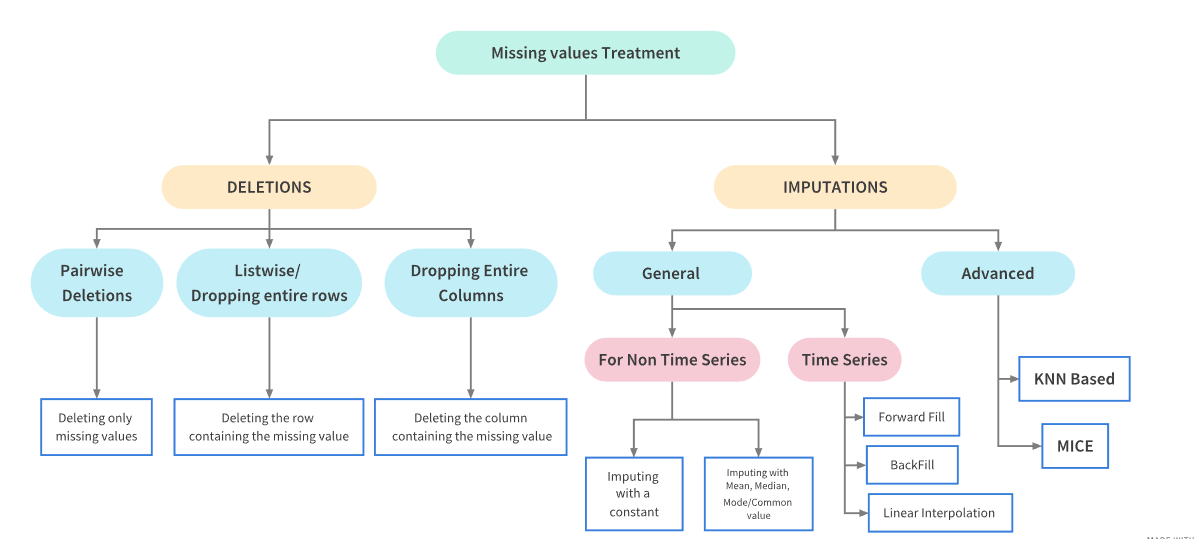
Dữ liệu khuyết có thể xuất hiện trong tập dữ liệu vì nhiều lý do: dữ liệu cho trường cụ thể không được người dùng/ứng dụng thu thập dữ liệu thêm vào, dữ liệu bị mất khi chuyển thủ công, lỗi lập trình, v.v. Đôi khi việc hiểu nguyên nhân là cần thiết vì điều này sẽ ảnh hưởng đến cách bạn xử lý dữ liệu như vậy. Nhưng phần này sẽ xuất hiện sau trong hướng dẫn. Hiện tại, hãy tập trung vào việc làm gì nếu bạn có dữ liệu khuyết...
Đối với dữ liệu số, pandas sử dụng giá trị dấu phẩy động NaN (Not a Number) để biểu diễn dữ liệu khuyết. Đây là một giá trị đặc biệt được định nghĩa trong thư viện Numpy nên chúng ta cũng cần import nó. NaN là dấu hiệu mặc định cho giá trị khuyết vì lý do tốc độ tính toán và tiện lợi. Đây là một giá trị sentinel, theo nghĩa là dữ liệu giả hoặc giá trị cờ có thể được phát hiện dễ dàng và thao tác bằng các hàm trong pandas.
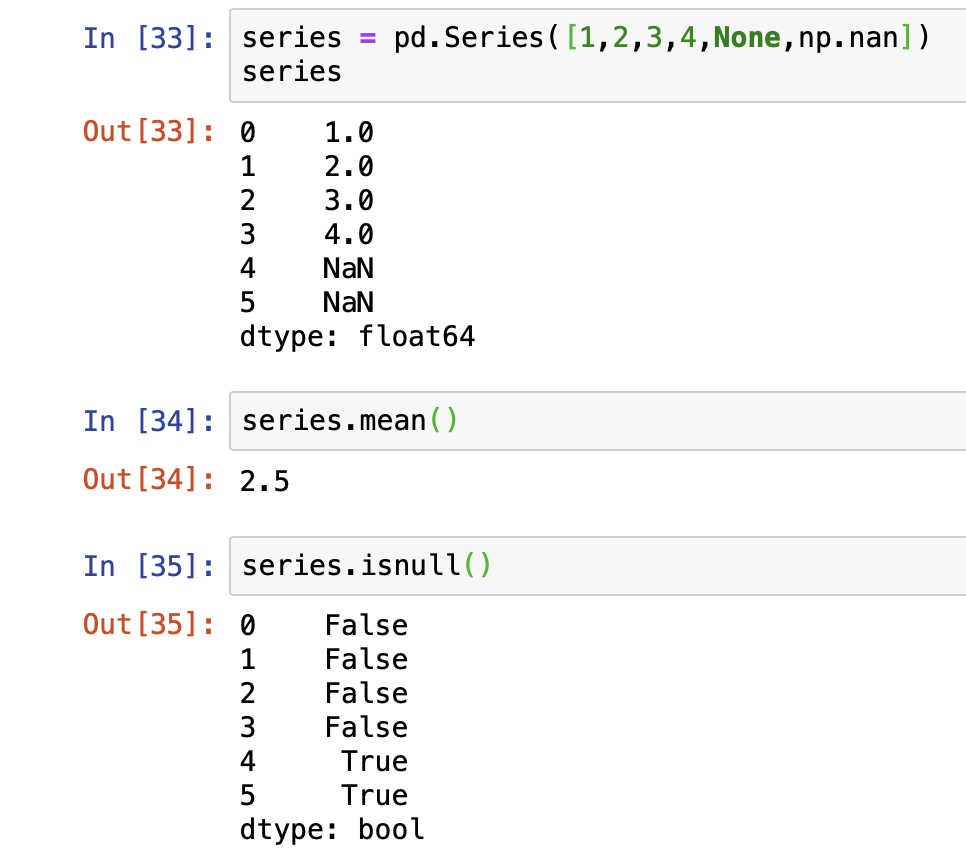
Hãy thử nghịch một chút với dữ liệu...
import numpy as np

# Creating a pandas series
data = pd.Series([0, 1, 2, 3, 4, 5, np.nan, 6, 7, 8])

# To check if and what index in the dataset contains null value
data.isnull()
0    False
1    False
2    False
3    False
4    False
5    False
6     True
7    False
8    False
9    False
dtype: bool
Ở trên, chúng ta dùng hàm isnull() trả về giá trị boolean true hoặc false. True khi dữ liệu tại chỉ số đó thực sự khuyết hoặc là NaN. Hàm ngược lại là notnull().
# To check where the dataset does not contain null value - opposite of isnull()
data.notnull()
0     True
1     True
2     True
3     True
4     True
5     True
6    False
7     True
8     True
9     True
dtype: bool
Thêm nữa, chúng ta có thể dùng hàm dropna() để lọc bỏ dữ liệu khuyết và loại bỏ giá trị null (khuyết) để chỉ thấy các giá trị không khuyết. Tuy nhiên, giá trị NaN thực ra không bị xóa và vẫn có trong tập dữ liệu gốc.
# Will not show the index 6 cause it contains null (NaN) value
data.dropna()
0    0.0
1    1.0
2    2.0
3    3.0
4    4.0
5    5.0
7    6.0
8    7.0
9    8.0
dtype: float64
data
0    0.0
1    1.0
2    2.0
3    3.0
4    4.0
5    5.0
6    NaN
7    6.0
8    7.0
9    8.0
dtype: float64
Để thực sự "loại bỏ" hay xóa giá trị NaN, bạn có thể hoặc lưu tập dữ liệu mới (không có NaN) để không ảnh hưởng tới Series gốc hoặc áp dụng drop inplace. Tham số inplace mặc định là false.
not_null_data = data.dropna()
not_null_data
0    0.0
1    1.0
2    2.0
3    3.0
4    4.0
5    5.0
7    6.0
8    7.0
9    8.0
dtype: float64
# Drop the 6th index in the original 'data' since it has a NaN place
data.dropna(inplace = True)
data
0    0.0
1    1.0
2    2.0
3    3.0
4    4.0
5    5.0
7    6.0
8    7.0
9    8.0
dtype: float64
Tuy nhiên, dataframe có thể phức tạp hơn và là 2 chiều, nghĩa là có hàng và cột. Pandas vẫn hỗ trợ bạn...
# Creating a dataframe with 4 rows and 4 columns (4*4 matrix)
data_dim = pd.DataFrame([[1,2,3,np.nan],[4,5,np.nan,np.nan],[7,np.nan,np.nan,np.nan],[np.nan,np.nan,np.nan,np.nan]])
data_dim
| 0 | 1 | 2 | 3 | |
|---|---|---|---|---|
| 0 | 1.0 | 2.0 | 3.0 | NaN |
| 1 | 4.0 | 5.0 | NaN | NaN |
| 2 | 7.0 | NaN | NaN | NaN |
| 3 | NaN | NaN | NaN | NaN |
Giờ giả sử bạn chỉ muốn loại bỏ các hàng hoặc cột toàn bộ là null hoặc chỉ những hàng/cột chứa một lượng giá trị null nhất định. Hãy xem các kịch bản khác nhau, nhớ rằng việc drop không diễn ra inplace, nên tập dữ liệu thật không bị ảnh hưởng. Chú ý tới các tham số truyền vào hàm dropna() để quyết định cách bạn loại bỏ dữ liệu khuyết.
# Drop all rows and columns containing NaN value
data_dim.dropna()
| 0 | 1 | 2 | 3 |
|---|
# Drop all rows and columns containing entirely of NaN value
data_dim.dropna(how = 'all')
| 0 | 1 | 2 | 3 | |
|---|---|---|---|---|
| 0 | 1.0 | 2.0 | 3.0 | NaN |
| 1 | 4.0 | 5.0 | NaN | NaN |
| 2 | 7.0 | NaN | NaN | NaN |
# Drop only columns that contain entirely NaN value
# Default is 0 - which signifies rows
data_dim.dropna(axis = 1, how = 'all')
| 0 | 1 | 2 | |
|---|---|---|---|
| 0 | 1.0 | 2.0 | 3.0 |
| 1 | 4.0 | 5.0 | NaN |
| 2 | 7.0 | NaN | NaN |
| 3 | NaN | NaN | NaN |
# Drop all columns that have more than 2 NaN values
data_dim.dropna(axis = 1, thresh = 2)
| 0 | 1 | |
|---|---|---|
| 0 | 1.0 | 2.0 |
| 1 | 4.0 | 5.0 |
| 2 | 7.0 | NaN |
| 3 | NaN | NaN |
# Drop all rows that have more than 2 NaN values
data_dim.dropna(thresh = 2)
| 0 | 1 | 2 | 3 | |
|---|---|---|---|---|
| 0 | 1.0 | 2.0 | 3.0 | NaN |
| 1 | 4.0 | 5.0 | NaN | NaN |
Bây giờ bạn đã biết cách xác định và loại bỏ giá trị khuyết - dù chỉ để xem tập dữ liệu kết quả hay thực hiện xóa inplace. Trong nhiều trường hợp, chỉ đơn thuần loại bỏ giá trị null là không khả thi, và bạn có thể muốn điền dữ liệu khuyết bằng một giá trị khác. Hãy xem cách bạn có thể làm điều đó...
Để thay thế hay đúng hơn là "điền" dữ liệu null, bạn có thể dùng hàm fillna(). Ví dụ, hãy thử dùng lại tập dữ liệu như trên và điền các giá trị NaN bằng 0.
# Check what the dataset looks like again
data_dim
| 0 | 1 | 2 | 3 | |
|---|---|---|---|---|
| 0 | 1.0 | 2.0 | 3.0 | NaN |
| 1 | 4.0 | 5.0 | NaN | NaN |
| 2 | 7.0 | NaN | NaN | NaN |
| 3 | NaN | NaN | NaN | NaN |
# Fill the NaN values with 0
data_dim_fill = data_dim.fillna(0)
data_dim_fill
| 0 | 1 | 2 | 3 | |
|---|---|---|---|---|
| 0 | 1.0 | 2.0 | 3.0 | 0.0 |
| 1 | 4.0 | 5.0 | 0.0 | 0.0 |
| 2 | 7.0 | 0.0 | 0.0 | 0.0 |
| 3 | 0.0 | 0.0 | 0.0 | 0.0 |
Và giống với dropna() bạn cũng có thể làm nhiều thứ khác tùy theo tham số bạn truyền vào. Cũng xin nhắc lại rằng truyền tham số inplace = True sẽ thay đổi tập dữ liệu gốc.
# Pass a dictionary to use differnt values for each column
data_dim_fill = data_dim.fillna({0: 0, 1: 8, 2: 9, 3: 10})
data_dim_fill
| 0 | 1 | 2 | 3 | |
|---|---|---|---|---|
| 0 | 1.0 | 2.0 | 3.0 | 10.0 |
| 1 | 4.0 | 5.0 | 9.0 | 10.0 |
| 2 | 7.0 | 8.0 | 9.0 | 10.0 |
| 3 | 0.0 | 8.0 | 9.0 | 10.0 |
Bạn có thể truyền tham số method cho hàm fillna() để tự động lan truyền các giá trị không khuyết theo hướng tiến (ffill hoặc pad) hoặc lùi (bfill hoặc backfill).
# Pass method to determine how to fill-up the column - forward here
data_dim_fill = data_dim.fillna(method='ffill')
data_dim_fill
| 0 | 1 | 2 | 3 | |
|---|---|---|---|---|
| 0 | 1.0 | 2.0 | 3.0 | NaN |
| 1 | 4.0 | 5.0 | 3.0 | NaN |
| 2 | 7.0 | 5.0 | 3.0 | NaN |
| 3 | 7.0 | 5.0 | 3.0 | NaN |
Bạn cũng có thể giới hạn số lần điền ở trên. Ví dụ, chỉ điền tối đa hai vị trí trong các cột... Ngoài ra, nếu bạn truyền axis = 1 điều này sẽ điền theo hàng tương ứng.
# Pass method to determine how to fill-up the column - forward here
data_dim_fill = data_dim.fillna(method='ffill', limit = 2)
data_dim_fill
| 0 | 1 | 2 | 3 | |
|---|---|---|---|---|
| 0 | 1.0 | 2.0 | 3.0 | NaN |
| 1 | 4.0 | 5.0 | 3.0 | NaN |
| 2 | 7.0 | 5.0 | 3.0 | NaN |
| 3 | 7.0 | 5.0 | NaN | NaN |
# Pass method to determine how to fill-up the row - forward here
data_dim_fill = data_dim.fillna(axis = 1, method='ffill')
data_dim_fill
| 0 | 1 | 2 | 3 | |
|---|---|---|---|---|
| 0 | 1.0 | 2.0 | 3.0 | 3.0 |
| 1 | 4.0 | 5.0 | 5.0 | 5.0 |
| 2 | 7.0 | 7.0 | 7.0 | 7.0 |
| 3 | NaN | NaN | NaN | NaN |
Với một số hiểu biết về dữ liệu và trường hợp sử dụng của bạn, bạn có thể dùng hàm fillna() theo nhiều cách khác ngoài việc đơn giản điền số. Bạn có thể điền bằng giá trị trung bình với mean() hoặc giá trị trung vị median() nữa...
# Check the data_dim dataset
data_dim
| 0 | 1 | 2 | 3 | |
|---|---|---|---|---|
| 0 | 1.0 | 2.0 | 3.0 | NaN |
| 1 | 4.0 | 5.0 | NaN | NaN |
| 2 | 7.0 | NaN | NaN | NaN |
| 3 | NaN | NaN | NaN | NaN |
# Fill the NaN value with mean values in the corresponding column
data_dim_fill = data_dim.fillna(data_dim.mean())
data_dim_fill
| 0 | 1 | 2 | 3 | |
|---|---|---|---|---|
| 0 | 1.0 | 2.0 | 3.0 | NaN |
| 1 | 4.0 | 5.0 | 3.0 | NaN |
| 2 | 7.0 | 3.5 | 3.0 | NaN |
| 3 | 4.0 | 3.5 | 3.0 | NaN |
Cho đến giờ, bạn mới chỉ làm việc với dữ liệu khuyết (NaN), nhưng có thể có những tình huống bạn muốn thay thế một giá trị không khuyết bằng một giá trị khác. Hoặc có thể một giá trị khuyết được ghi nhận như một số ngẫu nhiên, do đó cần được xử lý như NaN thay vì một con số. Đây là lúc hàm replace() phát huy tác dụng...
Hãy tạo một tập dữ liệu khác lần này.
data = pd.Series([1,2,-99,4,5,-99,7,8,-99])
data
0     1
1     2
2   -99
3     4
4     5
5   -99
6     7
7     8
8   -99
dtype: int64
# Replace the placeholder -99 as NaN
data.replace(-99, np.nan)
0    0.0
1    1.0
2    2.0
3    3.0
4    4.0
5    5.0
7    6.0
8    7.0
9    8.0
dtype: float64
Bạn sẽ không còn thấy -99 nữa, vì nó được thay bằng NaN và do đó không hiển thị. Tương tự, bạn có thể truyền nhiều giá trị cần thay thế. Để làm điều này, chúng ta sẽ tạo một series khác rồi nối series dữ liệu gốc với series mới và sau đó áp dụng thay thế nhiều giá trị.
Để làm điều đó, chúng ta có thể dùng hàm concat() trong pandas. Để tiếp tục đánh chỉ số sau khi nối, bạn có thể truyền tham số ignore_index = True.
# Create a new Series
new_data = pd.Series([-100, 11, 12, 13])
combined_series = pd.concat([data, new_data], ignore_index = True)
combined_series
0       1
1       2
2     -99
3       4
4       5
5     -99
6       7
7       8
8     -99
9    -100
10     11
11     12
12     13
dtype: int64
# Let's replace -99 and -100 as NaN in the new combined_series
data_replaced = combined_series.replace([-99, -100], np.nan)
data_replaced
0      1.0
1      2.0
2      NaN
3      4.0
4      5.0
5      NaN
6      7.0
7      8.0
8      NaN
9      NaN
10    11.0
11    12.0
12    13.0
dtype: float64
# Argument passed can also be a dictionary with separate values
data_replaced = combined_series.replace({-99: np.nan, -100: 0})

# Same as: new_data.replace([-99, -100], [np.nan, 0])
data_replaced
0      1.0
1      2.0
2      NaN
3      4.0
4      5.0
5      NaN
6      7.0
7      8.0
8      NaN
9      0.0
10    11.0
11    12.0
12    13.0
dtype: float64
Trong một số tình huống, bạn có thể muốn bổ sung thêm insight dựa trên một số logic cho những gì mình đã có. Khi đó, bạn có thể tận dụng map và kết hợp các hàm để đạt điều mình muốn. Logic có thể phức tạp hơn, nhưng hãy thử hiểu qua ví dụ này.
Giả sử, bạn có một dataframe ánh xạ các số sang dạng chữ tiếng Anh tương ứng.
data_number = pd.DataFrame({'english': ['zero','one','two','three','four','five'],
'digits': [0,1,2,3,4,5]})
data_number
| english | digits | |
|---|---|---|
| 0 | zero | 0 |
| 1 | one | 1 |
| 2 | two | 2 |
| 3 | three | 3 |
| 4 | four | 4 |
| 5 | five | 5 |
Giờ giả sử bạn muốn thêm một cột khác cho biết bội số của hai là 'Yes' và phần còn lại là 'No'. Bạn có thể viết một ánh xạ cho từng từ tiếng Anh riêng biệt tới 'Yes' hoặc 'No' tương ứng.
english_to_multiple = {
    'two': 'yes',
    'four': 'yes'
}
Sau đó bạn có thể gọi hàm map để thêm cột khi giá trị trong cột English là bội số của 2. Còn các số không phải bội số thì được điền gì? Hãy cùng xem...
data_number['multiple'] = data_number['english'].map(english_to_multiple)
data_number
| english | digits | multiple | |
|---|---|---|---|
| 0 | zero | 0 | NaN |
| 1 | one | 1 | NaN |
| 2 | two | 2 | yes |
| 3 | three | 3 | NaN |
| 4 | four | 4 | yes |
| 5 | five | 5 | NaN |
Các cột còn lại được điền bằng giá trị NaN, và bạn đã biết cách tiếp tục xử lý giá trị khuyết. Đây là một ví dụ đơn giản. Nhưng hy vọng bạn có thể tìm thấy cảm hứng để dùng các ý tưởng ở đây áp dụng hàm map làm nhiều việc hơn và tận dụng nó trong các trường hợp sử dụng cụ thể của bạn.
Đôi khi bạn có thể muốn phân loại theo một số logic và đưa toàn bộ dữ liệu vào các nhóm (bucket/bin) rời rạc để phân tích. Bạn có thể dùng hàm cut() cho việc này. Ví dụ, trước tiên hãy tạo một tập dữ liệu chứa 30 số ngẫu nhiên trong khoảng 1 - 100.
import random

data = random.sample(range(1, 101), 30)
# data
[45,
 39,
 25,
 83,
 27,
 6,
 73,
 43,
 36,
 93,
 97,
 17,
 15,
 99,
 37,
 5,
 31,
 22,
 65,
 30,
 3,
 26,
 91,
 12,
 52,
 76,
 63,
 84,
 59,
 53]
Giả sử chúng ta muốn phân loại chúng theo các nhóm do chính mình định nghĩa: các số từ 1 - 25, rồi 25 - 35, 40 - 60, rồi 60 - 80 và phần còn lại. Vậy ta định nghĩa một bucket...
Sau đó chúng ta sẽ dùng hàm cut.
# Defining the starting value for each bucket
bucket = [1, 25, 35, 60, 80, 100]

cut_data = pd.cut(data, bucket)
cut_data
[(35, 60], (35, 60], (1, 25], (80, 100], (25, 35], ..., (60, 80], (60, 80], (80, 100], (35, 60], (35, 60]]
Length: 30
Categories (5, interval[int64]): [(1, 25] < (25, 35] < (35, 60] < (60, 80] < (80, 100]]
cut() là một hàm rất hữu ích, và bạn có thể làm được nhiều hơn nữa với nó. Rất khuyến khích bạn xem tài liệu Pandas để tìm hiểu thêm.
Chủ đề này đặc biệt hữu ích khi bạn muốn chuyển đổi một số dữ liệu phân loại thành giá trị số để có thể dùng trong mô hình phân tích dữ liệu. Điều này đặc biệt tiện lợi khi làm mô hình học máy, nơi khái niệm one-hot encoding rất phổ biến. Nói theo cách kỹ thuật hơn: one-hot encoding là quá trình chuyển đổi các giá trị phân loại thành một vector số 1 chiều.
Một cách thực hiện điều này bằng pandas là dùng hàm get_dummies(). Nếu một cột trong dataframe của bạn có 'n' giá trị phân biệt, hàm sẽ tạo ra một ma trận với 'n' cột chứa toàn 1 và 0. Hãy xem ví dụ để nắm rõ khái niệm hơn...
# Creating a DataFrame consiting individual characters in the list
data = pd.Series(list('abcdababcdabcd'))
data
0     a
1     b
2     c
3     d
4     a
5     b
6     a
7     b
8     c
9     d
10    a
11    b
12    c
13    d
dtype: object
Giờ giả sử bạn muốn có các vector riêng lẻ biểu thị sự xuất hiện của từng ký tự để đưa vào một hàm.
Chẳng hạn như: với 'a' = [1,0,0,0,1,0,1,0,0,0,1,0,0,0] trong đó 1 ở vị trí 'a' xuất hiện và 0 ở vị trí không xuất hiện. Dùng hàm get_dummies() sẽ giúp việc này dễ dàng hơn.
pd.get_dummies(data)
| a | b | c | d | |
|---|---|---|---|---|
| 0 | 1 | 0 | 0 | 0 |
| 1 | 0 | 1 | 0 | 0 |
| 2 | 0 | 0 | 1 | 0 |
| 3 | 0 | 0 | 0 | 1 |
| 4 | 1 | 0 | 0 | 0 |
| 5 | 0 | 1 | 0 | 0 |
| 6 | 1 | 0 | 0 | 0 |
| 7 | 0 | 1 | 0 | 0 |
| 8 | 0 | 0 | 1 | 0 |
| 9 | 0 | 0 | 0 | 1 |
| 10 | 1 | 0 | 0 | 0 |
| 11 | 0 | 1 | 0 | 0 |
| 12 | 0 | 0 | 1 | 0 |
| 13 | 0 | 0 | 0 | 1 |
Tuy nhiên, đây là một ví dụ đơn giản để giúp bạn bắt đầu. Trong các ứng dụng thực tế, một ký tự có thể đồng thời thuộc nhiều nhóm, vì vậy bạn sẽ cần học các phương pháp tinh vi hơn. Ngoài ra với dữ liệu rất lớn, hàm này có thể không hiệu quả về tốc độ. Bài viết Xử lý Dữ liệu Phân loại trong Python của DataCamp thảo luận sâu hơn về các trường hợp như vậy và chủ đề này.
Bạn đã đến cuối hướng dẫn, và bạn đã học một số công cụ cơ bản để bắt đầu bước đầu tiên trên con đường phân tích dữ liệu. Các kỹ năng khác cần học cho bước chuẩn bị dữ liệu còn có cách phát hiện và lọc ngoại lệ trong tập dữ liệu, và nếu tập dữ liệu rất lớn - có thể bắt đầu bằng lấy mẫu ngẫu nhiên. Nhưng đây lại là những chủ đề rộng và khó khái quát.
Các trường hợp sử dụng thực tế thường phức tạp hơn và có thể cần giải pháp riêng, nhưng ý tưởng là bắt đầu từ những điều nhỏ, học hỏi trên đường đi, khám phá thêm và thực hành với các tập dữ liệu khác nhau! Nhớ xem khóa Cleaning Data in Python của DataCamp để học thêm công cụ và mẹo, và cuối khóa, bạn sẽ làm việc với một tập dữ liệu thực tế, lộn xộn từ Quỹ Gapminder. Hãy bắt đầu thôi!
Khóa học Python
Khóa học
Khóa học
Khóa học
blog
Matt Crabtree
10 phút
