Cursus
Introductie tot Python
4 uur
7.1M
Deze tutorial loodst je door enkele basisconcepten en -stappen voor data-preparatie. Data-preparatie is de eerste stap zodra je met een dataset aan de slag gaat. In deze stap zet je ruwe data om naar een vorm die je eenvoudig en nauwkeurig kunt analyseren. Goede data-preparatie maakt efficiënte analyse mogelijk: het kan fouten en onnauwkeurigheden wegnemen die tijdens het verzamelen zijn ontstaan en zo bias door slechte datakwaliteit verminderen. Daarom gaat veel tijd van een analist naar deze essentiële stap.
Data laden, data opschonen (onnodige of foutieve data verwijderen), dataformaten transformeren en data herschikken zijn de verschillende stappen binnen data-preparatie. In deze tutorial werk je met de pandas-bibliotheek van Python voor data-preparatie.
Zorg dat je concepten als een pandas DataFrame, Series, enz. begrijpt, want je komt ze vaak tegen in deze tutorial. Je kunt pandas grondiger leren in DataCamps pandas-tutorial.
In deze tutorial:
Onderweg krijg je tips en tricks en verwijzingen naar verdiepende materialen voor als je een onderwerp verder wilt uitpluizen.
Laten we beginnen met een korte introductie tot pandas...
Pandas is een softwarebibliotheek geschreven voor Python. Het is erg populair in de data science-community omdat het krachtige, expressieve en flexibele datastructuren biedt die datamanipulatie en -analyse makkelijk maken, én het is vrij beschikbaar. Bovendien kun je, als je een specifieke nieuwe usecase hebt, die delen op een van de Python-mailinglijsten of op de pandas GitHub-site — veel functionaliteit in pandas is namelijk ontstaan uit echte usecases.
Voor een uitstekende introductie tot pandas, bekijk zeker DataCamps Pandas Foundation-cursus. Hij is erg interactief en het eerste hoofdstuk is gratis!
Om de pandas-bibliotheek te gebruiken, moet je die eerst importeren. Typ dit in je Python-console:
import pandas as pdDe eerste stap in data-preparatie is... data verkrijgen. Als je een .csv-bestand hebt, kun je dat eenvoudig inladen met de functie .read_csv() in pandas. Je kunt dan typen:
data = pd.read_csv('path_to_file.csv')
Voor deze tutorial werk je echter met kleinere, makkelijk te begrijpen DataFrames en Series die we ter plekke aanmaken.
Dit is een veelvoorkomend probleem in de data-analysewereld.
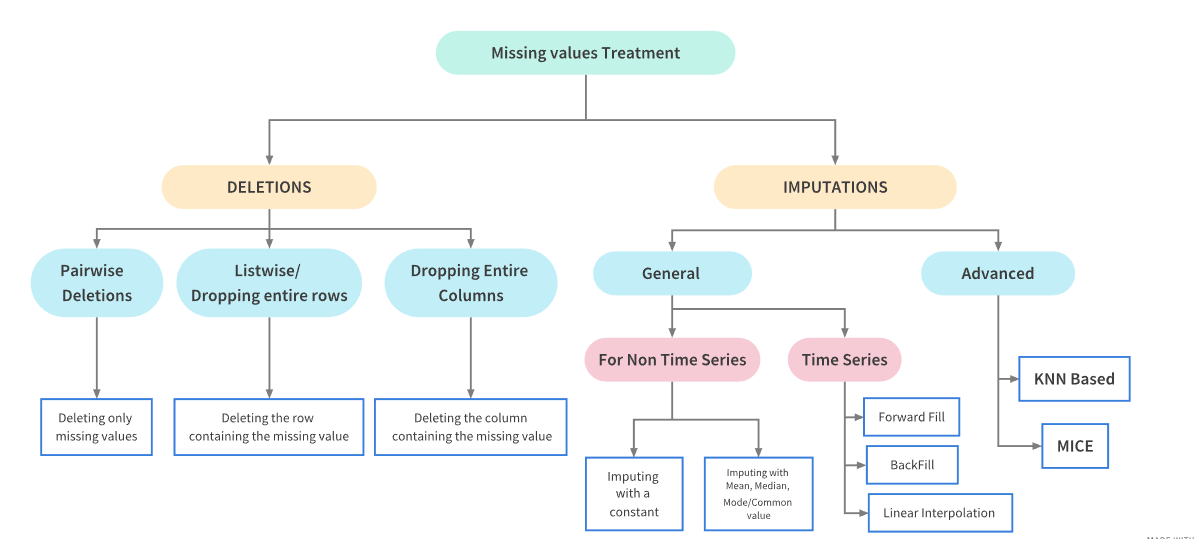
Ontbrekende data kan om meerdere redenen in je dataset voorkomen: de data voor een specifiek veld is niet toegevoegd door de gebruiker/dataverzamel-applicatie, data is handmatig verloren gegaan bij overdracht, er zit een programmeerfout in, enzovoort. Soms is het essentieel om de oorzaak te begrijpen, omdat dat beïnvloedt hoe je met zulke data omgaat. Maar dat komt later in deze tutorial aan bod. Laten we nu focussen op wat je doet als je ontbrekende data hebt...
Voor numerieke data gebruikt pandas de drijvende-kommawaarde NaN (Not a Number) om ontbrekende data weer te geven. Dit is een unieke waarde gedefinieerd in de bibliotheek NumPy, dus die moeten we ook importeren. NaN is de standaardmarkering voor ontbrekende waarden, omwille van rekenkundige snelheid en gemak. Het is een sentinelwaarde, in de zin dat het een dummy- of vlagwaarde is die eenvoudig te detecteren is en waar pandas-functies goed mee overweg kunnen.
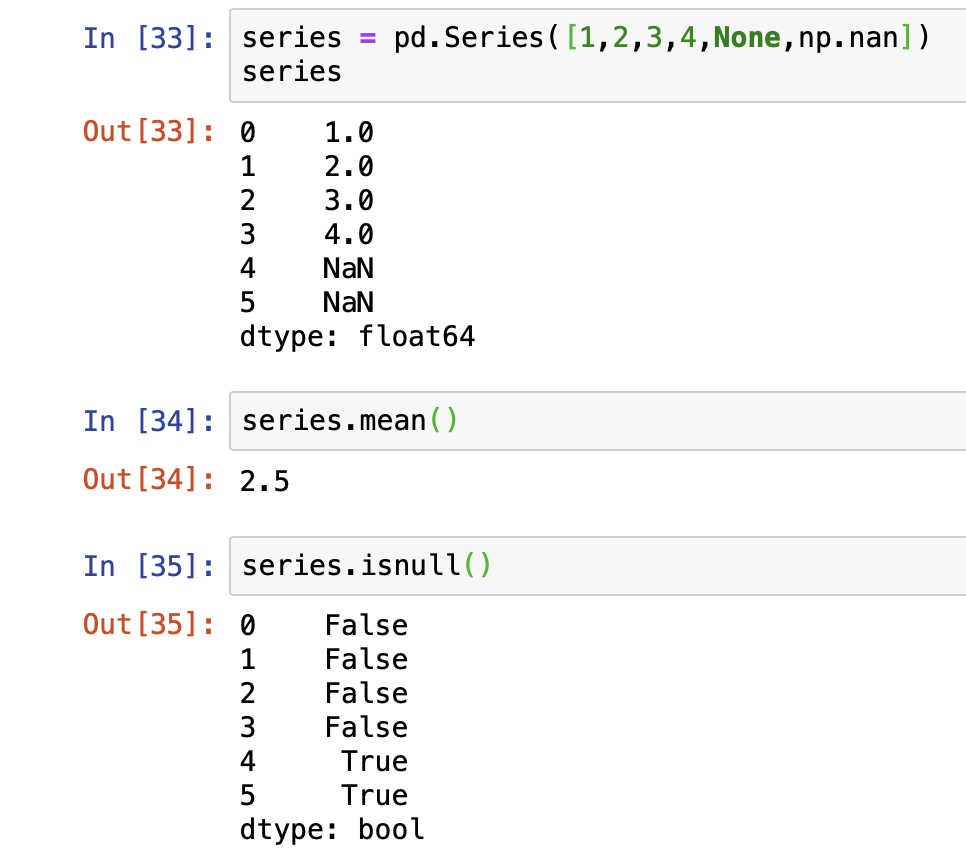
Laten we met wat data spelen...
import numpy as np

# Creating a pandas series
data = pd.Series([0, 1, 2, 3, 4, 5, np.nan, 6, 7, 8])

# To check if and what index in the dataset contains null value
data.isnull()
0    False
1    False
2    False
3    False
4    False
5    False
6     True
7    False
8    False
9    False
dtype: bool
Hierboven gebruikten we de functie isnull(), die een booleaanse true of false teruggeeft. True wanneer de data op die specifieke index ontbreekt of NaN is. Het tegenovergestelde hiervan is de functie notnull().
# To check where the dataset does not contain null value - opposite of isnull()
data.notnull()
0     True
1     True
2     True
3     True
4     True
5     True
6    False
7     True
8     True
9     True
dtype: bool
Verder kun je de functie dropna() gebruiken om ontbrekende data eruit te filteren en de null- (ontbrekende) waarde te verwijderen zodat je alleen de niet-nullwaarden ziet. De NaN-waarde wordt echter niet echt verwijderd en is nog steeds aanwezig in de originele dataset.
# Will not show the index 6 cause it contains null (NaN) value
data.dropna()
0    0.0
1    1.0
2    2.0
3    3.0
4    4.0
5    5.0
7    6.0
8    7.0
9    8.0
dtype: float64
data
0    0.0
1    1.0
2    2.0
3    3.0
4    4.0
5    5.0
6    NaN
7    6.0
8    7.0
9    8.0
dtype: float64
Wat je kunt doen om NaN echt te "droppen" of te verwijderen, is óf de nieuwe dataset (zonder NaN) opslaan zodat de originele Series ongemoeid blijft, óf een drop inplace toepassen. Het argument inplace heeft standaard de waarde false.
not_null_data = data.dropna()
not_null_data
0    0.0
1    1.0
2    2.0
3    3.0
4    4.0
5    5.0
7    6.0
8    7.0
9    8.0
dtype: float64
# Drop the 6th index in the original 'data' since it has a NaN place
data.dropna(inplace = True)
data
0    0.0
1    1.0
2    2.0
3    3.0
4    4.0
5    5.0
7    6.0
8    7.0
9    8.0
dtype: float64
DataFrames kunnen echter complexer zijn en twee-dimensionaal, met rijen en kolommen. Ook dan helpt pandas je verder...
# Creating a dataframe with 4 rows and 4 columns (4*4 matrix)
data_dim = pd.DataFrame([[1,2,3,np.nan],[4,5,np.nan,np.nan],[7,np.nan,np.nan,np.nan],[np.nan,np.nan,np.nan,np.nan]])
data_dim
| 0 | 1 | 2 | 3 | |
|---|---|---|---|---|
| 0 | 1.0 | 2.0 | 3.0 | NaN |
| 1 | 4.0 | 5.0 | NaN | NaN |
| 2 | 7.0 | NaN | NaN | NaN |
| 3 | NaN | NaN | NaN | NaN |
Stel nu dat je alleen rijen of kolommen wilt droppen die volledig null zijn, of alleen die met een bepaald aantal null-waarden. Bekijk de verschillende scenario’s; onthoud dat de drop niet inplace gebeurt, dus de echte dataset blijft onaangeroerd. Let op de argumenten die je meegeeft aan de functie dropna() om te bepalen hoe je de ontbrekende data dropt.
# Drop all rows and columns containing NaN value
data_dim.dropna()
| 0 | 1 | 2 | 3 |
|---|
# Drop all rows and columns containing entirely of NaN value
data_dim.dropna(how = 'all')
| 0 | 1 | 2 | 3 | |
|---|---|---|---|---|
| 0 | 1.0 | 2.0 | 3.0 | NaN |
| 1 | 4.0 | 5.0 | NaN | NaN |
| 2 | 7.0 | NaN | NaN | NaN |
# Drop only columns that contain entirely NaN value
# Default is 0 - which signifies rows
data_dim.dropna(axis = 1, how = 'all')
| 0 | 1 | 2 | |
|---|---|---|---|
| 0 | 1.0 | 2.0 | 3.0 |
| 1 | 4.0 | 5.0 | NaN |
| 2 | 7.0 | NaN | NaN |
| 3 | NaN | NaN | NaN |
# Drop all columns that have more than 2 NaN values
data_dim.dropna(axis = 1, thresh = 2)
| 0 | 1 | |
|---|---|---|
| 0 | 1.0 | 2.0 |
| 1 | 4.0 | 5.0 |
| 2 | 7.0 | NaN |
| 3 | NaN | NaN |
# Drop all rows that have more than 2 NaN values
data_dim.dropna(thresh = 2)
| 0 | 1 | 2 | 3 | |
|---|---|---|---|---|
| 0 | 1.0 | 2.0 | 3.0 | NaN |
| 1 | 4.0 | 5.0 | NaN | NaN |
Nu weet je hoe je ontbrekende waarden kunt identificeren en droppen — ofwel om het resulterende datasetje te bekijken of om inplace te verwijderen. In veel gevallen is het simpelweg droppen van null-waarden niet haalbaar en wil je de ontbrekende data opvullen met een andere waarde. Laten we kijken hoe je dat kunt doen...
Om null-data te vervangen of beter gezegd "op te vullen", kun je de functie fillna() gebruiken. Laten we bijvoorbeeld dezelfde dataset als hierboven gebruiken en de NaN-waarden opvullen met 0.
# Check what the dataset looks like again
data_dim
| 0 | 1 | 2 | 3 | |
|---|---|---|---|---|
| 0 | 1.0 | 2.0 | 3.0 | NaN |
| 1 | 4.0 | 5.0 | NaN | NaN |
| 2 | 7.0 | NaN | NaN | NaN |
| 3 | NaN | NaN | NaN | NaN |
# Fill the NaN values with 0
data_dim_fill = data_dim.fillna(0)
data_dim_fill
| 0 | 1 | 2 | 3 | |
|---|---|---|---|---|
| 0 | 1.0 | 2.0 | 3.0 | 0.0 |
| 1 | 4.0 | 5.0 | 0.0 | 0.0 |
| 2 | 7.0 | 0.0 | 0.0 | 0.0 |
| 3 | 0.0 | 0.0 | 0.0 | 0.0 |
Net als met dropna() kun je nog veel meer doen, afhankelijk van het soort argument dat je meegeeft. Ook hier weer: als je inplace = True meegeeft, wordt de wijziging toegepast op de originele dataset.
# Pass a dictionary to use differnt values for each column
data_dim_fill = data_dim.fillna({0: 0, 1: 8, 2: 9, 3: 10})
data_dim_fill
| 0 | 1 | 2 | 3 | |
|---|---|---|---|---|
| 0 | 1.0 | 2.0 | 3.0 | 10.0 |
| 1 | 4.0 | 5.0 | 9.0 | 10.0 |
| 2 | 7.0 | 8.0 | 9.0 | 10.0 |
| 3 | 0.0 | 8.0 | 9.0 | 10.0 |
Je kunt een method-argument meegeven aan de functie fillna() die niet-nullwaarden automatisch voorwaarts (ffill of pad) of achterwaarts (bfill of backfill) doorvoert.
# Pass method to determine how to fill-up the column - forward here
data_dim_fill = data_dim.fillna(method='ffill')
data_dim_fill
| 0 | 1 | 2 | 3 | |
|---|---|---|---|---|
| 0 | 1.0 | 2.0 | 3.0 | NaN |
| 1 | 4.0 | 5.0 | 3.0 | NaN |
| 2 | 7.0 | 5.0 | 3.0 | NaN |
| 3 | 7.0 | 5.0 | 3.0 | NaN |
Je kunt ook het aantal vullingen hierboven beperken. Vul bijvoorbeeld maar twee posities in de kolommen... Als je axis = 1 meegeeft, wordt er overeenkomstig per rij gevuld.
# Pass method to determine how to fill-up the column - forward here
data_dim_fill = data_dim.fillna(method='ffill', limit = 2)
data_dim_fill
| 0 | 1 | 2 | 3 | |
|---|---|---|---|---|
| 0 | 1.0 | 2.0 | 3.0 | NaN |
| 1 | 4.0 | 5.0 | 3.0 | NaN |
| 2 | 7.0 | 5.0 | 3.0 | NaN |
| 3 | 7.0 | 5.0 | NaN | NaN |
# Pass method to determine how to fill-up the row - forward here
data_dim_fill = data_dim.fillna(axis = 1, method='ffill')
data_dim_fill
| 0 | 1 | 2 | 3 | |
|---|---|---|---|---|
| 0 | 1.0 | 2.0 | 3.0 | 3.0 |
| 1 | 4.0 | 5.0 | 5.0 | 5.0 |
| 2 | 7.0 | 7.0 | 7.0 | 7.0 |
| 3 | NaN | NaN | NaN | NaN |
Met enig begrip van de data en je usecase kun je de functie fillna() op veel andere manieren gebruiken dan simpelweg met getallen op te vullen. Je kunt bijvoorbeeld opvullen met het gemiddelde via mean() of de mediaan via median()...
# Check the data_dim dataset
data_dim
| 0 | 1 | 2 | 3 | |
|---|---|---|---|---|
| 0 | 1.0 | 2.0 | 3.0 | NaN |
| 1 | 4.0 | 5.0 | NaN | NaN |
| 2 | 7.0 | NaN | NaN | NaN |
| 3 | NaN | NaN | NaN | NaN |
# Fill the NaN value with mean values in the corresponding column
data_dim_fill = data_dim.fillna(data_dim.mean())
data_dim_fill
| 0 | 1 | 2 | 3 | |
|---|---|---|---|---|
| 0 | 1.0 | 2.0 | 3.0 | NaN |
| 1 | 4.0 | 5.0 | 3.0 | NaN |
| 2 | 7.0 | 3.5 | 3.0 | NaN |
| 3 | 4.0 | 3.5 | 3.0 | NaN |
Tot nu toe heb je alleen met ontbrekende data (NaN) gewerkt, maar er zijn situaties waarin je een niet-nullwaarde wilt vervangen door een andere waarde. Of misschien is een null-waarde vastgelegd als een willekeurig getal en moet die daarom als NaN worden verwerkt in plaats van als getal. Dan komt de functie replace() van pas...
Laten we dit keer een andere dataset maken.
data = pd.Series([1,2,-99,4,5,-99,7,8,-99])
data
0     1
1     2
2   -99
3     4
4     5
5   -99
6     7
7     8
8   -99
dtype: int64
# Replace the placeholder -99 as NaN
data.replace(-99, np.nan)
0    0.0
1    1.0
2    2.0
3    3.0
4    4.0
5    5.0
7    6.0
8    7.0
9    8.0
dtype: float64
Je ziet -99 niet meer, omdat het is vervangen door NaN en daarom niet wordt getoond. Op dezelfde manier kun je meerdere waarden laten vervangen. Om dit te doen, maken we een andere Series, voegen we de originele data- Series samen met de nieuwe Series en passen we vervolgens de vervanging van meerdere waarden toe.
Hiervoor kun je de functie concat() in pandas gebruiken. Om de indexering door te laten lopen na de concatenatie, kun je het argument ignore_index = True meegeven.
# Create a new Series
new_data = pd.Series([-100, 11, 12, 13])
combined_series = pd.concat([data, new_data], ignore_index = True)
combined_series
0       1
1       2
2     -99
3       4
4       5
5     -99
6       7
7       8
8     -99
9    -100
10     11
11     12
12     13
dtype: int64
# Let's replace -99 and -100 as NaN in the new combined_series
data_replaced = combined_series.replace([-99, -100], np.nan)
data_replaced
0      1.0
1      2.0
2      NaN
3      4.0
4      5.0
5      NaN
6      7.0
7      8.0
8      NaN
9      NaN
10    11.0
11    12.0
12    13.0
dtype: float64
# Argument passed can also be a dictionary with separate values
data_replaced = combined_series.replace({-99: np.nan, -100: 0})

# Same as: new_data.replace([-99, -100], [np.nan, 0])
data_replaced
0      1.0
1      2.0
2      NaN
3      4.0
4      5.0
5      NaN
6      7.0
7      8.0
8      NaN
9      0.0
10    11.0
11    12.0
12    13.0
dtype: float64
In sommige situaties wil je extra inzicht toevoegen aan wat je al hebt, op basis van bepaalde logica. Dan kun je met mappings en een combinatie van functies bereiken wat je wilt. De logica kan complexer worden, maar probeer het te begrijpen met dit voorbeeld.
Stel, je hebt een DataFrame met getallen gekoppeld aan hun overeenkomstige telling in het Engels.
data_number = pd.DataFrame({'english': ['zero','one','two','three','four','five'],
'digits': [0,1,2,3,4,5]})
data_number
| english | digits | |
|---|---|---|
| 0 | zero | 0 |
| 1 | one | 1 |
| 2 | two | 2 |
| 3 | three | 3 |
| 4 | four | 4 |
| 5 | five | 5 |
Stel dat je nu een extra kolom wilt toevoegen die veelvouden van twee als 'Yes' aangeeft en de rest als 'No'. Je kunt een mapping uitschrijven van elke afzonderlijke Engelse naam naar de bijbehorende 'Yes' of 'No'.
english_to_multiple = {
    'two': 'yes',
    'four': 'yes'
}
Vervolgens kun je de map-functie aanroepen om de kolom toe te voegen voor wanneer de Engelse kolom een veelvoud van 2 is. Wat wordt er ingevuld in de andere niet-veelvoud-kolommen? Laten we het uitzoeken...
data_number['multiple'] = data_number['english'].map(english_to_multiple)
data_number
| english | digits | multiple | |
|---|---|---|---|
| 0 | zero | 0 | NaN |
| 1 | one | 1 | NaN |
| 2 | two | 2 | yes |
| 3 | three | 3 | NaN |
| 4 | four | 4 | yes |
| 5 | five | 5 | NaN |
De andere kolommen zijn gevuld met NaN-waarden, en je weet al hoe je verder met ontbrekende waarden kunt werken. Dit was een eenvoudig voorbeeld. Hopelijk vind je hier inspiratie om de map-functie creatief toe te passen in jouw specifieke usecases.
Soms wil je op basis van bepaalde logica categoriseren en alle data in discrete emmers of bins plaatsen voor analyse. Je kunt hiervoor de functie cut() gebruiken. Laten we bijvoorbeeld eerst een dataset maken met 30 willekeurige getallen tussen 1 en 100.
import random

data = random.sample(range(1, 101), 30)
# data
[45,
 39,
 25,
 83,
 27,
 6,
 73,
 43,
 36,
 93,
 97,
 17,
 15,
 99,
 37,
 5,
 31,
 22,
 65,
 30,
 3,
 26,
 91,
 12,
 52,
 76,
 63,
 84,
 59,
 53]
Stel dat we die willen categoriseren in zelf gedefinieerde buckets: getallen tussen 1 - 25, dan 25 - 35, 40 - 60, vervolgens 60 - 80 en daarna de rest. Dus we definiëren een bucket...
Vervolgens gebruiken we de functie cut.
# Defining the starting value for each bucket
bucket = [1, 25, 35, 60, 80, 100]

cut_data = pd.cut(data, bucket)
cut_data
[(35, 60], (35, 60], (1, 25], (80, 100], (25, 35], ..., (60, 80], (60, 80], (80, 100], (35, 60], (35, 60]]
Length: 30
Categories (5, interval[int64]): [(1, 25] < (25, 35] < (35, 60] < (60, 80] < (80, 100]]
cut() is een zeer nuttige functie en je kunt er nog veel meer mee doen. Het is sterk aan te raden om de pandas-documentatie te bekijken om er meer over te leren.
Dit onderwerp is vooral handig wanneer je categorische data wilt omzetten naar numerieke waarden, zodat je die in je data-analysemodel kunt gebruiken. Dit is met name nuttig bij machine learning, waar het concept van one-hot encoding bekend is. In meer technische termen: one-hot encoding is het proces waarbij categorische waarden worden omgezet naar een eendimensionale numerieke vector.
Een manier om dit met pandas te doen is de functie get_dummies() te gebruiken. Als een kolom in je DataFrame 'n' verschillende waarden heeft, levert de functie een matrix met 'n' kolommen met allemaal 1’en en 0’en. Laten we dit met een voorbeeld bekijken om het concept beter te vatten...
# Creating a DataFrame consiting individual characters in the list
data = pd.Series(list('abcdababcdabcd'))
data
0     a
1     b
2     c
3     d
4     a
5     b
6     a
7     b
8     c
9     d
10    a
11    b
12    c
13    d
dtype: object
Stel dat je nu afzonderlijke vectoren wilt hebben die de aanwezigheid van elk teken aangeven om aan een functie door te geven.
Zoiets als: voor 'a' = [1,0,0,0,1,0,1,0,0,0,1,0,0,0] waarbij 1 staat op de positie waar 'a' voorkomt en 0 waar dat niet zo is. Met de functie get_dummies() wordt dit een stuk eenvoudiger.
pd.get_dummies(data)
| a | b | c | d | |
|---|---|---|---|---|
| 0 | 1 | 0 | 0 | 0 |
| 1 | 0 | 1 | 0 | 0 |
| 2 | 0 | 0 | 1 | 0 |
| 3 | 0 | 0 | 0 | 1 |
| 4 | 1 | 0 | 0 | 0 |
| 5 | 0 | 1 | 0 | 0 |
| 6 | 1 | 0 | 0 | 0 |
| 7 | 0 | 1 | 0 | 0 |
| 8 | 0 | 0 | 1 | 0 |
| 9 | 0 | 0 | 0 | 1 |
| 10 | 1 | 0 | 0 | 0 |
| 11 | 0 | 1 | 0 | 0 |
| 12 | 0 | 0 | 1 | 0 |
| 13 | 0 | 0 | 0 | 1 |
Dit is echter een eenvoudig voorbeeld om je op weg te helpen. In toepassingen in de echte wereld kan het voorkomen dat het lidmaatschap van een teken tot meerdere categorieën tegelijk behoort; dan heb je geavanceerdere methoden nodig. En bij veel grotere data is deze functie mogelijk niet erg efficiënt qua snelheid. DataCamps Handling Categorical Data in Python bespreekt zulke gevallen en het onderwerp grondiger.
Je bent aan het einde van de tutorial en je hebt een aantal basistools geleerd om de eerste stap op je data-analysepad te zetten. Andere vaardigheden voor data-preparatie zijn bijvoorbeeld het detecteren en filteren van uitschieters in je dataset en — als de dataset enorm is — starten met willekeurige sampling. Maar dat zijn op zichzelf weer brede onderwerpen en lastig te generaliseren.
Usecases in de echte wereld zijn vaak complexer en vragen soms om een unieke oplossing, maar het idee is om klein te beginnen, al doende te leren, meer te verkennen en je handen vuil te maken met verschillende datasets! Bekijk zeker de cursus Cleaning Data in Python van DataCamp om meer tools en tricks te leren. Aan het einde werk je met een echte, rommelige dataset van de Gapminder Foundation. Aan de slag!
Python-cursussen
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min

