Kurs
Python’a Giriş
4 sa
7.1M
Bu eğitim, veri hazırlamaya yönelik bazı temel kavramlar ve adımlar boyunca size rehberlik edecek. Veri hazırlama, herhangi bir veri kümesiyle çalışmaya başladıktan sonraki ilk adımdır. Bu adımda, ham verileri kolay ve doğru şekilde analiz edilebilecek bir forma dönüştürürsünüz. Doğru veri hazırlama, verimli analiz sağlar — veri toplama sürecinde oluşmuş olabilecek hataları ve tutarsızlıkları ortadan kaldırabilir ve böylece düşük veri kalitesinden kaynaklanan önyargıyı azaltmaya yardımcı olabilir. Bu nedenle, analistlerin zamanının önemli bir kısmı bu kritik adıma harcanır.
Veri yükleme, verileri temizleme (gereksiz veya hatalı verileri kaldırma), veri biçimlerini dönüştürme ve verileri yeniden düzenleme, veri hazırlama adımında yer alan aşamalardır. Bu eğitimde, veri hazırlama için Python'un Pandas kütüphanesiyle çalışacaksınız.
Bu eğitimde sık sık karşınıza çıkacağı için Pandas DataFrame, Series vb. kavramları anladığınızdan emin olun. pandas hakkında daha derinlemesine bilgi edinmek için DataCamp'in Pandas eğitimine göz atabilirsiniz.
Bu eğitimde:
Yol boyunca, daha derine inmek isterseniz başka kapsamlı kaynaklara referansların yanı sıra bazı ipuçları ve püf noktaları da bulacaksınız.
Hadi Pandas'a kısa bir girişle başlayalım...
Pandas, Python için yazılmış bir yazılım kütüphanesidir. Veri bilimi topluluğunda oldukça ünlüdür; çünkü veri manipülasyonunu ve analizi kolaylaştıran güçlü, ifade gücü yüksek ve esnek veri yapıları sunar ve ücretsizdir. Ayrıca, belirli ve yeni bir kullanım durumunuz varsa bunu Python e-posta listelerinden birinde veya pandas GitHub sitesinde paylaşabilirsiniz — aslında pandas'taki işlevlerin çoğu, gerçek dünya kullanım durumlarıyla bu şekilde şekillenmiştir.
pandas'a mükemmel bir giriş için DataCamp'in Pandas Foundation kursuna mutlaka göz atın. Oldukça etkileşimli ve ilk bölüm ücretsiz!
pandas kütüphanesini kullanmak için önce içe aktarmanız gerekir. Python konsolunuza şunu yazın:
import pandas as pdVeri hazırlamanın ilk adımı... elbette, biraz veri edinmektir. Bir .csv dosyanız varsa, pandas'taki .read_csv() fonksiyonunu kullanarak sisteminize kolayca yükleyebilirsiniz. Sonra şunu yazabilirsiniz:
data = pd.read_csv('path_to_file.csv')
Ancak bu eğitimde, anlık olarak oluşturulan daha küçük ve anlaşılması kolay DataFrame ve Series'lerle çalışacaksınız.
Bu, veri analizi dünyasında çok yaygın bir sorundur.
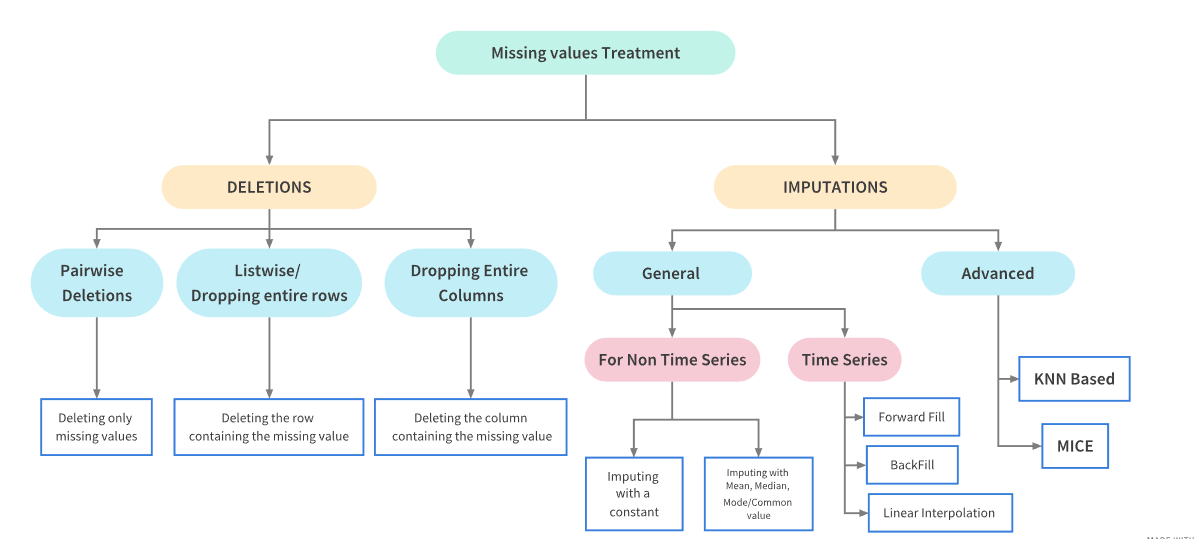
Eksik veriler, çeşitli nedenlerle veri kümesinde ortaya çıkabilir: İlgili alanın verisi kullanıcı/veri toplama uygulaması tarafından girilmemiş olabilir, manuel aktarım sırasında veri kaybolmuş olabilir, bir programlama hatası olabilir vb. Bazen nedeni anlamak önemlidir; çünkü bu durum, böyle bir veriyle nasıl başa çıkacağınızı etkiler. Ancak buna eğitimde daha sonra geleceğiz. Şimdilik, elinizde eksik veri varsa ne yapacağınıza odaklanalım...
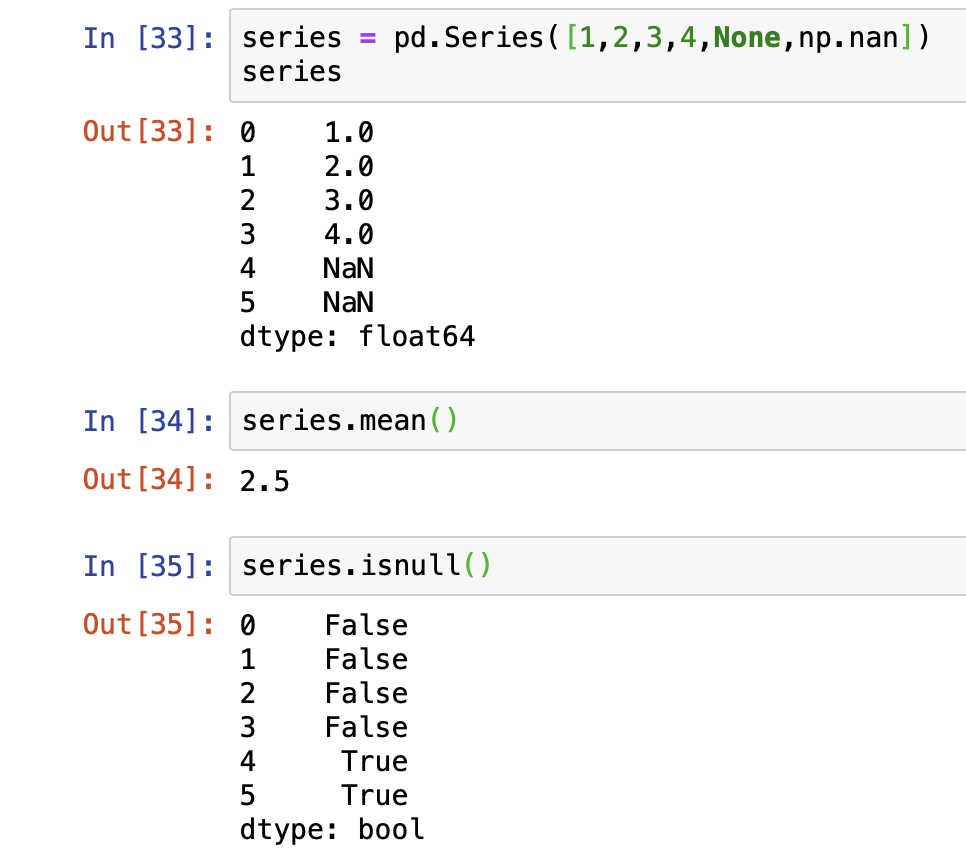
Sayısal veriler için pandas, eksik verileri göstermek üzere kayan noktalı bir değer olan NaN'ı (Not a Number) kullanır. Bu, Numpy kütüphanesinde tanımlanmış benzersiz bir değerdir, bu yüzden onu da içe aktarmamız gerekir. NaN, hesaplama hızı ve kullanım kolaylığı nedeniyle varsayılan eksik değer işaretleyicisidir. Bu, bir tür bekçi (sentinel) değerdir; yani pandas'taki fonksiyonlarla kolayca tespit edilip üzerinde çalışılabilen sahte veri veya bayrak değeridir.
Biraz veriyle oynayalım...
import numpy as np

# Creating a pandas series
data = pd.Series([0, 1, 2, 3, 4, 5, np.nan, 6, 7, 8])

# To check if and what index in the dataset contains null value
data.isnull()
0    False
1    False
2    False
3    False
4    False
5    False
6     True
7    False
8    False
9    False
dtype: bool
Yukarıda, boolean true veya false döndüren isnull() fonksiyonunu kullandık. Veri belirli bir indekste gerçekten eksik ya da NaN ise True döner. Bunun tersi ise notnull() fonksiyonudur.
# To check where the dataset does not contain null value - opposite of isnull()
data.notnull()
0     True
1     True
2     True
3     True
4     True
5     True
6    False
7     True
8     True
9     True
dtype: bool
Ayrıca, eksik verileri filtrelemek ve null (eksik) değeri kaldırıp yalnızca null olmayan değerleri görmek için dropna() fonksiyonunu kullanabiliriz. Ancak, NaN değeri gerçekten silinmez ve orijinal veri kümesinde hâlâ bulunabilir.
# Will not show the index 6 cause it contains null (NaN) value
data.dropna()
0    0.0
1    1.0
2    2.0
3    3.0
4    4.0
5    5.0
7    6.0
8    7.0
9    8.0
dtype: float64
data
0    0.0
1    1.0
2    2.0
3    3.0
4    4.0
5    5.0
6    NaN
7    6.0
8    7.0
9    8.0
dtype: float64
NaN değerini gerçekten "düşürmek" veya silmek için ya yeni veri kümesini (NaN olmadan) saklayabilir, böylece orijinal Series'e dokunmamış olursunuz, ya da inplace bir drop uygulayabilirsiniz. inplace argümanının varsayılan değeri false'tur.
not_null_data = data.dropna()
not_null_data
0    0.0
1    1.0
2    2.0
3    3.0
4    4.0
5    5.0
7    6.0
8    7.0
9    8.0
dtype: float64
# Drop the 6th index in the original 'data' since it has a NaN place
data.dropna(inplace = True)
data
0    0.0
1    1.0
2    2.0
3    3.0
4    4.0
5    5.0
7    6.0
8    7.0
9    8.0
dtype: float64
Bununla birlikte, dataframeler daha karmaşık olabilir ve iki boyutlu olabilir; yani satır ve sütun içerirler. Pandas burada da imdadınıza yetişir...
# Creating a dataframe with 4 rows and 4 columns (4*4 matrix)
data_dim = pd.DataFrame([[1,2,3,np.nan],[4,5,np.nan,np.nan],[7,np.nan,np.nan,np.nan],[np.nan,np.nan,np.nan,np.nan]])
data_dim
| 0 | 1 | 2 | 3 | |
|---|---|---|---|---|
| 0 | 1.0 | 2.0 | 3.0 | NaN |
| 1 | 4.0 | 5.0 | NaN | NaN |
| 2 | 7.0 | NaN | NaN | NaN |
| 3 | NaN | NaN | NaN | NaN |
Diyelim ki yalnızca tamamen null olan satırları veya sütunları ya da belirli sayıda null değer içerenleri düşürmek istiyorsunuz. Çeşitli senaryolara göz atın; unutmayın, düşürme inplace gerçekleşmiyor, bu yüzden gerçek veri kümesine dokunulmuyor. Eksik veriyi nasıl düşüreceğinizi belirlemek için dropna() fonksiyonuna geçirilen argümanlara dikkat edin.
# Drop all rows and columns containing NaN value
data_dim.dropna()
| 0 | 1 | 2 | 3 |
|---|
# Drop all rows and columns containing entirely of NaN value
data_dim.dropna(how = 'all')
| 0 | 1 | 2 | 3 | |
|---|---|---|---|---|
| 0 | 1.0 | 2.0 | 3.0 | NaN |
| 1 | 4.0 | 5.0 | NaN | NaN |
| 2 | 7.0 | NaN | NaN | NaN |
# Drop only columns that contain entirely NaN value
# Default is 0 - which signifies rows
data_dim.dropna(axis = 1, how = 'all')
| 0 | 1 | 2 | |
|---|---|---|---|
| 0 | 1.0 | 2.0 | 3.0 |
| 1 | 4.0 | 5.0 | NaN |
| 2 | 7.0 | NaN | NaN |
| 3 | NaN | NaN | NaN |
# Drop all columns that have more than 2 NaN values
data_dim.dropna(axis = 1, thresh = 2)
| 0 | 1 | |
|---|---|---|
| 0 | 1.0 | 2.0 |
| 1 | 4.0 | 5.0 |
| 2 | 7.0 | NaN |
| 3 | NaN | NaN |
# Drop all rows that have more than 2 NaN values
data_dim.dropna(thresh = 2)
| 0 | 1 | 2 | 3 | |
|---|---|---|---|---|
| 0 | 1.0 | 2.0 | 3.0 | NaN |
| 1 | 4.0 | 5.0 | NaN | NaN |
Artık eksik değerleri nasıl tanıyıp düşüreceğinizi biliyorsunuz — ister yalnızca ortaya çıkan veri kümesini görmek, ister inplace bir silme yapmak için. Birçok durumda, null değerleri basitçe düşürmek uygulanabilir bir seçenek değildir ve eksik verileri başka bir değerle doldurmak isteyebilirsiniz. Bunu nasıl yapabileceğinize bakalım...
Null verileri değiştirmek veya "doldurmak" için fillna() fonksiyonunu kullanabilirsiniz. Örneğin, yukarıdaki aynı veri kümesini kullanıp NaN değerlerini 0 ile doldurmayı deneyelim.
# Check what the dataset looks like again
data_dim
| 0 | 1 | 2 | 3 | |
|---|---|---|---|---|
| 0 | 1.0 | 2.0 | 3.0 | NaN |
| 1 | 4.0 | 5.0 | NaN | NaN |
| 2 | 7.0 | NaN | NaN | NaN |
| 3 | NaN | NaN | NaN | NaN |
# Fill the NaN values with 0
data_dim_fill = data_dim.fillna(0)
data_dim_fill
| 0 | 1 | 2 | 3 | |
|---|---|---|---|---|
| 0 | 1.0 | 2.0 | 3.0 | 0.0 |
| 1 | 4.0 | 5.0 | 0.0 | 0.0 |
| 2 | 7.0 | 0.0 | 0.0 | 0.0 |
| 3 | 0.0 | 0.0 | 0.0 | 0.0 |
Ayrıca, dropna()'da olduğu gibi, geçirdiğiniz argümana bağlı olarak başka pek çok şey de yapabilirsiniz. Ayrıca inplace = True argümanını geçirmenin değişikliği orijinal veri kümesine uygulayacağını hatırlatalım.
# Pass a dictionary to use differnt values for each column
data_dim_fill = data_dim.fillna({0: 0, 1: 8, 2: 9, 3: 10})
data_dim_fill
| 0 | 1 | 2 | 3 | |
|---|---|---|---|---|
| 0 | 1.0 | 2.0 | 3.0 | 10.0 |
| 1 | 4.0 | 5.0 | 9.0 | 10.0 |
| 2 | 7.0 | 8.0 | 9.0 | 10.0 |
| 3 | 0.0 | 8.0 | 9.0 | 10.0 |
fillna() fonksiyonuna bir method argümanı geçirerek null olmayan değerleri otomatik olarak ileriye (ffill veya pad) ya da geriye (bfill veya backfill) doğru yayabilirsiniz.
# Pass method to determine how to fill-up the column - forward here
data_dim_fill = data_dim.fillna(method='ffill')
data_dim_fill
| 0 | 1 | 2 | 3 | |
|---|---|---|---|---|
| 0 | 1.0 | 2.0 | 3.0 | NaN |
| 1 | 4.0 | 5.0 | 3.0 | NaN |
| 2 | 7.0 | 5.0 | 3.0 | NaN |
| 3 | 7.0 | 5.0 | 3.0 | NaN |
Ayrıca, yukarıdaki doldurma sayısını sınırlayabilirsiniz. Örneğin, sütunlarda yalnızca iki konumu doldurun... Ayrıca axis = 1 geçirirseniz bu, satır değerini uygun şekilde doldurur.
# Pass method to determine how to fill-up the column - forward here
data_dim_fill = data_dim.fillna(method='ffill', limit = 2)
data_dim_fill
| 0 | 1 | 2 | 3 | |
|---|---|---|---|---|
| 0 | 1.0 | 2.0 | 3.0 | NaN |
| 1 | 4.0 | 5.0 | 3.0 | NaN |
| 2 | 7.0 | 5.0 | 3.0 | NaN |
| 3 | 7.0 | 5.0 | NaN | NaN |
# Pass method to determine how to fill-up the row - forward here
data_dim_fill = data_dim.fillna(axis = 1, method='ffill')
data_dim_fill
| 0 | 1 | 2 | 3 | |
|---|---|---|---|---|
| 0 | 1.0 | 2.0 | 3.0 | 3.0 |
| 1 | 4.0 | 5.0 | 5.0 | 5.0 |
| 2 | 7.0 | 7.0 | 7.0 | 7.0 |
| 3 | NaN | NaN | NaN | NaN |
Veriyi ve kullanım durumunuzu biraz anladığınızda, fillna() fonksiyonunu yalnızca sayılarla doldurmaktan çok daha farklı şekillerde kullanabilirsiniz. mean() ile ortalama ya da median() ile medyan değeri kullanarak da doldurabilirsiniz...
# Check the data_dim dataset
data_dim
| 0 | 1 | 2 | 3 | |
|---|---|---|---|---|
| 0 | 1.0 | 2.0 | 3.0 | NaN |
| 1 | 4.0 | 5.0 | NaN | NaN |
| 2 | 7.0 | NaN | NaN | NaN |
| 3 | NaN | NaN | NaN | NaN |
# Fill the NaN value with mean values in the corresponding column
data_dim_fill = data_dim.fillna(data_dim.mean())
data_dim_fill
| 0 | 1 | 2 | 3 | |
|---|---|---|---|---|
| 0 | 1.0 | 2.0 | 3.0 | NaN |
| 1 | 4.0 | 5.0 | 3.0 | NaN |
| 2 | 7.0 | 3.5 | 3.0 | NaN |
| 3 | 4.0 | 3.5 | 3.0 | NaN |
Şimdiye kadar yalnızca eksik veriyle (NaN) çalıştınız; ancak null olmayan bir değeri farklı bir değerle değiştirmek istediğiniz durumlar olabilir. Ya da belki bir null değer rastgele bir sayı olarak kaydedilmiştir ve bu nedenle sayı olarak değil, NaN olarak işlenmesi gerekir. İşte replace() fonksiyonunun kullanışlı olduğu yer burası...
Bu kez farklı bir veri kümesi oluşturalım.
data = pd.Series([1,2,-99,4,5,-99,7,8,-99])
data
0     1
1     2
2   -99
3     4
4     5
5   -99
6     7
7     8
8   -99
dtype: int64
# Replace the placeholder -99 as NaN
data.replace(-99, np.nan)
0    0.0
1    1.0
2    2.0
3    3.0
4    4.0
5    5.0
7    6.0
8    7.0
9    8.0
dtype: float64
Artık -99'u görmeyeceksiniz; çünkü NaN ile değiştirildi ve bu nedenle gösterilmiyor. Benzer şekilde, değiştirilecek birden fazla değer de geçirebilirsiniz. Bunu yapmak için başka bir seri oluşturacağız ve ardından orijinal veri serisini yeni seriyle birleştirip çoklu değer değiştirme fonksiyonunu uygulayacağız.
Bunu yapmak için pandas'taki concat() fonksiyonunu kullanabiliriz. Birleştirmeden sonra indekslemeye devam etmek için ignore_index = True argümanını geçebilirsiniz.
# Create a new Series
new_data = pd.Series([-100, 11, 12, 13])
combined_series = pd.concat([data, new_data], ignore_index = True)
combined_series
0       1
1       2
2     -99
3       4
4       5
5     -99
6       7
7       8
8     -99
9    -100
10     11
11     12
12     13
dtype: int64
# Let's replace -99 and -100 as NaN in the new combined_series
data_replaced = combined_series.replace([-99, -100], np.nan)
data_replaced
0      1.0
1      2.0
2      NaN
3      4.0
4      5.0
5      NaN
6      7.0
7      8.0
8      NaN
9      NaN
10    11.0
11    12.0
12    13.0
dtype: float64
# Argument passed can also be a dictionary with separate values
data_replaced = combined_series.replace({-99: np.nan, -100: 0})

# Same as: new_data.replace([-99, -100], [np.nan, 0])
data_replaced
0      1.0
1      2.0
2      NaN
3      4.0
4      5.0
5      NaN
6      7.0
7      8.0
8      NaN
9      0.0
10    11.0
11    12.0
12    13.0
dtype: float64
Bazı durumlarda, belirli bir mantığa dayanarak elinizdekine daha fazla içgörü eklemek isteyebilirsiniz. Bu noktada, istediğinizi başarmak için map'lerden ve fonksiyon kombinasyonlarından yararlanabilirsiniz. Mantık daha karmaşık hale gelebilir; ancak bunu bu örnekle anlamaya çalışın.
Diyelim ki, sayıları İngilizce karşılıklarındaki yazımlarıyla eşleyen bir dataframe'iniz var.
data_number = pd.DataFrame({'english': ['zero','one','two','three','four','five'],
'digits': [0,1,2,3,4,5]})
data_number
| english | digits | |
|---|---|---|
| 0 | zero | 0 |
| 1 | one | 1 |
| 2 | two | 2 |
| 3 | three | 3 |
| 4 | four | 4 |
| 5 | five | 5 |
Şimdi, iki katı olanları 'Yes', diğerlerini 'No' olarak gösteren başka bir sütun eklemek istediğinizi varsayalım. Her bir farklı İngilizce yazımı, karşılık gelen 'Yes' veya 'No' ile eşleyen bir haritalama yazabilirsiniz.
english_to_multiple = {
    'two': 'yes',
    'four': 'yes'
}
Ardından, English sütunu 2'nin katı olduğunda sütunu eklemek için map fonksiyonunu çağırabilirsiniz. Peki diğer kat olmayan sayıların olduğu sütunlara ne yazılır? Hadi bulalım...
data_number['multiple'] = data_number['english'].map(english_to_multiple)
data_number
| english | digits | multiple | |
|---|---|---|---|
| 0 | zero | 0 | NaN |
| 1 | one | 1 | NaN |
| 2 | two | 2 | yes |
| 3 | three | 3 | NaN |
| 4 | four | 4 | yes |
| 5 | five | 5 | NaN |
Diğer sütunlar NaN değerleriyle doldurulur ve eksik değerlerle nasıl çalışacağınızı zaten biliyorsunuz. Bu basit bir örnekti. Ancak umarız buradaki fikirlerden ilham alarak map fonksiyonunu daha fazlası için kullanır ve kendi kullanım durumlarınıza uygularsınız.
Bazen bir mantığa göre kategorize etmek ve tüm verileri analiz amacıyla ayrık kovalar veya kutular (bins) içine yerleştirmek isteyebilirsiniz. Bunun için cut() fonksiyonunu kullanabilirsiniz. Örneğin, önce 1 - 100 arasında 30 rastgele sayı içeren bir veri kümesi oluşturalım.
import random

data = random.sample(range(1, 101), 30)
# data
[45,
 39,
 25,
 83,
 27,
 6,
 73,
 43,
 36,
 93,
 97,
 17,
 15,
 99,
 37,
 5,
 31,
 22,
 65,
 30,
 3,
 26,
 91,
 12,
 52,
 76,
 63,
 84,
 59,
 53]
Diyelim ki bunları kendi belirlediğimiz kovalarla kategorize etmek istiyoruz: 1 - 25, sonra 25 - 35, 40 - 60, ardından 60 - 80 ve sonra geri kalanı. O halde bir kova tanımlıyoruz...
Sonra cut fonksiyonunu kullanacağız.
# Defining the starting value for each bucket
bucket = [1, 25, 35, 60, 80, 100]

cut_data = pd.cut(data, bucket)
cut_data
[(35, 60], (35, 60], (1, 25], (80, 100], (25, 35], ..., (60, 80], (60, 80], (80, 100], (35, 60], (35, 60]]
Length: 30
Categories (5, interval[int64]): [(1, 25] < (25, 35] < (35, 60] < (60, 80] < (80, 100]]
cut() çok kullanışlı bir fonksiyondur ve bununla yapabileceğiniz çok daha fazla şey vardır. Daha fazlasını öğrenmek için Pandas belgesini incelemeniz şiddetle tavsiye edilir.
Bu konu, bazı kategorik verileri sayısal değerlere dönüştürmek istediğinizde özellikle kullanışlıdır; böylece bunları veri analizi modelinizde kullanabilirsiniz. Bu, özellikle makine öğrenmesi modellemesi yaparken, one-hot kodlama kavramının yaygın olduğu durumlarda elverişlidir. Daha teknik ifadeyle: one-hot kodlama, kategorik değerlerin 1 boyutlu sayısal bir vektöre dönüştürülmesi sürecidir.
Bunu pandas kullanarak yapmanın bir yolu get_dummies() fonksiyonunu kullanmaktır. DataFrame'inizde bir sütunda 'n' farklı değer varsa, fonksiyon 1'ler ve 0'lardan oluşan 'n' sütunlu bir matris türetecektir. Kavramı daha iyi kavramak için bir örnekle görelim...
# Creating a DataFrame consiting individual characters in the list
data = pd.Series(list('abcdababcdabcd'))
data
0     a
1     b
2     c
3     d
4     a
5     b
6     a
7     b
8     c
9     d
10    a
11    b
12    c
13    d
dtype: object
Diyelim ki şimdi, her bir karakterin görünümünü gösteren bireysel vektörlere sahip olmak istiyorsunuz ve bunu bir fonksiyona besleyeceksiniz.
Şuna benzer: 'a' için = [1,0,0,0,1,0,1,0,0,0,1,0,0,0]; burada 1, 'a' karakterinin bulunduğu pozisyonda, 0 ise bulunmadığı yerde. get_dummies() fonksiyonunu kullanmak bu işi kolaylaştıracaktır.
pd.get_dummies(data)
| a | b | c | d | |
|---|---|---|---|---|
| 0 | 1 | 0 | 0 | 0 |
| 1 | 0 | 1 | 0 | 0 |
| 2 | 0 | 0 | 1 | 0 |
| 3 | 0 | 0 | 0 | 1 |
| 4 | 1 | 0 | 0 | 0 |
| 5 | 0 | 1 | 0 | 0 |
| 6 | 1 | 0 | 0 | 0 |
| 7 | 0 | 1 | 0 | 0 |
| 8 | 0 | 0 | 1 | 0 |
| 9 | 0 | 0 | 0 | 1 |
| 10 | 1 | 0 | 0 | 0 |
| 11 | 0 | 1 | 0 | 0 |
| 12 | 0 | 0 | 1 | 0 |
| 13 | 0 | 0 | 0 | 1 |
Ancak bu, başlamanıza yardımcı olacak basit bir örnektir. Gerçek dünya uygulamalarında bir karakterin üyeliği aynı anda çeşitli kategorilere ait olabilir; dolayısıyla daha gelişmiş yöntemler öğrenmeniz gerekebilir. Ayrıca çok daha büyük verilerde bu fonksiyon hız açısından çok verimli olmayabilir. DataCamp'in Python'da Kategorik Verileri İşleme içeriği bu tür durumları ve konuyu daha derinlemesine ele almaktadır.
Geldik eğitimin sonuna; veri analizi yolculuğunuzun ilk adımına başlamak için bazı temel araçları öğrendiniz. Veri hazırlama adımları için öğrenilmesi gereken diğer beceriler arasında, veri kümenizdeki aykırı değerleri tespit edip filtrelemeyi öğrenmek ve veri kümesi çok büyükse — belki rastgele örnekleme ile başlamak — sayılabilir. Ancak bunlar da kendi başlarına geniş konulardır ve genellemesi zordur.
Gerçek dünya kullanım durumları genellikle daha karmaşık olabilir ve kendine özgü çözümler gerektirebilir; ancak amaç küçük başlayıp yolda öğrenmek, daha fazlasını keşfetmek ve farklı veri kümeleriyle pratik yapmaktır! Daha fazla araç ve püf noktayı öğrenmek için DataCamp'in Python'da Veri Temizleme kursuna mutlaka göz atın; sonunda Gapminder Foundation'dan elde edilen gerçek dünyadan, dağınık bir veri kümesi üzerinde çalışma fırsatı da bulacaksınız. Hadi başlayın!
Python Kursları
Kurs
Kurs
Kurs
blog
Dario Radečić
15 dk.
blog
Abid Ali Awan
14 dk.
Eğitim
Adel Nehme
Eğitim
Kurtis Pykes
8 dk.




