कोर्स
Python परिचय
4 घंटा
7M
यह ट्यूटोरियल आपको डेटा तैयारी के कुछ बुनियादी सिद्धांतों और चरणों से परिचित कराएगा। किसी भी प्रकार का डेटासेट मिलने के बाद डेटा तैयारी पहला कदम होता है। इसी चरण में आप कच्चे डेटा को ऐसी अवस्था में प्री-प्रोसेस करते हैं कि उसका आसानी से और सटीक विश्लेषण किया जा सके। उचित डेटा तैयारी से विश्लेषण कुशल बनता है — यह डेटा एकत्रीकरण के दौरान हुई गलतियों और अशुद्धियों को दूर कर सकता है और इस प्रकार घटिया डेटा गुणवत्ता से उत्पन्न पूर्वाग्रह को कम करने में मदद कर सकता है। इसलिए एक विश्लेषक का काफी समय इसी महत्वपूर्ण चरण में लगता है।
डेटा लोड करना, डेटा की सफाई करना (अनावश्यक या त्रुटिपूर्ण डेटा हटाना), डेटा के फॉर्मेट बदलना, और डेटा को पुनर्व्यवस्थित करना — ये सभी डेटा तैयारी के अंतर्गत आने वाले चरण हैं। इस ट्यूटोरियल में, आप डेटा तैयारी के लिए Python की Pandas लाइब्रेरी के साथ काम करेंगे।
सुनिश्चित करें कि आप Pandas DataFrame, Series आदि जैसे कॉन्सेप्ट समझते हैं, क्योंकि इस ट्यूटोरियल में इनका बार-बार उल्लेख होगा। आप DataCamp के Pandas ट्यूटोरियल में pandas के बारे में गहराई से सीख सकते हैं।
इस ट्यूटोरियल में:
रास्ते में, आपको कुछ टिप्स और ट्रिक्स मिलेंगे, साथ ही किसी विषय में और गहराई से जाने के लिए संदर्भ सामग्री भी दी गई है।
आईए Pandas का संक्षिप्त परिचय लेकर शुरू करते हैं...
Pandas Python के लिए लिखी गई एक सॉफ्टवेयर लाइब्रेरी है। यह डेटा साइंस समुदाय में बहुत लोकप्रिय है क्योंकि यह शक्तिशाली, अभिव्यंजक और लचीली डेटा संरचनाएँ प्रदान करती है, जिनसे डेटा का हेरफेर और विश्लेषण आसान हो जाता है, और यह निःशुल्क उपलब्ध है। इसके अलावा, यदि आपके पास कोई विशेष और नया उपयोग मामला है, तो आप उसे Python मेलिंग लिस्टों में से किसी पर या pandas GitHub साइट पर साझा भी कर सकते हैं — वास्तव में, pandas की अधिकांश कार्यक्षमताएँ इसी तरह वास्तविक दुनिया के उपयोग मामलों से प्रेरित होकर विकसित हुई हैं।
pandas का उत्कृष्ट परिचय पाने के लिए DataCamp का Pandas Foundation कोर्स अवश्य देखें। यह बहुत इंटरैक्टिव है, और पहला अध्याय निःशुल्क है!
pandas लाइब्रेरी का उपयोग करने के लिए, आपको पहले इसे इम्पोर्ट करना होगा। बस अपने python कंसोल में यह लिखें:
import pandas as pdडेटा तैयारी का पहला कदम है... यानी, कुछ डेटा जुटाना। यदि आपके पास .csv फ़ाइल है, तो आप pandas में .read_csv() फ़ंक्शन का उपयोग करके इसे अपने सिस्टम में आसानी से लोड कर सकते हैं। इसके बाद आप लिख सकते हैं:
data = pd.read_csv('path_to_file.csv')
हालाँकि, इस ट्यूटोरियल में, आप चलते-चलते बनाए गए कुछ छोटे, आसानी से समझ आने वाले DataFrames और Series के साथ काम करेंगे।
यह डेटा विश्लेषण की दुनिया में एक व्यापक समस्या है।
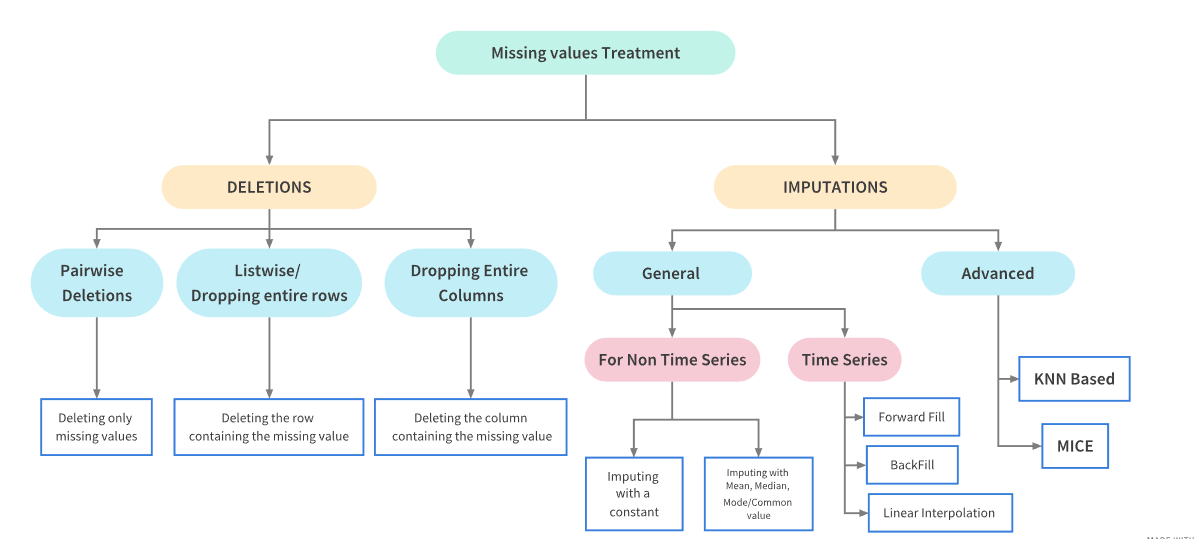
मिसिंग डेटा कई कारणों से उत्पन्न हो सकता है: किसी विशेष फ़ील्ड के लिए उपयोगकर्ता/डेटा संग्रहण ऐप्लिकेशन ने डेटा नहीं जोड़ा, मैनुअल ट्रांसफर के दौरान डेटा खो गया, प्रोग्रामिंग त्रुटि आदि। कभी-कभी कारण समझना आवश्यक होता है क्योंकि यह निर्धारित करता है कि आप ऐसे डेटा से कैसे निपटेंगे। लेकिन यह इस ट्यूटोरियल में आगे आएगा। फिलहाल, ध्यान दें कि यदि आपके पास मिसिंग डेटा है तो क्या करना चाहिए...
सांख्यिकीय डेटा के लिए, pandas मिसिंग डेटा को दर्शाने के लिए फ्लोटिंग-पॉइंट मान NaN (Not a Number) का उपयोग करता है। यह Numpy लाइब्रेरी में परिभाषित एक अद्वितीय मान है, इसलिए हमें इसे भी इम्पोर्ट करना होगा। संगणनात्मक गति और सुविधा के कारण NaN डिफ़ॉल्ट मिसिंग वैल्यू मार्कर है। यह एक सेंटिनल वैल्यू है, यानी डमी या फ़्लैग वैल्यू जिसे pandas के फ़ंक्शन्स से आसानी से पहचानकर प्रोसेस किया जा सकता है।
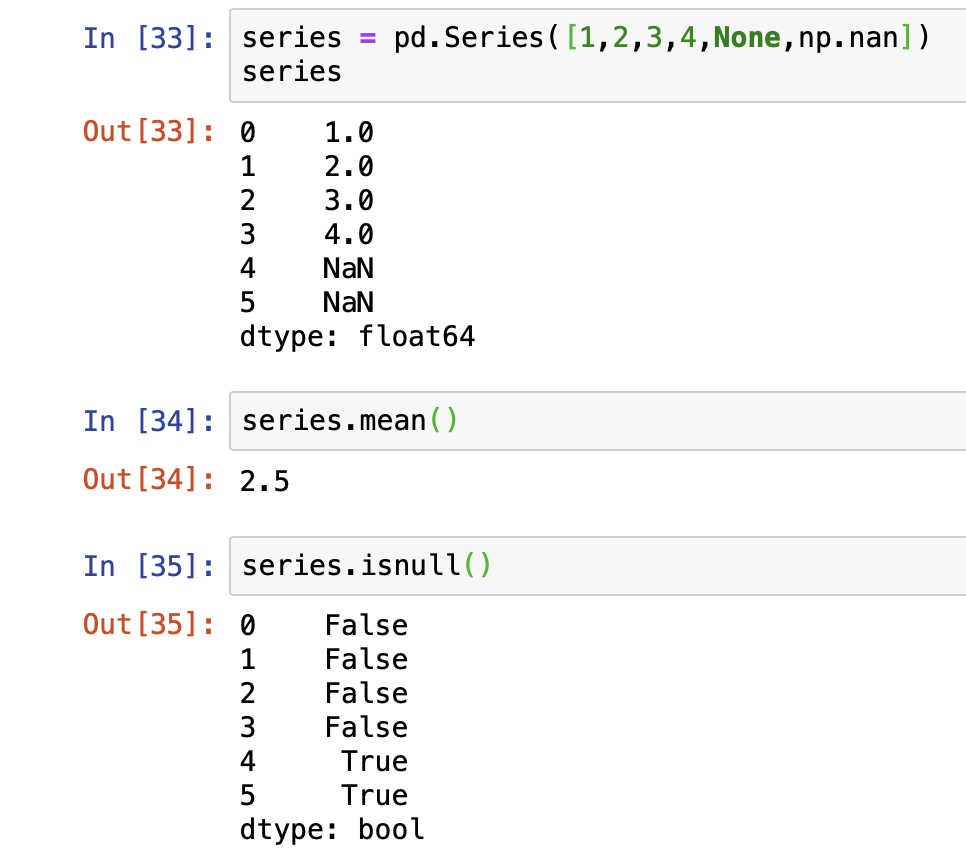
आइए कुछ डेटा के साथ खेलते हैं...
import numpy as np

# Creating a pandas series
data = pd.Series([0, 1, 2, 3, 4, 5, np.nan, 6, 7, 8])

# To check if and what index in the dataset contains null value
data.isnull()
0    False
1    False
2    False
3    False
4    False
5    False
6     True
7    False
8    False
9    False
dtype: bool
ऊपर, हमने isnull() फ़ंक्शन का उपयोग किया जो बूलियन true या false मान लौटाता है। True तब होता है जब उस विशेष इंडेक्स पर डेटा वास्तव में मिसिंग या NaN हो। इसका विपरीत notnull() फ़ंक्शन है।
# To check where the dataset does not contain null value - opposite of isnull()
data.notnull()
0     True
1     True
2     True
3     True
4     True
5     True
6    False
7     True
8     True
9     True
dtype: bool
इसके अलावा, हम dropna() फ़ंक्शन का उपयोग करके मिसिंग डेटा को फ़िल्टर कर सकते हैं और null (मिसिंग) मान को हटाकर केवल non-null मान देख सकते हैं। हालाँकि, NaN मान वास्तव में डिलीट नहीं होता और मूल डेटासेट में मौजूद रहता है।
# Will not show the index 6 cause it contains null (NaN) value
data.dropna()
0    0.0
1    1.0
2    2.0
3    3.0
4    4.0
5    5.0
7    6.0
8    7.0
9    8.0
dtype: float64
data
0    0.0
1    1.0
2    2.0
3    3.0
4    4.0
5    5.0
6    NaN
7    6.0
8    7.0
9    8.0
dtype: float64
आप वास्तव में NaN मान को "ड्रॉप" या डिलीट करने के लिए, या तो नया डेटासेट (बिना NaN) अलग से स्टोर कर सकते हैं ताकि मूल Series छेड़ी न जाए, या inplace ड्रॉप लागू कर सकते हैं। inplace आर्ग्युमेंट का डिफ़ॉल्ट मान false है।
not_null_data = data.dropna()
not_null_data
0    0.0
1    1.0
2    2.0
3    3.0
4    4.0
5    5.0
7    6.0
8    7.0
9    8.0
dtype: float64
# Drop the 6th index in the original 'data' since it has a NaN place
data.dropna(inplace = True)
data
0    0.0
1    1.0
2    2.0
3    3.0
4    4.0
5    5.0
7    6.0
8    7.0
9    8.0
dtype: float64
हालाँकि, डेटा फ्रेम अधिक जटिल और 2-डायमेंशन भी हो सकते हैं, यानी इनमें पंक्तियाँ और कॉलम होते हैं। Pandas यहाँ भी आपके काम आता है...
# Creating a dataframe with 4 rows and 4 columns (4*4 matrix)
data_dim = pd.DataFrame([[1,2,3,np.nan],[4,5,np.nan,np.nan],[7,np.nan,np.nan,np.nan],[np.nan,np.nan,np.nan,np.nan]])
data_dim
| 0 | 1 | 2 | 3 | |
|---|---|---|---|---|
| 0 | 1.0 | 2.0 | 3.0 | NaN |
| 1 | 4.0 | 5.0 | NaN | NaN |
| 2 | 7.0 | NaN | NaN | NaN |
| 3 | NaN | NaN | NaN | NaN |
अब मान लीजिए आप केवल वही पंक्तियाँ या कॉलम हटाना चाहते हैं जो सभी null हों, या केवल वे जिनमें निश्चित संख्या से अधिक null मान हों। अलग-अलग स्थितियाँ देखें, ध्यान रखें कि ड्रॉप inplace नहीं हो रहा, इसलिए असली डेटासेट नहीं बदलेगा। dropna() फ़ंक्शन को दिए गए आर्ग्युमेंट्स पर ध्यान दें कि आप मिसिंग डेटा कैसे ड्रॉप कर रहे हैं।
# Drop all rows and columns containing NaN value
data_dim.dropna()
| 0 | 1 | 2 | 3 |
|---|
# Drop all rows and columns containing entirely of NaN value
data_dim.dropna(how = 'all')
| 0 | 1 | 2 | 3 | |
|---|---|---|---|---|
| 0 | 1.0 | 2.0 | 3.0 | NaN |
| 1 | 4.0 | 5.0 | NaN | NaN |
| 2 | 7.0 | NaN | NaN | NaN |
# Drop only columns that contain entirely NaN value
# Default is 0 - which signifies rows
data_dim.dropna(axis = 1, how = 'all')
| 0 | 1 | 2 | |
|---|---|---|---|
| 0 | 1.0 | 2.0 | 3.0 |
| 1 | 4.0 | 5.0 | NaN |
| 2 | 7.0 | NaN | NaN |
| 3 | NaN | NaN | NaN |
# Drop all columns that have more than 2 NaN values
data_dim.dropna(axis = 1, thresh = 2)
| 0 | 1 | |
|---|---|---|
| 0 | 1.0 | 2.0 |
| 1 | 4.0 | 5.0 |
| 2 | 7.0 | NaN |
| 3 | NaN | NaN |
# Drop all rows that have more than 2 NaN values
data_dim.dropna(thresh = 2)
| 0 | 1 | 2 | 3 | |
|---|---|---|---|---|
| 0 | 1.0 | 2.0 | 3.0 | NaN |
| 1 | 4.0 | 5.0 | NaN | NaN |
अब आप जानते हैं कि मिसिंग मानों की पहचान और ड्रॉप कैसे करें — चाहे परिणामस्वरूप डेटासेट देखने के लिए या inplace डिलीशन करने के लिए। कई मामलों में, null मानों को सीधे हटाना संभव नहीं होता, और आप मिसिंग डेटा को किसी अन्य मान से भरना चाहेंगे। देखिए यह कैसे किया जा सकता है...
null डेटा को बदलने या "भरने" के लिए आप fillna() फ़ंक्शन का उपयोग कर सकते हैं। उदाहरण के लिए, ऊपर वाले ही डेटासेट का उपयोग करके NaN मानों को 0 से भरकर देखते हैं।
# Check what the dataset looks like again
data_dim
| 0 | 1 | 2 | 3 | |
|---|---|---|---|---|
| 0 | 1.0 | 2.0 | 3.0 | NaN |
| 1 | 4.0 | 5.0 | NaN | NaN |
| 2 | 7.0 | NaN | NaN | NaN |
| 3 | NaN | NaN | NaN | NaN |
# Fill the NaN values with 0
data_dim_fill = data_dim.fillna(0)
data_dim_fill
| 0 | 1 | 2 | 3 | |
|---|---|---|---|---|
| 0 | 1.0 | 2.0 | 3.0 | 0.0 |
| 1 | 4.0 | 5.0 | 0.0 | 0.0 |
| 2 | 7.0 | 0.0 | 0.0 | 0.0 |
| 3 | 0.0 | 0.0 | 0.0 | 0.0 |
और dropna() की तरह, आप दिए गए आर्ग्युमेंट के प्रकार के आधार पर और भी कई चीजें कर सकते हैं। साथ ही याद रखें कि inplace = True आर्ग्युमेंट देने पर बदलाव मूल डेटासेट में हो जाएगा।
# Pass a dictionary to use differnt values for each column
data_dim_fill = data_dim.fillna({0: 0, 1: 8, 2: 9, 3: 10})
data_dim_fill
| 0 | 1 | 2 | 3 | |
|---|---|---|---|---|
| 0 | 1.0 | 2.0 | 3.0 | 10.0 |
| 1 | 4.0 | 5.0 | 9.0 | 10.0 |
| 2 | 7.0 | 8.0 | 9.0 | 10.0 |
| 3 | 0.0 | 8.0 | 9.0 | 10.0 |
आप fillna() फ़ंक्शन को method आर्ग्युमेंट दे सकते हैं जो non-null मानों को आगे (ffill या pad) या पीछे (bfill या backfill) स्वतः प्रसारित करता है।
# Pass method to determine how to fill-up the column - forward here
data_dim_fill = data_dim.fillna(method='ffill')
data_dim_fill
| 0 | 1 | 2 | 3 | |
|---|---|---|---|---|
| 0 | 1.0 | 2.0 | 3.0 | NaN |
| 1 | 4.0 | 5.0 | 3.0 | NaN |
| 2 | 7.0 | 5.0 | 3.0 | NaN |
| 3 | 7.0 | 5.0 | 3.0 | NaN |
आप ऊपर फिल की संख्या सीमित भी कर सकते हैं। उदाहरण के लिए, कॉलम में केवल दो स्थान भरें... साथ ही, यदि आप axis = 1 पास करते हैं तो यह रो मानों को अनुरूप रूप से भरेगा।
# Pass method to determine how to fill-up the column - forward here
data_dim_fill = data_dim.fillna(method='ffill', limit = 2)
data_dim_fill
| 0 | 1 | 2 | 3 | |
|---|---|---|---|---|
| 0 | 1.0 | 2.0 | 3.0 | NaN |
| 1 | 4.0 | 5.0 | 3.0 | NaN |
| 2 | 7.0 | 5.0 | 3.0 | NaN |
| 3 | 7.0 | 5.0 | NaN | NaN |
# Pass method to determine how to fill-up the row - forward here
data_dim_fill = data_dim.fillna(axis = 1, method='ffill')
data_dim_fill
| 0 | 1 | 2 | 3 | |
|---|---|---|---|---|
| 0 | 1.0 | 2.0 | 3.0 | 3.0 |
| 1 | 4.0 | 5.0 | 5.0 | 5.0 |
| 2 | 7.0 | 7.0 | 7.0 | 7.0 |
| 3 | NaN | NaN | NaN | NaN |
डेटा और अपने उपयोग-केस की कुछ समझ के साथ, आप fillna() फ़ंक्शन का उपयोग केवल संख्याओं से भरने से आगे कई तरीकों से कर सकते हैं। आप इसे mean() का उपयोग करके औसत या median() का उपयोग करके माध्यिका मान से भी भर सकते हैं...
# Check the data_dim dataset
data_dim
| 0 | 1 | 2 | 3 | |
|---|---|---|---|---|
| 0 | 1.0 | 2.0 | 3.0 | NaN |
| 1 | 4.0 | 5.0 | NaN | NaN |
| 2 | 7.0 | NaN | NaN | NaN |
| 3 | NaN | NaN | NaN | NaN |
# Fill the NaN value with mean values in the corresponding column
data_dim_fill = data_dim.fillna(data_dim.mean())
data_dim_fill
| 0 | 1 | 2 | 3 | |
|---|---|---|---|---|
| 0 | 1.0 | 2.0 | 3.0 | NaN |
| 1 | 4.0 | 5.0 | 3.0 | NaN |
| 2 | 7.0 | 3.5 | 3.0 | NaN |
| 3 | 4.0 | 3.5 | 3.0 | NaN |
अब तक, आपने केवल मिसिंग डेटा (NaN) के साथ काम किया है, लेकिन कुछ स्थितियों में आप किसी non-null मान को किसी अन्य मान से बदलना चाहेंगे। या हो सकता है कि कोई null मान किसी यादृच्छिक संख्या के रूप में दर्ज हुआ हो, और इसलिए उसे संख्या के बजाय NaN की तरह प्रोसेस करना आवश्यक हो। ऐसे में replace() फ़ंक्शन उपयोगी होता है...
इस बार एक अलग डेटासेट बनाते हैं।
data = pd.Series([1,2,-99,4,5,-99,7,8,-99])
data
0     1
1     2
2   -99
3     4
4     5
5   -99
6     7
7     8
8   -99
dtype: int64
# Replace the placeholder -99 as NaN
data.replace(-99, np.nan)
0    0.0
1    1.0
2    2.0
3    3.0
4    4.0
5    5.0
7    6.0
8    7.0
9    8.0
dtype: float64
आप अब -99 नहीं देखेंगे, क्योंकि उसे NaN से बदल दिया गया है और इसलिए वह दिखता नहीं। इसी तरह, आप कई मानों को भी बदल सकते हैं। इसके लिए, हम एक अन्य series बनाएँगे और फिर मूल data series को नई series के साथ जोड़ेंगे, और उसके बाद multiple value replace फ़ंक्शन लागू करेंगे।
इसके लिए, हम pandas में concat() फ़ंक्शन का उपयोग कर सकते हैं। संयोजन लागू करने के बाद इंडेक्सिंग को जारी रखने के लिए, आप इसमें ignore_index = True आर्ग्युमेंट पास कर सकते हैं।
# Create a new Series
new_data = pd.Series([-100, 11, 12, 13])
combined_series = pd.concat([data, new_data], ignore_index = True)
combined_series
0       1
1       2
2     -99
3       4
4       5
5     -99
6       7
7       8
8     -99
9    -100
10     11
11     12
12     13
dtype: int64
# Let's replace -99 and -100 as NaN in the new combined_series
data_replaced = combined_series.replace([-99, -100], np.nan)
data_replaced
0      1.0
1      2.0
2      NaN
3      4.0
4      5.0
5      NaN
6      7.0
7      8.0
8      NaN
9      NaN
10    11.0
11    12.0
12    13.0
dtype: float64
# Argument passed can also be a dictionary with separate values
data_replaced = combined_series.replace({-99: np.nan, -100: 0})

# Same as: new_data.replace([-99, -100], [np.nan, 0])
data_replaced
0      1.0
1      2.0
2      NaN
3      4.0
4      5.0
5      NaN
6      7.0
7      8.0
8      NaN
9      0.0
10    11.0
11    12.0
12    13.0
dtype: float64
कुछ स्थितियों में, आप किसी लॉजिक के आधार पर, जो आपके पास पहले से है, उसमें और अंतर्दृष्टि जोड़ना चाहेंगे। तब आप maps और फ़ंक्शनों के संयोजन की मदद लेकर मनचाहा हासिल कर सकते हैं। लॉजिक और जटिल हो सकता है, लेकिन इस उदाहरण से समझने की कोशिश करें।
मान लीजिए, आपके पास एक डेटा फ्रेम है जिसमें संख्याएँ अंग्रेज़ी शब्दों में उनके समकक्ष के साथ मैप की गई हैं।
data_number = pd.DataFrame({'english': ['zero','one','two','three','four','five'],
'digits': [0,1,2,3,4,5]})
data_number
| english | digits | |
|---|---|---|
| 0 | zero | 0 |
| 1 | one | 1 |
| 2 | two | 2 |
| 3 | three | 3 |
| 4 | four | 4 |
| 5 | five | 5 |
मान लीजिए अब आप एक और कॉलम जोड़ना चाहते हैं जो दो के गुणकों को 'Yes' और बाकी को 'No' इंगित करे। आप प्रत्येक विशिष्ट अंग्रेज़ी शब्द का उसके 'Yes' या 'No' से मैप लिख सकते हैं।
english_to_multiple = {
    'two': 'yes',
    'four': 'yes'
}
फिर आप map फ़ंक्शन कॉल करके वह कॉलम जोड़ सकते हैं जहाँ English कॉलम 2 का गुणक हो। अन्य non-multiple नंबर कॉलम में क्या भरा जाएगा? चलिए देखते हैं...
data_number['multiple'] = data_number['english'].map(english_to_multiple)
data_number
| english | digits | multiple | |
|---|---|---|---|
| 0 | zero | 0 | NaN |
| 1 | one | 1 | NaN |
| 2 | two | 2 | yes |
| 3 | three | 3 | NaN |
| 4 | four | 4 | yes |
| 5 | five | 5 | NaN |
दूसरे कॉलम NaN मानों से भरे हैं, और आप पहले ही सीख चुके हैं कि मिसिंग मानों के साथ आगे कैसे काम करें। यह एक सरल उदाहरण था। उम्मीद है आप यहाँ से प्रेरणा लेकर map फ़ंक्शन का उपयोग और भी चीज़ें करने और अपने विशिष्ट उपयोग-केस में लागू करने का तरीका खोजेंगे।
कभी-कभी आप किसी लॉजिक के आधार पर श्रेणीकरण करना चाहेंगे और विश्लेषण के उद्देश्य से सभी डेटा को अलग-अलग डिस्क्रीट बकेट या बिन में रखना चाहेंगे। इसके लिए आप cut() फ़ंक्शन का उपयोग कर सकते हैं। उदाहरण के लिए, पहले 1 - 100 के बीच 30 यादृच्छिक संख्याओं वाला एक डेटासेट बनाते हैं।
import random

data = random.sample(range(1, 101), 30)
# data
[45,
 39,
 25,
 83,
 27,
 6,
 73,
 43,
 36,
 93,
 97,
 17,
 15,
 99,
 37,
 5,
 31,
 22,
 65,
 30,
 3,
 26,
 91,
 12,
 52,
 76,
 63,
 84,
 59,
 53]
मान लें कि हम इन्हें अपने परिभाषित कुछ बकेट्स में वर्गीकृत करना चाहते हैं: 1 - 25, फिर 25 - 35, 40 - 60, फिर 60 - 80 और फिर शेष। तो हम एक बकेट परिभाषित करते हैं...
फिर हम cut फ़ंक्शन का उपयोग करेंगे।
# Defining the starting value for each bucket
bucket = [1, 25, 35, 60, 80, 100]

cut_data = pd.cut(data, bucket)
cut_data
[(35, 60], (35, 60], (1, 25], (80, 100], (25, 35], ..., (60, 80], (60, 80], (80, 100], (35, 60], (35, 60]]
Length: 30
Categories (5, interval[int64]): [(1, 25] < (25, 35] < (35, 60] < (60, 80] < (80, 100]]
cut() बहुत उपयोगी फ़ंक्शन है, और इससे आप और भी बहुत कुछ कर सकते हैं। इसके बारे में अधिक जानने के लिए Pandas दस्तावेज़ देखना अत्यधिक अनुशंसित है।
जब आप किसी श्रेणीबद्ध (categorical) डेटा को संख्यात्मक मानों में बदलना चाहते हैं ताकि उसे अपने डेटा विश्लेषण मॉडल में उपयोग कर सकें, तब यह विषय विशेष रूप से उपयोगी होता है। यह खासकर मशीन लर्निंग मॉडलिंग में काम आता है, जहाँ वन-हॉट एनकोडिंग की अवधारणा प्रसिद्ध है। तकनीकी शब्दों में: वन-हॉट एनकोडिंग श्रेणीबद्ध मानों को 1-आयामी संख्यात्मक वेक्टर में बदलने की प्रक्रिया है।
pandas का उपयोग करके इसे करने का एक तरीका get_dummies() फ़ंक्शन है। यदि आपके डेटा फ्रेम में किसी कॉलम में 'n' विशिष्ट मान हैं, तो यह फ़ंक्शन 'n' कॉलम वाला एक मैट्रिक्स तैयार करेगा जिसमें 1s और 0s होंगे। आइए एक उदाहरण से इसे देखते हैं ताकि अवधारणा बेहतर समझ आए...
# Creating a DataFrame consiting individual characters in the list
data = pd.Series(list('abcdababcdabcd'))
data
0     a
1     b
2     c
3     d
4     a
5     b
6     a
7     b
8     c
9     d
10    a
11    b
12    c
13    d
dtype: object
मान लीजिए अब आप प्रत्येक कैरेक्टर की उपस्थिति दर्शाने वाले अलग-अलग वेक्टर बनाना चाहते हैं ताकि उन्हें किसी फ़ंक्शन में फीड किया जा सके।
कुछ इस तरह: 'a' के लिए = [1,0,0,0,1,0,1,0,0,0,1,0,0,0] जहाँ 1 उस स्थिति में है जहाँ 'a' मौजूद है और 0 जहाँ नहीं है। get_dummies() फ़ंक्शन का उपयोग करने से यह कार्य आसान हो जाएगा।
pd.get_dummies(data)
| a | b | c | d | |
|---|---|---|---|---|
| 0 | 1 | 0 | 0 | 0 |
| 1 | 0 | 1 | 0 | 0 |
| 2 | 0 | 0 | 1 | 0 |
| 3 | 0 | 0 | 0 | 1 |
| 4 | 1 | 0 | 0 | 0 |
| 5 | 0 | 1 | 0 | 0 |
| 6 | 1 | 0 | 0 | 0 |
| 7 | 0 | 1 | 0 | 0 |
| 8 | 0 | 0 | 1 | 0 |
| 9 | 0 | 0 | 0 | 1 |
| 10 | 1 | 0 | 0 | 0 |
| 11 | 0 | 1 | 0 | 0 |
| 12 | 0 | 0 | 1 | 0 |
| 13 | 0 | 0 | 0 | 1 |
हालाँकि, यह शुरुआत करने में मदद के लिए एक सरल उदाहरण है। वास्तविक दुनिया के अनुप्रयोगों में किसी कैरेक्टर की सदस्यता एक ही समय में कई श्रेणियों से हो सकती है, इसलिए आपको अधिक परिष्कृत तरीकों को सीखना होगा। साथ ही बहुत बड़े डेटा के लिए, यह फ़ंक्शन गति के लिहाज से बहुत कुशल नहीं हो सकता। DataCamp का Handling Categorical Data in Python ऐसे मामलों और इस विषय पर अधिक गहराई से चर्चा करता है।
ठीक है, आप ट्यूटोरियल के अंत में हैं, और आपने डेटा विश्लेषण की अपनी राह के पहले कदम के लिए कुछ बुनियादी टूल सीख लिए हैं। डेटा तैयारी के चरणों के लिए अन्य कौशलों में अपने डेटासेट में आउट्लायर्स का पता लगाना और उन्हें फ़िल्टर करना सीखना शामिल होगा और यदि डेटासेट बहुत बड़ा है — तो शायद रैंडम सैंपलिंग से शुरू करें। लेकिन ये अपने आप में फिर व्यापक विषय हैं और सामान्यीकृत करना कठिन है।
वास्तविक दुनिया के उपयोग-केस अक्सर अधिक जटिल हो सकते हैं और अपने अनूठे समाधान की आवश्यकता हो सकती है, लेकिन विचार यह है कि छोटा शुरू करें, रास्ते में सीखें, अधिक खोज करें और अलग-अलग डेटासेट पर हाथ गंदे करें! और अधिक टूल और ट्रिक्स सीखने के लिए DataCamp का Cleaning Data in Python कोर्स अवश्य देखें, और अंत में, आपको Gapminder Foundation से प्राप्त एक वास्तविक, अव्यवस्थित डेटासेट पर काम करने का मौका मिलता है। शुरू हो जाइए!
Python कोर्स
कोर्स
कोर्स
कोर्स