Kursus
Konsep Generative AI
2 jam
121.2K
Databricks baru-baru ini memperkenalkan DBRX, model bahasa besar (LLM) serbaguna dan terbuka yang dibangun di atas arsitektur mixture-of-experts (MoE) dengan pendekatan bertingkat halus. Alih-alih menggunakan satu jaringan saraf untuk semua tugas, sistem ini terdiri dari banyak jaringan "pakar" khusus, masing-masing dioptimalkan untuk jenis tugas atau data yang berbeda.
Model ini menunjukkan kinerja lebih baik dibandingkan LLM tradisional seperti GPT-3.5 dan Llama 2 karena lebih cepat dan lebih hemat biaya. Menurut pengujian, DBRX meraih skor 73,7%, lebih tinggi daripada LLaMa2 (69,8%) dalam tugas pemahaman bahasa.
Dalam artikel ini, kami akan membahas kemampuannya dan cara memulai dengan Databricks DBRX secara lebih mendalam.
DBRX menggunakan arsitektur decoder-only berbasis transformer yang dilatih dengan prediksi token berikutnya. Model ini mengadopsi arsitektur mixture-of-experts (MoE) bertingkat halus. Para ‘pakar’ ini merujuk pada agen-agen khusus berbasis LLM yang diperkaya dengan pengetahuan domain dan kemampuan bernalar.
DBRX memiliki banyak pakar berukuran kecil (total 16 pakar) dan memilih subsetnya (4 pakar) untuk setiap masukan yang diberikan.
Sederhananya, pendekatan bertingkat halus dengan 65x lebih banyak kemungkinan kombinasi pakar ini meningkatkan kualitas model dibandingkan model MoE terbuka lain seperti Mixtral dan Grok-1, yang memiliki lebih sedikit pakar dan memilih lebih sedikit pakar per masukan.
Berikut beberapa detail kunci tentang DBRX:
Model ini dipra-latih pada himpunan data yang sangat besar, diperkirakan dua kali lebih efektif daripada himpunan data sebelumnya yang digunakan Databricks. Serangkaian alat Databricks, seperti Apache Spark dan notebook Databricks untuk pemrosesan data serta Unity Catalog untuk tata kelola data, digunakan untuk melatih model.
Selama pelatihan, digunakan curriculum learning, dan komposisi data diubah untuk meningkatkan kualitas model secara signifikan. Perubahan strategis dalam komposisi data pelatihan ini mengoptimalkan kemampuan model dalam menangani beragam masukan secara efektif.
Beberapa teknologi kunci yang digunakan untuk pra-pelatihan DBRX mencakup:
Databricks mengklaim model DBRX unggul dibandingkan beberapa model sumber terbuka teratas dalam hal efisiensi dan kinerja tugas.
Berikut perbandingan terperinci tentang bagaimana DBRX bersaing dengan para kompetitornya:
Di bawah ini, kami rangkum perbandingan dalam sebuah tabel, dan menampilkan grafik berdasarkan sebagian hasilnya:
|
Perbandingan Model |
Pengetahuan Umum |
Penalaran Nalar Sehari-hari |
Databricks Gauntlet |
Penalaran Pemrograman |
Penalaran Matematika |
|
DBRX vs LLaMA2-70B |
+9,8% |
+3,1% |
+14% |
+37,9% |
+40,2% |
|
DBRX vs Mixtral Instruct |
+2,3% |
+1,4% |
+6,1% |
+15,3% |
+5,8% |
|
DBRX vs Grok-1 |
+0,7% |
Tidak tersedia |
Tidak tersedia |
+6,9% |
+4% |
|
DBRX vs Mixtral Base |
+1,8% |
+2,5% |
+10% |
+29,9% |
Tidak tersedia |
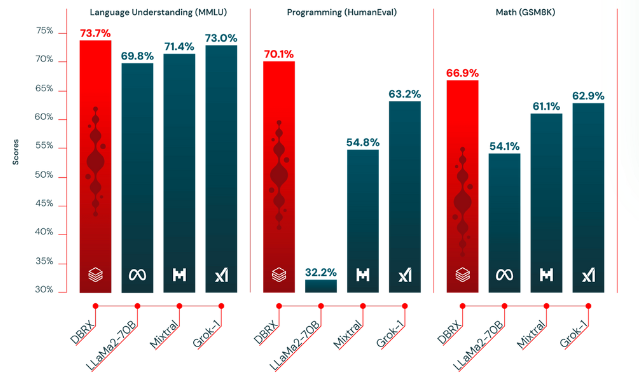
Membandingkan kualitas DBRX dengan LLM sumber terbuka lainnya - sumber
Sebelum mengakses DBRX, pastikan sistem Anda memiliki setidaknya 320GB memori. Lalu ikuti langkah-langkah berikut untuk mengakses DBRX:
transformerspip install "transformers>=4.40.0"from transformers import AutoTokenizer, AutoModelForCausalLM
import torch
tokenizer = AutoTokenizer.from_pretrained("databricks/dbrx-base", token="hf_YOUR_TOKEN")
model = AutoModelForCausalLM.from_pretrained("databricks/dbrx-base", device_map="auto", torch_dtype=torch.bfloat16, token="hf_YOUR_TOKEN")
# Directing tensors to "cuda" (GPU) for faster computation as GPUs are better at handling parallel tasks.
input_text = "Databricks was founded in "
input_ids = tokenizer(input_text, return_tensors="pt").to("cuda")
# DBRX accepts a context length of up to 32768 tokens. Here`max_new_tokens` specifies the maximum number of tokens to generate.
outputs = model.generate(**input_ids, max_new_tokens=100)
print(tokenizer.decode(outputs[0]))Ingin belajar cara menggunakan Transformers dan Hugging Face? Baca tutorial kami tentang penggunaan Transformers dan Hugging Face.
DRBX dapat membantu Anda membuat konten dasar dan merespons prompt seperti LLM lainnya. Berikut yang dapat Anda lakukan dengan DBRX:
DBRX juga dapat melakukan tugas terkait pengodean tingkat lanjut untuk membantu praktisi data atau pengembang:
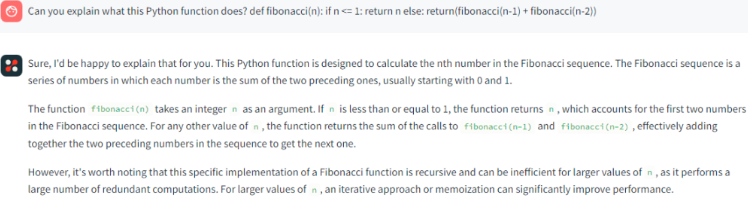
DBRX merespons perintah sederhana - sumber
Anda dapat melakukan fine-tuning DBRX dengan LLM foundry sumber terbuka di Github. Namun, fine-tuning memerlukan contoh pelatihan yang diformat sebagai kamus:
formatted_example = {'prompt': <prompt_text>, 'response': <response_text>}Prompt: Ini adalah pertanyaan atau instruksi awal yang Anda berikan kepada model.
Response: Ini adalah jawaban yang dilatih untuk dihasilkan oleh model.
Anda dapat menggunakan tiga set data berbeda untuk melakukan fine-tune pada LLM apa pun:
Jika Anda ingin melakukan fine-tuning menggunakan dataset dari HuggingFace Hub, dan
dataset tersebut memiliki fungsi prapemrosesan yang telah ditentukan atau sudah mengikuti
format "prompt"/"response", Anda dapat langsung mengarahkan dataloader ke dataset tersebut.
train_loader:
    name: finetuning
    dataset:
        hf_name: tatsu-lab/alpaca
        split: train
        ...
Jika tidak ada fungsi prapemrosesan yang ditentukan, gunakan preprocessing_fn untuk menentukan fungsi prapemrosesan kustom bagi dataloader.
train_loader:
    name: finetuning
    dataset:
        hf_name: mosaicml/doge-facts
        preprocessing_fn: my_data.formatting:dogefacts_prep_fn
        split: train
        ...
Jika Anda sudah memiliki dataset fine-tuning di perangkat, definisikan file JSONL lokal dalam
konfigurasi YAML yamls/finetune/1b_local_data_sft.yaml.
train_loader:
    name: finetuning
    dataset:
        hf_name: json # assuming data files are json formatted
        hf_kwargs:
            data_dir: /path/to/data/dir/
        preprocessing_fn: my.import.path:my_preprocessing_fn
        split: train
        ...
Lewati preprocessing_fn jika data lokal Anda sudah dalam format "prompt"/"response".
Konversikan dataset HuggingFace Anda ke format MDS menggunakan
convert_finetuning_dataset.py.
Setelah mengonversi dataset HuggingFace Anda ke format streaming, cukup sesuaikan konfigurasi YAML seperti ini.
train_loader:
    name: finetuning
    dataset:
        remote: s3://my-bucket/my-copy-doge-facts
        local: /tmp/mds-cache/
        split: train
        ...
Jika Anda ingin melihat fine-tuning parameter penuh, lihat konfigurasi YAML di
Databricks DBRX menggunakan banyak jaringan khusus untuk meningkatkan kecepatan model dan efisiensi biaya. Pendekatan bertingkat halus ini memungkinkannya mengungguli LLM lain dalam menangani tugas-tugas kompleks.
Ingin mempelajari lebih jauh tentang model bahasa besar dan cara melakukan fine-tuning? Lihat sumber daya berikut:
Lanjutkan Perjalanan AI Anda Hari Ini!
Kursus
Kursus
Program
blogs
Dario Radečić
15 mnt
blogs
David Woods
13 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
Javier Canales Luna
14 mnt



