Corso
Concetti di IA generativa
2 ore
121.2K
Databricks ha introdotto di recente DBRX, il suo modello di linguaggio di grandi dimensioni (LLM) generale e open, basato su un'architettura mixture-of-experts (MoE) a grana fine. Invece di usare una singola rete neurale per tutti i compiti, il sistema comprende più reti "esperte" specializzate, ognuna ottimizzata per diversi tipi di attività o dati.
Questo modello ha ottenuto risultati migliori rispetto agli LLM tradizionali come GPT-3.5 e Llama 2 perché è più veloce e più economico. Secondo i test, DBRX totalizza il 73,7%, un punteggio superiore a LLaMa2 (69,8%) nei compiti di comprensione del linguaggio.
In questo articolo parleremo delle sue capacità e di come iniziare a usare Databricks DBRX in modo più dettagliato.
DBRX utilizza un'architettura decoder-only basata su transformer, addestrata con la previsione del token successivo. Impiega un'architettura mixture-of-experts (MoE) a grana fine. Questi "esperti" si riferiscono ad agenti specializzati basati su LLM, arricchiti con conoscenze specifiche di dominio e capacità di ragionamento.
DBRX dispone di un gran numero di esperti più piccoli (16 in totale) e ne seleziona un sottoinsieme (4 esperti) per ogni input.
In poche parole, questo approccio a grana fine, con 65 volte più combinazioni possibili di esperti, migliora la qualità del modello rispetto ad altri modelli MoE open come Mixtral e Grok-1, che hanno meno esperti e ne selezionano meno per input.
Ecco alcuni dettagli chiave su DBRX:
Il modello è stato pre-addestrato su un dataset impressionante, stimato essere due volte più efficace rispetto ai dataset precedenti usati da Databricks. Per l'addestramento è stata utilizzata una suite di strumenti Databricks, come Apache Spark e i notebook Databricks per l'elaborazione dei dati e Unity Catalog per la governance dei dati.
Durante l'addestramento è stato impiegato il curriculum learning e la miscela di dati è stata modificata per migliorare sostanzialmente la qualità del modello. Queste modifiche strategiche nella composizione dei dati di training hanno ottimizzato la capacità del modello di gestire efficacemente input diversificati.
Alcune delle tecnologie chiave utilizzate per il pretraining di DBRX includono:
Databricks sostiene che il suo modello DBRX sia superiore a diversi modelli open source di punta in termini di efficienza e prestazioni sui compiti.
Ecco un confronto dettagliato di come DBRX si posiziona rispetto ai concorrenti:
Di seguito, abbiamo raccolto i confronti in una tabella e mostrato un grafico basato su alcuni dei risultati:
|
Confronto modelli |
Conoscenze generali |
Ragionamento di buon senso |
Databricks Gauntlet |
Ragionamento nella programmazione |
Ragionamento matematico |
|
DBRX vs LLaMA2-70B |
+9,8% |
+3,1% |
+14% |
+37,9% |
+40,2% |
|
DBRX vs Mixtral Instruct |
+2,3% |
+1,4% |
+6,1% |
+15,3% |
+5,8% |
|
DBRX vs Grok-1 |
+0,7% |
Non disponibile |
Non disponibile |
+6,9% |
+4% |
|
DBRX vs Mixtral Base |
+1,8% |
+2,5% |
+10% |
+29,9% |
Non disponibile |
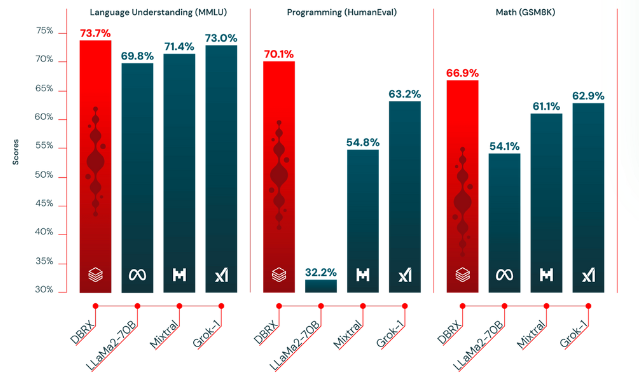
Confronto della qualità di DBRX con altri LLM open source - fonte
Prima di accedere a DBRX, assicurati che il tuo sistema abbia almeno 320 GB di memoria. Poi segui questi passaggi per accedere a DBRX:
transformerspip install "transformers>=4.40.0"from transformers import AutoTokenizer, AutoModelForCausalLM
import torch
tokenizer = AutoTokenizer.from_pretrained("databricks/dbrx-base", token="hf_YOUR_TOKEN")
model = AutoModelForCausalLM.from_pretrained("databricks/dbrx-base", device_map="auto", torch_dtype=torch.bfloat16, token="hf_YOUR_TOKEN")
# Directing tensors to "cuda" (GPU) for faster computation as GPUs are better at handling parallel tasks.
input_text = "Databricks was founded in "
input_ids = tokenizer(input_text, return_tensors="pt").to("cuda")
# DBRX accepts a context length of up to 32768 tokens. Here`max_new_tokens` specifies the maximum number of tokens to generate.
outputs = model.generate(**input_ids, max_new_tokens=100)
print(tokenizer.decode(outputs[0]))Vuoi imparare a usare Transformers e Hugging Face? Leggi il nostro tutorial su Transformers e Hugging Face.
DRBX può aiutarti con la creazione di contenuti di base e con risposte ai prompt come qualsiasi LLM. Ecco cosa puoi fare con DBRX:
DBRX può anche svolgere attività avanzate legate al coding per aiutare data practitioner o sviluppatori:
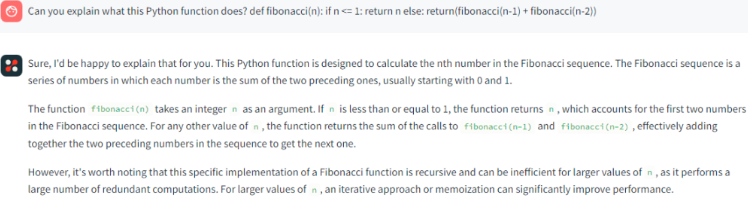
DBRX risponde a comandi semplici - fonte
Puoi fare fine-tuning di DBRX con la LLM foundry open source di Github. Tuttavia, il fine-tuning richiede che gli esempi di training siano formattati come dizionari:
formatted_example = {'prompt': <prompt_text>, 'response': <response_text>}Prompt: È la domanda o l'istruzione iniziale che fornisci al modello.
Response: È la risposta che il modello viene addestrato a generare.
Puoi usare tre diversi dataset per fare fine-tuning di qualsiasi LLM:
Se vuoi fare fine-tuning usando un dataset dall'HuggingFace Hub e il
dataset ha una funzione di pre-processing predefinita o segue già il
formato "prompt"/"response", puoi semplicemente puntare il dataloader a quel dataset.
train_loader:
    name: finetuning
    dataset:
        hf_name: tatsu-lab/alpaca
        split: train
        ...
Se non è definita alcuna funzione di pre-processing, usa preprocessing_fn per specificare una funzione di pre-processing personalizzata per il dataloader.
train_loader:
    name: finetuning
    dataset:
        hf_name: mosaicml/doge-facts
        preprocessing_fn: my_data.formatting:dogefacts_prep_fn
        split: train
        ...
Se hai già un dataset di fine-tuning sul tuo dispositivo, definisci i file JSONL locali nello
YAML di configurazione yamls/finetune/1b_local_data_sft.yaml.
train_loader:
    name: finetuning
    dataset:
        hf_name: json # assuming data files are json formatted
        hf_kwargs:
            data_dir: /path/to/data/dir/
        preprocessing_fn: my.import.path:my_preprocessing_fn
        split: train
        ...
Salta preprocessing_fn se i tuoi dati locali sono già nel formato "prompt"/"response".
Converti il tuo dataset HuggingFace in formato MDS usando lo script
convert_finetuning_dataset.py.
Dopo aver convertito il tuo dataset HuggingFace in un formato di streaming, modifica semplicemente la tua configurazione YAML in questo modo.
train_loader:
    name: finetuning
    dataset:
        remote: s3://my-bucket/my-copy-doge-facts
        local: /tmp/mds-cache/
        split: train
        ...
Se vuoi vedere il fine-tuning a pieno numero di parametri, consulta la configurazione YAML in
Databricks DBRX utilizza più reti specializzate per aumentare la velocità del modello e l'efficienza dei costi. Questo approccio a grana fine gli consente di superare altri LLM nella gestione di compiti complessi.
Vuoi saperne di più sui large language model e su come fare fine-tuning? Dai un'occhiata a queste risorse:
Continua oggi il tuo percorso nell'IA!
Corso
Corso
Programma
blog
Tim Lu
12 min
blog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min



