Cursus
Generatieve AI-concepten
2 uur
121.2K
Databricks heeft onlangs DBRX geïntroduceerd, zijn open general-purpose large language model (LLM) dat is gebouwd op een mixture-of-experts-architectuur (MoE) met een fijnmazige aanpak. In plaats van één neuraal netwerk voor alle taken te gebruiken, bestaat het systeem uit meerdere gespecialiseerde „expert”-netwerken, elk geoptimaliseerd voor verschillende soorten taken of data.
Dit model presteert beter dan traditionele LLM's zoals GPT-3.5 en Llama 2 omdat het sneller en kostenefficiënter is. Volgens tests scoort DBRX 73,7%, hoger dan LLaMa2 (69,8%) bij taken voor taalbegrip.
In dit artikel bespreken we de mogelijkheden en hoe je aan de slag gaat met Databricks DBRX in meer detail.
DBRX gebruikt een transformer-gebaseerde decoder-only-architectuur die is getraind met next-token prediction. Het maakt gebruik van een fijnmazige mixture-of-experts (MoE)-architectuur. Deze ‘experts’ verwijzen naar gespecialiseerde agenten op basis van LLM's, verrijkt met domeinspecifieke kennis en redeneervaardigheden.
DBRX heeft een groot aantal kleinere experts (in totaal 16) en kiest voor elke invoer een subset daarvan (4 experts).
Simpel gezegd: deze fijnmazige aanpak met 65x meer mogelijke combinaties van experts verbetert de modelkwaliteit vergeleken met andere open MoE-modellen zoals Mixtral en Grok-1, die minder experts hebben en per input minder experts selecteren.
Hier zijn enkele kerngegevens over DBRX:
Het model is voorgetraind op een indrukwekkend grote dataset, die naar schatting twee keer zo effectief is als eerdere datasets die door Databricks zijn gebruikt. Een reeks Databricks-tools, zoals Apache Spark en Databricks-notebooks voor dataverwerking en Unity Catalog voor datagovernance, is gebruikt om het model te trainen.
Tijdens de training is gebruikgemaakt van curriculum learning en is de datamix aangepast om de modelkwaliteit substantieel te verbeteren. Dergelijke strategische aanpassingen in de trainingsdatamix optimaliseerden het vermogen van het model om diverse inputs effectief te verwerken.
Enkele van de belangrijkste technologieën die voor de pretraining van DBRX zijn gebruikt, zijn:
Databricks stelt dat het DBRX-model superieur is aan verschillende toonaangevende open-sourcemodellen wat betreft efficiëntie en taakprestatie.
Hier is een uitgebreide vergelijking van hoe DBRX zich verhoudt tot zijn concurrenten:
Hieronder hebben we de vergelijkingen samengebracht in een tabel en een grafiek getoond op basis van enkele resultaten:
|
Modelvergelijking |
Algemene kennis |
Gezond-verstand-redeneren |
Databricks Gauntlet |
Redeneren over programmeren |
Wiskundig redeneren |
|
DBRX vs LLaMA2-70B |
+9,8% |
+3,1% |
+14% |
+37,9% |
+40,2% |
|
DBRX vs Mixtral Instruct |
+2,3% |
+1,4% |
+6,1% |
+15,3% |
+5,8% |
|
DBRX vs Grok-1 |
+0,7% |
Niet beschikbaar |
Niet beschikbaar |
+6,9% |
+4% |
|
DBRX vs Mixtral Base |
+1,8% |
+2,5% |
+10% |
+29,9% |
Niet beschikbaar |
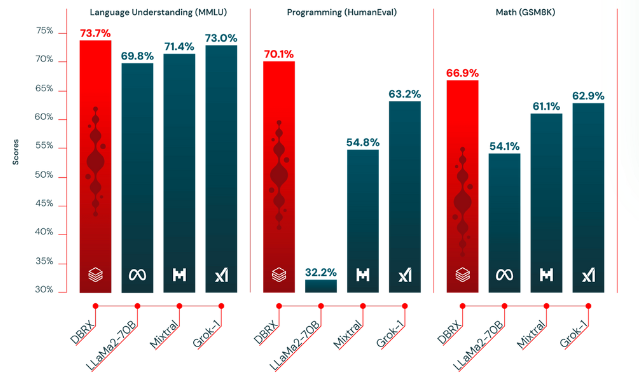
Vergelijking van de kwaliteit van DBRX met andere open-source LLM's - bron
Zorg ervoor dat je systeem minstens 320GB geheugen heeft voordat je DBRX gebruikt. Volg daarna deze stappen om toegang te krijgen tot DBRX:
transformerspip install "transformers>=4.40.0"from transformers import AutoTokenizer, AutoModelForCausalLM
import torch
tokenizer = AutoTokenizer.from_pretrained("databricks/dbrx-base", token="hf_YOUR_TOKEN")
model = AutoModelForCausalLM.from_pretrained("databricks/dbrx-base", device_map="auto", torch_dtype=torch.bfloat16, token="hf_YOUR_TOKEN")
# Directing tensors to "cuda" (GPU) for faster computation as GPUs are better at handling parallel tasks.
input_text = "Databricks was founded in "
input_ids = tokenizer(input_text, return_tensors="pt").to("cuda")
# DBRX accepts a context length of up to 32768 tokens. Here`max_new_tokens` specifies the maximum number of tokens to generate.
outputs = model.generate(**input_ids, max_new_tokens=100)
print(tokenizer.decode(outputs[0]))Wil je leren werken met Transformers en Hugging Face? Lees onze tutorial over het gebruik van Transformers en Hugging Face.
DRBX kan je helpen met basiscontentcreatie en promptantwoorden zoals elke LLM. Dit kun je doen met DBRX:
DBRX kan ook geavanceerde coderelated taken uitvoeren om dataprofessionals of coders te helpen:
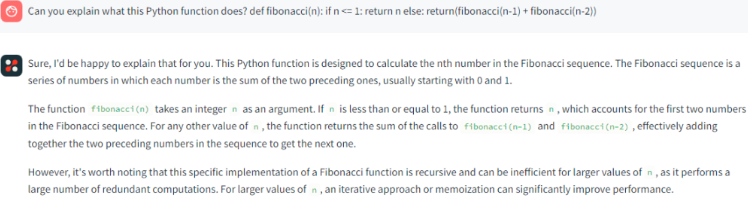
DBRX reageert op eenvoudige opdrachten - bron
Je kunt DBRX fijn-afstemmen met de open-source LLM Foundry van Github. Fijn-afstemmen vereist echter dat trainingsvoorbeelden worden geformatteerd als dictionaries:
formatted_example = {'prompt': <prompt_text>, 'response': <response_text>}Prompt: Dit is de startvraag of instructie die je aan het model geeft.
Response: Dit is het antwoord dat het model wordt getraind om te genereren.
Je kunt drie verschillende datasets gebruiken om een LLM fijn af te stemmen:
Als je wilt fijn-afstemmen met een dataset van de HuggingFace Hub en de
dataset heeft een vooraf gedefinieerde preprocessingfunctie of volgt al het
„prompt”/„response”-formaat, dan kun je de dataloader eenvoudig naar die dataset laten verwijzen.
train_loader:
    name: finetuning
    dataset:
        hf_name: tatsu-lab/alpaca
        split: train
        ...
Als er geen preprocessingfunctie is gedefinieerd, gebruik dan preprocessing_fn om een aangepaste preprocessingfunctie voor de dataloader op te geven.
train_loader:
    name: finetuning
    dataset:
        hf_name: mosaicml/doge-facts
        preprocessing_fn: my_data.formatting:dogefacts_prep_fn
        split: train
        ...
Als je al een fijn-afstemdataset op je apparaat hebt, definieer dan lokale JSONL-bestanden in
de YAML-config yamls/finetune/1b_local_data_sft.yaml.
train_loader:
    name: finetuning
    dataset:
        hf_name: json # assuming data files are json formatted
        hf_kwargs:
            data_dir: /path/to/data/dir/
        preprocessing_fn: my.import.path:my_preprocessing_fn
        split: train
        ...
Sla preprocessing_fn over als je lokale data al het „prompt”/„response”-formaat heeft.
Zet je HuggingFace-dataset om naar MDS-formaat met het
convert_finetuning_dataset.py-script.
Nadat je je HuggingFace-dataset hebt omgezet naar een streamingformaat, pas je je YAML-configuratie als volgt aan.
train_loader:
    name: finetuning
    dataset:
        remote: s3://my-bucket/my-copy-doge-facts
        local: /tmp/mds-cache/
        split: train
        ...
Als je volledige parameter-finetuning wilt zien, bekijk dan de YAML-config op
Databricks DBRX gebruikt meerdere gespecialiseerde netwerken om de snelheid en kostenefficiëntie van het model te verbeteren. Deze fijnmazige aanpak stelt het in staat om andere LLM's te overtreffen bij het uitvoeren van complexe taken.
Wil je meer leren over large language models en hoe je ze fijn-afstemt? Bekijk dan deze resources:
Zet vandaag je AI-reis voort!
Cursus
Cursus
Leerpad
blog
Adel Nehme
15 min

