Khóa học
Các khái niệm về Generative AI
2 giờ
121.2K
Gần đây, Databricks đã giới thiệu DBRX, mô hình ngôn ngữ lớn (LLM) đa dụng dạng mở, được xây dựng trên kiến trúc hỗn hợp chuyên gia (MoE) với cách tiếp cận chi tiết. Thay vì dùng một mạng nơ-ron duy nhất cho mọi tác vụ, hệ thống gồm nhiều mạng "chuyên gia" chuyên biệt, mỗi mạng được tối ưu cho các loại tác vụ hoặc dữ liệu khác nhau.
Mô hình này cho kết quả tốt hơn các LLM truyền thống như GPT-3.5 và Llama 2 vì nhanh hơn và tiết kiệm chi phí hơn. Theo thử nghiệm, DBRX đạt 73,7%, cao hơn LLaMa2 (69,8%) trong các tác vụ hiểu ngôn ngữ.
Trong bài viết này, chúng tôi sẽ bàn về các khả năng của mô hình và cách bắt đầu với Databricks DBRX chi tiết hơn.
DBRX sử dụng kiến trúc decoder-only dựa trên transformer, được huấn luyện theo phương pháp dự đoán token tiếp theo. Nó áp dụng kiến trúc hỗn hợp chuyên gia (MoE) chi tiết. Các “chuyên gia” này là những tác nhân chuyên biệt dựa trên LLM, được tăng cường bằng kiến thức theo miền và kỹ năng suy luận.
DBRX có số lượng lớn các chuyên gia nhỏ (tổng cộng 16 chuyên gia) và chọn một tập con (4 chuyên gia) cho mỗi đầu vào.
Nói đơn giản, cách tiếp cận chi tiết với số tổ hợp chuyên gia có thể có nhiều hơn 65 lần này giúp cải thiện chất lượng mô hình so với các mô hình MoE mở khác như Mixtral và Grok-1, vốn có ít chuyên gia hơn và chọn ít chuyên gia hơn cho mỗi đầu vào.
Dưới đây là một số chi tiết chính về DBRX:
Mô hình được tiền huấn luyện trên một bộ dữ liệu cực lớn, ước tính hiệu quả gấp đôi so với các bộ dữ liệu trước đây Databricks từng dùng. Bộ công cụ Databricks như Apache Spark và Databricks notebooks cho xử lý dữ liệu, cùng Unity Catalog cho quản trị dữ liệu, đã được dùng để huấn luyện mô hình.
Trong quá trình huấn luyện, kỹ thuật học theo giáo trình (curriculum learning) được áp dụng, và thành phần trộn dữ liệu được điều chỉnh để cải thiện đáng kể chất lượng mô hình. Những điều chỉnh chiến lược này trong trộn dữ liệu giúp tối ưu khả năng mô hình xử lý hiệu quả các đầu vào đa dạng.
Một số công nghệ chủ chốt dùng cho tiền huấn luyện DBRX gồm:
Databricks cho rằng mô hình DBRX của họ vượt trội so với một số mô hình mã nguồn mở hàng đầu về hiệu quả và hiệu năng tác vụ.
Đây là so sánh chi tiết cách DBRX đối đầu các đối thủ:
Bên dưới, chúng tôi tổng hợp các so sánh vào một bảng, kèm biểu đồ dựa trên một số kết quả:
|
So sánh mô hình |
Kiến thức tổng quát |
Suy luận thường thức |
Databricks Gauntlet |
Suy luận lập trình |
Suy luận toán học |
|
DBRX so với LLaMA2-70B |
+9,8% |
+3,1% |
+14% |
+37,9% |
+40,2% |
|
DBRX so với Mixtral Instruct |
+2,3% |
+1,4% |
+6,1% |
+15,3% |
+5,8% |
|
DBRX so với Grok-1 |
+0,7% |
Không có |
Không có |
+6,9% |
+4% |
|
DBRX so với Mixtral Base |
+1,8% |
+2,5% |
+10% |
+29,9% |
Không có |
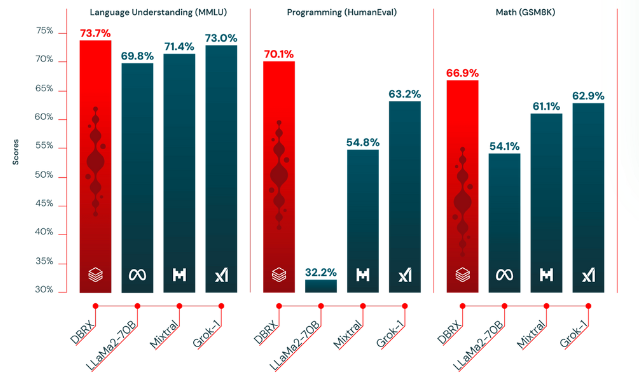
So sánh chất lượng của DBRX với các LLM mã nguồn mở khác - nguồn
Trước khi truy cập DBRX, hãy đảm bảo hệ thống của bạn có tối thiểu 320GB bộ nhớ. Sau đó làm theo các bước sau để truy cập DBRX:
transformerspip install "transformers>=4.40.0"from transformers import AutoTokenizer, AutoModelForCausalLM
import torch
tokenizer = AutoTokenizer.from_pretrained("databricks/dbrx-base", token="hf_YOUR_TOKEN")
model = AutoModelForCausalLM.from_pretrained("databricks/dbrx-base", device_map="auto", torch_dtype=torch.bfloat16, token="hf_YOUR_TOKEN")
# Directing tensors to "cuda" (GPU) for faster computation as GPUs are better at handling parallel tasks.
input_text = "Databricks was founded in "
input_ids = tokenizer(input_text, return_tensors="pt").to("cuda")
# DBRX accepts a context length of up to 32768 tokens. Here`max_new_tokens` specifies the maximum number of tokens to generate.
outputs = model.generate(**input_ids, max_new_tokens=100)
print(tokenizer.decode(outputs[0]))Muốn học cách sử dụng Transformers và Hugging Face? Đọc hướng dẫn của chúng tôi về cách dùng Transformers và Hugging Face.
DRBX có thể hỗ trợ bạn tạo nội dung cơ bản và phản hồi prompt như mọi LLM khác. Bạn có thể làm gì với DBRX:
DBRX cũng có thể thực hiện các tác vụ nâng cao liên quan đến mã để hỗ trợ người làm dữ liệu hoặc lập trình viên:
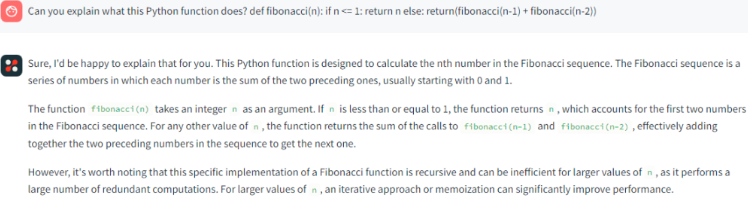
DBRX phản hồi các lệnh đơn giản - nguồn
Bạn có thể tinh chỉnh DBRX với LLM foundry mã nguồn mở trên Github. Tuy nhiên, tinh chỉnh yêu cầu các ví dụ huấn luyện được định dạng dưới dạng dictionary:
formatted_example = {'prompt': <prompt_text>, 'response': <response_text>}Prompt: Đây là câu hỏi hoặc hướng dẫn ban đầu bạn đưa cho mô hình.
Response: Đây là câu trả lời mà mô hình được huấn luyện để tạo ra.
Bạn có thể dùng ba loại bộ dữ liệu khác nhau để tinh chỉnh bất kỳ LLM nào:
Nếu bạn muốn tinh chỉnh bằng bộ dữ liệu từ HuggingFace Hub, và
bộ dữ liệu có hàm tiền xử lý được định nghĩa sẵn hoặc đã tuân theo
định dạng "prompt"/"response", bạn chỉ cần trỏ dataloader tới bộ dữ liệu đó.
train_loader:
    name: finetuning
    dataset:
        hf_name: tatsu-lab/alpaca
        split: train
        ...
Nếu không có hàm tiền xử lý được định nghĩa, hãy dùng preprocessing_fn để chỉ định một hàm tiền xử lý tùy chỉnh cho dataloader.
train_loader:
    name: finetuning
    dataset:
        hf_name: mosaicml/doge-facts
        preprocessing_fn: my_data.formatting:dogefacts_prep_fn
        split: train
        ...
Nếu bạn đã có bộ dữ liệu tinh chỉnh trên thiết bị, hãy khai báo các tệp JSONL cục bộ trong
tệp cấu hình YAML yamls/finetune/1b_local_data_sft.yaml.
train_loader:
    name: finetuning
    dataset:
        hf_name: json # assuming data files are json formatted
        hf_kwargs:
            data_dir: /path/to/data/dir/
        preprocessing_fn: my.import.path:my_preprocessing_fn
        split: train
        ...
Bỏ qua preprocessing_fn nếu dữ liệu cục bộ của bạn đã ở định dạng "prompt"/"response".
Chuyển bộ dữ liệu HuggingFace của bạn sang định dạng MDS bằng
convert_finetuning_dataset.py.
Sau khi chuyển bộ dữ liệu HuggingFace sang định dạng streaming, chỉ cần điều chỉnh cấu hình YAML như sau.
train_loader:
    name: finetuning
    dataset:
        remote: s3://my-bucket/my-copy-doge-facts
        local: /tmp/mds-cache/
        split: train
        ...
Nếu bạn muốn xem tinh chỉnh toàn bộ tham số, hãy xem tệp YAML tại
Databricks DBRX sử dụng nhiều mạng chuyên biệt để tăng tốc độ và hiệu quả chi phí của mô hình. Cách tiếp cận chi tiết này giúp nó vượt trội hơn các LLM khác trong xử lý tác vụ phức tạp.
Muốn tìm hiểu thêm về các mô hình ngôn ngữ lớn và cách tinh chỉnh chúng? Hãy xem các tài nguyên này:
Tiếp tục hành trình AI của bạn ngay hôm nay!
Khóa học
Khóa học
Lộ trình
blog
Matt Crabtree
10 phút
