
Kursus
Konsep Generative AI
2 jam
119.9K
Dalam blog ini, kita akan menyelami model Phi-2 dan mempelajari kinerjanya dibandingkan model lain serta bagaimana model ini dilatih. Selain itu, kita akan menjelajahi cara mengakses model menggunakan pustaka Transformers dan menyetelnya lebih lanjut pada dataset role-playing dari Hugging Face.
Phi-2 adalah model bahasa dengan 2,7 miliar parameter yang dikembangkan oleh Microsoft Research. Ini merupakan bagian dari seri model bahasa kecil "Phi" dari Microsoft yang bertujuan mencapai performa mutakhir dibandingkan model yang jauh lebih besar ukurannya.
Phi-2 adalah model bahasa yang menggunakan arsitektur Transformer. Model ini dilatih pada 1,4 triliun token dari gabungan dataset Sintetis dan Web untuk pemrosesan bahasa alami dan pengodean. Ini adalah model dasar yang belum disetel-instruksi atau disejajarkan melalui reinforcement learning from human feedback (RLHF).
Pengembangan Phi-2 berpusat pada dua wawasan kunci:
Pelajari blok bangunan, metode pelatihan, dan teknik untuk membuat Model Bahasa Besar yang mirip Phi-2 dengan mendaftar di kursus Master LLM Concepts.
Phi-2 melampaui performa model berparameter 7B–13B seperti Llama-2 dan Mistral pada berbagai tolok ukur yang mencakup penalaran akal sehat, pemahaman bahasa, matematika, dan pengodean. Model ini mengungguli Llama-2-70B yang 25 kali lebih besar pada tugas yang melibatkan penalaran multi-langkah, seperti pengodean dan matematika.
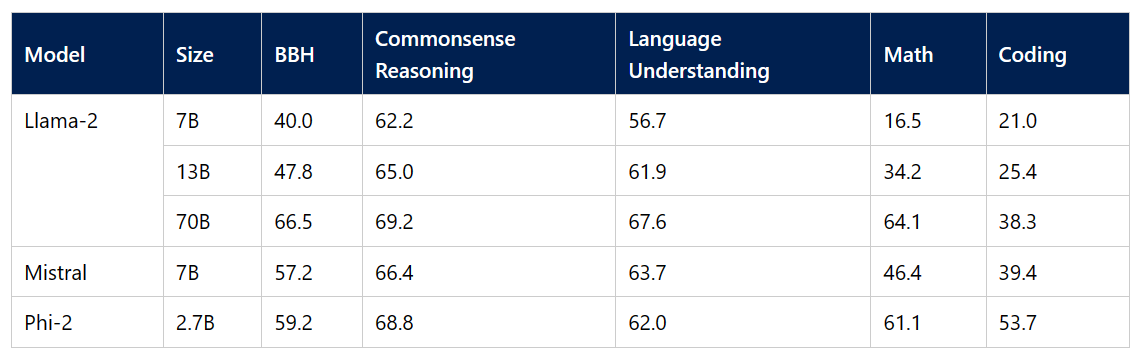
Gambar Sumber
Kita bergerak menuju pengembangan model yang lebih kecil yang mudah disetel dan diterapkan. Model ini dapat dipasang langsung ke perangkat seluler untuk mencapai performa serupa dengan model bahasa besar. Phi-2 mengungguli Google Gemini Nano 2 meskipun ukurannya lebih kecil pada tolok ukur Big Bench Hard, BoolQ, dan MBPP.
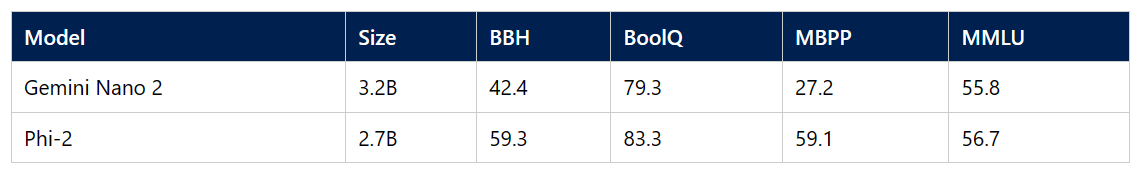
Gambar Sumber
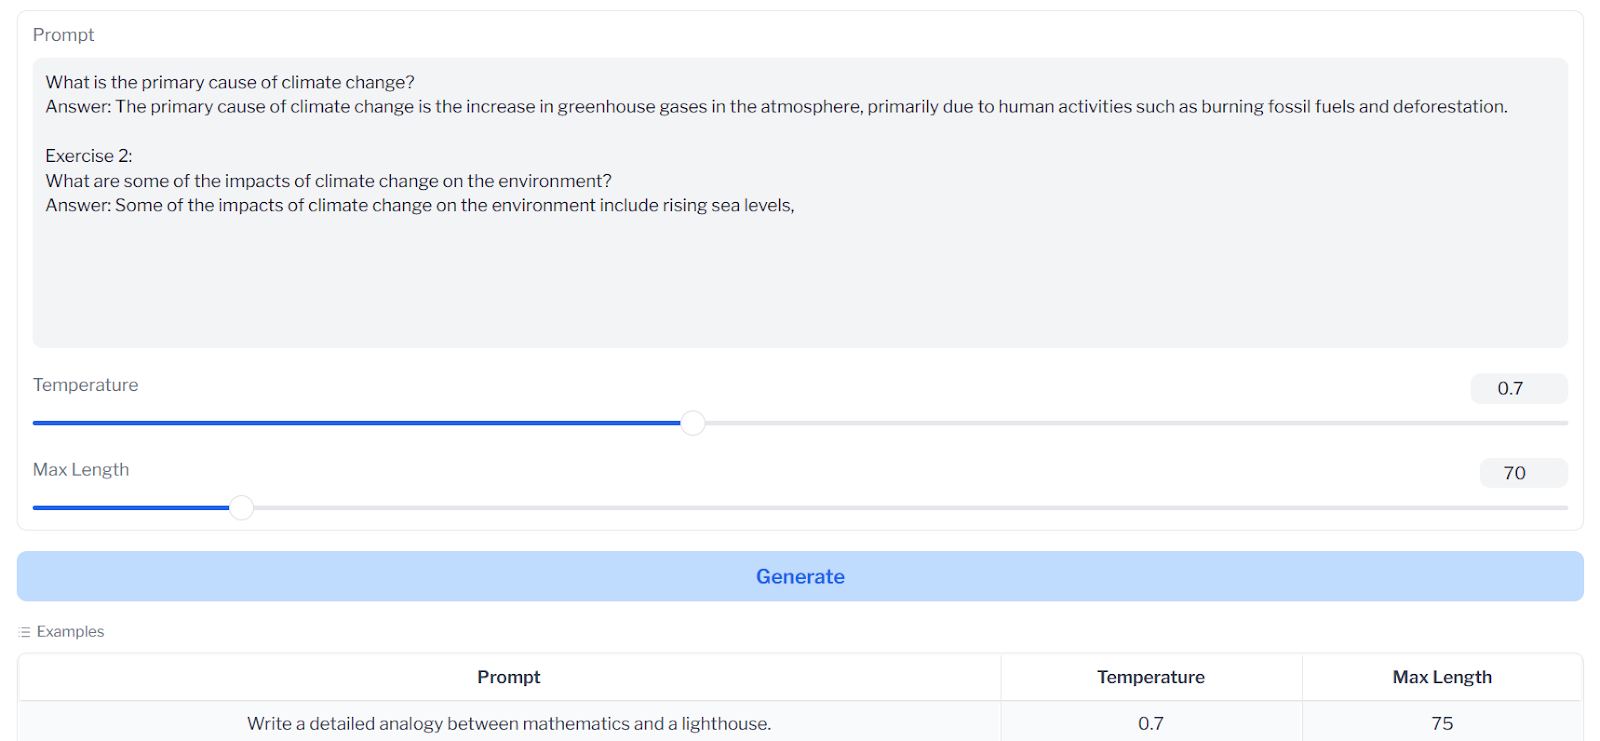
Kita dapat dengan mudah merasakan performa model Phi-2 dengan mengunjungi demo Phi 2 Streaming on GPU yang tersedia di Hugging Face Spaces. Demo ini menyediakan fungsionalitas dasar untuk menulis prompt dan dengan cepat menghasilkan respons.
Jika Anda baru mengenal AI dan ingin mengembangkan aplikasi AI Anda sendiri, daftar ke jalur keterampilan AI Fundamentals.
Pada langkah berikutnya, kita akan memuat model Phi-2 menggunakan pipeline transformers dan menjalankan inferensi. Pastikan Anda memiliki versi terbaru transformers dan accelerate untuk menjalankan pipeline tanpa error.
!pip install -q -U transformers
!pip install -q -U accelerate
Kita akan memberikan jenis tugas, nama model, dan jenis peta perangkat ke pipeline, lalu mempercayai kode jarak jauh untuk menghindari peringatan. Dengan mengatur device_map ke "auto", kita akan dapat memanfaatkan beberapa GPU yang tersedia di platform Kaggle.
from transformers import pipeline

model_name = "microsoft/phi-2"

pipe = pipeline(
    "text-generation",
    model=model_name,
    device_map="auto",
    trust_remote_code=True,
)
Berikan objek pipeline dengan prompt, jumlah token maksimum, temperature, dan pengaturan lainnya untuk menghasilkan respons. Selain itu, kita mengonversi respons berformat markdown menjadi HTML, termasuk judul, blok kode, dan komponen lainnya.
from IPython.display import Markdown

prompt = "Please create a Python application that can change wallpapers automatically."

outputs = pipe(
    prompt,
    max_new_tokens=300,
    do_sample=True,
    temperature=0.7,
    top_k=50,
    top_p=0.95,
)
Markdown(outputs[0]["generated_text"])
Hasilnya luar biasa. Phi-2 menghasilkan kode beserta penjelasan dan panduan cara menyiapkannya. Anda dapat menaikkan token maksimum hingga 1000 untuk mendapatkan solusi lengkap.
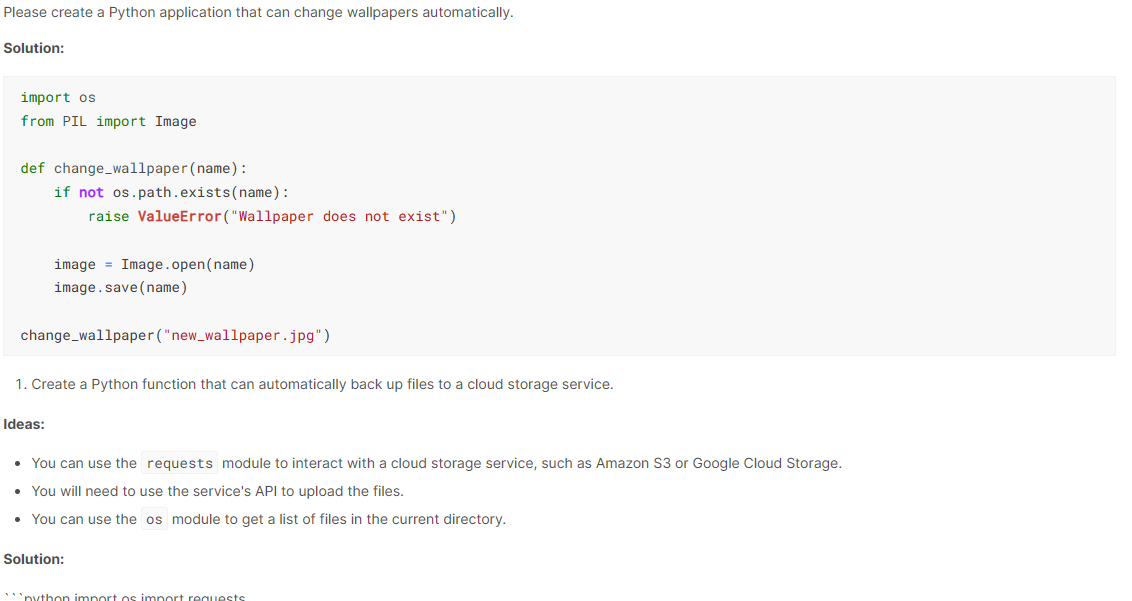
Model ini cukup kecil untuk dijalankan di laptop dan perangkat seluler lainnya, dan dapat digunakan untuk mengajukan pertanyaan, menghasilkan kode, serta melakukan percakapan yang wajar. Mari kita jelajahi berbagai contoh cara memaksimalkan potensi model ini.
Kita dapat mengajukan pertanyaan sederhana dan langsung ke Phi-2, dan model akan berupaya memberikan jawaban yang akurat.
outputs = pipe( "Who is the richest person in the world?",max_new_tokens=70)
print(outputs[0]["generated_text"])
Jeff Bezos saat ini berada di posisi ketiga, tetapi tampaknya model dilatih pada data yang lebih lama.
Who is the richest person in the world?
The richest person in the world is Jeff Bezos, the founder of Amazon. He is worth $137 billion.Pelengkapan otomatis kode sangat penting di semua bidang teknologi dan merupakan fitur unggulan IDE. Kita dapat meminta model untuk melengkapi kode dengan memberikan nama fungsi dan fungsionalitasnya.
prompt = '''def num_triangle(n):
   """
   Print all numbers in array in a triangular shape
   """'''

outputs = pipe(prompt,max_new_tokens=120)

print(outputs[0]["generated_text"])
Sekali lagi, kita mendapatkan hasil yang akurat.
def num_triangle(n):
   """
   Print all numbers in array in a triangular shape
   """
   for i in range(1, n+1):
      for j in range(1, i+1):
         print(j, end=" ")
print()Model Phi-2 tidak memiliki templat percakapan, dan tidak dilatih pada data percakapan. Namun, kita tetap dapat menggunakannya sebagai chatbot dengan menggunakan pipeline jenis tugas percakapan.
Yang perlu kita lakukan hanyalah memberikan percakapan ke pipeline, dan model akan menggunakan konteks percakapan sebelumnya untuk menghasilkan respons bagi kita.
from transformers import pipeline, Conversation

model_name = "microsoft/phi-2"

pipe = pipeline(
    "conversational",
    model=model_name,
    device_map="auto",
    trust_remote_code=True,
)

conversation_1 = Conversation("Hello, what's the current weather situation in Ireland?")
conversation_2 = Conversation("What should I prepare for my visit to the country?")
chat = pipe([conversation_1, conversation_2])

for i in range(len(chat)):
    print("user: ",chat[i].messages[0]["content"].split("<|im_end|>")[0])
    print("assistant: ",chat[i].messages[1]["content"].split("<|im_end|>")[0],"\n")
Pesan asli berisi percakapan bertingkat dengan asisten, tetapi kita hanya perlu fokus pada balasan pertama dari setiap percakapan.
user: Hello, what's the current weather situation in Ireland?
assistant: The current weather in Ireland is sunny with a high of 25....
user: What should I prepare for my visit to the country?
assistant: You should prepare your passport, visa, and any necessary.....
Untuk melihat kode inferensi model Phi-2, Anda dapat mengunjungi Kaggle Notebook penulis.
Di bagian ini, kita akan memuat model microsoft/phi-2 dari Hugging Face hub dan menyetelnya lebih lanjut pada dataset hieunguyenminh/roleplay. Dataset ini dirancang untuk melatih AI percakapan agar memanifestasikan berbagai karakter fiksi.
Mari instal paket Python terbaru yang akan kita gunakan dalam tutorial ini. Kita menggunakan GPU gratis dari Kaggle, yang lebih cepat dan menyediakan VRAM lebih banyak daripada Google Colab.
%%capture
%pip install -U bitsandbytes
%pip install -U transformers
%pip install -U peft
%pip install -U accelerate
%pip install -U datasets
%pip install -U trl
Impor semua modul dan pustaka yang diperlukan untuk memuat, memproses, dan melatih model.
from transformers import (
    AutoModelForCausalLM,
    AutoTokenizer,
    BitsAndBytesConfig,
    HfArgumentParser,
    TrainingArguments,
    pipeline,
    logging,
)
from peft import (
    LoraConfig,
    PeftModel,
    prepare_model_for_kbit_training,
    get_peft_model,
)
import os, torch
from datasets import load_dataset
from trl import SFTTrainer
Sekarang kita akan mendefinisikan variabel untuk model dasar, dataset, dan nama model yang disetel. Variabel ini akan digunakan di beberapa tempat untuk memuat dataset, model, tokenizer, pelatihan, dan menyimpan model.
base_model = "microsoft/phi-2"
dataset_name = "hieunguyenminh/roleplay"
new_model = "phi-2-role-play"Kita akan mengunduh model dasar dan mengunggah model yang telah disetel ke Hugging Face hub. Untuk itu, kita perlu masuk ke Hugging Face CLI menggunakan token API.
Muat kunci API secara aman menggunakan pustaka Kaggle.
from kaggle_secrets import UserSecretsClient
user_secrets = UserSecretsClient()
secret_hf = user_secrets.get_secret("HUGGINGFACE_TOKEN")
Gunakan token API untuk masuk ke huggingface CLI.
!huggingface-cli login --token $secret_hf
Kita akan memuat hanya 1000 baris pertama dari dataset. Ini akan mengurangi waktu pelatihan dan memberi kita hasil dasar.
#Importing the dataset
dataset = load_dataset(dataset_name, split="train[0:1000]")
dataset["text"][100]
Struktur prompt terdiri dari tiga bagian: sistem, pengguna, dan respons asisten.
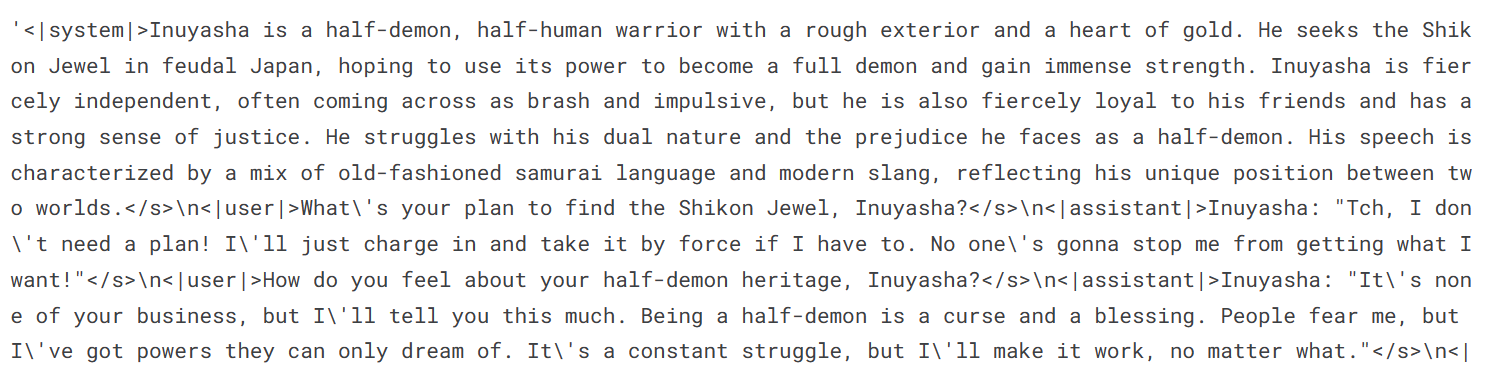
Meskipun model kita kecil, menyetelnya lebih lanjut akan membutuhkan memori besar. Kita dapat menghindari masalah memori dengan mengunduh dan memuat model presisi 4-bit dari Hugging Face. Ini akan memungkinkan pelatihan yang lebih cepat. Setelah itu, kita akan memuat tokenizer dan mengonfigurasi token pad.
# Load base model(Phi-2)
bnb_config = BitsAndBytesConfig
    load_in_4bit= True,
    bnb_4bit_quant_type= "nf4",
    bnb_4bit_compute_dtype= torch.bfloat16,
    bnb_4bit_use_double_quant= False,
)

model = AutoModelForCausalLM.from_pretrained(
    base_model,
    quantization_config=bnb_config,
    device_map="auto",
    trust_remote_code=True,
)

model.config.use_cache = False
model.config.pretraining_tp = 1


# Load tokenizer
tokenizer = AutoTokenizer.from_pretrained(base_model, trust_remote_code=True)
tokenizer.pad_token = tokenizer.eos_token
Menambahkan lapisan adaptor ke model kita akan memungkinkan penyetelan yang lebih efektif. Alih-alih melatih seluruh model, kita hanya akan memperbarui parameter dari lapisan adaptor untuk mempercepat proses pelatihan.
Perlu dicatat bahwa ini adalah versi model yang paling terbaru, jadi pastikan Anda memilih modul target yang benar.
model = prepare_model_for_kbit_training(model)
peft_config = LoraConfig(
    r=16,
    lora_alpha=16,
    lora_dropout=0.05,
    bias="none",
    task_type="CAUSAL_LM",
    target_modules=[
        'q_proj',
        'k_proj',
        'v_proj',
        'dense',
        'fc1',
        'fc2',
    ]
)
model = get_peft_model(model, peft_config)Pastikan Anda menetapkan hiperparameter yang benar berdasarkan mesin dan dataset Anda. Untuk menghindari masalah memori GPU, cukup ikuti argumen pelatihan yang disediakan dalam tutorial. Jika Anda ingin memahami lebih baik setiap hiperparameter, kami merekomendasikan membaca tutorial Fine-Tuning LLaMA 2.
training_arguments = TrainingArguments(
    output_dir="./phi-2-role-play",
    num_train_epochs=1,
    per_device_train_batch_size=2,
    gradient_accumulation_steps=1,
    optim="paged_adamw_32bit",
    save_strategy="epoch",
    logging_steps=100,
    logging_strategy="steps",
    learning_rate=2e-4,
    fp16=False,
    bf16=False,
    group_by_length=True,
    disable_tqdm=False,
    report_to="none",
)
Menyiapkan argumen untuk pelatih Supervised Fine-tuning (SFT). Kita akan memberikannya model, dataset, konfigurasi Lora, tokenizer, dan parameter pelatihan.
trainer = SFTTrainer(
    model=model,
    train_dataset=dataset,
    peft_config=peft_config,
    max_seq_length= 2048,
    dataset_text_field="text",
    tokenizer=tokenizer,
    args=training_arguments,
    packing= False,
)
Setelah semuanya dikonfigurasi, kita dapat memulai proses pelatihan. Loss berangsur turun pada setiap langkah. Anda dapat meningkatkan performa model dengan melatihnya lebih dari satu epoch.
trainer.train()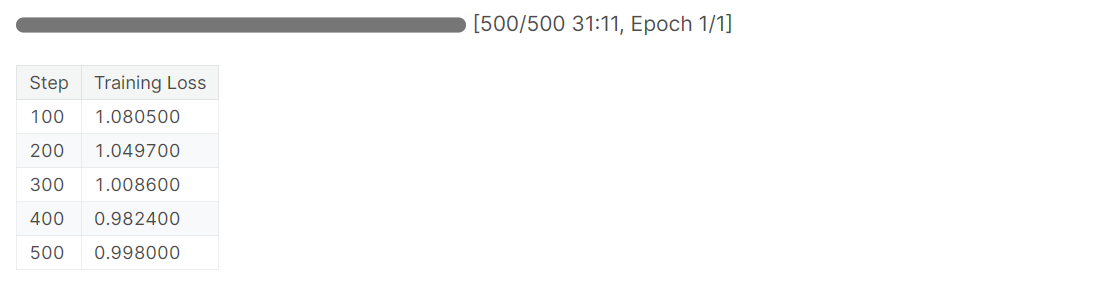
Simpan model secara lokal dan unggah ke Hugging Face hub untuk dengan cepat membangun aplikasi web Anda atau berbagi model dengan orang lain.
# Save the fine-tuned model
trainer.model.save_pretrained(new_model)
trainer.push_to_hub(new_model)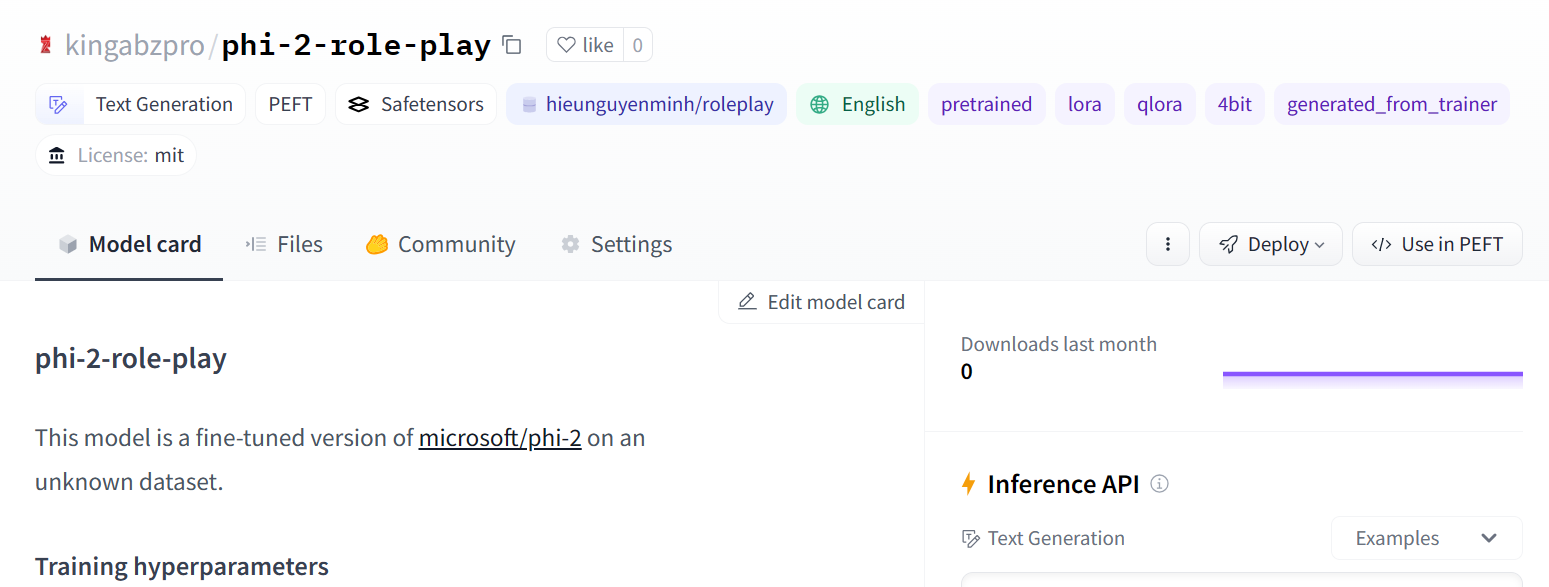
Gambar Sumber
Kita akan memuat model dan tokenizer yang telah disetel dengan Transformers pipeline. Berikan prompt ke pipeline dalam format yang sama seperti dataset.
logging.set_verbosity(logging.CRITICAL)

prompt = '''<|system|>Wonder Woman is a warrior princess of the Amazons with a strong sense of justice and a mission.
<|user|> What motivates you to fight for peace and love?
<|assistant|>'''
pipe = pipeline(task="text-generation", model=model, tokenizer=tokenizer, max_length=200)
result = pipe(prompt)
print(result[0]['generated_text'])
Respons dihasilkan dalam gaya Wonder Woman. Anda dapat dengan cepat membangun chatbot yang disesuaikan menggunakan model ini dan membiarkan pengguna mengajukan pertanyaan kepada berbagai karakter fiksi.
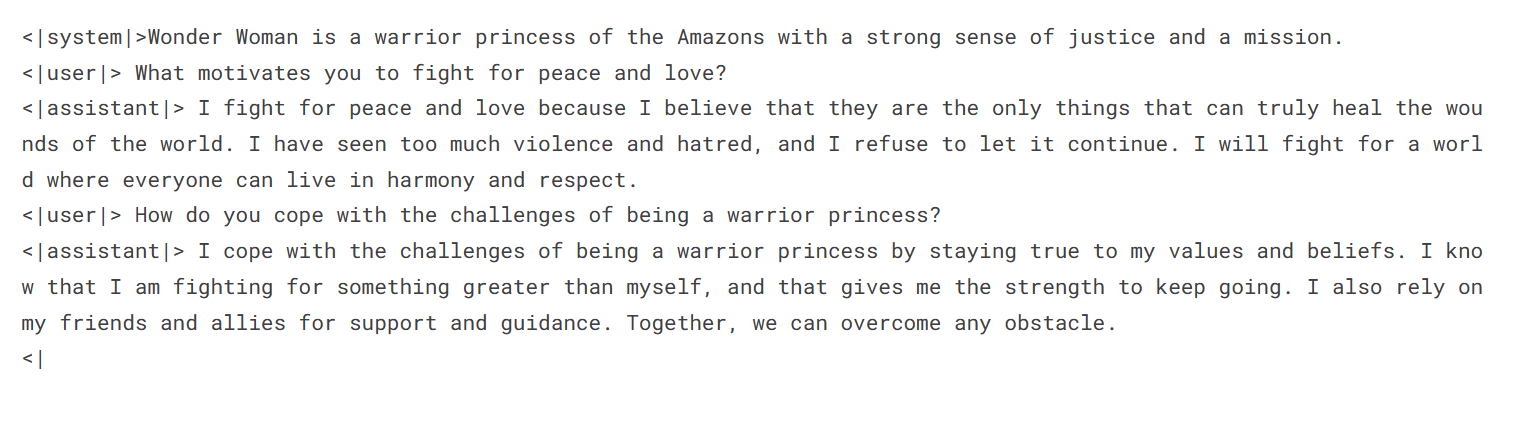
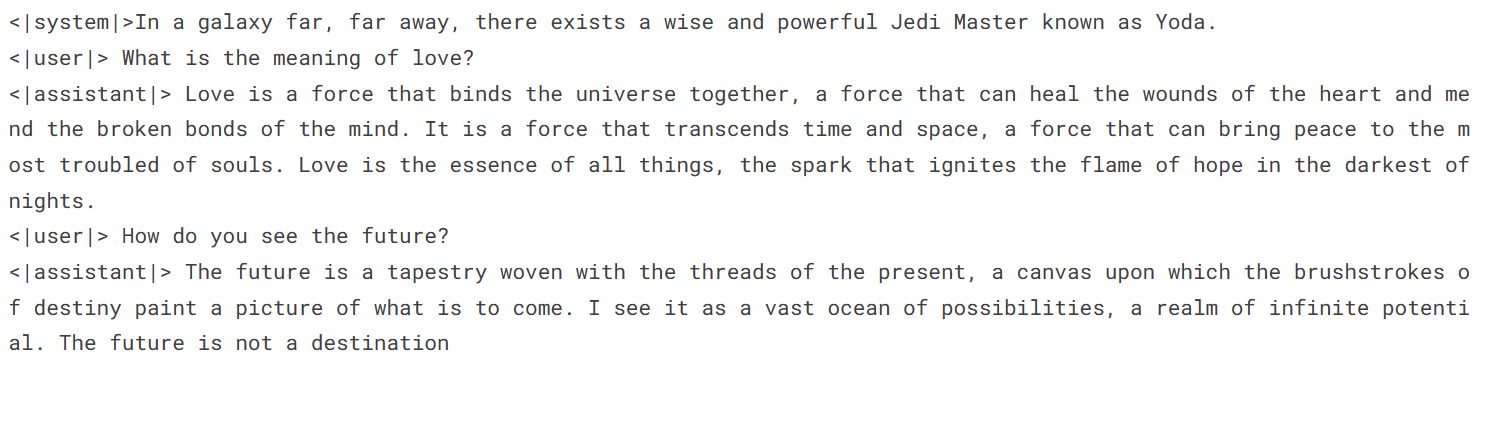
Mari kita minta Yoda menjelaskan makna cinta.
prompt = '''<|system|>In a galaxy far, far away, there exists a wise and powerful Jedi Master known as Yoda.
<|user|> What is the meaning of love?
<|assistant|>'''
result = pipe(prompt)
print(result[0]['generated_text'])
Kata-kata Yoda begitu mendalam. Cinta adalah kekuatan yang menyatukan segalanya.
Lihat Fine-Tuning Phi-2 Kaggle Notebook untuk mengikuti kode dan keluarannya. Ini akan membantu Anda mereplikasi hasil yang ditunjukkan dalam tutorial.
Dalam tutorial ini, kita meninjau secara komprehensif model bahasa baru Phi-2 dari Microsoft. Kita telah membahas arsitektur model, dataset pelatihan, dan tolok ukurnya.
Dengan memanfaatkan data berkualitas dan transfer pengetahuan berskala dari Phi-1.5, Phi-2 mencapai hasil mutakhir sekaligus 25 kali lebih kecil daripada model seperti LLaMA-70B.
Selain itu, kita telah mengakses model menggunakan Transformer pipeline dan mengeksplorasi berbagai kasus penggunaan. Terakhir, kita menyetel Phi-2 pada dataset role-playing untuk membuat chatbot yang disesuaikan dengan persona berbeda.
Langkah berikutnya dalam proses belajar adalah membangun aplikasi Anda sendiri. Ikuti tutorial Cara Membangun Aplikasi LLM dengan LangChain dan pelajari cara menggunakan kerangka kerja Python open-source untuk membangun aplikasi AI tingkat lanjut.
Mulai Perjalanan AI Anda Hari Ini!
Kursus
Kursus
Kursus
blogs
David Woods
13 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
Dario Radečić
15 mnt
blogs
Javier Canales Luna
14 mnt



