Kurs
Konzeptuelle Einführung in generative KI
2 Std.
117.2K
Databricks hat kürzlich DBRX vorgestellt, ein offenes, universelles Large Language Model (LLM), das auf einer fein granulierten Mixture-of-Experts-(MoE)-Architektur basiert. Statt ein einziges neuronales Netz für alle Aufgaben zu nutzen, setzt das System auf mehrere spezialisierte „Expert:innen“-Netzwerke, die jeweils für unterschiedliche Aufgabentypen oder Daten optimiert sind.
Dieses Modell übertrifft klassische LLMs wie GPT-3.5 und Llama 2, weil es schneller und kostengünstiger ist. Laut Tests erzielt DBRX 73,7 % und liegt damit bei Sprachverständnis-Aufgaben über LLaMA2 (69,8 %).
In diesem Artikel schauen wir uns die Fähigkeiten an und zeigen dir im Detail, wie du mit Databricks DBRX startest.
DBRX nutzt eine Transformer-basierte Decoder-only-Architektur, trainiert per Next-Token-Prediction. Es setzt auf eine fein granulierte Mixture-of-Experts-(MoE)-Architektur. Diese „Expert:innen“ sind spezialisierte Agenten auf LLM-Basis, erweitert um domänenspezifisches Wissen und ausgeprägte Reasoning-Fähigkeiten.
DBRX verfügt über viele kleinere Expert:innen (insgesamt 16) und wählt für jede Eingabe eine Teilmenge davon aus (4 Expert:innen).
Vereinfacht gesagt verbessert dieser fein granulierte Ansatz mit 65-mal mehr möglichen Expert:innen-Kombinationen die Modellqualität gegenüber anderen offenen MoE-Modellen wie Mixtral und Grok-1, die weniger Expert:innen haben und pro Eingabe weniger auswählen.
Hier einige wichtige Details zu DBRX:
Das Modell wurde auf einem beeindruckend großen Datensatz vortrainiert, der Schätzungen zufolge doppelt so wirkungsvoll ist wie die zuvor von Databricks verwendeten Datensätze. Ein Set an Databricks-Tools – darunter Apache Spark und Databricks Notebooks für die Datenverarbeitung sowie der Unity Catalog für Data Governance – kam beim Training zum Einsatz.
Während des Trainings wurde Curriculum Learning genutzt und der Datenmix angepasst, um die Modellqualität deutlich zu steigern. Diese gezielten Anpassungen im Datenmix optimierten die Fähigkeit des Modells, vielfältige Eingaben effektiv zu verarbeiten.
Zu den wichtigsten Technologien für das Pretraining von DBRX gehören:
Databricks behauptet, dass DBRX mehreren führenden Open-Source-Modellen in Effizienz und Aufgabenerfüllung überlegen ist.
Hier gibt es einen detaillierten Vergleich, wie DBRX im Wettbewerb dasteht:
Unten haben wir die Vergleiche tabellarisch zusammengefasst und eine Grafik zu ausgewählten Ergebnissen ergänzt:
|
Modellvergleich |
Allgemeinwissen |
Alltagslogik |
Databricks Gauntlet |
Programmieren |
Mathematisches Reasoning |
|
DBRX vs. LLaMA2-70B |
+9,8 % |
+3,1 % |
+14 % |
+37,9 % |
+40,2 % |
|
DBRX vs. Mixtral Instruct |
+2,3 % |
+1,4 % |
+6,1 % |
+15,3 % |
+5,8 % |
|
DBRX vs. Grok-1 |
+0,7 % |
Nicht verfügbar |
Nicht verfügbar |
+6,9 % |
+4 % |
|
DBRX vs. Mixtral Base |
+1,8 % |
+2,5 % |
+10 % |
+29,9 % |
Nicht verfügbar |
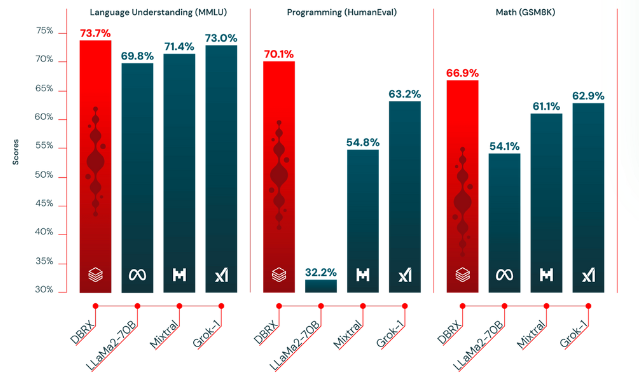
Vergleich der DBRX-Qualität mit anderen Open-Source-LLMs – Quelle
Bevor du auf DBRX zugreifst, stell sicher, dass dein System mindestens 320 GB Arbeitsspeicher hat. Folge dann diesen Schritten:
transformerspip install "transformers>=4.40.0"from transformers import AutoTokenizer, AutoModelForCausalLM
import torch
tokenizer = AutoTokenizer.from_pretrained("databricks/dbrx-base", token="hf_YOUR_TOKEN")
model = AutoModelForCausalLM.from_pretrained("databricks/dbrx-base", device_map="auto", torch_dtype=torch.bfloat16, token="hf_YOUR_TOKEN")
# Leitet Tensoren für schnellere Berechnungen an "cuda" (GPU) weiter, da GPUs parallele Aufgaben besser verarbeiten.
input_text = "Databricks was founded in "
input_ids = tokenizer(input_text, return_tensors="pt").to("cuda")
# DBRX akzeptiert eine Kontextlänge von bis zu 32768 Tokens. Hier gibt `max_new_tokens` die maximale Anzahl neu zu generierender Tokens an.
outputs = model.generate(**input_ids, max_new_tokens=100)
print(tokenizer.decode(outputs[0]))Du willst lernen, wie man Transformers und Hugging Face nutzt? Lies unser Tutorial zu Transformers und Hugging Face.
DBRX hilft dir – wie jedes LLM – bei grundlegender Inhaltserstellung und Prompt-Antworten. Das kannst du mit DBRX tun:
DBRX kann auch fortgeschrittene Coding-Aufgaben für Data Professionals oder Entwickler:innen übernehmen:
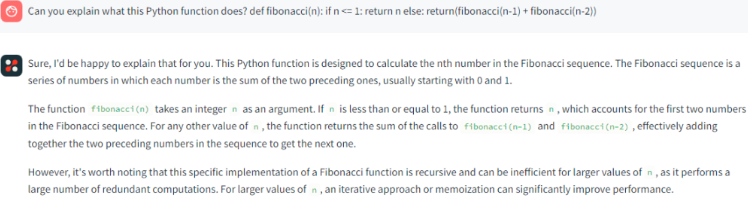
DBRX reagiert auf einfache Befehle – Quelle
Du kannst DBRX mit der Open-Source-LLM Foundry auf GitHub feinabstimmen. Fürs Fine-Tuning müssen Trainingsbeispiele allerdings als Dictionaries formatiert sein:
formatted_example = {'prompt': <prompt_text>, 'response': <response_text>}Prompt: Die Ausgangsfrage oder Anweisung, die du dem Modell gibst.
Response: Die Antwort, zu deren Generierung das Modell trainiert wird.
Zum Fine-Tuning eines LLM kannst du drei verschiedene Datensätze verwenden:
Wenn du mit einem Datensatz aus dem Hugging Face Hub feinabstimmen willst und der
Datensatz bereits eine vordefinierte Preprocessing-Funktion hat oder dem
„prompt“/„response“-Format folgt, kannst du den Dataloader direkt auf diesen Datensatz zeigen lassen.
train_loader:
    name: finetuning
    dataset:
        hf_name: tatsu-lab/alpaca
        split: train
        ...
Ist keine Preprocessing-Funktion definiert, nutze preprocessing_fn, um eine eigene Preprocessing-Funktion für den Dataloader anzugeben.
train_loader:
    name: finetuning
    dataset:
        hf_name: mosaicml/doge-facts
        preprocessing_fn: my_data.formatting:dogefacts_prep_fn
        split: train
        ...
Wenn du bereits einen Fine-Tuning-Datensatz auf deinem Gerät hast, definiere lokale JSONL-Dateien in
der YAML-Konfiguration yamls/finetune/1b_local_data_sft.yaml.
train_loader:
    name: finetuning
    dataset:
        hf_name: json # assuming data files are json formatted
        hf_kwargs:
            data_dir: /path/to/data/dir/
        preprocessing_fn: my.import.path:my_preprocessing_fn
        split: train
        ...
Überspringe preprocessing_fn, wenn deine lokalen Daten bereits im „prompt“/„response“-Format vorliegen.
Konvertiere deinen Hugging Face-Datensatz mit dem Skript
convert_finetuning_dataset.py ins MDS-Format.
Nachdem du deinen Hugging Face-Datensatz in ein Streaming-Format konvertiert hast, passe deine YAML-Konfiguration einfach so an.
train_loader:
    name: finetuning
    dataset:
        remote: s3://my-bucket/my-copy-doge-facts
        local: /tmp/mds-cache/
        split: train
        ...
Wenn du vollständiges Parameter-Fine-Tuning sehen möchtest, schau dir die YAML-Konfiguration an:
Databricks DBRX nutzt mehrere spezialisierte Netzwerke, um Geschwindigkeit und Kosteneffizienz zu steigern. Dieser fein granulierte Ansatz ermöglicht es dem Modell, andere LLMs bei komplexen Aufgaben zu übertreffen.
Du willst mehr über Large Language Models und Fine-Tuning lernen? Dann sieh dir diese Ressourcen an:
Setze deine KI-Reise heute fort!
Kurs
Kurs
Lernpfad