Cours
Concepts d'IA générative
2 h
117.3K
Databricks a récemment présenté DBRX, son grand modèle de langage (LLM) généraliste open source, conçu sur une architecture « mixture-of-experts » (MoE) à grain fin. Plutôt que d'utiliser un seul réseau de neurones pour toutes les tâches, le système repose sur plusieurs réseaux « experts » spécialisés, chacun optimisé pour différents types de tâches ou de données.
Ce modèle surpasse des LLM traditionnels comme GPT-3.5 et Llama 2, car il est plus rapide et plus économique. D'après les tests, DBRX atteint un score de 73,7 %, supérieur à LLaMA 2 (69,8 %) sur des tâches de compréhension du langage.
Dans cet article, nous allons détailler ses capacités et comment bien démarrer avec Databricks DBRX.
DBRX utilise une architecture de décodeur de type transformer, entraînée via la prédiction du prochain jeton. Il s'appuie sur une architecture MoE à grain fin. Ces « experts » désignent des agents spécialisés basés sur des LLM, enrichis de connaissances métiers et de capacités de raisonnement.
DBRX embarque un grand nombre de petits experts (16 au total) et en sélectionne un sous-ensemble (4 experts) pour chaque entrée.
En bref, cette approche fine, avec 65× plus de combinaisons d'experts possibles, améliore la qualité du modèle par rapport à d'autres MoE open source comme Mixtral et Grok-1, qui comportent moins d'experts et en activent moins par entrée.
Voici quelques détails clés sur DBRX :
Le modèle a été pré-entraîné sur un jeu de données très volumineux, estimé deux fois plus efficace que les jeux de données précédemment utilisés par Databricks. Un ensemble d'outils Databricks, comme Apache Spark et les notebooks Databricks pour le traitement de données, ainsi que Unity Catalog pour la gouvernance, a servi à entraîner le modèle.
Pendant l'entraînement, un apprentissage curriculaire a été appliqué et le mix de données a été ajusté afin d'améliorer sensiblement la qualité du modèle. Ces ajustements stratégiques ont optimisé sa capacité à traiter efficacement des entrées variées.
Parmi les technologies clés utilisées pour le pré-entraînement de DBRX :
Databricks affirme que son modèle DBRX est supérieur à plusieurs modèles open source de référence en matière d'efficacité et de performance sur les tâches.
Voici une comparaison détaillée de la manière dont DBRX se positionne face à ses concurrents :
Ci-dessous, nous avons récapitulé les comparaisons dans un tableau et proposé un graphique basé sur certains résultats :
|
Comparaison des modèles |
Connaissances générales |
Raisonnement de bon sens |
Databricks Gauntlet |
Raisonnement en programmation |
Raisonnement mathématique |
|
DBRX vs LLaMA2-70B |
+9,8 % |
+3,1 % |
+14 % |
+37,9 % |
+40,2 % |
|
DBRX vs Mixtral Instruct |
+2,3 % |
+1,4 % |
+6,1 % |
+15,3 % |
+5,8 % |
|
DBRX vs Grok-1 |
+0,7 % |
Non disponible |
Non disponible |
+6,9 % |
+4 % |
|
DBRX vs Mixtral Base |
+1,8 % |
+2,5 % |
+10 % |
+29,9 % |
Non disponible |
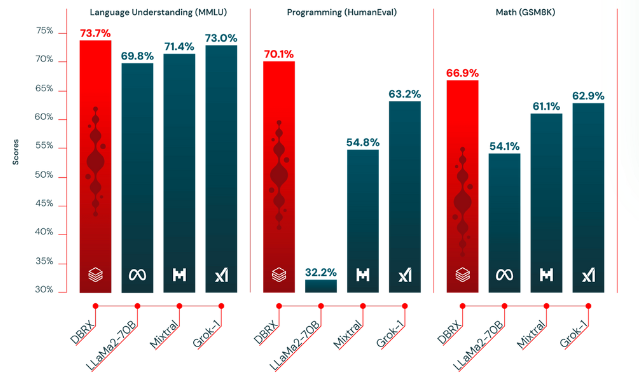
Comparaison de la qualité de DBRX avec d'autres LLM open source - source
Avant d'accéder à DBRX, vérifiez que votre système dispose d'au moins 320 Go de mémoire. Suivez ensuite ces étapes pour y accéder :
transformerspip install "transformers>=4.40.0"from transformers import AutoTokenizer, AutoModelForCausalLM
import torch
tokenizer = AutoTokenizer.from_pretrained("databricks/dbrx-base", token="hf_YOUR_TOKEN")
model = AutoModelForCausalLM.from_pretrained("databricks/dbrx-base", device_map="auto", torch_dtype=torch.bfloat16, token="hf_YOUR_TOKEN")
# Orientation des tenseurs vers "cuda" (GPU) pour un calcul plus rapide, les GPU étant mieux adaptés au parallélisme.
input_text = "Databricks was founded in "
input_ids = tokenizer(input_text, return_tensors="pt").to("cuda")
# DBRX accepte une longueur de contexte jusqu'à 32 768 jetons. Ici, `max_new_tokens` spécifie le nombre maximal de nouveaux jetons à générer.
outputs = model.generate(**input_ids, max_new_tokens=100)
print(tokenizer.decode(outputs[0]))Vous voulez apprendre à utiliser Transformers et Hugging Face ? Lisez notre tutoriel sur Transformers et Hugging Face.
DBRX peut vous aider pour des tâches de création de contenu et de réponse à des invites, comme tout LLM. Voici ce que vous pouvez faire avec DBRX :
DBRX peut également réaliser des tâches avancées liées au code pour aider les data practitioners ou les développeurs :
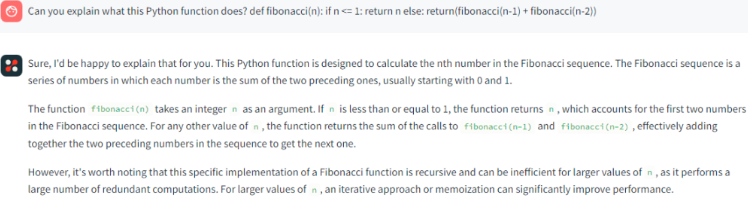
DBRX répondant à des commandes simples - source
Vous pouvez affiner DBRX avec la LLM foundry open source de Github. Cependant, l'affinage nécessite des exemples d'entraînement formatés sous forme de dictionnaires :
formatted_example = {'prompt': <prompt_text>, 'response': <response_text>}Prompt : c'est la question ou l'instruction de départ que vous donnez au modèle.
Response : c'est la réponse que le modèle est entraîné à générer.
Vous pouvez utiliser trois types de jeux de données pour affiner un LLM :
Si vous souhaitez affiner à partir d'un jeu de données du Hub Hugging Face et que le
jeu de données dispose d'une fonction de prétraitement prédéfinie ou suit déjà le
format « prompt »/« response », il suffit d'indiquer ce jeu de données au dataloader.
train_loader:
    name: finetuning
    dataset:
        hf_name: tatsu-lab/alpaca
        split: train
        ...
Si aucune fonction de prétraitement n'est définie, utilisez preprocessing_fn pour spécifier une fonction de prétraitement personnalisée pour le dataloader.
train_loader:
    name: finetuning
    dataset:
        hf_name: mosaicml/doge-facts
        preprocessing_fn: my_data.formatting:dogefacts_prep_fn
        split: train
        ...
Si vous disposez déjà d'un jeu d'affinage sur votre machine, définissez les fichiers JSONL locaux dans
la configuration YAML yamls/finetune/1b_local_data_sft.yaml.
train_loader:
    name: finetuning
    dataset:
        hf_name: json # en supposant que les fichiers de données soient au format JSON
        hf_kwargs:
            data_dir: /path/to/data/dir/
        preprocessing_fn: my.import.path:my_preprocessing_fn
        split: train
        ...
Omettez preprocessing_fn si vos données locales sont déjà au format « prompt »/« response ».
Convertissez votre jeu de données Hugging Face en format MDS à l'aide du script
convert_finetuning_dataset.py.
Après conversion de votre jeu de données Hugging Face au format streaming, ajustez simplement votre configuration YAML comme suit.
train_loader:
    name: finetuning
    dataset:
        remote: s3://my-bucket/my-copy-doge-facts
        local: /tmp/mds-cache/
        split: train
        ...
Pour un exemple d'affinage à paramètres complets, consultez la configuration YAML :
Databricks DBRX s'appuie sur plusieurs réseaux spécialisés pour améliorer la vitesse et la maîtrise des coûts. Cette approche fine lui permet de surpasser d'autres LLM sur des tâches complexes.
Vous souhaitez en savoir plus sur les grands modèles de langage et comment les affiner ? Découvrez ces ressources :
Poursuivez votre aventure IA dès aujourd'hui !
Cours
Cours
Cursus