Kurs
Üretken Yapay Zeka Kavramları
2 sa
121.2K
Databricks kısa süre önce, ince taneli bir yaklaşıma sahip karışık-uzmanlar (MoE) mimarisi üzerine inşa edilmiş, açık genel amaçlı büyük dil modeli (LLM) DBRX'i tanıttı. Tüm görevler için tek bir sinir ağı kullanmak yerine, sistem farklı görev veya veri türleri için optimize edilmiş birden fazla özel "uzman" ağdan oluşur.
Bu model, daha hızlı ve daha uygun maliyetli olduğu için GPT-3.5 ve Llama 2 gibi geleneksel BBA'lara göre daha iyi performans göstermiştir. Testlere göre, DBRX dil anlama görevlerinde LLaMa2'den (69,8%) daha yüksek olan %73,7 puan alıyor.
Bu yazıda, yeteneklerini ve Databricsk DBRX ile nasıl başlayabileceğinizi daha ayrıntılı olarak ele alacağız.
DBRX, bir sonraki belirteç tahmini kullanılarak eğitilmiş, yalnızca kod çözücü (decoder-only) dönüşümcü tabanlı bir mimari kullanır. İnce taneli bir karışık-uzmanlar (MoE) mimarisi uygular. Bu ‘uzmanlar’, alan bilgisi ve akıl yürütme becerileriyle güçlendirilmiş, BBA'lara dayanan özel ajanları ifade eder.
DBRX çok sayıda daha küçük uzmana sahiptir (toplam 16 uzman) ve herhangi bir girdi için bunların bir alt kümesini (4 uzman) seçer.
Basitçe söylemek gerekirse, uzmanların 65 kat daha fazla olası kombinasyonuna izin veren bu ince taneli yaklaşım, daha az uzmana sahip olup girdi başına daha az uzman seçen Mixtral ve Grok-1 gibi diğer açık MoE modellere kıyasla model kalitesini artırır.
DBRX ile ilgili bazı önemli ayrıntılar şunlardır:
Model, Databricks'in daha önce kullandığı veri kümelerine kıyasla iki kat daha etkili olduğu tahmin edilen, son derece büyük bir veri kümesi üzerinde ön eğitildi. Modeli eğitmek için Apache Spark ve veri işleme için Databricks not defterleri ile veri yönetişimi için Unity Catalog gibi bir dizi Databricks aracı kullanıldı.
Eğitim sırasında, aşamalı öğrenme (curriculum learning) uygulandı ve veri karması model kalitesini önemli ölçüde iyileştirecek şekilde değiştirildi. Eğitim veri karmasındaki bu stratejik değişiklikler, modelin çeşitli girdileri etkili biçimde ele alma yeteneğini optimize etti.
DBRX’in ön eğitimi için kullanılan başlıca teknolojilerden bazıları şunlardır:
Databricks, DBRX modelinin verimlilik ve görev performansı açısından bir dizi üst düzey açık kaynak modelden üstün olduğunu iddia ediyor.
DBRX'in rakiplerine karşı nasıl konumlandığına dair ayrıntılı bir karşılaştırma burada:
Aşağıda, karşılaştırmaları bir tabloda derledik ve bazı sonuçlara dayalı bir grafik gösterdik:
|
Model Karşılaştırması |
Genel Bilgi |
Gündelik Akıl Yürütme |
Databricks Gauntlet |
Programlama Akıl Yürütmesi |
Matematiksel Akıl Yürütme |
|
DBRX vs LLaMA2-70B |
+%9,8 |
+%3,1 |
+%14 |
+%37,9 |
+%40,2 |
|
DBRX vs Mixtral Instruct |
+%2,3 |
+%1,4 |
+%6,1 |
+%15,3 |
+%5,8 |
|
DBRX vs Grok-1 |
+%0,7 |
Mevcut değil |
Mevcut değil |
+%6,9 |
+%4 |
|
DBRX vs Mixtral Base |
+%1,8 |
+%2,5 |
+%10 |
+%29,9 |
Mevcut değil |
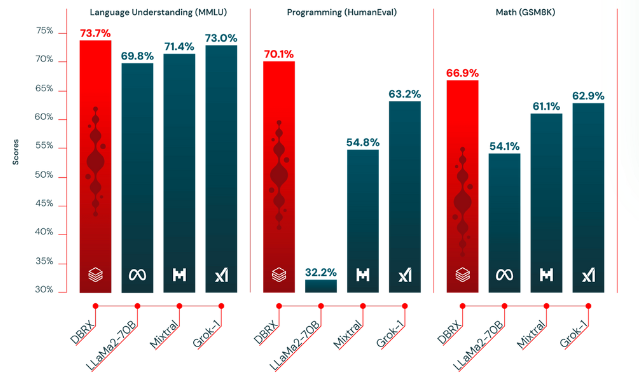
DBRX’in kalitesini diğer açık kaynak BBA'larla karşılaştırma - kaynak
DBRX'e erişmeden önce, sisteminizde en az 320 GB bellek olduğundan emin olun. Ardından DBRX'e erişmek için şu adımları izleyin:
transformers kütüphanesini kurunpip install "transformers>=4.40.0"from transformers import AutoTokenizer, AutoModelForCausalLM
import torch
tokenizer = AutoTokenizer.from_pretrained("databricks/dbrx-base", token="hf_YOUR_TOKEN")
model = AutoModelForCausalLM.from_pretrained("databricks/dbrx-base", device_map="auto", torch_dtype=torch.bfloat16, token="hf_YOUR_TOKEN")
# Directing tensors to "cuda" (GPU) for faster computation as GPUs are better at handling parallel tasks.
input_text = "Databricks was founded in "
input_ids = tokenizer(input_text, return_tensors="pt").to("cuda")
# DBRX accepts a context length of up to 32768 tokens. Here`max_new_tokens` specifies the maximum number of tokens to generate.
outputs = model.generate(**input_ids, max_new_tokens=100)
print(tokenizer.decode(outputs[0]))Transformers ve Hugging Face kullanmayı öğrenmek ister misiniz? Transformers ve Hugging Face kullanımıyla ilgili eğitimimize göz atın.
DRBX, herhangi bir BBA gibi temel içerik oluşturma ve komut yanıtlama görevlerinde size yardımcı olabilir. DBRX ile şunları yapabilirsiniz:
DBRX, veri uygulayıcılarına veya kodlayıcılara yardımcı olmak için ileri düzey kodlama ile ilgili görevleri de gerçekleştirebilir:
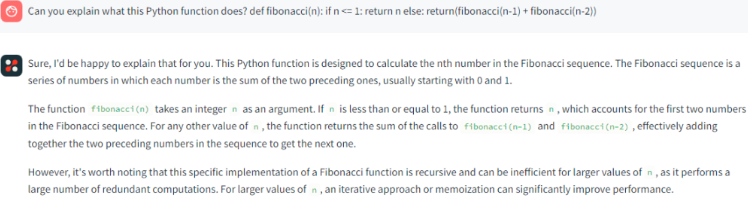
DBRX'in basit komutlara yanıtı - kaynak
DBRX'i Github’ın açık kaynaklı LLM foundrysi ile ince ayar yapabilirsiniz. Ancak ince ayar, eğitim örneklerinin sözlükler olarak biçimlendirilmesini gerektirir:
formatted_example = {'prompt': <prompt_text>, 'response': <response_text>}Prompt: Modele verdiğiniz başlangıç sorusu veya talimattır.
Response: Modelin üretecek şekilde eğitildiği yanıttır.
Herhangi bir BBA'ya ince ayar yapmak için üç farklı veri kümesi kullanabilirsiniz:
İnce ayarı HuggingFace Hub'daki bir veri kümesiyle yapmak istiyorsanız ve
veri kümesinin önceden tanımlanmış bir ön işleme işlevi varsa veya zaten
"prompt"/"response" biçimini takip ediyorsa, veri yükleyiciyi doğrudan bu veri kümesine işaret edebilirsiniz.
train_loader:
    name: finetuning
    dataset:
        hf_name: tatsu-lab/alpaca
        split: train
        ...
Herhangi bir ön işleme işlevi tanımlı değilse, veri yükleyici için özel bir ön işleme işlevi belirtmek üzere preprocessing_fn kullanın.
train_loader:
    name: finetuning
    dataset:
        hf_name: mosaicml/doge-facts
        preprocessing_fn: my_data.formatting:dogefacts_prep_fn
        split: train
        ...
Cihazınızda halihazırda bir ince ayar veri kümeniz varsa, yerel JSONL dosyalarını
YAML yapılandırmasında yamls/finetune/1b_local_data_sft.yaml olarak tanımlayın.
train_loader:
    name: finetuning
    dataset:
        hf_name: json # assuming data files are json formatted
        hf_kwargs:
            data_dir: /path/to/data/dir/
        preprocessing_fn: my.import.path:my_preprocessing_fn
        split: train
        ...
Yerel verileriniz zaten "prompt"/"response" biçimindeyse preprocessing_fn'i atlayın.
HuggingFace veri kümenizi,
convert_finetuning_dataset.py betiğini kullanarak MDS biçimine dönüştürün.
HuggingFace veri kümenizi akış formatına dönüştürdükten sonra YAML yapılandırmanızı şu şekilde ayarlayın.
train_loader:
    name: finetuning
    dataset:
        remote: s3://my-bucket/my-copy-doge-facts
        local: /tmp/mds-cache/
        split: train
        ...
Tam parametre ince ayarını görmek isterseniz,
dbrx-full-ft.yaml adresindeki YAML yapılandırmasına bakın
Databricks DBRX, model hızını ve maliyet etkinliğini artırmak için birden çok özel ağ kullanır. Bu ince taneli yaklaşım, karmaşık görevleri ele almada diğer BBA'ları geride bırakmasını sağlar.
Büyük dil modelleri ve onlara nasıl ince ayar yapacağınız hakkında daha fazla bilgi edinmek ister misiniz? Şu kaynaklara göz atın:
Yapay Zekâ Yolculuğunuza Bugün Devam Edin!
Kurs
Kurs
Program
blog
Abid Ali Awan
14 dk.
blog
Dario Radečić
15 dk.
Eğitim
Adel Nehme
Eğitim
Kurtis Pykes
8 dk.




