
Kursus
Agen Teks-ke-Kueri dengan MongoDB dan LangGraph
2 jam
919
DeepSeek baru-baru ini merilis DeepSeek V3.1, model penalaran hibrida skala besar yang mendukung mode jawaban “think” dan “non-think”, sehingga ideal untuk analisis dokumen interaktif.
Dalam blog ini, saya akan berfokus pada kapabilitas agen DeepSeek V3.1 untuk memahami makalah penelitian. Saya akan menjelaskan langkah demi langkah cara mengubah PDF apa pun menjadi asisten riset interaktif melalui aplikasi Streamlit—saya akan memandu Anda melalui:
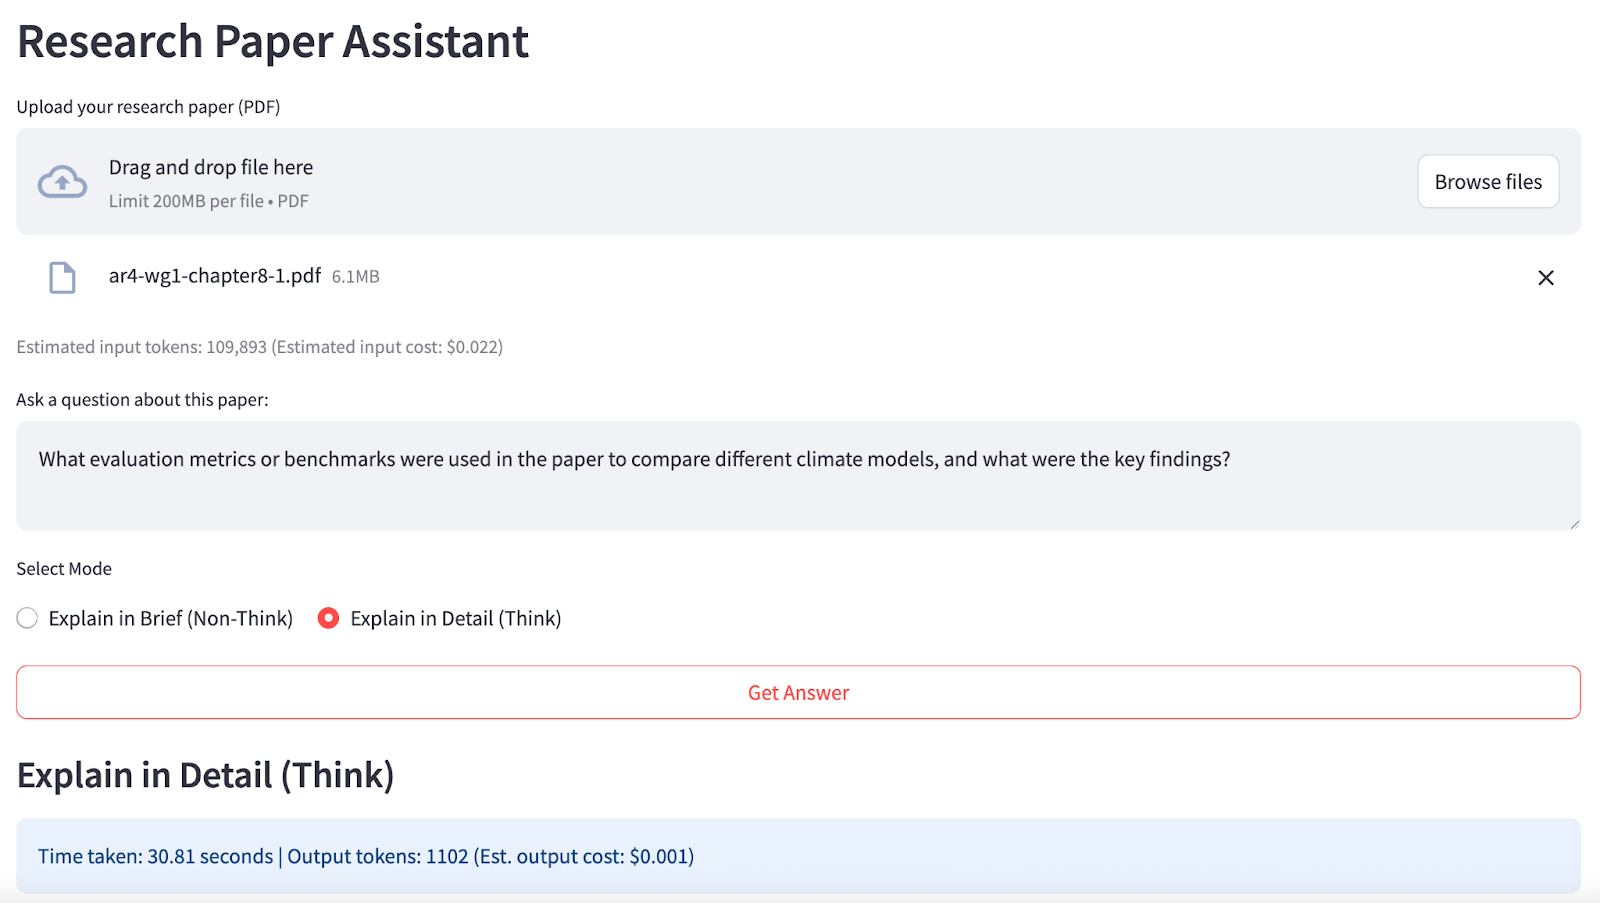
Di akhir, aplikasi Anda akan terlihat seperti ini:
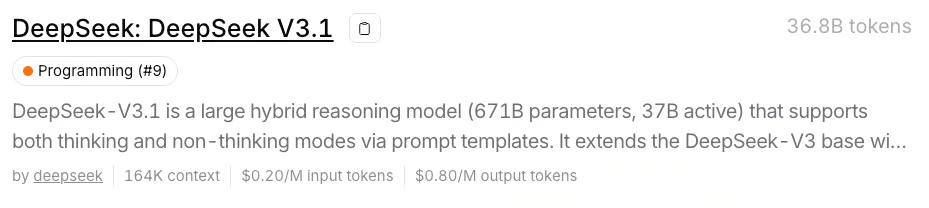
DeepSeek V3.1 adalah model Mixture-of-Experts (MoE) hibrida dengan 671 miliar parameter yang dilatih untuk gaya jawaban "thinking" (terperinci, bernalar) dan "non-thinking" (faktual, ringkas). Model ini mendukung konteks hingga 128.000 token dan dapat diakses melalui API OpenAI-kompatibel milik OpenRouter.
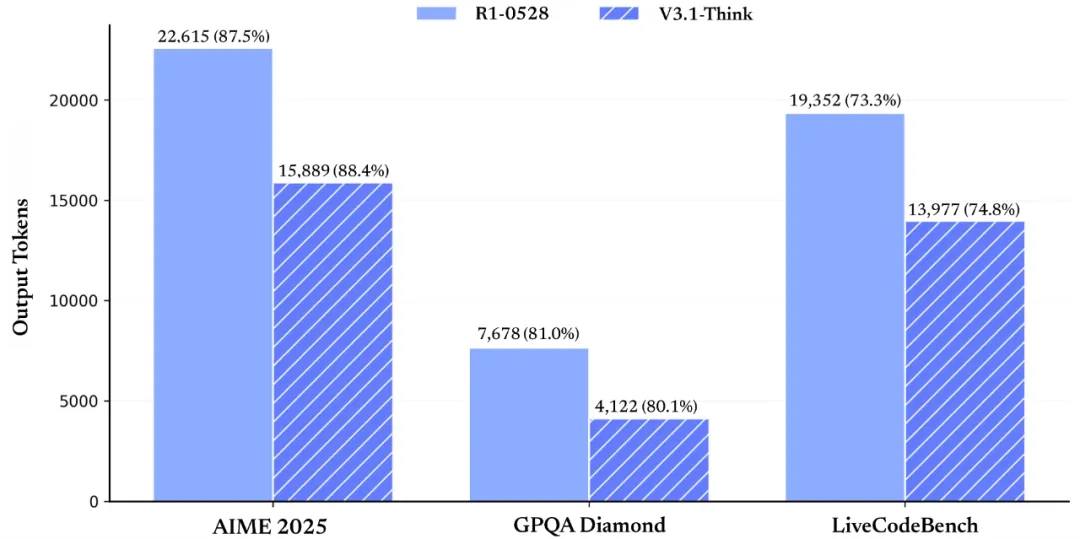
Sumber: DeepSeek
Fitur terpenting DeepSeek V3.1 adalah:
Pada bagian ini, saya akan menjelaskan bagaimana saya menggunakan DeepSeek V3.1 untuk mengubah makalah penelitian PDF apa pun yang diunggah menjadi asisten riset bertenaga AI yang interaktif.
Begini cara kerjanya:
Sebelum menjalankan demo ini, pastikan semua prasyarat sudah siap.
Pertama, pastikan Anda telah memasang impor berikut:
pip install streamlit openai pypdfPerintah ini memastikan Anda memiliki semua dependensi inti untuk UI, penanganan PDF, dan permintaan API.
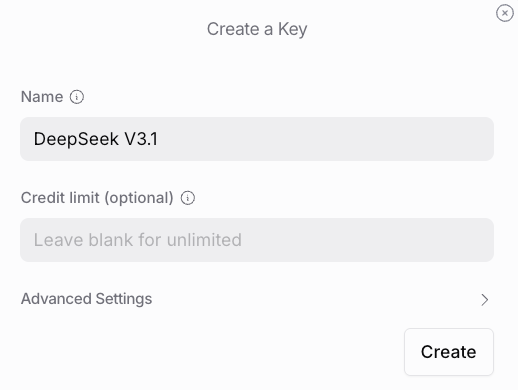
Model DeepSeek V3.1 tersedia melalui berbagai platform serta DeepSeek Official API. Namun, saya menggunakan OpenRouter yang menyediakan akses ke banyak kunci API untuk berbagai model dan paling hemat biaya untuk tujuan demo ini. Berikut langkah menyiapkan kunci API untuk DeepSeek V3.1:
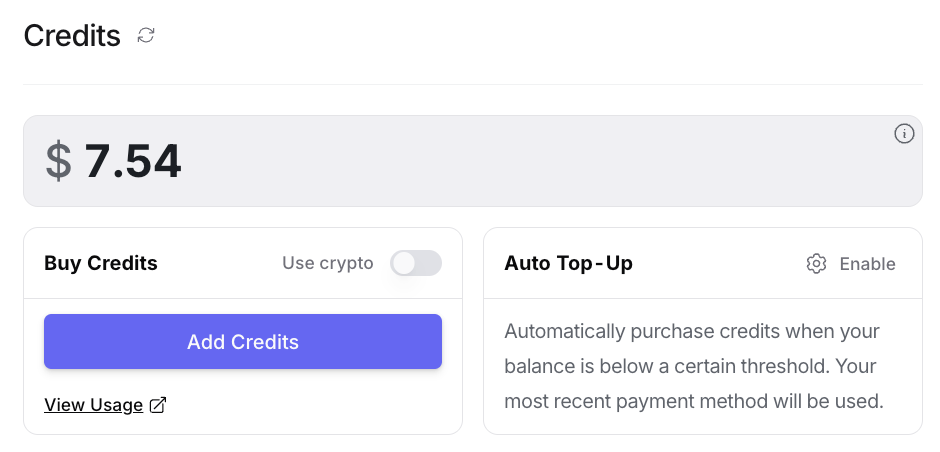
Sekarang, setel kunci API Anda sebagai variabel lingkungan sebelum menjalankan aplikasi:
export OPENROUTER_API_KEY=your_api_keyAPI resmi DeepSeek paling cocok untuk beban kerja otomatis dengan volume tinggi.
Untuk sebagian besar riset, pendidikan, atau kasus demo, termasuk Streamlit Research Paper Assistant ini, saya lebih memilih OpenRouter karena lebih sederhana dan fleksibel. Platform ini menawarkan harga global yang dapat diprediksi tanpa batasan jangka waktu atau logika cache yang perlu dikelola, sehingga cocok untuk analisis ad hoc, kueri dokumen unik, dan kolaborasi yang mudah.
Catatan: Menggunakan DeepSeek V3.1 melalui API hanya memerlukan sekitar 8 GB memori untuk UI, sehingga Anda tidak perlu meng-host model 670 miliar parameter yang masif secara lokal, yang jika tidak akan memerlukan ruang disk 170+ GB dan GPU yang kuat.
Untuk menghadirkan DeepSeek V3.1 melalui antarmuka yang ramah pengguna, kita akan menggunakan Streamlit sebagai kerangka aplikasi dan menghubungkannya ke model melalui API OpenAI-kompatibel milik OpenRouter.
Langkah ini mencakup penyiapan lingkungan, autentikasi API, dan konfigurasi dasar Streamlit.
import streamlit as stimport pypdfimport tempfilefrom openai import OpenAIimport osimport timeimport rest.set_page_config( page_title="DeepSeek V3.1 Research Assistant", layout="wide")with st.sidebar: st.title("Research Paper Assistant") st.info("Tip: Ask about the methods, findings, or reasoning for best results.")OPENROUTER_API_KEY = os.environ.get("OPENROUTER_API_KEY", "")if not OPENROUTER_API_KEY: st.warning("Add your OpenRouter API key to an environment variable.") st.stop()client = OpenAI( base_url="https://openrouter.ai/api/v1", api_key=OPENROUTER_API_KEY,)Pada kode di atas, pemanggilan fungsi st.set_page_config() menyesuaikan judul halaman dan tata letak aplikasi Streamlit. Aplikasi mengambil kunci API OpenRouter dari variabel lingkungan dan klien yang kompatibel dengan OpenAI diinisialisasi, mengarah ke endpoint API OpenRouter, memastikan semua panggilan LLM berikutnya diarahkan dan diautentikasi dengan benar untuk DeepSeek V3.1.
Sebelum membangun alur kerja utama, kita memerlukan fungsi utilitas yang andal untuk menangani pemrosesan dokumen dan estimasi sumber daya. Pada langkah ini, kita mendefinisikan fungsi pembantu untuk mengekstrak teks dari PDF yang diunggah, meninjau konten dokumen, menghitung perkiraan jumlah token, dan memperkirakan biaya berdasarkan harga DeepSeek V3.1 di OpenRouter.
def pdf_to_text(uploaded_file): with tempfile.NamedTemporaryFile(delete=False, suffix=".pdf") as tmp_file: tmp_file.write(uploaded_file.read()) tmp_path = tmp_file.name reader = pypdf.PdfReader(tmp_path) text = "" for page in reader.pages: page_text = page.extract_text() if page_text: text += page_text + "\n" return textdef preview_pdf_text(text, max_chars=600): preview = text[:max_chars] if len(text) > max_chars: preview += "\n...\n[Preview truncated]" return previewdef count_tokens(text): return max(1, int(len(text) / 4))def estimate_cost(tokens, mode="input"): if mode == "input": return tokens / 1_000_000 * 0.20 else: return tokens / 1_000_000 * 0.80Dengan fungsi pembantu ini diterapkan, backend kita siap mendukung antarmuka asisten riset yang skalabel:
pdf_to_text() memproses PDF multi-halaman menjadi teks biasa sambil mempertahankan batas halaman, membuat data sesuai untuk input LLM dan pemrosesan lanjutan.count_tokens() memberikan perkiraan jumlah token untuk membantu memantau penggunaan API relatif terhadap jendela konteks besar DeepSeek. Sementara fungsi estimate_cost() kemudian menerjemahkan jumlah token ini menjadi umpan balik biaya waktu nyata menggunakan harga OpenRouter untuk input dan output, sehingga pengguna tetap mengetahui anggaran komputasi untuk setiap kueri.preview_pdf_text() membuat pratinjau yang dipersingkat, memungkinkan pengguna memverifikasi integritas dan relevansi konten yang diekstrak sebelum menimbulkan biaya model atau mencapai batas API.Dengan fondasi ini, kita sekarang dapat melanjutkan untuk merangkai aplikasi Streamlit lengkap untuk tanya jawab makalah penelitian berkonteks panjang dan berbasis agen.
Dengan utilitas inti siap, kita kini dapat menyusun antarmuka pengguna Streamlit utama yang menyatukan pemrosesan PDF, estimasi token/biaya, tanya jawab berbasis pengguna, dan interaksi langsung dengan DeepSeek V3.1 melalui OpenRouter.
st.header("Research Paper Assistant")pdf_file = st.file_uploader("Upload your research paper (PDF)", type=["pdf"])if "paper_text" not in st.session_state or st.session_state.get("last_uploaded") != pdf_file: if pdf_file is not None: with st.spinner("Extracting text from PDF..."): st.session_state.paper_text = pdf_to_text(pdf_file) st.session_state.last_uploaded = pdf_file st.success(f"PDF uploaded. Total characters extracted: {len(st.session_state.paper_text):,}") with st.expander("Preview of extracted PDF text:"): st.code(preview_pdf_text(st.session_state.paper_text), language='markdown')paper_text = st.session_state.get("paper_text")if paper_text: input_tokens = count_tokens(paper_text) st.caption(f"Estimated input tokens: {input_tokens:,} (Estimated input cost: ${estimate_cost(input_tokens):.3f})") question = st.text_area("Ask a question about this paper:", height=80, placeholder="E.g. What are the main findings?") mode = st.radio( "Select Mode", ["Explain in Brief (Non-Think)", "Explain in Detail (Think)"], horizontal=True, ) go = st.button("Get Answer", use_container_width=True) if question and go: if mode == "Explain in Brief (Non-Think)": prompt = ( f"{paper_text}\n\n" f"Question: {question}\n" "First, answer in a few sentences. Then, quote 1–2 exact sentences from the above paper that best support your answer. " "Show each quote on a new line." ) thinking_flag = False header = "Explain in Brief (Non-Think)" else: prompt = ( f"{paper_text}\n\n" f"Question: {question}\n" "First, answer in detail with reasoning and evidence. Then, quote 2–3 exact sentences from the above paper that most strongly support your answer. " "List the quotes after your answer." ) thinking_flag = True header = "Explain in Detail (Think)" with st.spinner(f"Generating answer..."): start_time = time.perf_counter() try: response = client.chat.completions.create( model="deepseek/deepseek-chat-v3.1", messages=[ {"role": "system", "content": "You are a helpful research assistant."}, {"role": "user", "content": prompt} ], max_tokens=900, extra_body={"thinking": thinking_flag}, ) answer = response.choices[0].message.content.strip() output_tokens = count_tokens(answer) except Exception as e: answer = f"Error: {e}" output_tokens = 0 end_time = time.perf_counter() elapsed_time = end_time - start_time parts = re.split(r"(?:^|\n)(Quotes?:?)", answer, flags=re.IGNORECASE) if len(parts) >= 3: main_answer = parts[0].strip() quotes = parts[2].strip() else: main_answer = answer quotes = None st.markdown(f"### {header}") st.info(f"Time taken: {elapsed_time:.2f} seconds | Output tokens: {output_tokens} (Est. output cost: ${estimate_cost(output_tokens, 'output'):.3f})") st.write(main_answer) if quotes: st.markdown("**Supporting Quotes:**") st.success(quotes)Aplikasi Streamlit ini menerapkan asisten makalah penelitian dinamis menggunakan DeepSeek V3.1, menangani semuanya mulai dari pemasukan dokumen hingga tanya jawab LLM yang sadar konteks. Berikut fungsi-fungsi kunci yang ditangani oleh aplikasi Streamlit:
Pengguna mengunggah file PDF melalui antarmuka, lalu:
st.session_state untuk melihat apakah file baru. Jika ya, aplikasi mengekstrak teks dan menyimpannya di session_state bersama referensi unggahan, sehingga menghindari ekstraksi berulang pada setiap interaksi.Setelah dokumen dimuat, pengguna dapat mengetik pertanyaan dan memilih antara mode Non-think dan Think, di mana UI menyesuaikan instruksi prompt untuk tiap mode:
Saat pengguna mengeklik "Get Answer", aplikasi kemudian:
thinking pada permintaan API OpenRouter (extra_body={"thinking": thinking_flag}), memastikan model berjalan dalam mode penalaran yang benar, alih-alih mengandalkan temperature.Jawaban yang dikembalikan diurai sehingga respons utama dan kutipan pendukung dipisahkan (jika ditemukan). Lalu, baik jawaban maupun kutipan yang diekstrak dirender di UI, menonjolkan bukti tekstual yang tepat dari makalah sumber.
Untuk mencoba sendiri, simpan kodenya sebagai app.py dan jalankan:
streamlit run app.pyPelajari AI dengan kursus-kursus ini!
Kursus
Kursus
Kursus
blogs
Dario Radečić
15 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
David Woods
13 mnt
blogs
Javier Canales Luna
14 mnt



