
Curso
Agentes de texto a consulta con MongoDB y LangGraph
2 h
902
DeepSeek ha lanzado recientemente DeepSeek V3.1, un modelo de razonamiento híbrido a gran escala que admite modos de respuesta de “think” y “non-think”, lo que lo hace ideal para el análisis interactivo de documentos.
En este blog me centro en las capacidades agénticas de DeepSeek V3.1 para comprender artículos de investigación. Te explico paso a paso cómo convertir cualquier PDF en un asistente de investigación interactivo mediante una app de Streamlit. Verás cómo:
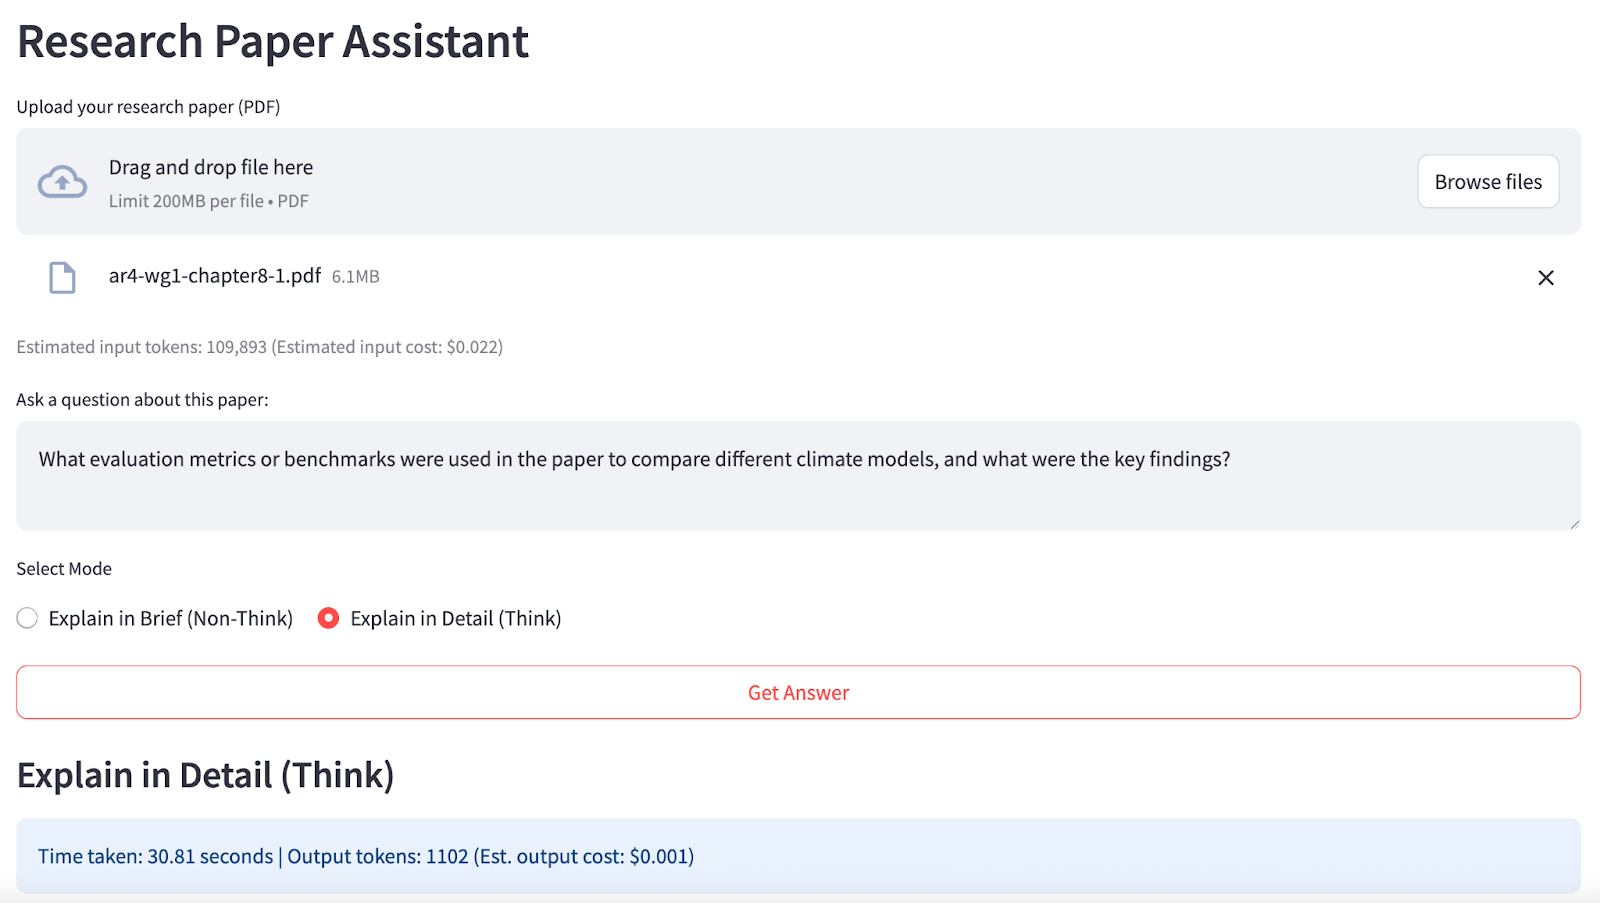
Al final, tu app se verá así:
DeepSeek V3.1 es un modelo híbrido de Mixture-of-Experts (MoE) con 671 B de parámetros, entrenado para estilos de respuesta tanto de "thinking" (detallado, con razonamiento) como de "non-thinking" (factual, conciso). Admite contextos de hasta 128.000 tokens y es accesible mediante la API compatible con OpenAI de OpenRouter.
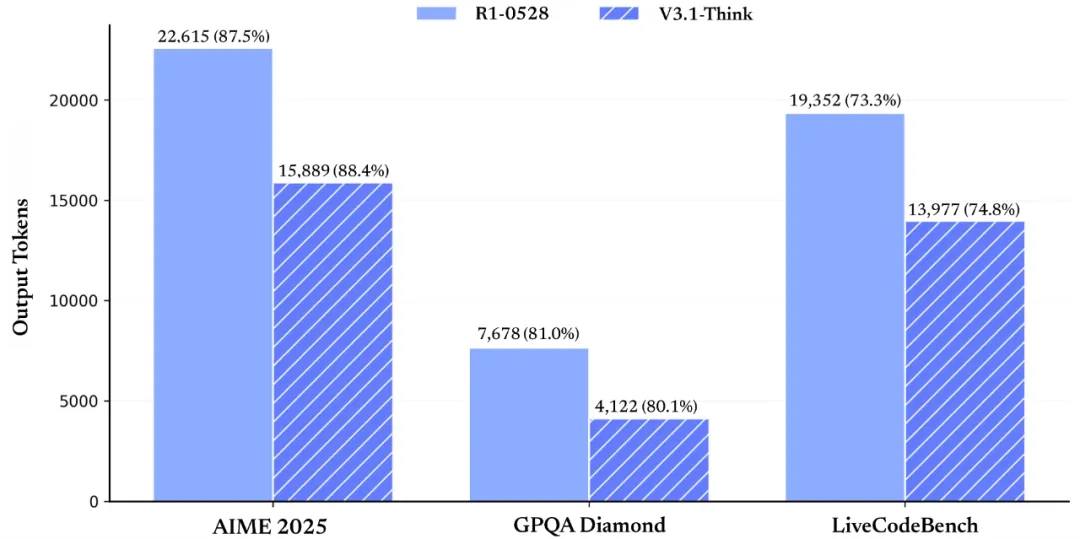
Fuente: DeepSeek
Las características más importantes de DeepSeek V3.1 son:
En esta sección te muestro cómo utilicé DeepSeek V3.1 para convertir cualquier artículo científico en PDF en un asistente de investigación interactivo con IA.
Así es como funciona:
Antes de ejecutar esta demo, asegúrate de tener todo lo necesario.
Primero, instala los siguientes paquetes:
pip install streamlit openai pypdfEste comando instala las dependencias clave para la interfaz, el manejo de PDFs y las solicitudes a APIs.
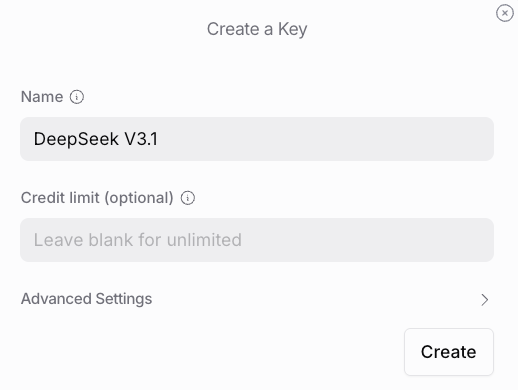
El modelo DeepSeek V3.1 está disponible en varias plataformas, incluida la API oficial de DeepSeek. Sin embargo, yo utilicé OpenRouter, que ofrece acceso con una única cuenta a múltiples modelos y resultó la opción más económica para esta demo. Estos son los pasos para crear una API key para DeepSeek V3.1:
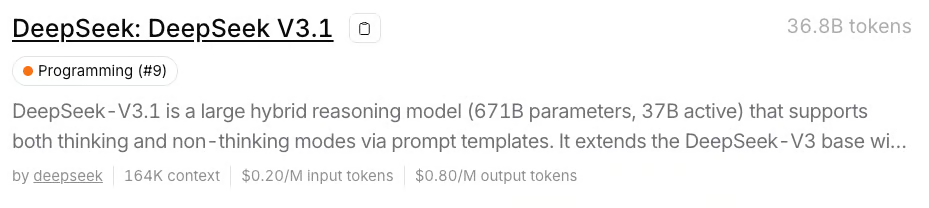
Ahora, define tu clave como variable de entorno antes de ejecutar la app:
export OPENROUTER_API_KEY=your_api_keyLa API oficial de DeepSeek es la mejor opción para cargas de trabajo automatizadas de alto volumen.
Para la mayoría de casos de investigación, educación o demos, incluido este asistente de artículos en Streamlit, prefiero OpenRouter porque es una opción más simple y flexible. Ofrece precios globales predecibles sin restricciones temporales ni lógica de caché que gestionar, perfecto para análisis ad hoc, consultas únicas sobre documentos y colaboración sencilla.
Nota: usar DeepSeek V3.1 a través de la API requiere solo unos 8 GB de memoria para la interfaz, evitando tener que alojar localmente el modelo de 670 B de parámetros, que necesitaría más de 170 GB de disco y una GPU potente.
Para ofrecer DeepSeek V3.1 en una interfaz fácil de usar, utilizaremos Streamlit como framework y lo conectaremos al modelo mediante la API compatible con OpenAI de OpenRouter.
Este paso cubre la configuración del entorno, la autenticación con la API y los ajustes básicos de Streamlit.
import streamlit as stimport pypdfimport tempfilefrom openai import OpenAIimport osimport timeimport rest.set_page_config( page_title="DeepSeek V3.1 Research Assistant", layout="wide")with st.sidebar: st.title("Research Paper Assistant") st.info("Tip: Ask about the methods, findings, or reasoning for best results.")OPENROUTER_API_KEY = os.environ.get("OPENROUTER_API_KEY", "")if not OPENROUTER_API_KEY: st.warning("Add your OpenRouter API key to an environment variable.") st.stop()client = OpenAI( base_url="https://openrouter.ai/api/v1", api_key=OPENROUTER_API_KEY,)En el código anterior, la llamada a st.set_page_config() personaliza el título y el diseño de la página en Streamlit. La app recupera la clave de OpenRouter desde las variables de entorno e instancia un cliente compatible con OpenAI apuntando al endpoint de OpenRouter, garantizando que todas las llamadas al LLM se enruten y autentiquen correctamente para DeepSeek V3.1.
Antes de construir el flujo principal, necesitamos utilidades sólidas para procesar documentos y estimar recursos. Aquí definimos funciones para extraer texto de PDFs subidos, previsualizar contenido, contar aproximadamente los tokens y estimar el coste según los precios de DeepSeek V3.1 en OpenRouter.
def pdf_to_text(uploaded_file): with tempfile.NamedTemporaryFile(delete=False, suffix=".pdf") as tmp_file: tmp_file.write(uploaded_file.read()) tmp_path = tmp_file.name reader = pypdf.PdfReader(tmp_path) text = "" for page in reader.pages: page_text = page.extract_text() if page_text: text += page_text + "\n" return textdef preview_pdf_text(text, max_chars=600): preview = text[:max_chars] if len(text) > max_chars: preview += "\n...\n[Preview truncated]" return previewdef count_tokens(text): return max(1, int(len(text) / 4))def estimate_cost(tokens, mode="input"): if mode == "input": return tokens / 1_000_000 * 0.20 else: return tokens / 1_000_000 * 0.80Con estas funciones auxiliares, el backend queda listo para dar soporte a una interfaz de asistente de investigación escalable:
pdf_to_text() convierte PDFs multipágina en texto plano preservando los saltos de página, dejando los datos listos para entrar al LLM y procesos posteriores.count_tokens() ofrece un recuento aproximado de tokens para controlar el uso de la API frente a la amplia ventana de contexto de DeepSeek. Por su parte, estimate_cost() traduce este recuento en una estimación de coste en tiempo real usando los precios de OpenRouter para entrada y salida, manteniéndote al tanto del presupuesto computacional de cada consulta.preview_pdf_text() crea vistas previas truncadas para que puedas verificar la integridad y relevancia del contenido extraído antes de incurrir en costes o chocar con límites de la API.Con estas piezas listas, pasamos a montar la app de Streamlit completa para Q&A agéntico con contexto largo sobre artículos científicos.
Con las utilidades básicas listas, montamos la interfaz principal en Streamlit que une el procesamiento del PDF, la estimación de tokens/coste, el Q&A guiado por el usuario y la interacción en tiempo real con DeepSeek V3.1 a través de OpenRouter.
st.header("Research Paper Assistant")pdf_file = st.file_uploader("Upload your research paper (PDF)", type=["pdf"])if "paper_text" not in st.session_state or st.session_state.get("last_uploaded") != pdf_file: if pdf_file is not None: with st.spinner("Extracting text from PDF..."): st.session_state.paper_text = pdf_to_text(pdf_file) st.session_state.last_uploaded = pdf_file st.success(f"PDF uploaded. Total characters extracted: {len(st.session_state.paper_text):,}") with st.expander("Preview of extracted PDF text:"): st.code(preview_pdf_text(st.session_state.paper_text), language='markdown')paper_text = st.session_state.get("paper_text")if paper_text: input_tokens = count_tokens(paper_text) st.caption(f"Estimated input tokens: {input_tokens:,} (Estimated input cost: ${estimate_cost(input_tokens):.3f})") question = st.text_area("Ask a question about this paper:", height=80, placeholder="E.g. What are the main findings?") mode = st.radio( "Select Mode", ["Explain in Brief (Non-Think)", "Explain in Detail (Think)"], horizontal=True, ) go = st.button("Get Answer", use_container_width=True) if question and go: if mode == "Explain in Brief (Non-Think)": prompt = ( f"{paper_text}\n\n" f"Question: {question}\n" "First, answer in a few sentences. Then, quote 1–2 exact sentences from the above paper that best support your answer. " "Show each quote on a new line." ) thinking_flag = False header = "Explain in Brief (Non-Think)" else: prompt = ( f"{paper_text}\n\n" f"Question: {question}\n" "First, answer in detail with reasoning and evidence. Then, quote 2–3 exact sentences from the above paper that most strongly support your answer. " "List the quotes after your answer." ) thinking_flag = True header = "Explain in Detail (Think)" with st.spinner(f"Generating answer..."): start_time = time.perf_counter() try: response = client.chat.completions.create( model="deepseek/deepseek-chat-v3.1", messages=[ {"role": "system", "content": "You are a helpful research assistant."}, {"role": "user", "content": prompt} ], max_tokens=900, extra_body={"thinking": thinking_flag}, ) answer = response.choices[0].message.content.strip() output_tokens = count_tokens(answer) except Exception as e: answer = f"Error: {e}" output_tokens = 0 end_time = time.perf_counter() elapsed_time = end_time - start_time parts = re.split(r"(?:^|\n)(Quotes?:?)", answer, flags=re.IGNORECASE) if len(parts) >= 3: main_answer = parts[0].strip() quotes = parts[2].strip() else: main_answer = answer quotes = None st.markdown(f"### {header}") st.info(f"Time taken: {elapsed_time:.2f} seconds | Output tokens: {output_tokens} (Est. output cost: ${estimate_cost(output_tokens, 'output'):.3f})") st.write(main_answer) if quotes: st.markdown("**Supporting Quotes:**") st.success(quotes)Esta aplicación de Streamlit implementa un asistente dinámico para artículos científicos con DeepSeek V3.1, gestionando desde la ingestión del documento hasta el Q&A contextual con el LLM. Estas son las funciones clave:
El usuario sube un PDF a través de la interfaz y luego:
st.session_state para ver si el archivo es nuevo. Si lo es, extrae el texto y lo guarda en session_state junto con la referencia de subida, evitando repetir la extracción en cada interacción.Con el documento cargado, puedes escribir una pregunta y elegir entre Non-think y Think; la interfaz adapta las instrucciones del prompt para cada modo:
Cuando haces clic en "Get Answer", la app:
thinking en la solicitud a la API de OpenRouter (extra_body={"thinking": thinking_flag}), asegurando que el modelo ejecute el modo de razonamiento correcto sin depender de la temperatura.La respuesta devuelta se analiza para separar el contenido principal de las citas de apoyo (si las hay). Luego se muestran ambos en la interfaz, destacando la evidencia textual exacta del artículo fuente.
Para probarlo, guarda el código como app.py y ejecuta:
streamlit run app.py¡Aprende IA con estos cursos!
Curso
Curso
Curso
blog
Abid Ali Awan
10 min
Tutorial
Dimitri Didmanidze
8 min
Tutorial
Abid Ali Awan
12 min
Tutorial
Arunn Thevapalan
12 min
Tutorial
Nadia mhadhbi
15 min
Tutorial
Moez Ali
12 min







