
Kursus
Bekerja dengan DeepSeek di Python
3 jam
1.4K
DeepSeek V3.2 Speciale adalah model penalaran berkomputasi tinggi yang dioptimalkan untuk alur kerja kompleks yang dilengkapi alat. Alih-alih hanya menjawab pertanyaan secara langsung, model ini dirancang untuk merencanakan, bernalar, dan mengoordinasikan alat untuk membangun sistem analitik beragen.
Dalam tutorial ini, kita akan menggunakan DeepSeek V3.2 Speciale untuk membangun sebuah Agen Analis Data AI yang berjalan di atas CSV apa pun. Alurnya seperti ini:
Pada akhirnya, Anda akan memiliki aplikasi Streamlit dengan rencana eksplisit dan langkah analisis yang dapat direproduksi. Jika Anda ingin mempelajari lebih lanjut tentang agen AI, saya sarankan melihat jalur keterampilan AI Agent Fundamentals.
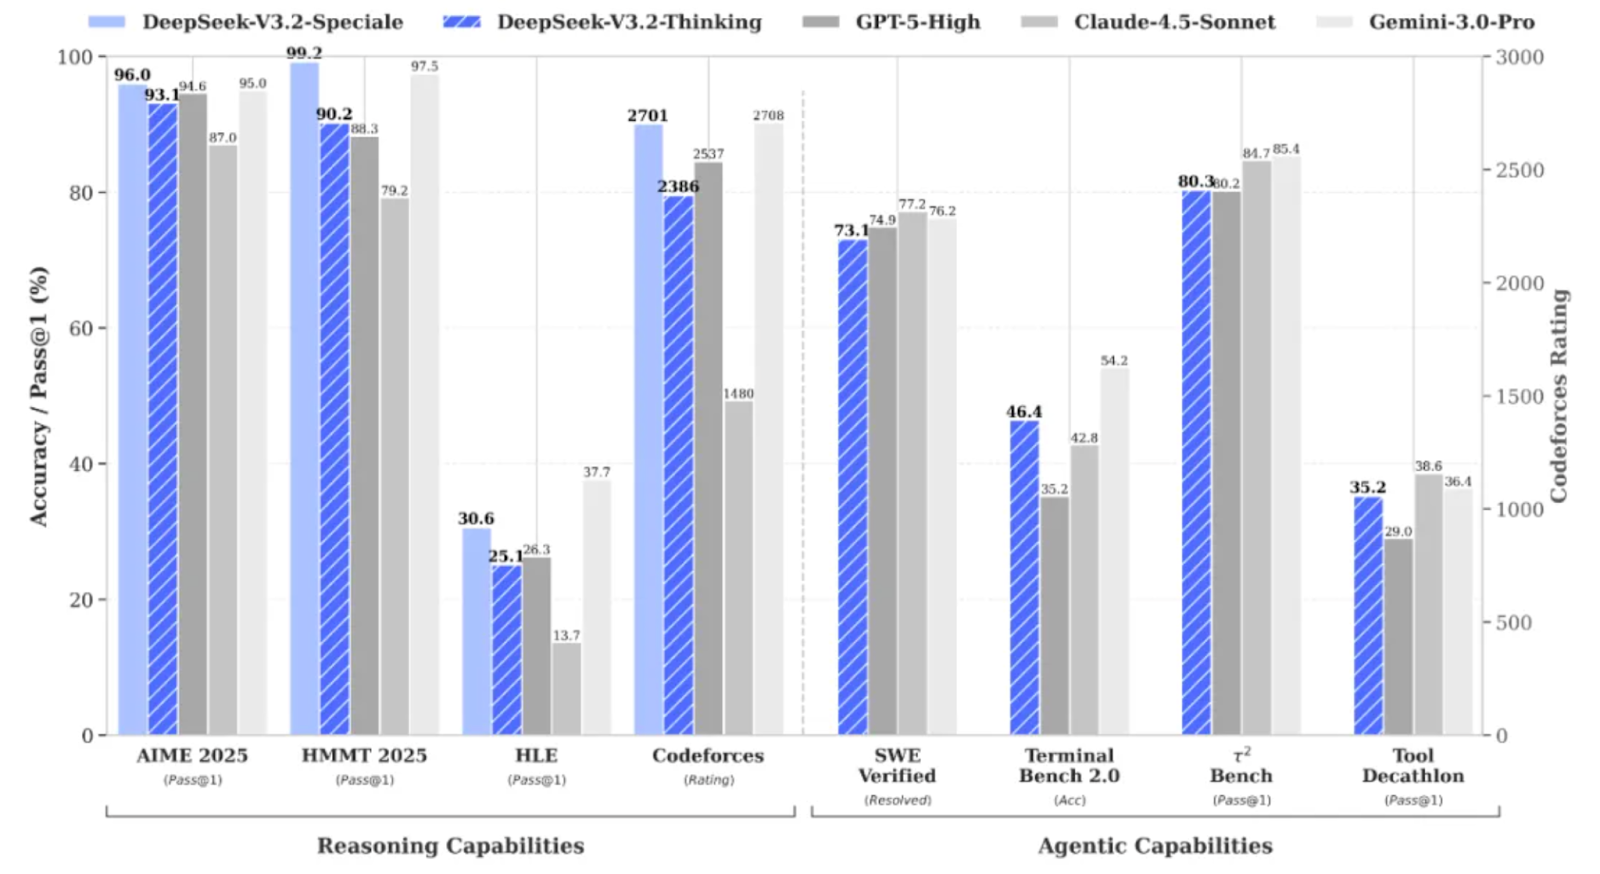
DeepSeek V3.2 Speciale adalah varian berkomputasi tinggi yang ditingkatkan dengan reinforcement learning dari keluarga DeepSeek V3.2, yang dirancang khusus untuk penalaran mendalam alih-alih obrolan santai.
Model ini mendorong kinerja hingga menyaingi model seperti Gemini 3 Pro pada tugas-tugas kompleks, dan bahkan meraih hasil medali emas pada tolok ukur seperti IMO, CMO, ICPC World Finals, dan IOI 2025.
DeepSeek V3.2 Speciale dioptimalkan untuk:
V3.2 Speciale hanya mendukung mode berpikir dan saat ini belum mendukung pemanggilan alat melalui API resmi. Anda tidak bisa sekadar mengubah temperature dan berharap mendapat JSON bersih pada percobaan pertama. Model Speciale akan bernalar panjang lebar dan sering kali menyisipkan penalarannya ke dalam jawaban akhir.
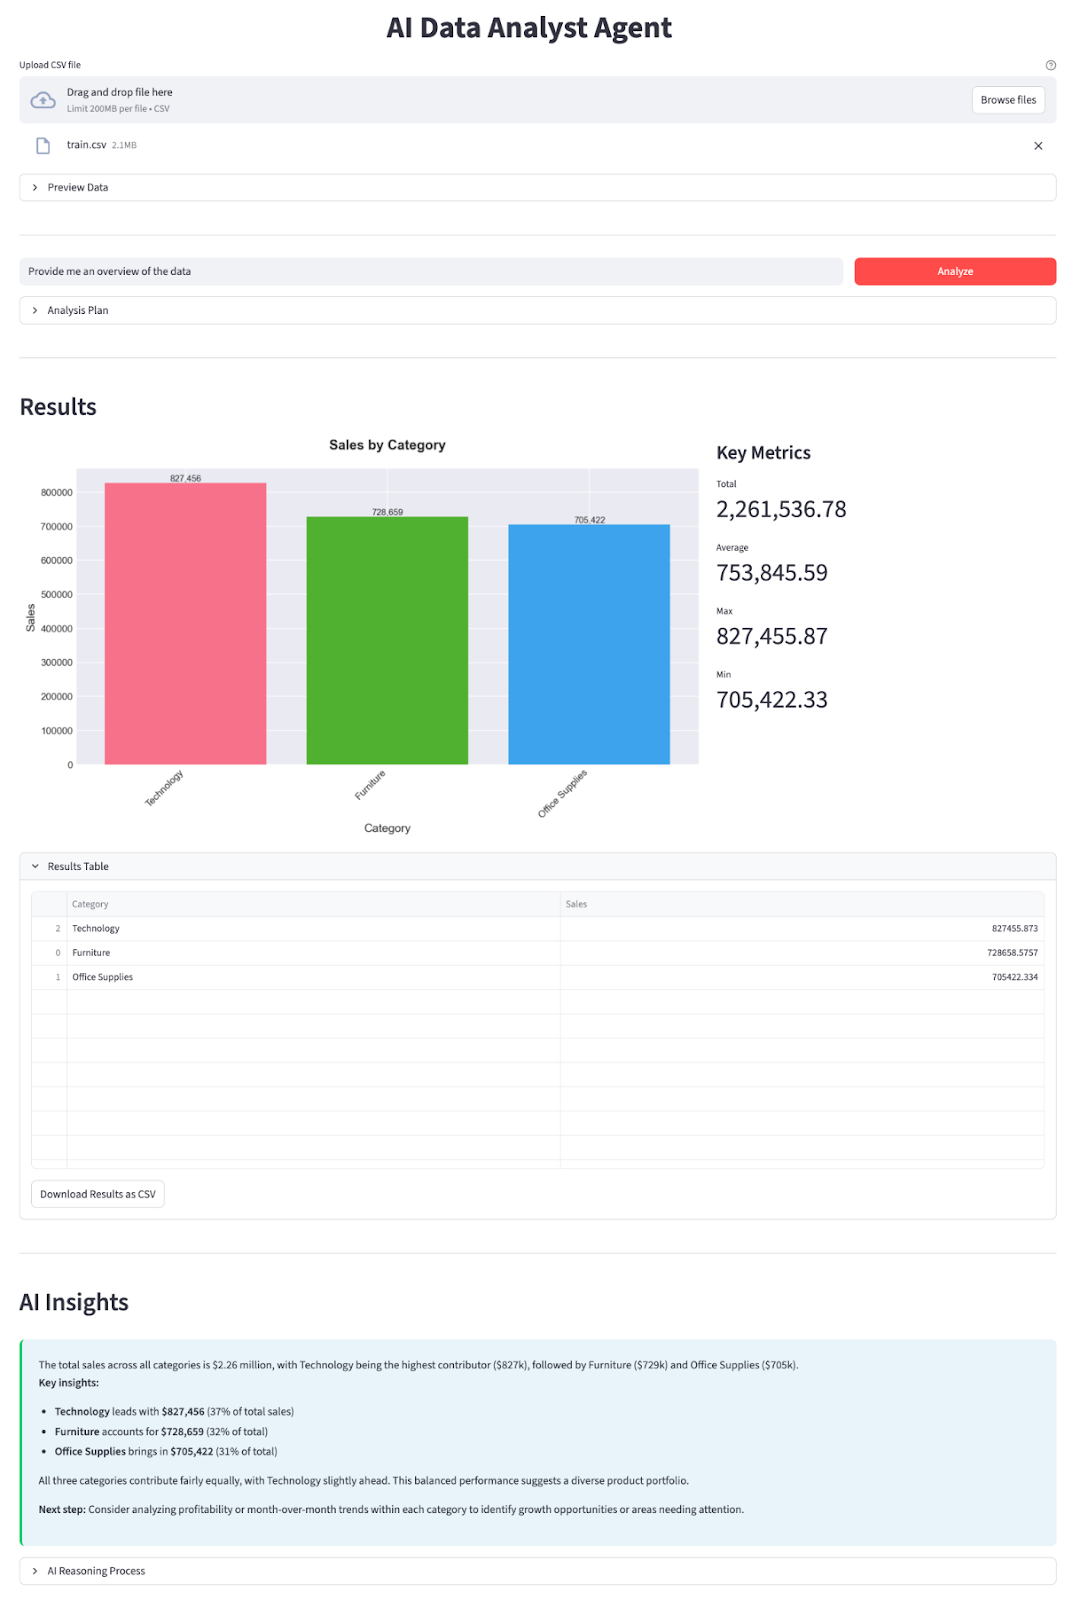
Di bagian ini, kita akan mengimplementasikan Agen Analis Data AI dengan model DeepSeek V3.2 Speciale yang dibungkus dalam aplikasi Streamlit. Secara garis besar, berikut yang dilakukan aplikasi final:
Mari kita bangun langkah demi langkah.
Pertama, instal dependensi inti dan ambil kunci API dari platform API DeepSeek:
pip install streamlit pandas matplotlib seaborn python-dotenv openaiKita akan menggunakan beberapa pustaka inti seperti streamlit untuk mendukung UI aplikasi web interaktif, pandas untuk memuat dan memanipulasi data CSV, matplotlib, dan seaborn untuk membuat grafik dan visualisasi. Pustaka python-dotenv digunakan untuk memuat variabel lingkungan dari file .env, dan OpenAI sebagai klien untuk berkomunikasi dengan API DeepSeek yang kompatibel dengan OpenAI.
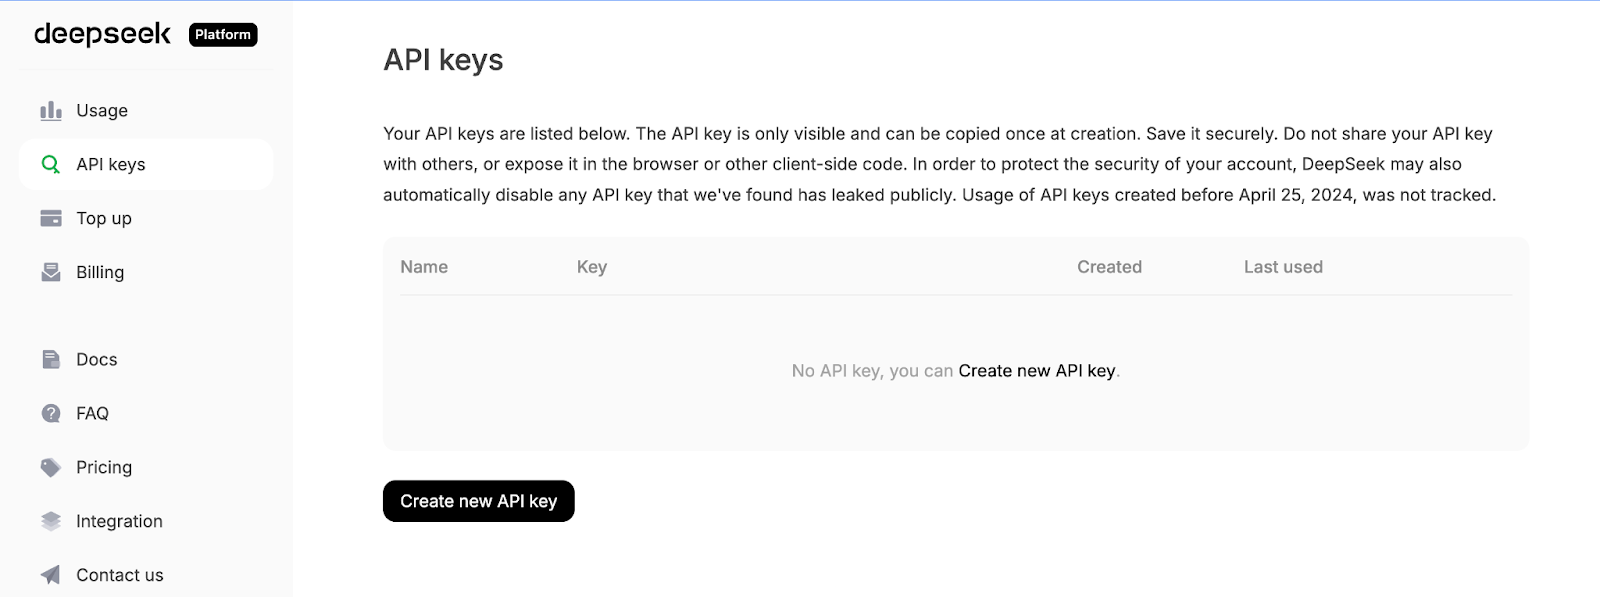
Selanjutnya, masuk ke platform API DeepSeek, buka tab API Keys, dan klik Create a new API key.
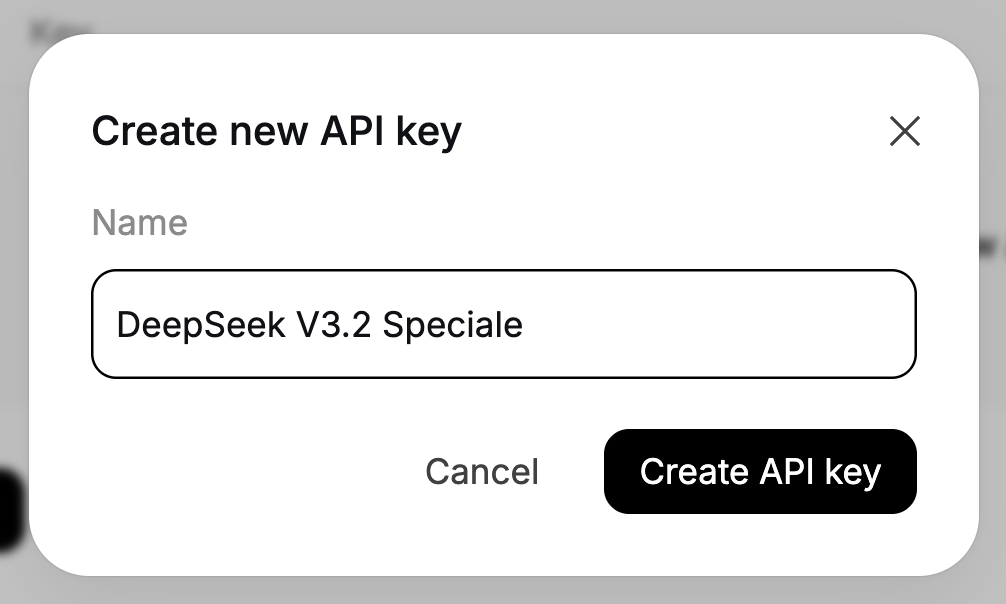
Terakhir, beri nama pada kunci Anda, dan salin kunci yang dihasilkan.
Setel kunci API DeepSeek Anda sebagai variabel lingkungan:
export DEEPSEEK_API_KEY="your_api_key_here"Sekarang lingkungan kita sudah siap.
Dengan dependensi terpasang, langkah berikutnya adalah menambahkannya ke skrip kita dan menyambungkan klien DeepSeek yang akan menggerakkan agen perencana dan penjelas.
import io
import json
import os
import re
from datetime import datetime
import matplotlib.pyplot as plt
import pandas as pd
import seaborn as sns
import streamlit as st
from dotenv import load_dotenv
from openai import OpenAI
plt.style.use('seaborn-v0_8-darkgrid')
sns.set_palette("husl")
load_dotenv()
DEEPSEEK_API_KEY = os.getenv("DEEPSEEK_API_KEY")
if not DEEPSEEK_API_KEY:
    raise RuntimeError("Please set DEEPSEEK_API_KEY env variable.")
DEEPSEEK_BASE_URL = os.getenv(
    "DEEPSEEK_BASE_URL",
    "https://api.deepseek.com/v3.2_speciale_expires_on_20251215",
)
client = OpenAI(
    api_key=DEEPSEEK_API_KEY,
    base_url=DEEPSEEK_BASE_URL,
)
Blok kode di atas melakukan tiga hal. Ia mengimpor pustaka inti, menerapkan gaya plotting, dan memuat variabel lingkungan dari .env. Lalu membaca DEEPSEEK_API_KEY, memvalidasinya, dan membangun klien OpenAI yang diarahkan ke endpoint sementara V3.2 Speciale milik DeepSeek sehingga setiap panggilan LLM berikutnya menggunakan model yang tepat.
Perhatikan bahwa DeepSeek V3.2 Speciale saat ini dilayani dari endpoint sementara yang kedaluwarsa pada 15 Desember 2025. Setelah itu, URL deployment dapat berubah, tetapi nama model akan tetap deepseek-reasoner. Untuk endpoint terbaru dan detail penggunaan, lihat dokumentasi resmi DeepSeek.
Dengan klien yang sudah dikonfigurasi, mari kita definisikan dua agen kita—satu untuk merencanakan analisis, dan satu lagi untuk menjelaskan hasil.
Dengan klien siap, kita dapat membangun Agen Perencana, yang memutuskan analisis apa yang akan dijalankan dengan data. Alih-alih membiarkan model memanipulasi DataFrame secara langsung, kita memintanya menghasilkan rencana JSON terstruktur yang dapat dieksekusi secara aman oleh “data worker” Python kita.
Perencana melihat deskripsi teks tentang dataset bersama dengan pertanyaan pengguna, dan mengembalikan objek JSON yang menjelaskan operasi, kolom group-by, filter, metrik, dan jenis grafik.
def call_planner_llm(schema_text: str, question: str) -> tuple[dict, str]:
    system_prompt = """
    You are a data analysis planner. Convert user questions into JSON plans.
    JSON Structure (REQUIRED):
    {
      "operation": "group_by_summary",
      "group_by": ["column_name"],
      "filters": [],
      "target_column": "column_to_analyze",
      "metric": "sum",
      "need_chart": true,
      "chart_type": "bar"
    }
    Fields:
    - operation: Always use "group_by_summary" (most flexible)
    - group_by: Columns to group by (e.g., ["Product Name"] or ["Category", "Region"])
    - filters: Optional filters, e.g., [{"column": "Year", "op": "==", "value": "2023"}]
    - target_column: Column to aggregate (must exist in schema!)
    - metric: One of: sum, mean, count, max, min
    - need_chart: true (always show chart)
    - chart_type: bar, line, or pie
    Quick Rules:
    - Use ONLY columns from the provided schema
    - For "this year", look for year columns or use the latest year in data
    - For "top N", use appropriate group_by and metric
    - For comparisons, use filters to split groups
    Think briefly, then output the complete JSON.
    """.strip()
    messages = [
        {"role": "system", "content": system_prompt},
        {
            "role": "user",
            "content": f"Dataset:\n{schema_text}\n\nQuestion:\n{question}\n\nReminder: After analyzing, output the complete JSON plan.",
        },
    ]
    resp = client.chat.completions.create(
        model="deepseek-reasoner",
        messages=messages,
        max_tokens=8192,
    )
    message = resp.choices[0].message
    content = message.content or ""
    content = content.strip()
    reasoning_content = getattr(message, 'reasoning_content', None) or ""
    finish_reason = resp.choices[0].finish_reason
    def extract_json_from_text(text: str) -> dict | None:
        if not text:
            return None
        try:
            return json.loads(text)
        except json.JSONDecodeError:
            pass
        code_block_match = re.search(r'```(?:json)?\s*(\{[\s\S]*?\})\s*```', text, re.DOTALL)
        if code_block_match:
            try:
                return json.loads(code_block_match.group(1))
            except json.JSONDecodeError:
                pass
        def find_all_json_objects(s):
            objects = []
            depth = 0
            start_idx = None
            in_string = False
            escape_next = False
            for i, char in enumerate(s):
                if escape_next:
                    escape_next = False
                    continue
                if char == '\\':
                    escape_next = True
                    continue
                if char == '"' and not in_string:
                    in_string = True
                elif char == '"' and in_string:
                    in_string = False
                elif not in_string:
                    if char == '{':
                        if depth == 0:
                            start_idx = i
                        depth += 1
                    elif char == '}':
                        depth -= 1
                        if depth == 0 and start_idx is not None:
                            objects.append(s[start_idx:i+1])
                            start_idx = None
            return objects
        for candidate in find_all_json_objects(text):
            try:
                parsed = json.loads(candidate)
                if isinstance(parsed, dict) and any(k in parsed for k in ['operation', 'target_column', 'metric', 'group_by']):
                    return parsed
            except json.JSONDecodeError:
                continue
        for i in range(len(text)):
            if text[i] == '{':
                decoder = json.JSONDecoder()
                try:
                    parsed, _ = decoder.raw_decode(text[i:])
                    if isinstance(parsed, dict) and any(k in parsed for k in ['operation', 'target_column', 'metric', 'group_by']):
                        return parsed
                except json.JSONDecodeError:
                    continue
        return None
    if reasoning_content:
        plan = extract_json_from_text(reasoning_content)
        if plan is not None:
            return plan, reasoning_content
    plan = extract_json_from_text(content)
    if plan is not None:
        return plan, reasoning_content
    error_msg = (
        f"Planner returned non-JSON content.\n"
        f"Finish reason: {finish_reason}\n"
        f"Content received: {repr(content[:500]) if content else '(empty)'}\n"
        f"Reasoning content length: {len(reasoning_content) if reasoning_content else 0}\n"
        f"Reasoning content sample: {reasoning_content[:500] if reasoning_content else '(none)'}"
    )
    if finish_reason == "length":
        error_msg += "\n\nNote: Response was truncated due to token limit. The model didn't finish generating the JSON."
    raise ValueError(error_msg)
Pertama, system_prompt mendefinisikan kontrak untuk Agen Perencana, yang mengonversi pertanyaan pengguna menjadi rencana JSON, dan menentukan tepatnya field apa yang kita harapkan, seperti daftar kolom group_by, filters opsional, target_column, metric, dan chart_type.
Kita juga menambahkan beberapa heuristik (seperti cara menangani “tahun ini” atau “top N”) agar model berperilaku lebih seperti analis data junior daripada chatbot umum.
Berikutnya, kita membangun pesan sistem yang membawa instruksi, dan mengemas dua hal, termasuk deskripsi tekstual skema dataset (nama kolom, dtype, sampel baris) serta pertanyaan pengguna. Ini memberi model konteks yang cukup untuk memilih nama kolom yang valid dan agregasi yang masuk akal untuk pertanyaan yang diajukan.
DeepSeek V3.2 Speciale kemudian dipanggil melalui client.chat.completions.create(). Karena ini model penalaran, ia dapat menghasilkan dua kanal keluaran, sebuah string konten yang terlihat dan string reasoning_content internal tempat sebagian besar “pemikiran” dan jawaban akhir sering berada. Kita mengambil keduanya dari respons dan mencatat finish_reason agar dapat mendeteksi pemotongan.
Pekerjaan berat terjadi di dalam fungsi extract_json_from_text(). Karena model penalaran tidak selalu mengembalikan JSON bersih, kita membungkusnya dalam markdown. Untuk membuat perencana tangguh, fungsi pembantu ini mencoba beberapa strategi secara berurutan:
json.loadsPada setiap kandidat, ia hanya menerima objek yang tampak seperti rencana valid, yakni harus memuat setidaknya salah satu field operation, target_column, metric, atau group_by.
Akhirnya, kita hubungkan semuanya dengan menerapkan fungsi extract_json_from_text() pada reasoning_content.
Bersama-sama, bagian-bagian ini mengubah pertanyaan bahasa alami dan snapshot skema menjadi rencana analisis terstruktur.
Setelah Data Worker menjalankan analisis dengan Pandas, kita mengirim tabel hasil bersama rencana JSON kembali ke DeepSeek dan mengubah semuanya menjadi ringkasan dengan wawasan konkret.
def call_explainer_llm(question: str, plan: dict, result_summary: list) -> tuple[str, str]:
    system_prompt = """
    You are a senior data analyst explaining insights to business stakeholders.
    The user asked a question about their CSV data.
    Another agent already designed an analysis plan and we executed it in Python.
    You will now explain the results in clear, engaging, non-technical language.
    Requirements:
    - Start with a direct 1-2 sentence answer to their question
    - Use bullet points (3-5 points) to highlight key insights, trends, or comparisons
    - Include specific numbers and percentages where relevant
    - Use business-friendly language (avoid technical jargon like "aggregation", "groupby")
    - If the data shows interesting patterns, point them out
    - End with a brief recommendation or next step if appropriate
    Keep it concise and actionable.
    """.strip()
    limited_summary = result_summary[:20] if len(result_summary) > 20 else result_summary
    user_content = f"""
    User question:
    {question}
    Analysis performed:
    {json.dumps(plan, indent=2)}
    Results (top rows):
    {json.dumps(limited_summary, indent=2)}
    Total rows in result: {len(result_summary)}
    """.strip()
    messages = [
        {"role": "system", "content": system_prompt},
        {"role": "user", "content": user_content},
    ]
    resp = client.chat.completions.create(
        model="deepseek-reasoner",
        messages=messages,
        max_tokens=2048,
    )
    message = resp.choices[0].message
    content = message.content or ""
    content = content.strip()
    reasoning_content = getattr(message, 'reasoning_content', None) or ""
    if not content:
        if reasoning_content:
            content = reasoning_content.strip()
    return (content if content else "Unable to generate explanation from the model response.",
            reasoning_content)
Agen penjelas dimulai dengan menetapkan system_prompt, yang menginstruksikan DeepSeek untuk berperan seperti analis data senior yang berbicara kepada pemangku kepentingan bisnis. Kita menentukan bentuk jawaban yang diinginkan, beserta panduan lain untuk menyusun respons.
Selanjutnya, kita menyiapkan user_content, yang memberikan semua konteks yang dibutuhkan model. Kita meneruskan pertanyaan asli, rencana analisis JSON (agar model tahu komputasi apa yang dijalankan), dan total jumlah baris.
Lalu kita menyusun daftar pesan dan memanggil DeepSeek V3.2 Speciale melalui client.chat.completions.create(). Seperti pada perencana, model dapat mengembalikan teks di content dan reasoning_content, jadi kita mengambil keduanya dan menggunakan reasoning_content jika content kosong.
Terakhir, fungsi mengembalikan tuple yang mencakup penjelasan dan string penalaran mentah yang muncul di expander.
Dengan Agen Penjelas ini, putaran menjadi lengkap:
Sebelum kita membiarkan DeepSeek merencanakan apa pun, kita perlu mendeskripsikan data dengan jelas dan membuatnya ramah analisis. Ini dicapai menggunakan sekumpulan fungsi pembantu.
Agen Perencana tidak dapat melihat DataFrame Anda secara langsung, jadi kita mengirim ringkasan tekstual yang ringkas tentang dataset.
def get_schema_description(df: pd.DataFrame, max_rows: int = 3) -> str:
    schema_lines = ["Columns:"]
    for col, dtype in df.dtypes.items():
        if dtype == 'object' and df[col].nunique() < 20:
            unique_vals = df[col].dropna().unique()[:5]
            schema_lines.append(f"- {col} ({dtype}) - sample values: {', '.join(map(str, unique_vals))}")
        else:
            schema_lines.append(f"- {col} ({dtype})")
    sample = df.head(max_rows).to_markdown(index=False)
    return "\n".join(schema_lines) + "\n\nSample rows:\n" + sample
Fungsi pembantu ini melakukan loop atas semua kolom. Ia juga menyertakan beberapa nilai sampel untuk hal-hal seperti nama produk, wilayah, atau kategori. F
inalnya, ia menambahkan tabel markdown singkat dari beberapa baris pertama, sehingga model memiliki contoh konkret untuk bernalar.
String skema ini adalah “mata” perencana pada data Anda yang memungkinkannya memilih nama kolom dan group-by yang valid.
Kita secara otomatis mendeteksi kolom tanggal dan menambahkan field pembantu seperti <col>_year dan <col>_year_month, yang memudahkan DeepSeek menjawab pertanyaan seperti “tahun lalu” atau “per bulan”.
def preprocess_dates(df: pd.DataFrame) -> pd.DataFrame:
    df = df.copy()
    date_columns = []
    for col in df.columns:
        if pd.api.types.is_datetime64_any_dtype(df[col]):
            date_columns.append(col)
            continue
        if any(x in col.lower() for x in ['date', 'time', 'day']):
            try:
                df[col] = pd.to_datetime(df[col], errors='coerce')
                if df[col].notna().sum() > 0:
                    date_columns.append(col)
            except:
                pass
    for col in date_columns:
        if col in df.columns and pd.api.types.is_datetime64_any_dtype(df[col]):
            df[f'{col}_year'] = df[col].dt.year
            df[f'{col}_month'] = df[col].dt.month
            df[f'{col}_year_month'] = df[col].dt.to_period('M').astype(str)
    return df
Pertama, kita memindai kolom, dan jika sebuah kolom sudah bertipe datetime atau namanya mengisyaratkan tanggal (seperti order_date atau day), kita mencoba menguraikannya dengan pd.to_datetime. Untuk setiap kolom tanggal, kita membuat fitur seperti <col>_year, <col>_month, dan <col>_year_month.
Prapemrosesan ini berarti perencana dapat dengan aman mereferensikan kolom year dan year_month tanpa Anda merekayasa fitur waktu secara manual untuk setiap dataset.
Perencana dapat menambahkan filter baris sederhana ke rencana, dan fungsi pembantu ini mengubahnya menjadi filter pandas.
def apply_filters(df: pd.DataFrame, filters: list) -> pd.DataFrame:
    if not filters:
        return df
    filtered = df.copy()
    for f in filters:
        col = f.get("column")
        op = f.get("op")
        val = f.get("value")
        if col not in filtered.columns:
            continue
        try:
            val_cast = pd.to_numeric(val)
        except Exception:
            val_cast = val
        if op == "==":
            filtered = filtered[filtered[col] == val_cast]
        elif op == "!=":
            filtered = filtered[filtered[col] != val_cast]
        elif op == ">":
            filtered = filtered[filtered[col] > val_cast]
        elif op == "<":
            filtered = filtered[filtered[col] < val_cast]
        elif op == ">=":
            filtered = filtered[filtered[col] >= val_cast]
        elif op == "<=":
            filtered = filtered[filtered[col] <= val_cast]
        elif op == "contains":
            filtered = filtered[filtered[col].astype(str).str.contains(str(val_cast), case=False, na=False)]
    return filtered
Untuk setiap filter, kita memeriksa bahwa kolomnya ada, dan mengubah nilai menjadi angka jika memungkinkan, lalu menerapkan perbandingan yang sesuai. Semua filter diterapkan secara berurutan, sehingga Anda dapat menggabungkan kondisi secara natural seperti “Region contains West” dan “Year >= 2021”.
Fungsi ini menghubungkan batasan bahasa alami dari rencana ke subset baris.
Sekarang kita mengimplementasikan Data Worker, yaitu lapisan tipis yang membaca rencana JSON dan menjalankan agregasi pandas yang sesuai.
def run_analysis_plan(df: pd.DataFrame, plan: dict) -> pd.DataFrame:
    op = plan.get("operation")
    target_col = plan.get("target_column")
    group_by = plan.get("group_by") or []
    filters = plan.get("filters") or []
    metric = plan.get("metric", "sum")
    if filters:
        df = apply_filters(df, filters)
    if not op or not target_col or target_col not in df.columns:
        return df.head(20)
    if op in ("aggregate_compare", "group_by_summary", "filter_then_aggregate"):
        if not group_by:
            if metric == "sum":
                value = df[target_col].sum()
            elif metric == "mean":
                value = df[target_col].mean()
            elif metric == "count":
                value = df[target_col].count()
            elif metric == "max":
                value = df[target_col].max()
            elif metric == "min":
                value = df[target_col].min()
            else:
                raise ValueError(f"Unsupported metric: {metric}")
            return pd.DataFrame({f"{metric}_{target_col}": [value]})
        if metric == "sum":
            agg_df = df.groupby(group_by)[target_col].sum().reset_index()
        elif metric == "mean":
            agg_df = df.groupby(group_by)[target_col].mean().reset_index()
        elif metric == "count":
            agg_df = df.groupby(group_by)[target_col].count().reset_index()
        elif metric == "max":
            agg_df = df.groupby(group_by)[target_col].max().reset_index()
        elif metric == "min":
            agg_df = df.groupby(group_by)[target_col].min().reset_index()
        else:
            raise ValueError(f"Unsupported metric: {metric}")
        agg_df = agg_df.sort_values(by=target_col, ascending=False)
        return agg_df
    return df.head(20)
Kita mulai dengan membongkar rencana dengan parameter operasi, kolom target, kolom pengelompokan, filter, dan metrik. T
erus, filter diterapkan melalui fungsi apply_filters(). Jika rencana mereferensikan kolom yang tidak valid, kita kembali menampilkan pratinjau sederhana.
Jika tidak, untuk operasi yang didukung, kita mengagregasi seluruh tabel atau menjalankan groupby diikuti operasi seperti sum, mean, count, max, atau min, dan mengurutkan hasil berdasarkan kolom metrik.
Inilah inti dari lapisan alat: LLM memutuskan apa yang dihitung, dan fungsi ini memutuskan bagaimana menghitungnya secara aman dengan pandas.
Terakhir, kita mengubah tabel hasil menjadi grafik yang sesuai dengan chart_type dari rencana, sehingga kita memiliki angka dan visual di keluaran.
def generate_chart(df: pd.DataFrame, plan: dict):
    if not plan.get("need_chart") or df.empty:
        return None
    chart_type = plan.get("chart_type", "bar")
    group_by = plan.get("group_by") or []
    target_col = plan.get("target_column")
    if not target_col or target_col not in df.columns:
        return None
    fig, ax = plt.subplots(figsize=(10, 6))
    if group_by and len(group_by) > 0:
        x_col = group_by[0]
        if x_col not in df.columns:
            return None
        plot_df = df.head(15)
        if chart_type == "bar":
            bars = ax.bar(range(len(plot_df)), plot_df[target_col], color=sns.color_palette("husl", len(plot_df)))
            ax.set_xticks(range(len(plot_df)))
            ax.set_xticklabels(plot_df[x_col], rotation=45, ha='right')
            ax.set_ylabel(target_col, fontsize=12)
            ax.set_xlabel(x_col, fontsize=12)
            for i, (bar, val) in enumerate(zip(bars, plot_df[target_col])):
                height = bar.get_height()
                ax.text(bar.get_x() + bar.get_width()/2., height,
                       f'{val:,.0f}' if abs(val) > 100 else f'{val:.2f}',
                       ha='center', va='bottom', fontsize=9)
        elif chart_type == "line":
            ax.plot(range(len(plot_df)), plot_df[target_col], marker='o', linewidth=2, markersize=8)
            ax.set_xticks(range(len(plot_df)))
            ax.set_xticklabels(plot_df[x_col], rotation=45, ha='right')
            ax.set_ylabel(target_col, fontsize=12)
            ax.set_xlabel(x_col, fontsize=12)
            ax.grid(True, alpha=0.3)
        elif chart_type == "pie" and len(plot_df) <= 10:
            ax.pie(plot_df[target_col], labels=plot_df[x_col], autopct='%1.1f%%', startangle=90)
            ax.axis('equal')
        else:
            bars = ax.bar(range(len(plot_df)), plot_df[target_col])
            ax.set_xticks(range(len(plot_df)))
            ax.set_xticklabels(plot_df[x_col], rotation=45, ha='right')
        title = f"{target_col} by {x_col}"
    else:
        ax.bar([target_col], [df[target_col].iloc[0]])
        title = f"{target_col}"
    ax.set_title(title, fontsize=14, fontweight='bold', pad=20)
    fig.tight_layout()
    buf = io.BytesIO()
    fig.savefig(buf, format="png", dpi=150, bbox_inches='tight')
    buf.seek(0)
    plt.close(fig)
    return buf
Kita membaca chart_type, group_by, dan target_column dari rencana dan membangun figur Matplotlib. Fungsi generate_chart() di atas mengembalikan buffer PNG dalam memori yang ditampilkan aplikasi Streamlit di samping metrik utama.
Dengan fungsi pembantu ini, sisa sistem menjadi jauh lebih sederhana. Perencana menggunakan get_schema_description untuk merancang analisis, Data Worker menggunakan fungsi preprocess_dates(), apply_filters(), dan run_analysis_plan() untuk memproses angka, dan fungsi generate_chart() mengubah tabel akhir menjadi grafik.
Sekarang perencana, data worker, penjelas, dan fungsi pembantu sudah siap, kita dapat membungkus semuanya dalam aplikasi Streamlit.
st.set_page_config(
    page_title="AI Data Analyst Agent",
    page_icon="📊",
    layout="wide",
    initial_sidebar_state="expanded"
)
st.markdown("""
<style>
    .main-header {

        font-weight: 700;


        text-align: center;
    }
    .sub-header {


        text-align: center;
    }
    .metric-card {
        background-

        border-radius: 0.5rem;
        border-left: 4px solid #1f77b4;
    }
    .insight-box {
        background-

        border-radius: 0.5rem;
        border-left: 4px solid #2ecc71;

    }
</style>
""", unsafe_allow_html=True)
st.markdown("<h1 class='main-header'>AI Data Analyst Agent</h1>", unsafe_allow_html=True)
uploaded_file = st.file_uploader("Upload CSV file", type=["csv"], help="Upload any CSV file to get started")
if uploaded_file is not None:
    try:
        df = pd.read_csv(uploaded_file)
        df = preprocess_dates(df)
    except Exception as e:
        st.error(f"Error loading CSV: {e}")
        st.stop()
    with st.expander("Preview Data", expanded=False):
        col1, col2, col3 = st.columns(3)
        col1.metric("Total Rows", f"{len(df):,}")
        col2.metric("Total Columns", len(df.columns))
        col3.metric("Memory Usage", f"{df.memory_usage(deep=True).sum() / 1024**2:.1f} MB")
        st.dataframe(df.head(100), width='stretch', height=300)
        st.markdown("**Numeric Columns Summary:**")
        numeric_cols = df.select_dtypes(include=['number']).columns
        if len(numeric_cols) > 0:
            st.dataframe(df[numeric_cols].describe(), width='stretch')
    st.markdown("---")
    col1, col2 = st.columns([4, 1])
    with col1:
        question = st.text_input(
            " Ask a question about your data",
            placeholder="e.g., Which product category had the highest sales last year?",
            label_visibility="collapsed"
        )
    with col2:
        analyze_button = st.button("Analyze", type="primary", width='stretch')
    if analyze_button and question.strip():
        with st.spinner("Analyzing data..."):
            schema_text = get_schema_description(df)
            try:
                plan, planner_reasoning = call_planner_llm(schema_text, question)
            except Exception as e:
                st.error(f" Planner agent failed: {e}")
                st.stop()
            with st.expander(" Analysis Plan", expanded=False):
                col1, col2 = st.columns(2)
                with col1:
                    st.json(plan)
                with col2:
                    if planner_reasoning:
                        st.markdown("**AI Reasoning Process:**")
                        st.text_area("Planner Reasoning", planner_reasoning[:1000] + "..." if len(planner_reasoning) > 1000 else planner_reasoning,
                                   height=200, label_visibility="collapsed")
            try:
                result_df = run_analysis_plan(df, plan)
            except Exception as e:
                st.error(f" Error running analysis: {e}")
                st.info(" Tip: Try rephrasing your question or be more specific about the columns you want to analyze.")
                st.stop()
        st.markdown("---")
        st.markdown("## Results")
        chart_buf = generate_chart(result_df, plan)
        if chart_buf is not None:
            col1, col2 = st.columns([2, 1])
            with col1:
                st.image(chart_buf)
            with col2:
                st.markdown("### Key Metrics")
                target_col = plan.get("target_column")
                if target_col in result_df.columns:
                    st.metric("Total", f"{result_df[target_col].sum():,.2f}")
                    st.metric("Average", f"{result_df[target_col].mean():,.2f}")
                    st.metric("Max", f"{result_df[target_col].max():,.2f}")
                    st.metric("Min", f"{result_df[target_col].min():,.2f}")
        else:
            st.info("Chart generation skipped (not applicable for this query)")
        with st.expander("Results Table", expanded=True):
            st.dataframe(result_df, width='stretch', height=400)
            csv_data = result_df.to_csv(index=False)
            st.download_button(
                label="Download Results as CSV",
                data=csv_data,
                file_name=f"analysis_results_{datetime.now().strftime('%Y%m%d_%H%M%S')}.csv",
                mime="text/csv"
            )
        with st.spinner("Generating insights..."):
            result_df_serializable = result_df.copy()
            for col in result_df_serializable.columns:
                if pd.api.types.is_datetime64_any_dtype(result_df_serializable[col]):
                    result_df_serializable[col] = result_df_serializable[col].astype(str)
                elif pd.api.types.is_period_dtype(result_df_serializable[col]):
                    result_df_serializable[col] = result_df_serializable[col].astype(str)
            result_summary = result_df_serializable.to_dict(orient="records")
            explanation, explainer_reasoning = call_explainer_llm(
                question=question,
                plan=plan,
                result_summary=result_summary,
            )
        st.markdown("---")
        st.markdown("## AI Insights")
        st.markdown(f'<div class="insight-box">{explanation}</div>', unsafe_allow_html=True)
        if explainer_reasoning:
            with st.expander(" AI Reasoning Process", expanded=False):
                st.text_area("Explainer Reasoning", explainer_reasoning[:1500] + "..." if len(explainer_reasoning) > 1500 else explainer_reasoning,
                           height=300, label_visibility="collapsed")
Di bagian atas, kita mengonfigurasi halaman dengan st.set_page_config dan CSS untuk menata dasbor. Pengguna terlebih dahulu mengunggah CSV, yang kita muat ke DataFrame, melewati preprocess_dates, dan tampilkan di dalam expander Preview Data dengan jumlah baris/kolom, penggunaan memori, dan ringkasan cepat.
Di balik layar, kita membangun skema dengan fungsi get_schema_description(), memanggil call_planner_llm untuk mendapatkan rencana JSON, dan menampilkan baik rencana maupun penalaran model di dalam expander. Data Worker kemudian mengeksekusi rencana dengan pandas, dan bagian Results menampilkan grafik dari generate_chart beserta metrik utama.
Terakhir, kita memanggil call_explainer_llm dengan pertanyaan, rencana, dan ringkasan hasil untuk menghasilkan penjelasan bagi kotak AI Insights, dengan expander opsional AI Reasoning Process untuk siapa pun yang ingin mengintip di balik kap.
Simpan semuanya sebagai app.py dan jalankan:
streamlit run app.pyPada video di bawah, Anda dapat melihat versi singkat dari alur kerja yang berjalan:
Kursus Teratas di DataCamp
Kursus
Kursus
Kursus
blogs
Dario Radečić
15 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
David Woods
13 mnt
blogs
Javier Canales Luna
14 mnt



