
Curso
Agentes de Text-to-Query com MongoDB e LangGraph
2 h
902
A DeepSeek lançou recentemente o DeepSeek V3.1, um modelo híbrido de raciocínio em grande escala que suporta modos de resposta com e sem "pensamento" (think/non-think), ideal para análise interativa de documentos.
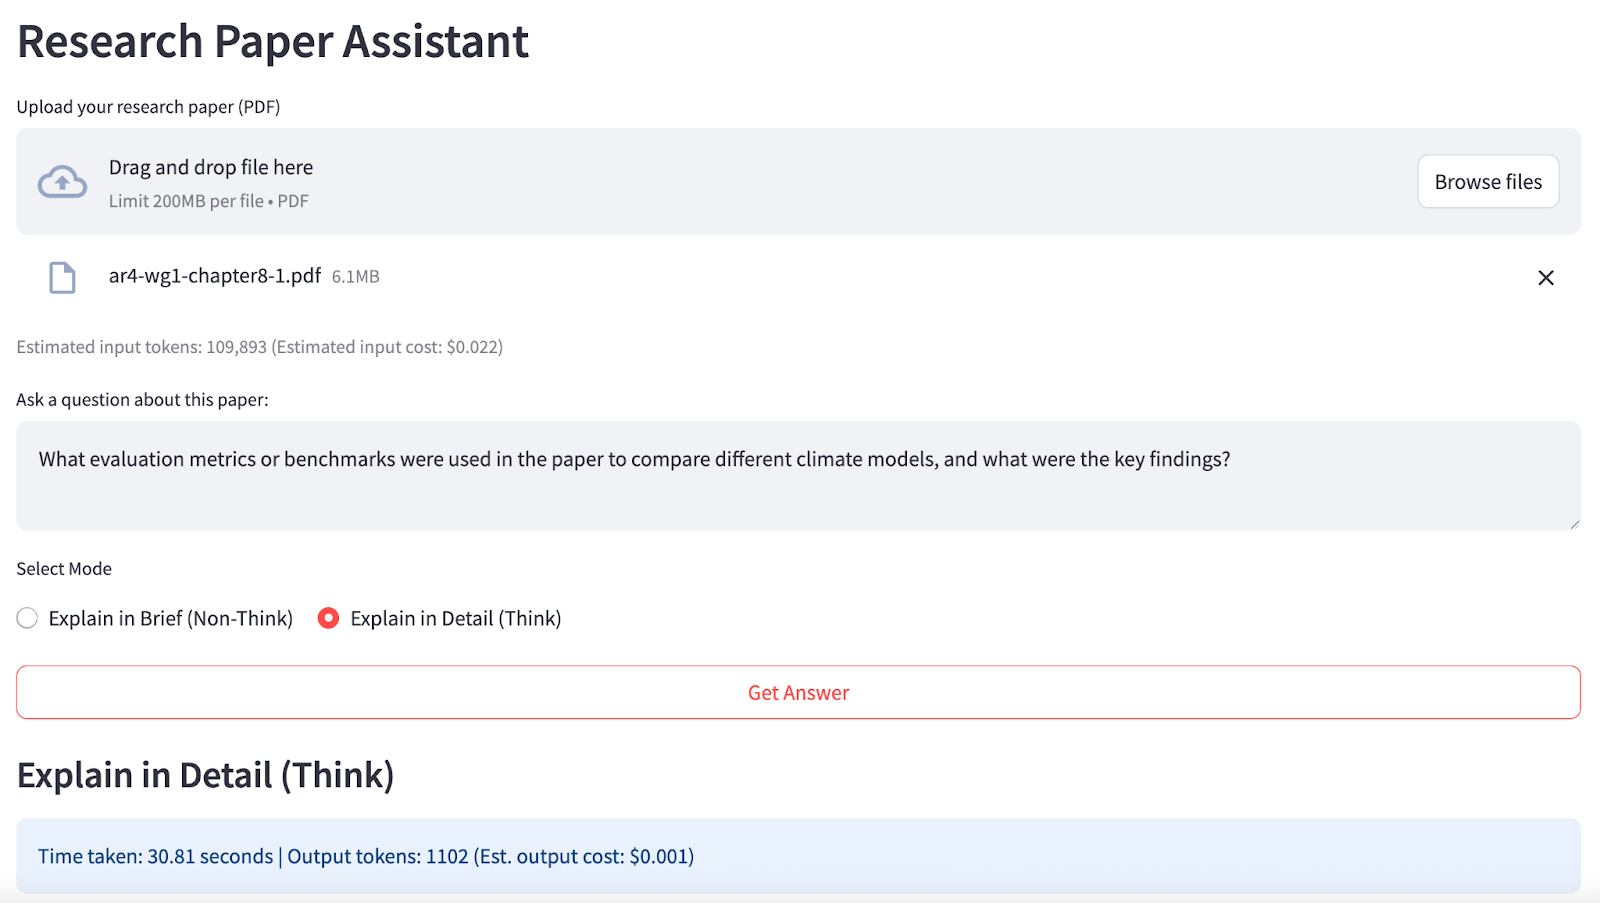
Neste blog, vou focar nas capacidades agentivas do DeepSeek V3.1 para entender artigos científicos. Vou explicar passo a passo como transformar qualquer PDF em um assistente de pesquisa interativo por meio de um app em Streamlit — vou mostrar:
No fim, seu app vai ficar assim:
O DeepSeek V3.1 é um modelo híbrido de Mixture-of-Experts (MoE) com 671 bilhões de parâmetros, treinado para respostas com "pensamento" (detalhadas, fundamentadas) e sem "pensamento" (factuais, concisas). Ele suporta contextos de até 128.000 tokens e é acessível via a API compatível com OpenAI do OpenRouter.
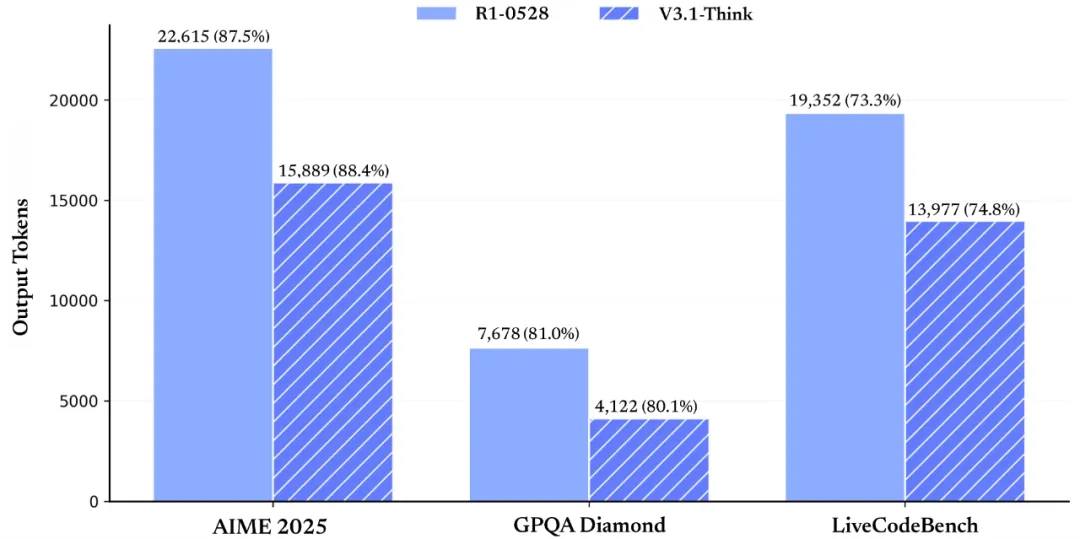
Fonte: DeepSeek
Os recursos mais importantes do DeepSeek V3.1 são:
Nesta seção, explico como usei o DeepSeek V3.1 para transformar qualquer artigo científico em PDF enviado pelo usuário em um assistente de pesquisa com IA.
Veja como funciona:
Antes de rodar esta demo, vamos garantir que todos os pré-requisitos estejam prontos.
Primeiro, garanta que você instalou os seguintes pacotes:
pip install streamlit openai pypdfEsse comando garante que você tenha as dependências básicas para a interface, tratamento de PDF e requisições à API.
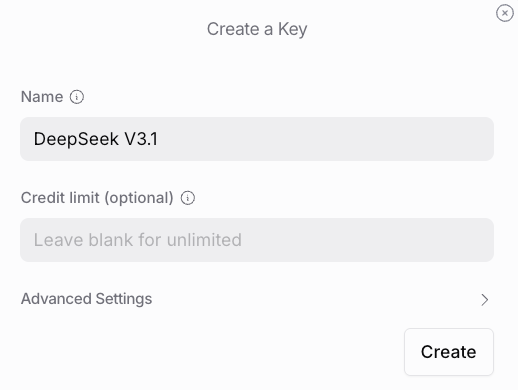
O modelo DeepSeek V3.1 está disponível em várias plataformas, inclusive na API oficial da DeepSeek. Porém, usei o OpenRouter, que oferece acesso a várias chaves de API para diversos modelos e foi a opção mais econômica para esta demo. Veja como configurar uma API Key para o DeepSeek V3.1:
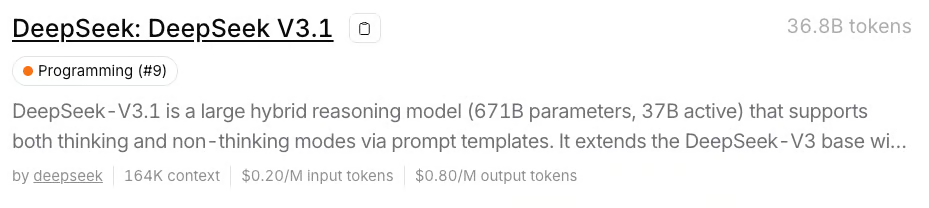
Agora, defina sua chave de API como variável de ambiente antes de rodar o app:
export OPENROUTER_API_KEY=your_api_keyA API oficial da DeepSeek é mais indicada para workloads automatizados e de alto volume.
Para a maioria dos usos de pesquisa, educação ou demonstração — incluindo este assistente de artigos em Streamlit — eu prefiro o OpenRouter por ser uma opção mais simples e flexível. Ele oferece preços globais previsíveis, sem janelas de tempo ou lógica de cache para gerenciar, sendo perfeito para análises pontuais, consultas únicas a documentos e colaboração fácil.
Observação: usar o DeepSeek V3.1 via API exige cerca de 8 GB de memória para a interface, evitando que você precise hospedar localmente o modelo gigantesco de 670B parâmetros, o que exigiria mais de 170 GB de espaço em disco e uma GPU potente.
Para disponibilizar o DeepSeek V3.1 em uma interface amigável, vamos usar o Streamlit como framework do app e conectá-lo ao modelo pela API compatível com OpenAI do OpenRouter.
Aqui, cobrimos o ambiente, autenticação de API e configuração básica do Streamlit.
import streamlit as stimport pypdfimport tempfilefrom openai import OpenAIimport osimport timeimport rest.set_page_config( page_title="DeepSeek V3.1 Research Assistant", layout="wide")with st.sidebar: st.title("Research Paper Assistant") st.info("Tip: Ask about the methods, findings, or reasoning for best results.")OPENROUTER_API_KEY = os.environ.get("OPENROUTER_API_KEY", "")if not OPENROUTER_API_KEY: st.warning("Add your OpenRouter API key to an environment variable.") st.stop()client = OpenAI( base_url="https://openrouter.ai/api/v1", api_key=OPENROUTER_API_KEY,)No código acima, a chamada st.set_page_config() personaliza o título e o layout da página do app Streamlit. O app recupera a chave da API do OpenRouter das variáveis de ambiente e instancia um cliente compatível com OpenAI, apontando para o endpoint do OpenRouter, garantindo que todas as chamadas ao LLM sejam roteadas e autenticadas corretamente para o DeepSeek V3.1.
Antes de construir o fluxo principal, precisamos de utilitários robustos para processamento de documentos e estimativa de recursos. Nesta etapa, definimos funções auxiliares para extrair texto de PDFs enviados, pré-visualizar o conteúdo, contar aproximadamente os tokens e estimar o custo com base nos preços do DeepSeek V3.1 no OpenRouter.
def pdf_to_text(uploaded_file): with tempfile.NamedTemporaryFile(delete=False, suffix=".pdf") as tmp_file: tmp_file.write(uploaded_file.read()) tmp_path = tmp_file.name reader = pypdf.PdfReader(tmp_path) text = "" for page in reader.pages: page_text = page.extract_text() if page_text: text += page_text + "\n" return textdef preview_pdf_text(text, max_chars=600): preview = text[:max_chars] if len(text) > max_chars: preview += "\n...\n[Preview truncated]" return previewdef count_tokens(text): return max(1, int(len(text) / 4))def estimate_cost(tokens, mode="input"): if mode == "input": return tokens / 1_000_000 * 0.20 else: return tokens / 1_000_000 * 0.80Com essas funções auxiliares, nosso backend está pronto para sustentar uma interface de assistente de pesquisa escalável:
pdf_to_text() processa PDFs com múltiplas páginas em texto simples preservando limites de página, deixando os dados prontos para entrada no LLM e para etapas posteriores.count_tokens() fornece uma contagem aproximada de tokens para monitorar o uso da API em relação à grande janela de contexto do DeepSeek. Já a estimate_cost() traduz essa contagem em estimativas de custo em tempo real usando os preços do OpenRouter para entrada e saída, mantendo o usuário informado sobre o orçamento computacional de cada consulta.preview_pdf_text() cria prévias truncadas, permitindo verificar a integridade e relevância do conteúdo extraído antes de incorrer em custos do modelo ou atingir limites da API.Com esses blocos prontos, podemos montar o app completo em Streamlit para Q&A agentivo com longos contextos em artigos científicos.
Com os utilitários centrais prontos, vamos montar a interface principal do Streamlit, reunindo processamento de PDF, estimativa de tokens/custos, Q&A guiado pelo usuário e interação em tempo real com o DeepSeek V3.1 via OpenRouter.
st.header("Research Paper Assistant")pdf_file = st.file_uploader("Upload your research paper (PDF)", type=["pdf"])if "paper_text" not in st.session_state or st.session_state.get("last_uploaded") != pdf_file: if pdf_file is not None: with st.spinner("Extracting text from PDF..."): st.session_state.paper_text = pdf_to_text(pdf_file) st.session_state.last_uploaded = pdf_file st.success(f"PDF uploaded. Total characters extracted: {len(st.session_state.paper_text):,}") with st.expander("Preview of extracted PDF text:"): st.code(preview_pdf_text(st.session_state.paper_text), language='markdown')paper_text = st.session_state.get("paper_text")if paper_text: input_tokens = count_tokens(paper_text) st.caption(f"Estimated input tokens: {input_tokens:,} (Estimated input cost: ${estimate_cost(input_tokens):.3f})") question = st.text_area("Ask a question about this paper:", height=80, placeholder="E.g. What are the main findings?") mode = st.radio( "Select Mode", ["Explain in Brief (Non-Think)", "Explain in Detail (Think)"], horizontal=True, ) go = st.button("Get Answer", use_container_width=True) if question and go: if mode == "Explain in Brief (Non-Think)": prompt = ( f"{paper_text}\n\n" f"Question: {question}\n" "First, answer in a few sentences. Then, quote 1–2 exact sentences from the above paper that best support your answer. " "Show each quote on a new line." ) thinking_flag = False header = "Explain in Brief (Non-Think)" else: prompt = ( f"{paper_text}\n\n" f"Question: {question}\n" "First, answer in detail with reasoning and evidence. Then, quote 2–3 exact sentences from the above paper that most strongly support your answer. " "List the quotes after your answer." ) thinking_flag = True header = "Explain in Detail (Think)" with st.spinner(f"Generating answer..."): start_time = time.perf_counter() try: response = client.chat.completions.create( model="deepseek/deepseek-chat-v3.1", messages=[ {"role": "system", "content": "You are a helpful research assistant."}, {"role": "user", "content": prompt} ], max_tokens=900, extra_body={"thinking": thinking_flag}, ) answer = response.choices[0].message.content.strip() output_tokens = count_tokens(answer) except Exception as e: answer = f"Error: {e}" output_tokens = 0 end_time = time.perf_counter() elapsed_time = end_time - start_time parts = re.split(r"(?:^|\n)(Quotes?:?)", answer, flags=re.IGNORECASE) if len(parts) >= 3: main_answer = parts[0].strip() quotes = parts[2].strip() else: main_answer = answer quotes = None st.markdown(f"### {header}") st.info(f"Time taken: {elapsed_time:.2f} seconds | Output tokens: {output_tokens} (Est. output cost: ${estimate_cost(output_tokens, 'output'):.3f})") st.write(main_answer) if quotes: st.markdown("**Supporting Quotes:**") st.success(quotes)Este app em Streamlit implementa um assistente dinâmico para artigos científicos usando o DeepSeek V3.1, lidando desde a ingestão do documento até o Q&A contextual com LLM. As principais funções cobertas pelo app são:
O usuário envia um arquivo PDF pela interface e então:
st.session_state para ver se o arquivo é novo. Se for, extrai o texto e o armazena em session_state junto com a referência do upload, evitando extrações repetidas a cada interação.Com o documento carregado, o usuário digita uma pergunta e escolhe entre os modos Non-think e Think; a interface adapta as instruções do prompt para cada modo:
Quando o usuário clica em "Get Answer", o app:
thinking na requisição à API do OpenRouter (extra_body={"thinking": thinking_flag}), garantindo que o modelo rode no modo de raciocínio correto, sem depender apenas de temperatura.A resposta retornada é analisada para separar o conteúdo principal e as citações de apoio (se existirem). Em seguida, tanto a resposta quanto as citações extraídas são exibidas na interface, destacando a evidência textual exata do artigo.
Para testar por conta própria, salve o código como app.py e execute:
streamlit run app.pyAprenda IA com estes cursos!
Curso
Curso
Curso
Tutorial
Dimitri Didmanidze
8 min
Tutorial
Abid Ali Awan
12 min
Tutorial
Zoumana Keita
14 min
Tutorial
Arunn Thevapalan
12 min
Tutorial
Tutorial
Abid Ali Awan
10 min