
Cursus
Text-to-Query Agents met MongoDB en LangGraph
2 uur
914
DeepSeek bracht onlangs DeepSeek V3.1 uit, een grootschalig hybride redeneermodel dat zowel “think”- als “non-think”-antwoordsmodi ondersteunt, waardoor het ideaal is voor interactieve documentanalyse.
In deze blog focus ik op de agent-capaciteiten van DeepSeek V3.1 voor het begrijpen van wetenschappelijke papers. Ik leg stap voor stap uit hoe je elke PDF omzet in een interactieve onderzoeksassistent via een Streamlit-app—ik neem je mee langs:
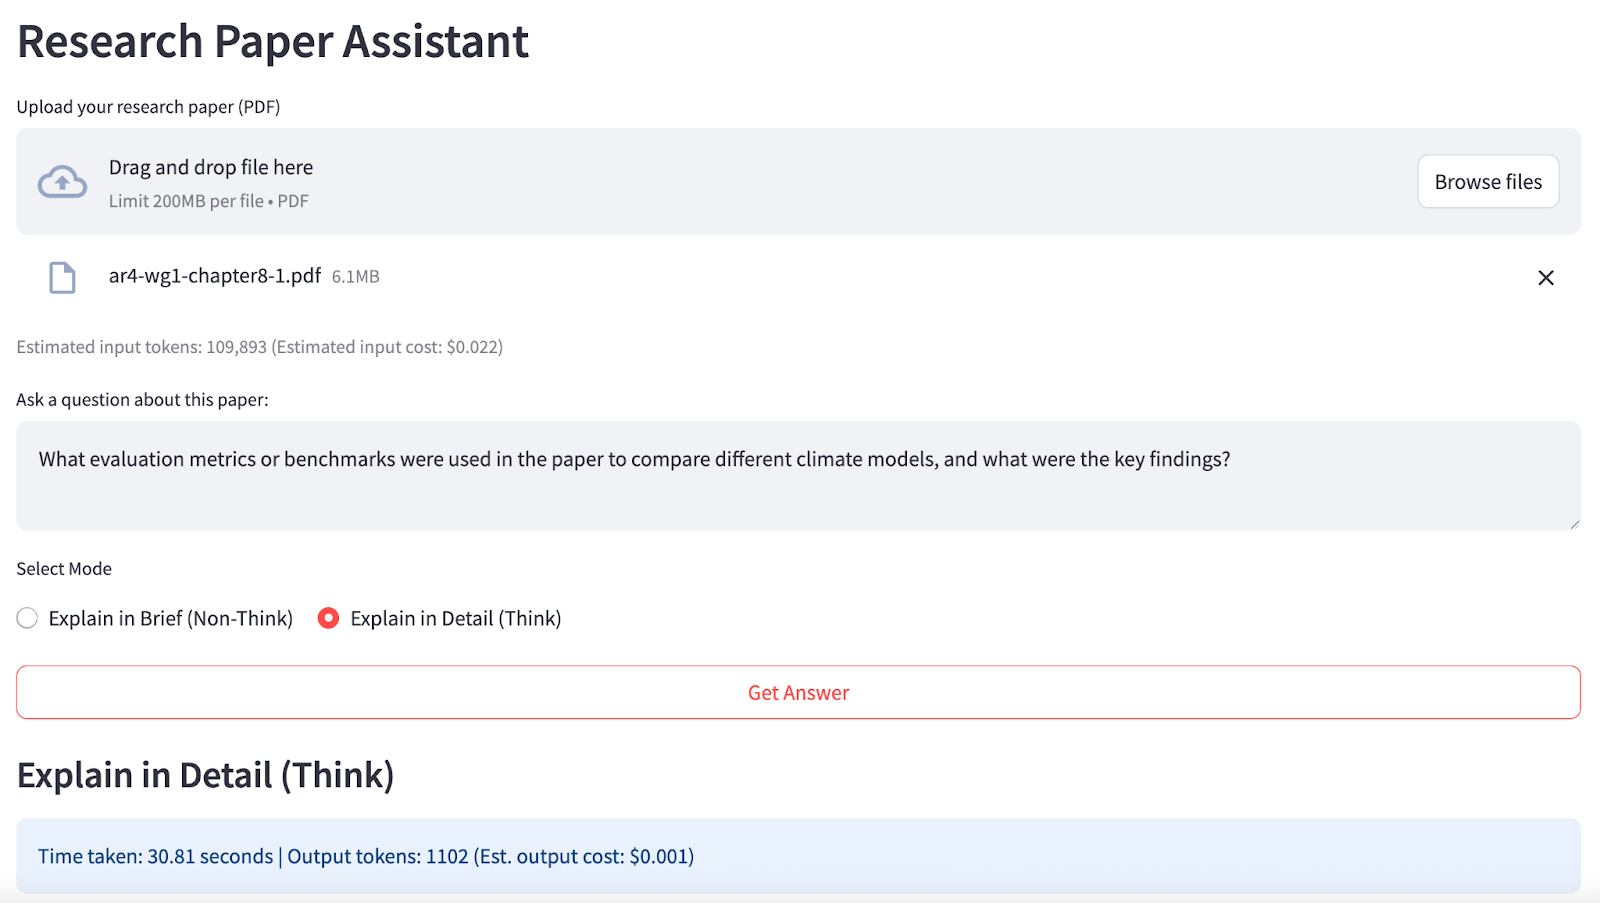
Aan het einde ziet je app er zo uit:
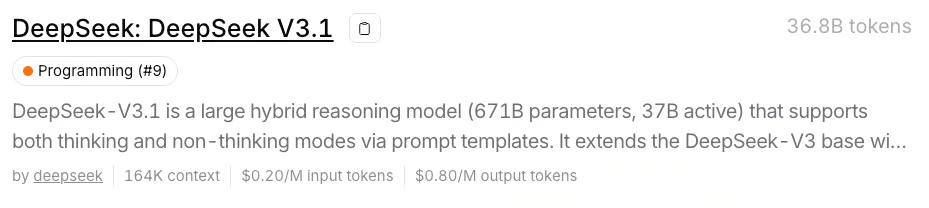
DeepSeek V3.1 is een hybride model met 671 miljard parameters, een Mixture-of-Experts (MoE)-architectuur, getraind voor zowel "thinking" (uitvoerig, beredeneerd) als "non-thinking" (feitelijk, bondig) antwoordstijlen. Het ondersteunt contexten tot 128.000 tokens en is toegankelijk via de OpenAI-compatibele API van OpenRouter.
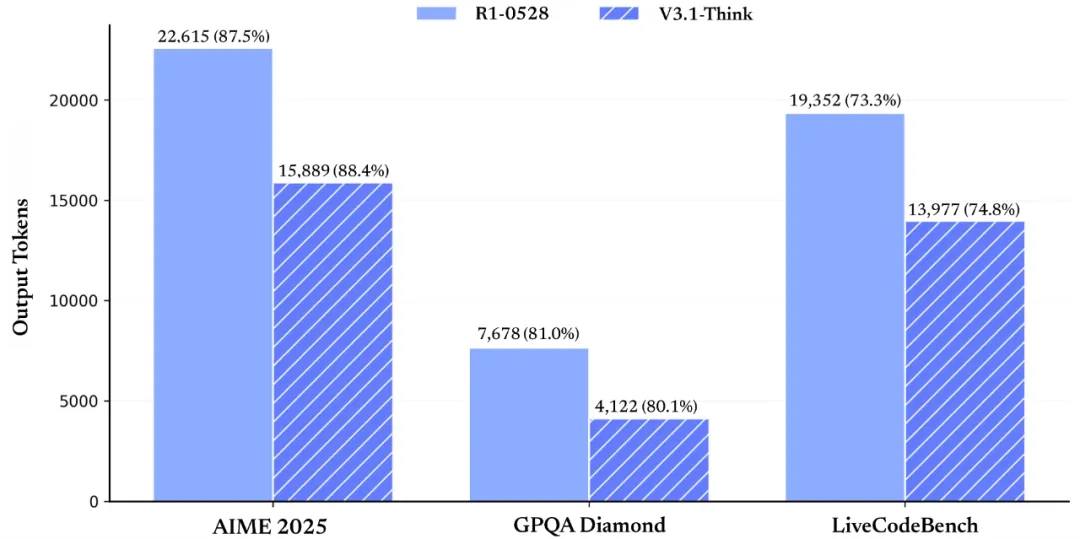
Bron: DeepSeek
De belangrijkste eigenschappen van DeepSeek V3.1 zijn:
In dit onderdeel laat ik zien hoe ik DeepSeek V3.1 heb gebruikt om elke geüploade PDF-paper te veranderen in een interactieve, AI-aangedreven onderzoeksassistent.
Zo werkt het:
Voordat we deze demo draaien, zorgen we dat we alle vereisten op orde hebben.
Zorg er eerst voor dat je de volgende imports geïnstalleerd hebt:
pip install streamlit openai pypdfMet dit commando heb je alle kern-afhankelijkheden voor de UI, PDF-verwerking en API-verzoeken.
Het DeepSeek V3.1-model is beschikbaar via tal van platforms, naast de officiële DeepSeek-API. Ik gebruikte echter OpenRouter in plaats daarvan, dat gebruikers toegang geeft tot meerdere API-sleutels voor tal van modellen en voor deze demo het meest kostenefficiënt was. Zo stel je een API-sleutel in voor DeepSeek V3.1:
Stel nu je API-sleutel in als omgevingsvariabele voordat je de app draait:
export OPENROUTER_API_KEY=your_api_keyDe officiële DeepSeek-API is het meest geschikt voor grootschalige, geautomatiseerde workloads.
Voor de meeste onderzoeks-, educatieve of demo-gebruikssituaties, waaronder deze Streamlit Research Paper Assistant, geef ik de voorkeur aan OpenRouter omdat dit een eenvoudigere en flexibelere keuze is. Het biedt voorspelbare wereldwijde prijzen zonder tijdvensterbeperkingen of cachelogica om te beheren, waardoor het perfect is voor ad-hocanalyse, unieke documentvragen en eenvoudige samenwerking.
Opmerking: DeepSeek V3.1 via de API gebruiken vereist slechts ongeveer 8 GB geheugen voor de UI, waardoor je het massieve model met 670B parameters niet lokaal hoeft te hosten, wat anders 170+ GB schijfruimte en een krachtige GPU zou vereisen.
Om DeepSeek V3.1 via een gebruiksvriendelijke interface beschikbaar te maken, gebruiken we Streamlit als ons app-framework en verbinden we dit via de OpenAI-compatibele API van OpenRouter met het model.
Deze stap omvat de omgevingssetup, API-authenticatie en basisconfiguratie van Streamlit.
import streamlit as stimport pypdfimport tempfilefrom openai import OpenAIimport osimport timeimport rest.set_page_config( page_title="DeepSeek V3.1 Research Assistant", layout="wide")with st.sidebar: st.title("Research Paper Assistant") st.info("Tip: Ask about the methods, findings, or reasoning for best results.")OPENROUTER_API_KEY = os.environ.get("OPENROUTER_API_KEY", "")if not OPENROUTER_API_KEY: st.warning("Add your OpenRouter API key to an environment variable.") st.stop()client = OpenAI( base_url="https://openrouter.ai/api/v1", api_key=OPENROUTER_API_KEY,)In bovenstaande code stelt de aanroep van st.set_page_config() de paginatitel en lay-out van de Streamlit-app in. De app haalt de OpenRouter API-sleutel op uit omgevingsvariabelen en er wordt een OpenAI-compatibele client geïnstantieerd die naar het OpenRouter API-eindpunt wijst, zodat alle volgende LLM-calls correct worden gerouteerd en geauthenticeerd voor DeepSeek V3.1.
Voordat we de hoofdworkflow bouwen, hebben we robuuste hulpfuncties nodig voor documentverwerking en resource-inschatting. In deze stap definiëren we helperfuncties om tekst uit geüploade PDF’s te extraheren, documentinhoud te previewen, het geschatte aantal tokens te tellen en de kosten te schatten op basis van de DeepSeek V3.1-prijzen van OpenRouter.
def pdf_to_text(uploaded_file): with tempfile.NamedTemporaryFile(delete=False, suffix=".pdf") as tmp_file: tmp_file.write(uploaded_file.read()) tmp_path = tmp_file.name reader = pypdf.PdfReader(tmp_path) text = "" for page in reader.pages: page_text = page.extract_text() if page_text: text += page_text + "\n" return textdef preview_pdf_text(text, max_chars=600): preview = text[:max_chars] if len(text) > max_chars: preview += "\n...\n[Preview truncated]" return previewdef count_tokens(text): return max(1, int(len(text) / 4))def estimate_cost(tokens, mode="input"): if mode == "input": return tokens / 1_000_000 * 0.20 else: return tokens / 1_000_000 * 0.80Met deze helperfuncties is onze backend goed voorbereid om een schaalbare interface voor een onderzoeksassistent te ondersteunen:
pdf_to_text() verwerkt PDF’s met meerdere pagina’s tot platte tekst, terwijl paginagrenzen behouden blijven, waardoor de data geschikt is voor LLM-input en verdere verwerking downstream.count_tokens() geeft een geschatte tokentelling om het API-gebruik te monitoren ten opzichte van DeepSeek’s grote contextvenster. De functie estimate_cost() zet deze tokentellingen vervolgens om in realtime kostenfeedback met de OpenRouter-prijzen voor input en output, zodat de gebruiker inzicht houdt in het rekenbudget per query.preview_pdf_text() maakt ingekorte previews, zodat gebruikers de integriteit en relevantie van de geëxtraheerde content kunnen controleren voordat er modelkosten worden gemaakt of API-limieten worden geraakt.Met deze bouwstenen kunnen we nu de complete Streamlit-app samenstellen voor long-context, agent-gestuurde Q&A over papers.
Met de kernhulpmiddelen op hun plaats kunnen we nu de belangrijkste Streamlit-interface samenstellen die PDF-verwerking, token-/kosteninschatting, gebruikersgestuurde Q&A en live interactie met DeepSeek V3.1 via OpenRouter samenbrengt.
st.header("Research Paper Assistant")pdf_file = st.file_uploader("Upload your research paper (PDF)", type=["pdf"])if "paper_text" not in st.session_state or st.session_state.get("last_uploaded") != pdf_file: if pdf_file is not None: with st.spinner("Extracting text from PDF..."): st.session_state.paper_text = pdf_to_text(pdf_file) st.session_state.last_uploaded = pdf_file st.success(f"PDF uploaded. Total characters extracted: {len(st.session_state.paper_text):,}") with st.expander("Preview of extracted PDF text:"): st.code(preview_pdf_text(st.session_state.paper_text), language='markdown')paper_text = st.session_state.get("paper_text")if paper_text: input_tokens = count_tokens(paper_text) st.caption(f"Estimated input tokens: {input_tokens:,} (Estimated input cost: ${estimate_cost(input_tokens):.3f})") question = st.text_area("Ask a question about this paper:", height=80, placeholder="E.g. What are the main findings?") mode = st.radio( "Select Mode", ["Explain in Brief (Non-Think)", "Explain in Detail (Think)"], horizontal=True, ) go = st.button("Get Answer", use_container_width=True) if question and go: if mode == "Explain in Brief (Non-Think)": prompt = ( f"{paper_text}\n\n" f"Question: {question}\n" "First, answer in a few sentences. Then, quote 1–2 exact sentences from the above paper that best support your answer. " "Show each quote on a new line." ) thinking_flag = False header = "Explain in Brief (Non-Think)" else: prompt = ( f"{paper_text}\n\n" f"Question: {question}\n" "First, answer in detail with reasoning and evidence. Then, quote 2–3 exact sentences from the above paper that most strongly support your answer. " "List the quotes after your answer." ) thinking_flag = True header = "Explain in Detail (Think)" with st.spinner(f"Generating answer..."): start_time = time.perf_counter() try: response = client.chat.completions.create( model="deepseek/deepseek-chat-v3.1", messages=[ {"role": "system", "content": "You are a helpful research assistant."}, {"role": "user", "content": prompt} ], max_tokens=900, extra_body={"thinking": thinking_flag}, ) answer = response.choices[0].message.content.strip() output_tokens = count_tokens(answer) except Exception as e: answer = f"Error: {e}" output_tokens = 0 end_time = time.perf_counter() elapsed_time = end_time - start_time parts = re.split(r"(?:^|\n)(Quotes?:?)", answer, flags=re.IGNORECASE) if len(parts) >= 3: main_answer = parts[0].strip() quotes = parts[2].strip() else: main_answer = answer quotes = None st.markdown(f"### {header}") st.info(f"Time taken: {elapsed_time:.2f} seconds | Output tokens: {output_tokens} (Est. output cost: ${estimate_cost(output_tokens, 'output'):.3f})") st.write(main_answer) if quotes: st.markdown("**Supporting Quotes:**") st.success(quotes)Deze Streamlit-toepassing implementeert een dynamische onderzoeksassistent voor papers met DeepSeek V3.1, van documentinname tot contextbewuste LLM Q&A. Dit zijn de kerntaken die de Streamlit-app afhandelt:
De gebruiker uploadt via de interface een PDF-bestand, daarna:
st.session_state om te zien of het bestand nieuw is. Zo ja, dan wordt de tekst geëxtraheerd en in session_state gecachet samen met de uploadreferentie, zodat tekstextractie niet telkens opnieuw hoeft.Zodra een document geladen is, kan de gebruiker een vraag typen en kiezen tussen Non-think en Think-modus, waarbij de UI de promptinstructies aanpast aan elke modus:
Wanneer de gebruiker op "Get Answer" klikt, dan doet de app het volgende:
thinking in bij het OpenRouter API-verzoek (extra_body={"thinking": thinking_flag}), zodat het model in de juiste redeneermodus draait, in plaats van te vertrouwen op temperature.Het teruggestuurde antwoord wordt geparsed zodat het hoofdantwoord en de ondersteunende citaten gescheiden worden (indien gevonden). Vervolgens worden zowel het antwoord als de geëxtraheerde citaten in de UI weergegeven, waarbij de exacte tekstuele onderbouwing uit de bronpaper wordt uitgelicht.
Om het zelf te proberen, sla de code op als app.py en start:
streamlit run app.pyLeer AI met deze cursussen!
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min

