
Corso
Agent text-to-query con MongoDB e LangGraph
2 ore
921
DeepSeek ha rilasciato di recente DeepSeek V3.1, un modello ibrido di reasoning su larga scala che supporta le modalità di risposta “think” e “non-think”, ideale per l’analisi interattiva dei documenti.
In questo blog mi concentrerò sulle capacità agentiche di DeepSeek V3.1 per comprendere gli articoli di ricerca. Ti spiegherò passo dopo passo come trasformare qualsiasi PDF in un assistente di ricerca interattivo tramite un’app Streamlit—ti guiderò attraverso:
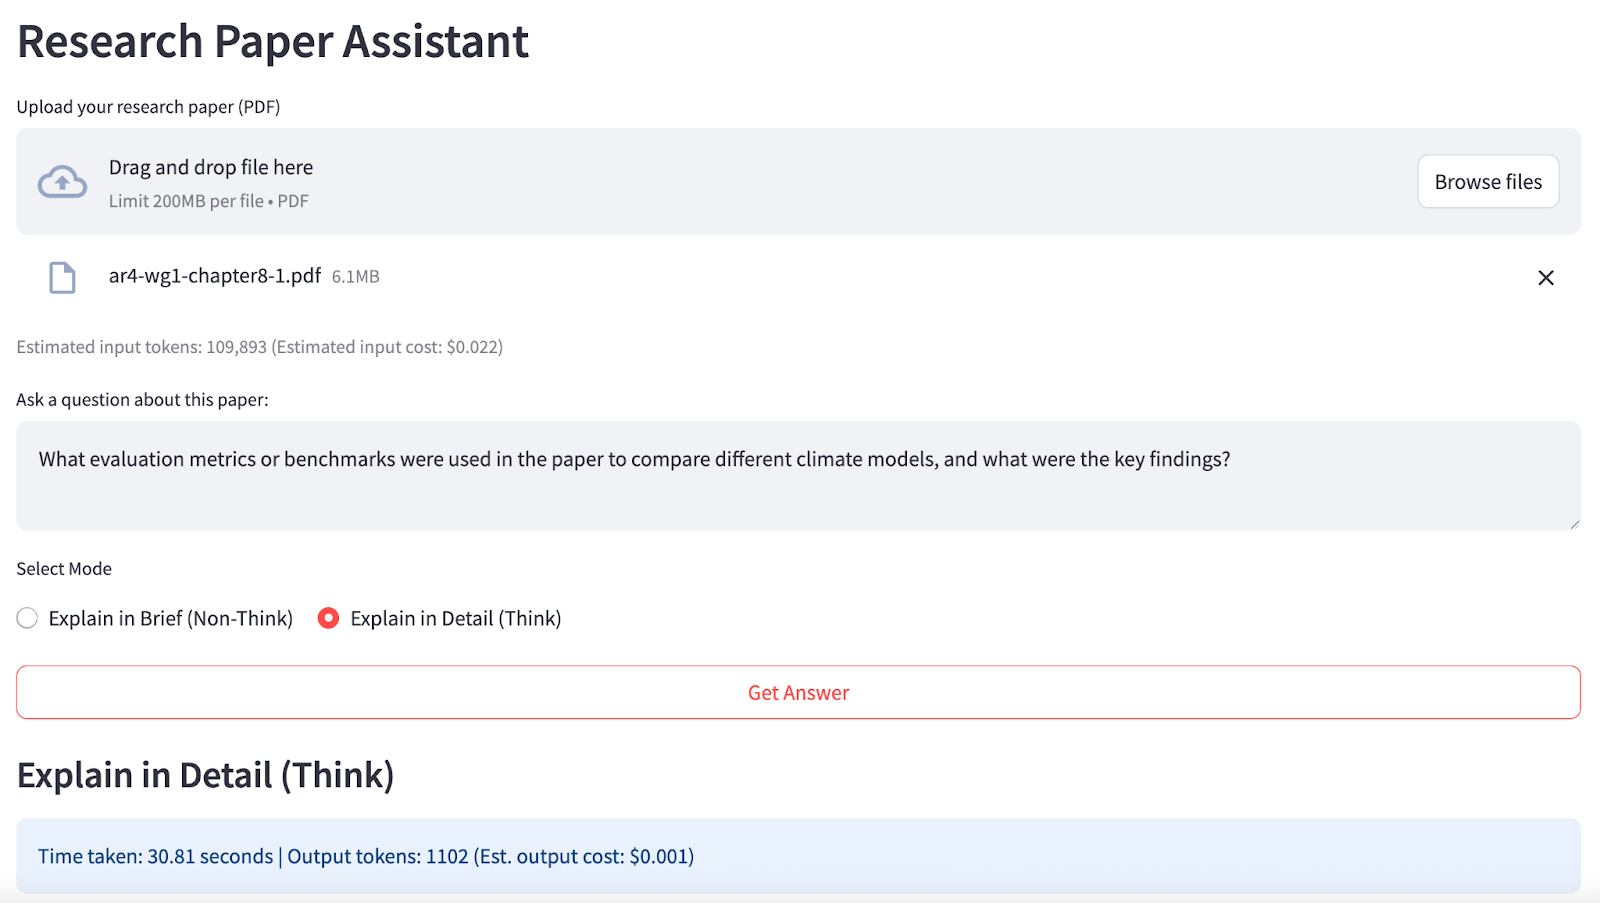
Alla fine, la tua app sarà così:
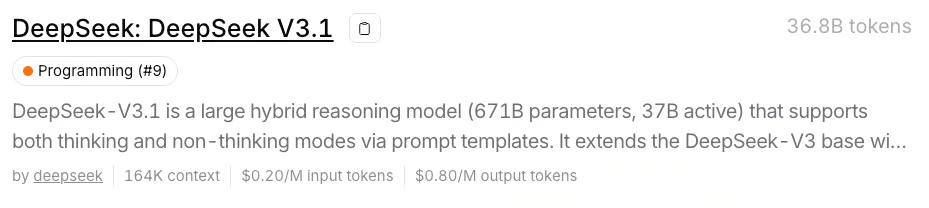
DeepSeek V3.1 è un modello ibrido da 671 miliardi di parametri Mixture-of-Experts (MoE) addestrato sia per risposte “thinking” (dettagliate, ragionate) sia “non-thinking” (fattuali, concise). Supporta contesti fino a 128.000 token ed è accessibile tramite l’API compatibile con OpenAI di OpenRouter.
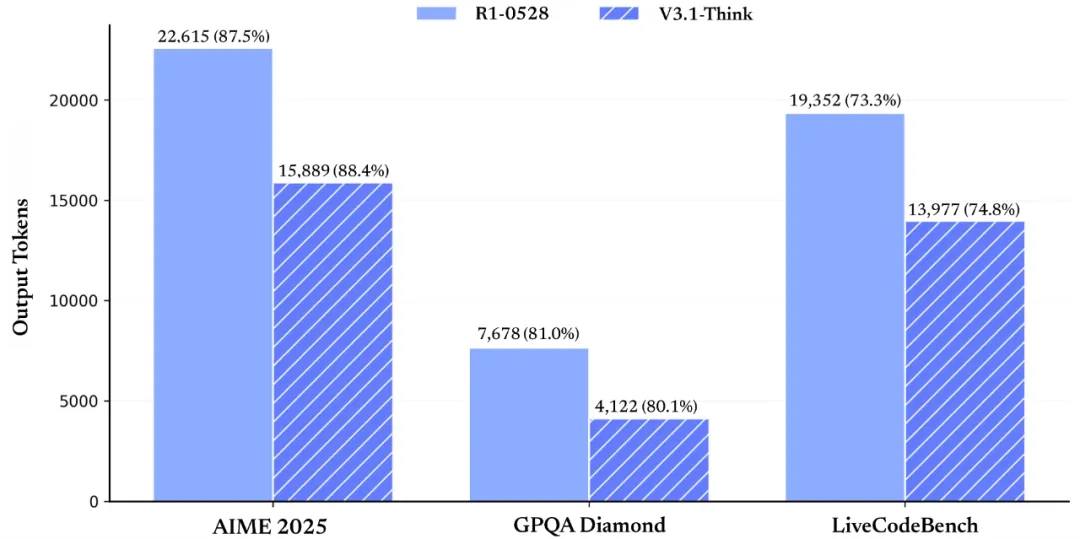
Fonte: DeepSeek
Le caratteristiche più importanti di DeepSeek V3.1 sono:
In questa sezione ti mostro come ho usato DeepSeek V3.1 per trasformare qualsiasi articolo di ricerca PDF caricato in un assistente di ricerca interattivo con AI.
Ecco come funziona:
Prima di eseguire questa demo, assicuriamoci di avere tutti i prerequisiti.
Per prima cosa, assicurati di avere installati i seguenti import:
pip install streamlit openai pypdfQuesto comando garantisce di avere tutte le dipendenze principali per UI, gestione dei PDF e richieste API.
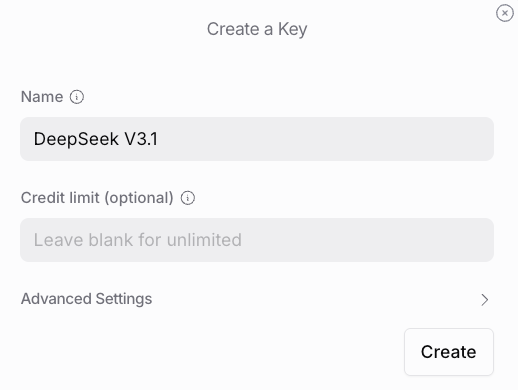
Il modello DeepSeek V3.1 è disponibile su numerose piattaforme, oltre che tramite la DeepSeek Official API. Tuttavia, ho usato OpenRouter, che offre accesso a più chiavi API per numerosi modelli ed è risultato il più conveniente per lo scopo di questa demo. Ecco i passaggi per impostare una chiave API per DeepSeek V3.1:
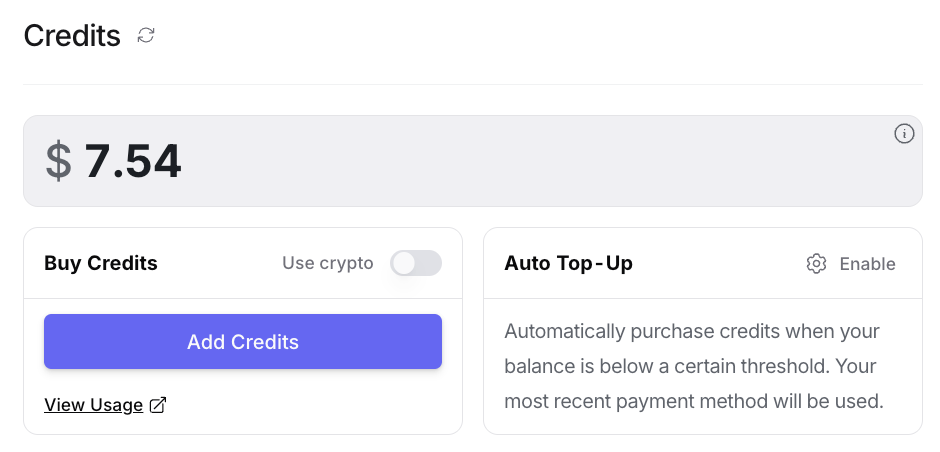
Ora imposta la tua chiave API come variabile d’ambiente prima di avviare l’app:
export OPENROUTER_API_KEY=your_api_keyLa DeepSeek API ufficiale è più adatta a carichi di lavoro automatizzati e ad alto volume.
Per la maggior parte dei casi d’uso di ricerca, didattici o demo, incluso questo Research Paper Assistant in Streamlit, preferisco OpenRouter perché è una scelta più semplice e flessibile. Offre prezzi globali prevedibili senza restrizioni di finestra temporale o logiche di cache da gestire, rendendolo perfetto per analisi ad hoc, query su documenti unici e collaborazione semplice.
Nota: Usare DeepSeek V3.1 tramite API richiede solo circa 8 GB di memoria per la UI, evitandoti l’hosting locale del mastodontico modello da 670 miliardi di parametri, che altrimenti richiederebbe oltre 170 GB di spazio su disco e una GPU potente.
Per rendere DeepSeek V3.1 disponibile tramite un’interfaccia intuitiva, useremo Streamlit come framework dell’app e lo collegheremo al modello tramite l’API compatibile con OpenAI di OpenRouter.
Questo passaggio copre la configurazione dell’ambiente, l’autenticazione all’API e la configurazione di base di Streamlit.
import streamlit as stimport pypdfimport tempfilefrom openai import OpenAIimport osimport timeimport rest.set_page_config( page_title="DeepSeek V3.1 Research Assistant", layout="wide")with st.sidebar: st.title("Research Paper Assistant") st.info("Tip: Ask about the methods, findings, or reasoning for best results.")OPENROUTER_API_KEY = os.environ.get("OPENROUTER_API_KEY", "")if not OPENROUTER_API_KEY: st.warning("Add your OpenRouter API key to an environment variable.") st.stop()client = OpenAI( base_url="https://openrouter.ai/api/v1", api_key=OPENROUTER_API_KEY,)Nel codice sopra, la chiamata alla funzione st.set_page_config() personalizza il titolo e il layout della pagina dell’app Streamlit. L’app recupera la chiave API di OpenRouter dalle variabili d’ambiente e istanzia un client compatibile con OpenAI, puntando all’endpoint API di OpenRouter, assicurando che tutte le successive chiamate all’LLM siano correttamente instradate e autenticate per DeepSeek V3.1.
Prima di creare il flusso principale, servono utility robuste per la gestione dei documenti e la stima delle risorse. In questo passaggio definiamo funzioni di supporto per estrarre il testo dai PDF caricati, mostrarne l’anteprima, contare il numero approssimativo di token e stimare i costi in base ai prezzi di OpenRouter per DeepSeek V3.1.
def pdf_to_text(uploaded_file): with tempfile.NamedTemporaryFile(delete=False, suffix=".pdf") as tmp_file: tmp_file.write(uploaded_file.read()) tmp_path = tmp_file.name reader = pypdf.PdfReader(tmp_path) text = "" for page in reader.pages: page_text = page.extract_text() if page_text: text += page_text + "\n" return textdef preview_pdf_text(text, max_chars=600): preview = text[:max_chars] if len(text) > max_chars: preview += "\n...\n[Preview truncated]" return previewdef count_tokens(text): return max(1, int(len(text) / 4))def estimate_cost(tokens, mode="input"): if mode == "input": return tokens / 1_000_000 * 0.20 else: return tokens / 1_000_000 * 0.80Con queste funzioni di supporto implementate, il backend è ben preparato a sostenere un’interfaccia di assistente alla ricerca scalabile:
pdf_to_text() elabora PDF multipagina in testo semplice preservando i confini di pagina, rendendo i dati adatti all’input dell’LLM e a successive elaborazioni.count_tokens() fornisce un conteggio approssimativo dei token per monitorare l’uso dell’API rispetto all’ampia finestra di contesto di DeepSeek. La funzione estimate_cost() traduce poi questi conteggi in un feedback sui costi in tempo reale usando i prezzi di OpenRouter per input e output, mantenendo l’utente informato sul budget computazionale per ogni query.preview_pdf_text() crea anteprime troncate, consentendo di verificare l’integrità e la pertinenza del contenuto estratto prima di sostenere costi o raggiungere limiti API.Con questi mattoni al loro posto, possiamo ora passare ad assemblare l’app Streamlit completa per Q&A su articoli di ricerca con contesto lungo e capacità agentiche.
Con le utility principali pronte, possiamo assemblare l’interfaccia utente Streamlit che unisce elaborazione dei PDF, stima di token/costi, Q&A guidato dall’utente e interazione live con DeepSeek V3.1 tramite OpenRouter.
st.header("Research Paper Assistant")pdf_file = st.file_uploader("Upload your research paper (PDF)", type=["pdf"])if "paper_text" not in st.session_state or st.session_state.get("last_uploaded") != pdf_file: if pdf_file is not None: with st.spinner("Extracting text from PDF..."): st.session_state.paper_text = pdf_to_text(pdf_file) st.session_state.last_uploaded = pdf_file st.success(f"PDF uploaded. Total characters extracted: {len(st.session_state.paper_text):,}") with st.expander("Preview of extracted PDF text:"): st.code(preview_pdf_text(st.session_state.paper_text), language='markdown')paper_text = st.session_state.get("paper_text")if paper_text: input_tokens = count_tokens(paper_text) st.caption(f"Estimated input tokens: {input_tokens:,} (Estimated input cost: ${estimate_cost(input_tokens):.3f})") question = st.text_area("Ask a question about this paper:", height=80, placeholder="E.g. What are the main findings?") mode = st.radio( "Select Mode", ["Explain in Brief (Non-Think)", "Explain in Detail (Think)"], horizontal=True, ) go = st.button("Get Answer", use_container_width=True) if question and go: if mode == "Explain in Brief (Non-Think)": prompt = ( f"{paper_text}\n\n" f"Question: {question}\n" "First, answer in a few sentences. Then, quote 1–2 exact sentences from the above paper that best support your answer. " "Show each quote on a new line." ) thinking_flag = False header = "Explain in Brief (Non-Think)" else: prompt = ( f"{paper_text}\n\n" f"Question: {question}\n" "First, answer in detail with reasoning and evidence. Then, quote 2–3 exact sentences from the above paper that most strongly support your answer. " "List the quotes after your answer." ) thinking_flag = True header = "Explain in Detail (Think)" with st.spinner(f"Generating answer..."): start_time = time.perf_counter() try: response = client.chat.completions.create( model="deepseek/deepseek-chat-v3.1", messages=[ {"role": "system", "content": "You are a helpful research assistant."}, {"role": "user", "content": prompt} ], max_tokens=900, extra_body={"thinking": thinking_flag}, ) answer = response.choices[0].message.content.strip() output_tokens = count_tokens(answer) except Exception as e: answer = f"Error: {e}" output_tokens = 0 end_time = time.perf_counter() elapsed_time = end_time - start_time parts = re.split(r"(?:^|\n)(Quotes?:?)", answer, flags=re.IGNORECASE) if len(parts) >= 3: main_answer = parts[0].strip() quotes = parts[2].strip() else: main_answer = answer quotes = None st.markdown(f"### {header}") st.info(f"Time taken: {elapsed_time:.2f} seconds | Output tokens: {output_tokens} (Est. output cost: ${estimate_cost(output_tokens, 'output'):.3f})") st.write(main_answer) if quotes: st.markdown("**Supporting Quotes:**") st.success(quotes)Questa applicazione Streamlit implementa un assistente dinamico per articoli di ricerca usando DeepSeek V3.1, gestendo tutto dall’ingestione del documento al Q&A con LLM sensibile al contesto. Ecco le funzioni chiave gestite dall’app Streamlit:
L’utente carica un file PDF tramite l’interfaccia, quindi:
st.session_state per capire se il file è nuovo. In tal caso, estrae il testo e lo memorizza in cache in session_state insieme al riferimento al caricamento, evitando estrazioni ripetute a ogni interazione.Una volta caricato il documento, l’utente può digitare una domanda e selezionare tra modalità Non-think e Think; la UI adatta le istruzioni del prompt per ciascuna modalità:
Quando l’utente clicca su "Get Answer", l’app:
thinking nella richiesta API di OpenRouter (extra_body={"thinking": thinking_flag}), assicurando che il modello operi nella modalità di reasoning corretta, invece di affidarsi alla temperatura.La risposta restituita viene analizzata in modo da separare la parte principale e le citazioni di supporto (se presenti). Quindi, sia la risposta sia le citazioni estratte sono renderizzate nella UI, evidenziando le prove testuali precise tratte dall’articolo.
Per provarlo, salva il codice come app.py e avvia:
streamlit run app.pyImpara l'AI con questi corsi!
Corso
Corso
Corso
blog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min
blog
Tim Lu
12 min



