Last chance! 50% off DataCamp Premium
Sale ends in
DeepSeek ने हाल ही में DeepSeek V3.1 जारी किया है—एक बड़े पैमाने का हाइब्रिड रीजनिंग मॉडल जो “थिंक” और “नॉन-थिंक” दोनों उत्तर मोड का समर्थन करता है, जिससे यह इंटरएक्टिव डॉक्युमेंट एनालिसिस के लिए उपयुक्त बनता है।
इस ब्लॉग में, मैं रिसर्च पेपर्स को समझने के लिए DeepSeek V3.1 की एजेंटिक क्षमताओं पर ध्यान केंद्रित करूंगा। मैं चरण दर चरण समझाऊंगा कि किसी भी PDF को Streamlit ऐप के माध्यम से एक इंटरएक्टिव रिसर्च असिस्टेंट में कैसे बदला जाए—मैं आपको इन बातों से गुजराऊंगा:
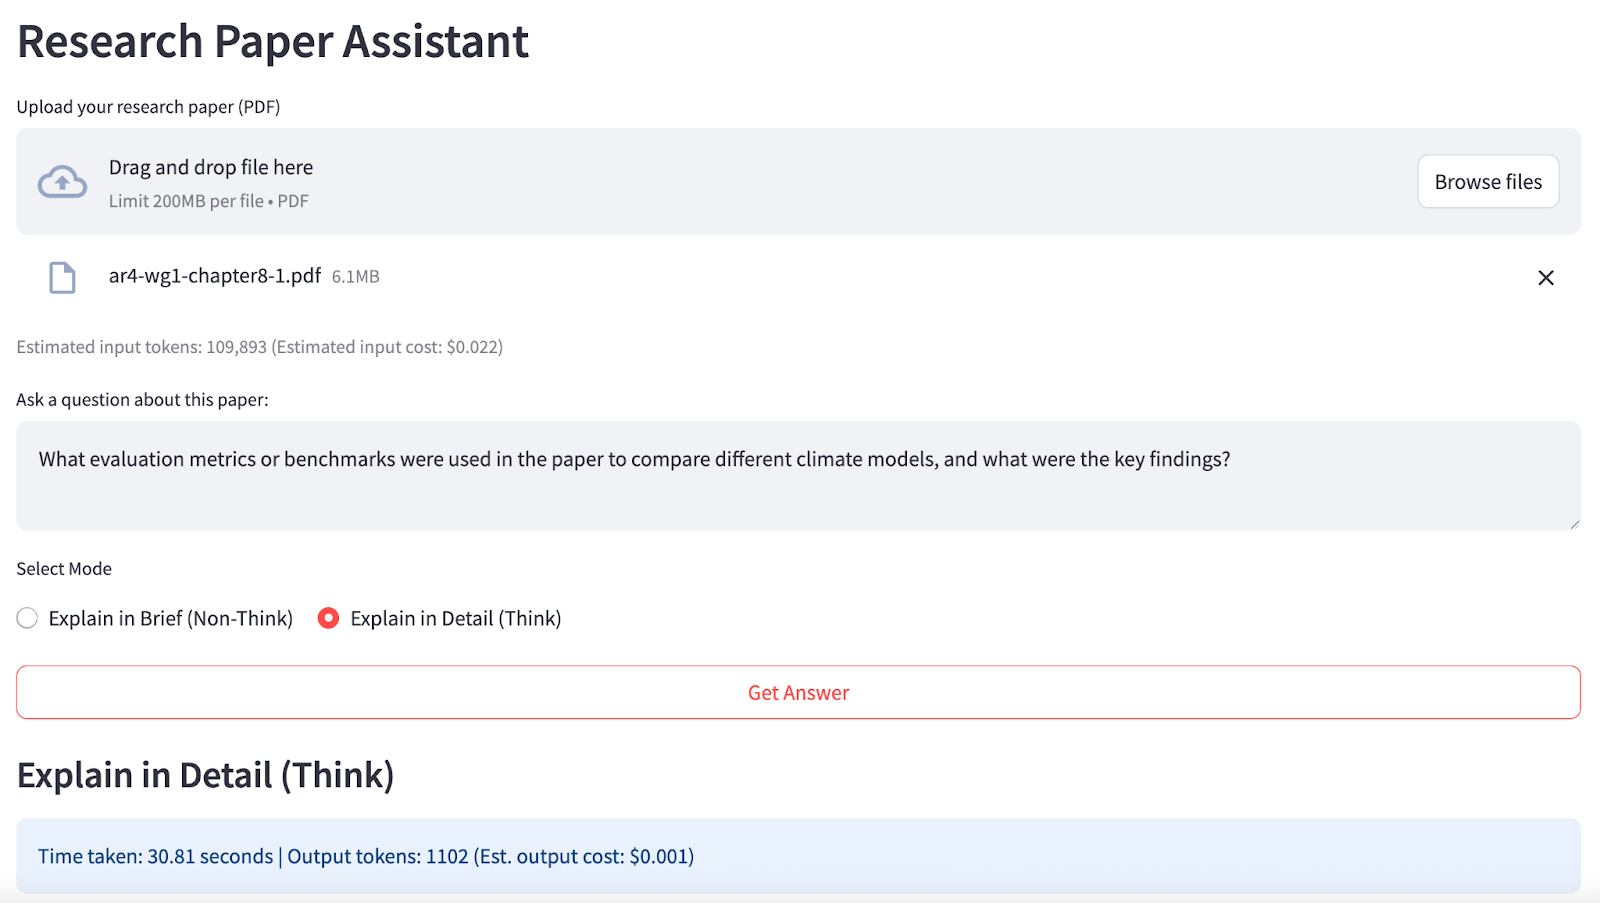
अंत में, आपका ऐप कुछ ऐसा दिखेगा:
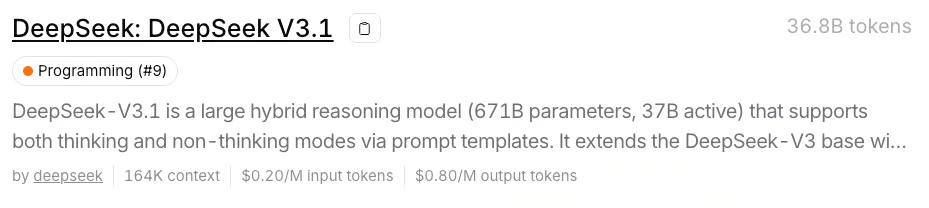
DeepSeek V3.1 एक 671B-पैरामीटर, हाइब्रिड Mixture-of-Experts (MoE) मॉडल है, जिसे "थिंकिंग" (विस्तृत, तर्कसंगत) और "नॉन-थिंकिंग" (तथ्यात्मक, संक्षिप्त) उत्तर शैलियों—दोनों—के लिए प्रशिक्षित किया गया है। यह 128,000-टोकन कॉन्टेक्स्ट का समर्थन करता है और OpenRouter के OpenAI-संगत API के माध्यम से सुलभ है।
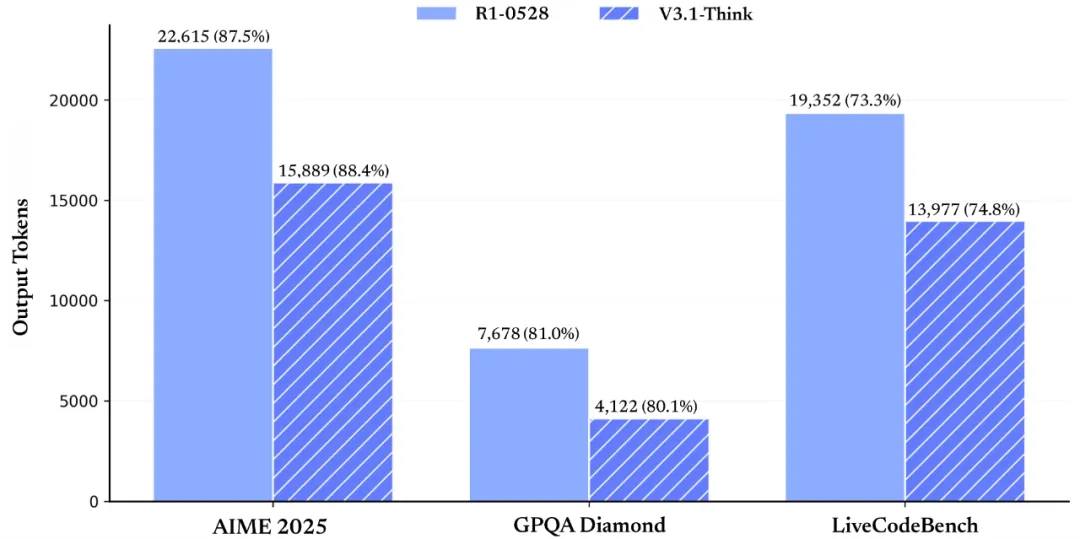
स्रोत: DeepSeek
DeepSeek V3.1 की सबसे अहम विशेषताएं हैं:
इस सेक्शन में, मैं बताऊंगा कि मैंने DeepSeek V3.1 का उपयोग करके अपलोड किए गए किसी भी PDF रिसर्च पेपर को एक इंटरएक्टिव, AI-संचालित रिसर्च असिस्टेंट में कैसे बदला।
यह ऐसे काम करता है:
इस डेमो को चलाने से पहले, सुनिश्चित करें कि हमारे पास सभी पूर्वापेक्षाएँ मौजूद हैं।
सबसे पहले, सुनिश्चित करें कि आपके पास निम्न इम्पोर्ट्स इंस्टॉल हों:
pip install streamlit openai pypdfयह कमांड UI, PDF हैंडलिंग और API रिक्वेस्ट्स के लिए सभी कोर डिपेंडेंसीज़ सुनिश्चित करता है।
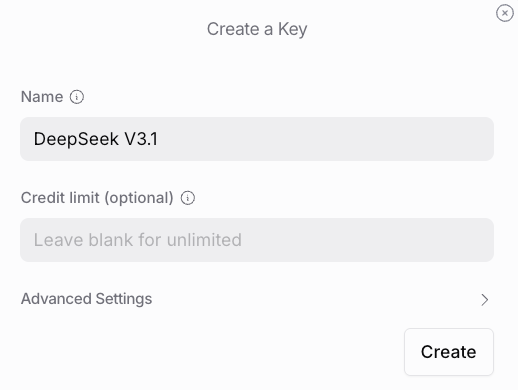
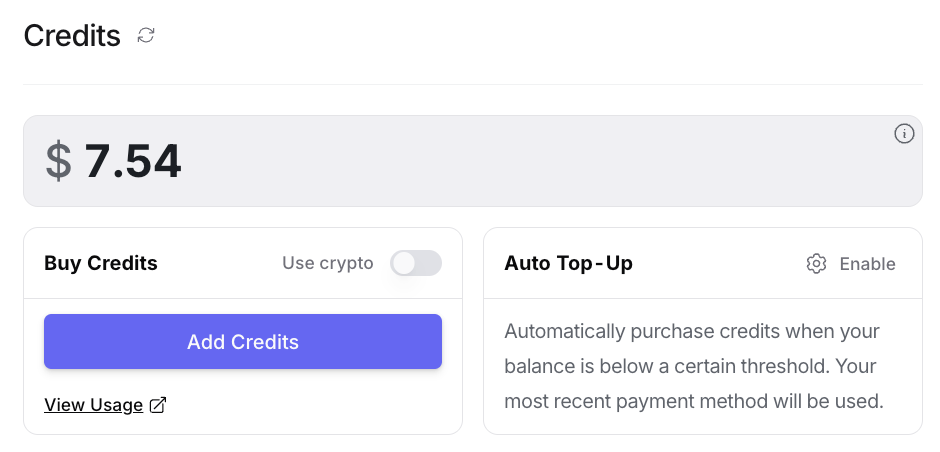
DeepSeek V3.1 मॉडल कई प्लेटफॉर्म्स पर उपलब्ध है, DeepSeek आधिकारिक API सहित। हालांकि, मैंने OpenRouter का उपयोग किया, जो उपयोगकर्ताओं को कई मॉडलों के लिए एकाधिक API कुंजियों तक पहुंच देता है और इस डेमो के उद्देश्य से सबसे किफायती था। DeepSeek V3.1 के लिए API कुंजी सेट करने के चरण इस प्रकार हैं:
अब, ऐप चलाने से पहले अपनी API कुंजी को वातावरण चर के रूप में सेट करें:
export OPENROUTER_API_KEY=your_api_keyआधिकारिक DeepSeek API उच्च-वॉल्यूम, स्वचालित वर्कलोड्स के लिए सबसे उपयुक्त है।
अधिकांश रिसर्च, शिक्षा, या डेमो उपयोग मामलों के लिए—इस Streamlit रिसर्च पेपर असिस्टेंट सहित—मैं OpenRouter को प्राथमिकता दूंगा क्योंकि यह सरल और अधिक लचीला विकल्प है। यह वैश्विक स्तर पर अनुमानित प्राइसिंग प्रदान करता है, किसी समय-विंडो प्रतिबंध या कैश लॉजिक को मैनेज करने की आवश्यकता नहीं—जिससे यह एड-हॉक विश्लेषण, अद्वितीय डॉक्युमेंट क्वेरीज़, और आसान सहयोग के लिए उपयुक्त बनता है।
ध्यान दें: API के माध्यम से DeepSeek V3.1 का उपयोग करने के लिए UI हेतु केवल लगभग 8 GB मेमोरी की आवश्यकता होती है। इससे आपको 670B-पैरामीटर वाले विशाल मॉडल को लोकली होस्ट करने की जरूरत नहीं पड़ती, जिसके लिए अन्यथा 170+ GB डिस्क स्पेस और एक शक्तिशाली GPU चाहिए होता।
DeepSeek V3.1 को उपयोगकर्ता-अनुकूल इंटरफ़ेस के माध्यम से उपलब्ध कराने के लिए, हम Streamlit को ऐप फ्रेमवर्क के रूप में उपयोग करेंगे और इसे OpenRouter के OpenAI-संगत API के जरिए मॉडल से कनेक्ट करेंगे।
यह चरण वातावरण सेटअप, API प्रमाणीकरण, और बेसिक Streamlit कॉन्फ़िगरेशन को कवर करता है।
import streamlit as stimport pypdfimport tempfilefrom openai import OpenAIimport osimport timeimport rest.set_page_config( page_title="DeepSeek V3.1 Research Assistant", layout="wide")with st.sidebar: st.title("Research Paper Assistant") st.info("Tip: Ask about the methods, findings, or reasoning for best results.")OPENROUTER_API_KEY = os.environ.get("OPENROUTER_API_KEY", "")if not OPENROUTER_API_KEY: st.warning("Add your OpenRouter API key to an environment variable.") st.stop()client = OpenAI( base_url="https://openrouter.ai/api/v1", api_key=OPENROUTER_API_KEY,)ऊपर दिए गए कोड में, st.set_page_config() कॉल Streamlit ऐप के पेज टाइटल और लेआउट को कस्टमाइज़ करती है। ऐप वातावरण चरों से OpenRouter API कुंजी प्राप्त करता है और OpenAI-संगत क्लाइंट को इनिशियलाइज़ करता है, जो OpenRouter API एंडपॉइंट की ओर पॉइंट करता है, ताकि DeepSeek V3.1 के लिए सभी आगामी LLM कॉल सही ढंग से रूट और प्रमाणित हों।
मुख्य वर्कफ़्लो बनाने से पहले, हमें डॉक्युमेंट प्रोसेसिंग और संसाधन अनुमान के लिए उपयोगी यूटिलिटी फंक्शन्स चाहिए। इस चरण में, हम हेल्पर फंक्शन्स परिभाषित करते हैं जो अपलोड की गई PDFs से टेक्स्ट निकालें, डॉक्युमेंट कंटेंट का प्रीव्यू दें, अनुमानित टोकन गिनें, और OpenRouter की DeepSeek V3.1 प्राइसिंग के आधार पर लागत का अनुमान लगाएँ।
def pdf_to_text(uploaded_file): with tempfile.NamedTemporaryFile(delete=False, suffix=".pdf") as tmp_file: tmp_file.write(uploaded_file.read()) tmp_path = tmp_file.name reader = pypdf.PdfReader(tmp_path) text = "" for page in reader.pages: page_text = page.extract_text() if page_text: text += page_text + "\n" return textdef preview_pdf_text(text, max_chars=600): preview = text[:max_chars] if len(text) > max_chars: preview += "\n...\n[Preview truncated]" return previewdef count_tokens(text): return max(1, int(len(text) / 4))def estimate_cost(tokens, mode="input"): if mode == "input": return tokens / 1_000_000 * 0.20 else: return tokens / 1_000_000 * 0.80इन हेल्पर फंक्शन्स के साथ, हमारा बैकएंड एक स्केलेबल रिसर्च असिस्टेंट इंटरफ़ेस को सपोर्ट करने के लिए अच्छी तरह तैयार है:
pdf_to_text() फंक्शन बहु-पृष्ठ PDFs को सादा टेक्स्ट में प्रोसेस करता है, पेज सीमाओं को बनाए रखते हुए—जिससे डेटा LLM इनपुट और आगे की प्रोसेसिंग के लिए उपयुक्त बनता है।count_tokens() फंक्शन DeepSeek की उच्च कॉन्टेक्स्ट विंडो के सापेक्ष API उपयोग की निगरानी में मदद के लिए अनुमानित टोकन काउंट देता है। जबकि estimate_cost() फंक्शन इन्हीं टोकन काउंट्स को OpenRouter की इनपुट और आउटपुट प्राइसिंग का उपयोग कर वास्तविक-समय लागत फीडबैक में बदलता है, ताकि उपयोगकर्ता प्रत्येक क्वेरी के कम्प्यूटेशनल बजट से अवगत रहें।preview_pdf_text() फंक्शन ट्रंकेटेड प्रीव्यू बनाता है, जिससे उपयोगकर्ता मॉडल लागत वहन करने या API लिमिट तक पहुँचने से पहले निकाले गए कंटेंट की शुद्धता और प्रासंगिकता सत्यापित कर सकें।इन बिल्डिंग ब्लॉक्स के साथ, अब हम लंबे कॉन्टेक्स्ट, एजेंटिक रिसर्च पेपर Q&A के लिए संपूर्ण Streamlit ऐप असेंबल कर सकते हैं।
कोर यूटिलिटीज़ के साथ, अब हम मुख्य Streamlit यूज़र इंटरफ़ेस को असेंबल कर सकते हैं, जो PDF प्रोसेसिंग, टोकन/लागत अनुमान, उपयोगकर्ता-प्रेरित Q&A, और OpenRouter के जरिए DeepSeek V3.1 के साथ लाइव इंटरेक्शन—सबको एक साथ लाता है।
st.header("Research Paper Assistant")pdf_file = st.file_uploader("Upload your research paper (PDF)", type=["pdf"])if "paper_text" not in st.session_state or st.session_state.get("last_uploaded") != pdf_file: if pdf_file is not None: with st.spinner("Extracting text from PDF..."): st.session_state.paper_text = pdf_to_text(pdf_file) st.session_state.last_uploaded = pdf_file st.success(f"PDF uploaded. Total characters extracted: {len(st.session_state.paper_text):,}") with st.expander("Preview of extracted PDF text:"): st.code(preview_pdf_text(st.session_state.paper_text), language='markdown')paper_text = st.session_state.get("paper_text")if paper_text: input_tokens = count_tokens(paper_text) st.caption(f"Estimated input tokens: {input_tokens:,} (Estimated input cost: ${estimate_cost(input_tokens):.3f})") question = st.text_area("Ask a question about this paper:", height=80, placeholder="E.g. What are the main findings?") mode = st.radio( "Select Mode", ["Explain in Brief (Non-Think)", "Explain in Detail (Think)"], horizontal=True, ) go = st.button("Get Answer", use_container_width=True) if question and go: if mode == "Explain in Brief (Non-Think)": prompt = ( f"{paper_text}\n\n" f"Question: {question}\n" "First, answer in a few sentences. Then, quote 1–2 exact sentences from the above paper that best support your answer. " "Show each quote on a new line." ) thinking_flag = False header = "Explain in Brief (Non-Think)" else: prompt = ( f"{paper_text}\n\n" f"Question: {question}\n" "First, answer in detail with reasoning and evidence. Then, quote 2–3 exact sentences from the above paper that most strongly support your answer. " "List the quotes after your answer." ) thinking_flag = True header = "Explain in Detail (Think)" with st.spinner(f"Generating answer..."): start_time = time.perf_counter() try: response = client.chat.completions.create( model="deepseek/deepseek-chat-v3.1", messages=[ {"role": "system", "content": "You are a helpful research assistant."}, {"role": "user", "content": prompt} ], max_tokens=900, extra_body={"thinking": thinking_flag}, ) answer = response.choices[0].message.content.strip() output_tokens = count_tokens(answer) except Exception as e: answer = f"Error: {e}" output_tokens = 0 end_time = time.perf_counter() elapsed_time = end_time - start_time parts = re.split(r"(?:^|\n)(Quotes?:?)", answer, flags=re.IGNORECASE) if len(parts) >= 3: main_answer = parts[0].strip() quotes = parts[2].strip() else: main_answer = answer quotes = None st.markdown(f"### {header}") st.info(f"Time taken: {elapsed_time:.2f} seconds | Output tokens: {output_tokens} (Est. output cost: ${estimate_cost(output_tokens, 'output'):.3f})") st.write(main_answer) if quotes: st.markdown("**Supporting Quotes:**") st.success(quotes)यह Streamlit एप्लिकेशन DeepSeek V3.1 का उपयोग करके एक डायनेमिक रिसर्च पेपर असिस्टेंट लागू करता है, जो डॉक्युमेंट इनजेशन से लेकर संदर्भ-सचेत LLM Q&A तक सब कुछ संभालता है। यहाँ Streamlit एप्लिकेशन द्वारा हैंडल किए गए प्रमुख फंक्शन्स हैं:
उपयोगकर्ता इंटरफ़ेस के माध्यम से एक PDF फ़ाइल अपलोड करता है, फिर:
st.session_state जाँचता है कि फ़ाइल नई है या नहीं। यदि हाँ, तो यह टेक्स्ट निकालता है और उसे अपलोड रेफरेंस के साथ session_state में कैश करता है, ताकि हर इंटरैक्शन पर बार-बार एक्सट्रैक्शन से बचा जा सके।डॉक्युमेंट लोड होने के बाद, उपयोगकर्ता प्रश्न टाइप कर सकता है और नॉन-थिंक तथा थिंक मोड में से चुन सकता है, जहाँ UI प्रत्येक मोड के लिए प्रॉम्प्ट निर्देशों को अनुकूलित करता है:
जब उपयोगकर्ता "Get Answer" पर क्लिक करता/करती है, तब ऐप:
thinking पैरामीटर को OpenRouter API रिक्वेस्ट में सेट करता है (extra_body={"thinking": thinking_flag}), ताकि मॉडल सही रीजनिंग मोड में चले, न कि केवल तापमान पर निर्भर रहे।वापस आए उत्तर को इस तरह पार्स किया जाता है कि मुख्य प्रतिक्रिया और सपोर्टिंग उद्धरण अलग हो जाएँ (यदि मिलें)। फिर, UI में उत्तर और निकाले गए उद्धरण—दोनों—रेंडर किए जाते हैं, जिससे स्रोत पेपर से सटीक पाठ्य साक्ष्य पर प्रकाश डाला जा सके।
खुद आज़माने के लिए, कोड को app.py के रूप में सेव करें और लॉन्च करें:
streamlit run app.pyइन पाठ्यक्रमों के साथ AI सीखें!
कोर्स
कोर्स
कोर्स