
Cours
Agents de text-to-query avec MongoDB et LangGraph
2 h
902
DeepSeek a récemment publié DeepSeek V3.1, un modèle hybride de raisonnement à grande échelle qui prend en charge les modes de réponse « think » et « non-think », idéal pour l'analyse interactive de documents.
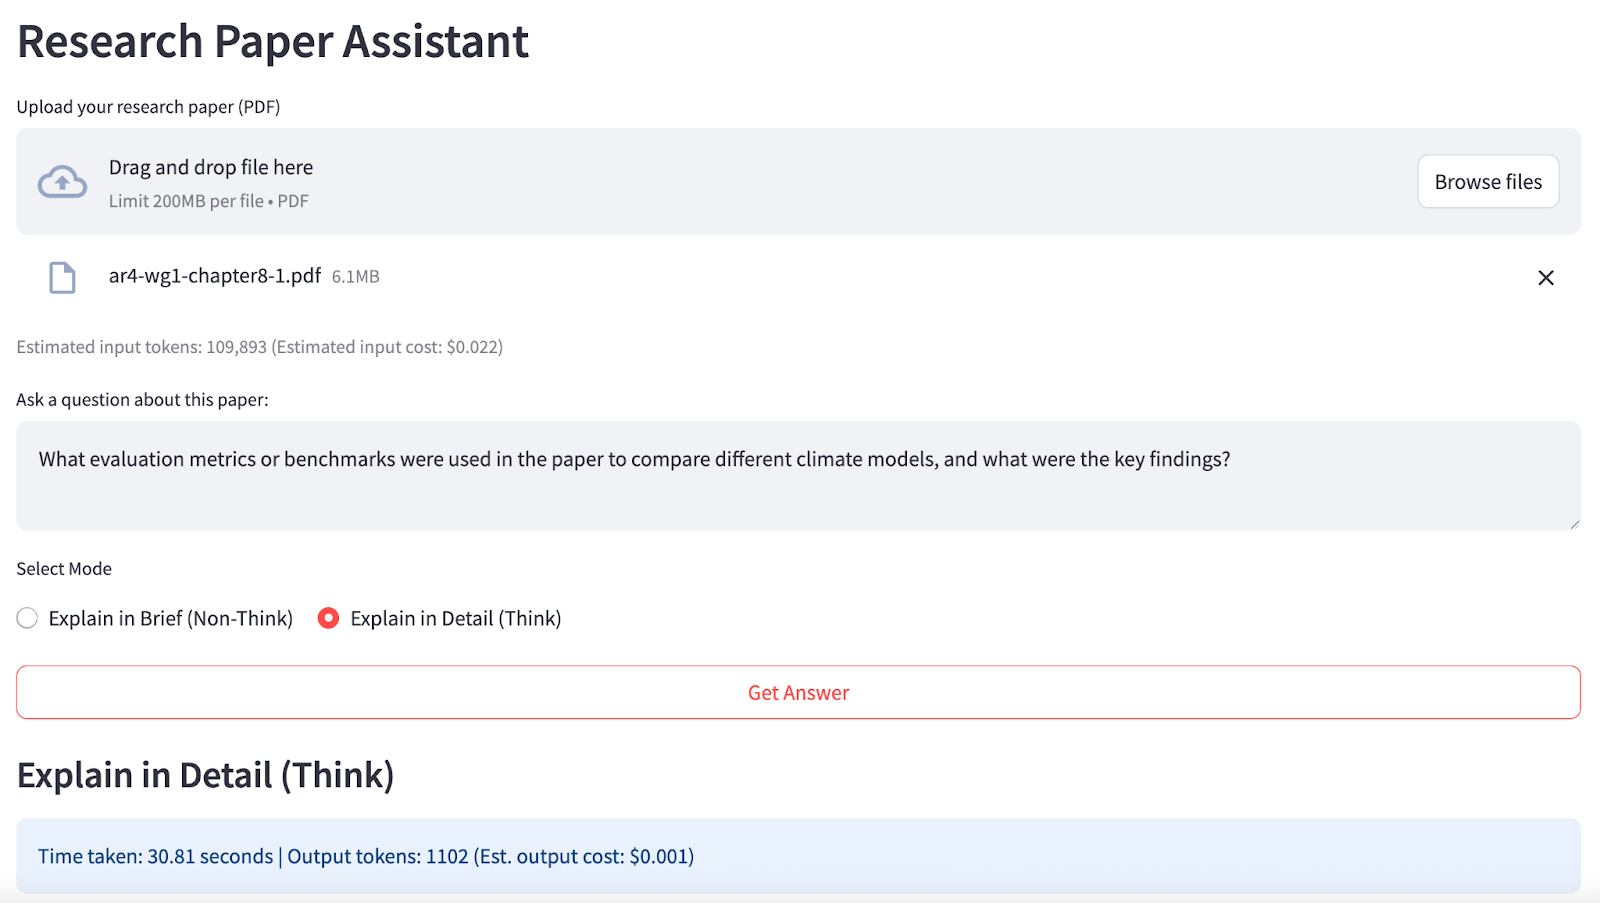
Dans cet article, je me concentre sur les capacités agentiques de DeepSeek V3.1 pour la compréhension d’articles scientifiques. Je vous explique, étape par étape, comment transformer n’importe quel PDF en assistant de recherche interactif via une application Streamlit :
Au final, votre application ressemblera à ceci :
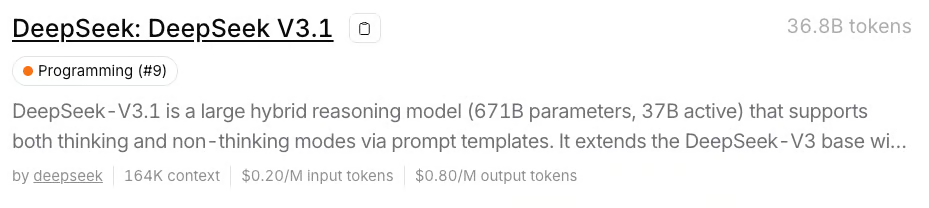
DeepSeek V3.1 est un modèle hybride de Mixture-of-Experts (MoE) comptant 671 milliards de paramètres, entraîné pour deux styles de réponse : « thinking » (détaillé, argumenté) et « non-thinking » (factuel, concis). Il gère des contextes jusqu’à 128 000 tokens et est accessible via l’API compatible OpenAI d’OpenRouter.
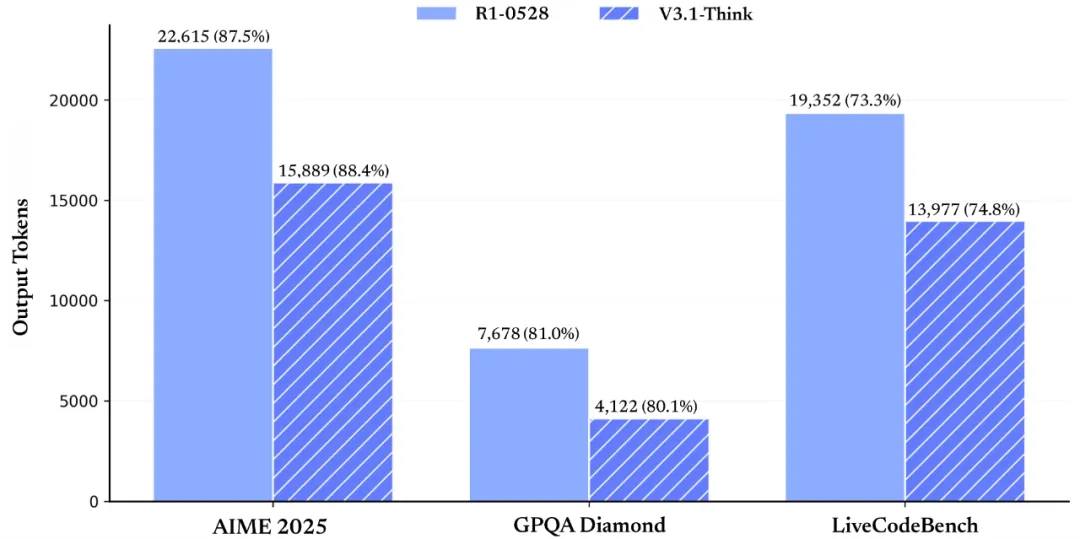
Source : DeepSeek
Les caractéristiques essentielles de DeepSeek V3.1 sont :
Dans cette section, je montre comment j’ai utilisé DeepSeek V3.1 pour transformer tout article scientifique PDF téléversé en assistant de recherche interactif dopé à l’IA.
Voici le fonctionnement :
Avant d’exécuter cette démo, assurons-nous d’avoir tous les prérequis.
Commencez par installer les imports suivants :
pip install streamlit openai pypdfCette commande installe les dépendances essentielles pour l’interface, la gestion des PDF et les requêtes API.
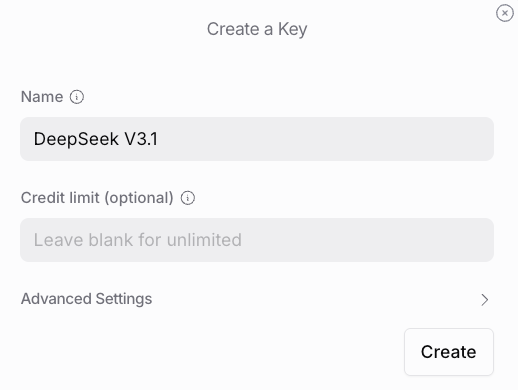
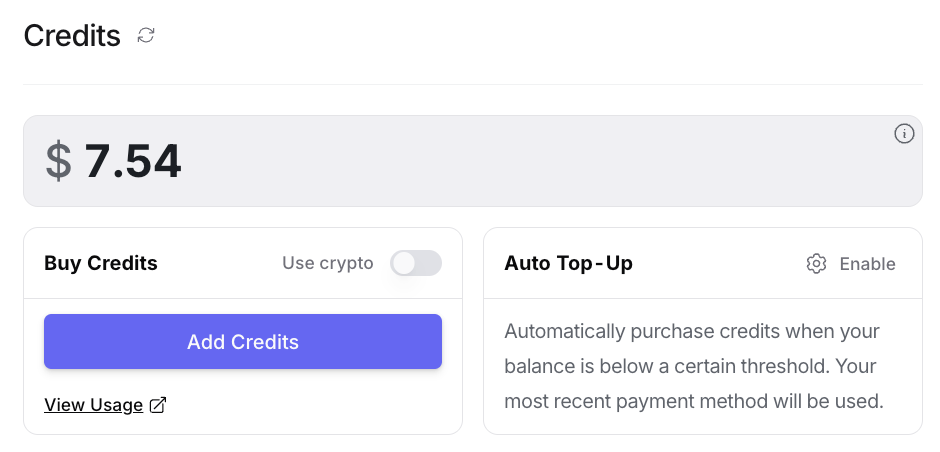
Le modèle DeepSeek V3.1 est disponible via de nombreuses plateformes, ainsi que l’API officielle DeepSeek. Pour ma part, j’ai utilisé OpenRouter, qui donne accès à plusieurs clés d’API pour de nombreux modèles et s’est révélé le plus économique pour cette démo. Procédez ainsi pour configurer une clé d’API pour DeepSeek V3.1 :
Définissez maintenant votre clé d’API comme variable d’environnement avant d’exécuter l’application :
export OPENROUTER_API_KEY=your_api_keyL’API officielle DeepSeek convient le mieux aux charges à fort volume et aux traitements automatisés.
Pour la plupart des cas d’usage de recherche, d’enseignement ou de démonstration, y compris cet assistant Streamlit pour articles scientifiques, je préfère OpenRouter car c’est un choix plus simple et plus flexible. Il offre une tarification globale prévisible, sans fenêtres temporelles ni logique de cache à gérer : idéal pour des analyses ad hoc, des questions uniques sur des documents et une collaboration facilitée.
Remarque : utiliser DeepSeek V3.1 via l’API ne requiert qu’environ 8 Go de mémoire pour l’interface, vous évitant d’héberger localement le gigantesque modèle de 670 milliards de paramètres, qui demanderait sinon plus de 170 Go d’espace disque et un GPU puissant.
Pour proposer DeepSeek V3.1 dans une interface conviviale, nous allons utiliser Streamlit comme framework et le connecter au modèle via l’API compatible OpenAI d’OpenRouter.
Cette étape couvre la configuration de l’environnement, l’authentification API et la configuration de base de Streamlit.
import streamlit as stimport pypdfimport tempfilefrom openai import OpenAIimport osimport timeimport rest.set_page_config( page_title="DeepSeek V3.1 Research Assistant", layout="wide")with st.sidebar: st.title("Research Paper Assistant") st.info("Tip: Ask about the methods, findings, or reasoning for best results.")OPENROUTER_API_KEY = os.environ.get("OPENROUTER_API_KEY", "")if not OPENROUTER_API_KEY: st.warning("Add your OpenRouter API key to an environment variable.") st.stop()client = OpenAI( base_url="https://openrouter.ai/api/v1", api_key=OPENROUTER_API_KEY,)Dans le code ci-dessus, l’appel à st.set_page_config() personnalise le titre et la mise en page de l’application Streamlit. L’application récupère la clé d’API OpenRouter depuis les variables d’environnement et instancie un client compatible OpenAI pointant vers l’endpoint OpenRouter, garantissant que tous les appels LLM sont correctement routés et authentifiés pour DeepSeek V3.1.
Avant de construire le flux principal, nous avons besoin de fonctions robustes pour le traitement des documents et l’estimation des ressources. Nous définissons ici des fonctions d’aide pour extraire le texte des PDFs téléversés, prévisualiser le contenu, compter approximativement les tokens et estimer le coût d’après la tarification OpenRouter de DeepSeek V3.1.
def pdf_to_text(uploaded_file): with tempfile.NamedTemporaryFile(delete=False, suffix=".pdf") as tmp_file: tmp_file.write(uploaded_file.read()) tmp_path = tmp_file.name reader = pypdf.PdfReader(tmp_path) text = "" for page in reader.pages: page_text = page.extract_text() if page_text: text += page_text + "\n" return textdef preview_pdf_text(text, max_chars=600): preview = text[:max_chars] if len(text) > max_chars: preview += "\n...\n[Preview truncated]" return previewdef count_tokens(text): return max(1, int(len(text) / 4))def estimate_cost(tokens, mode="input"): if mode == "input": return tokens / 1_000_000 * 0.20 else: return tokens / 1_000_000 * 0.80Avec ces fonctions utilitaires, notre backend est prêt à alimenter une interface d’assistant de recherche scalable :
pdf_to_text() convertit des PDFs multipages en texte brut tout en préservant les limites de page, rendant les données exploitables par un LLM et pour la suite du traitement.count_tokens() fournit un volume de tokens approximatif pour suivre l’usage API au regard de la grande fenêtre de contexte de DeepSeek. La fonction estimate_cost() traduit ensuite ces tokens en un retour coût en temps réel selon les tarifs OpenRouter pour l’entrée et la sortie, afin d’informer l’utilisateur sur le budget computationnel de chaque requête.preview_pdf_text() crée des aperçus tronqués permettant de vérifier l’intégrité et la pertinence du contenu extrait avant d’engager des coûts modèle ou d’atteindre des limites d’API.Avec ces briques en place, nous pouvons assembler l’application Streamlit complète pour un Q&R agentique sur articles scientifiques et à long contexte.
Maintenant que les utilitaires sont en place, assemblons l’interface principale Streamlit qui réunit traitement PDF, estimation tokens/coûts, Q&R piloté par l’utilisateur et interaction en direct avec DeepSeek V3.1 via OpenRouter.
st.header("Research Paper Assistant")pdf_file = st.file_uploader("Upload your research paper (PDF)", type=["pdf"])if "paper_text" not in st.session_state or st.session_state.get("last_uploaded") != pdf_file: if pdf_file is not None: with st.spinner("Extracting text from PDF..."): st.session_state.paper_text = pdf_to_text(pdf_file) st.session_state.last_uploaded = pdf_file st.success(f"PDF uploaded. Total characters extracted: {len(st.session_state.paper_text):,}") with st.expander("Preview of extracted PDF text:"): st.code(preview_pdf_text(st.session_state.paper_text), language='markdown')paper_text = st.session_state.get("paper_text")if paper_text: input_tokens = count_tokens(paper_text) st.caption(f"Estimated input tokens: {input_tokens:,} (Estimated input cost: ${estimate_cost(input_tokens):.3f})") question = st.text_area("Ask a question about this paper:", height=80, placeholder="E.g. What are the main findings?") mode = st.radio( "Select Mode", ["Explain in Brief (Non-Think)", "Explain in Detail (Think)"], horizontal=True, ) go = st.button("Get Answer", use_container_width=True) if question and go: if mode == "Explain in Brief (Non-Think)": prompt = ( f"{paper_text}\n\n" f"Question: {question}\n" "First, answer in a few sentences. Then, quote 1–2 exact sentences from the above paper that best support your answer. " "Show each quote on a new line." ) thinking_flag = False header = "Explain in Brief (Non-Think)" else: prompt = ( f"{paper_text}\n\n" f"Question: {question}\n" "First, answer in detail with reasoning and evidence. Then, quote 2–3 exact sentences from the above paper that most strongly support your answer. " "List the quotes after your answer." ) thinking_flag = True header = "Explain in Detail (Think)" with st.spinner(f"Generating answer..."): start_time = time.perf_counter() try: response = client.chat.completions.create( model="deepseek/deepseek-chat-v3.1", messages=[ {"role": "system", "content": "You are a helpful research assistant."}, {"role": "user", "content": prompt} ], max_tokens=900, extra_body={"thinking": thinking_flag}, ) answer = response.choices[0].message.content.strip() output_tokens = count_tokens(answer) except Exception as e: answer = f"Error: {e}" output_tokens = 0 end_time = time.perf_counter() elapsed_time = end_time - start_time parts = re.split(r"(?:^|\n)(Quotes?:?)", answer, flags=re.IGNORECASE) if len(parts) >= 3: main_answer = parts[0].strip() quotes = parts[2].strip() else: main_answer = answer quotes = None st.markdown(f"### {header}") st.info(f"Time taken: {elapsed_time:.2f} seconds | Output tokens: {output_tokens} (Est. output cost: ${estimate_cost(output_tokens, 'output'):.3f})") st.write(main_answer) if quotes: st.markdown("**Supporting Quotes:**") st.success(quotes)Cette application Streamlit met en œuvre un assistant dynamique pour articles scientifiques avec DeepSeek V3.1, de l’ingestion de documents au Q&R contextuel. Les fonctions clé gérées par l’application sont :
L’utilisateur téléverse un fichier PDF via l’interface, puis :
st.session_state pour savoir si le fichier est nouveau. Le cas échéant, elle extrait le texte et le met en cache dans session_state avec la référence de téléversement, évitant une nouvelle extraction à chaque interaction.Une fois le document chargé, l’utilisateur peut poser une question et choisir entre les modes Non-think et Think ; l’IU adapte alors les instructions de prompt pour chaque mode :
Quand l’utilisateur clique sur « Get Answer », l’application :
thinking dans la requête à l’API OpenRouter (extra_body={"thinking": thinking_flag}) pour exécuter le modèle dans le bon mode de raisonnement, sans s’en remettre à la température ;La réponse renvoyée est analysée pour séparer le corps principal et les citations de soutien (si présentes). Les deux sont ensuite affichés dans l’IU, en mettant en avant les preuves textuelles précises issues de l’article.
Pour essayer vous-même, enregistrez le code sous app.py et lancez :
streamlit run app.pyFormez-vous à l’IA avec ces cours !
Cours
Cours
Cours