
Kurs
Text-to-Query-Agents mit MongoDB und LangGraph
2 Std.
902
DeepSeek hat vor Kurzem DeepSeek V3.1 vorgestellt, ein großskaliges Hybrid-Reasoning-Modell mit „Think“- und „Non-Think“-Antwortmodi – ideal für interaktive Dokumentanalyse.
In diesem Blog zeige ich dir die agentischen Fähigkeiten von DeepSeek V3.1 beim Verstehen von wissenschaftlichen Arbeiten. Schritt für Schritt erkläre ich, wie du jedes PDF über eine Streamlit-App in einen interaktiven Forschungsassistenten verwandelst – inklusive:
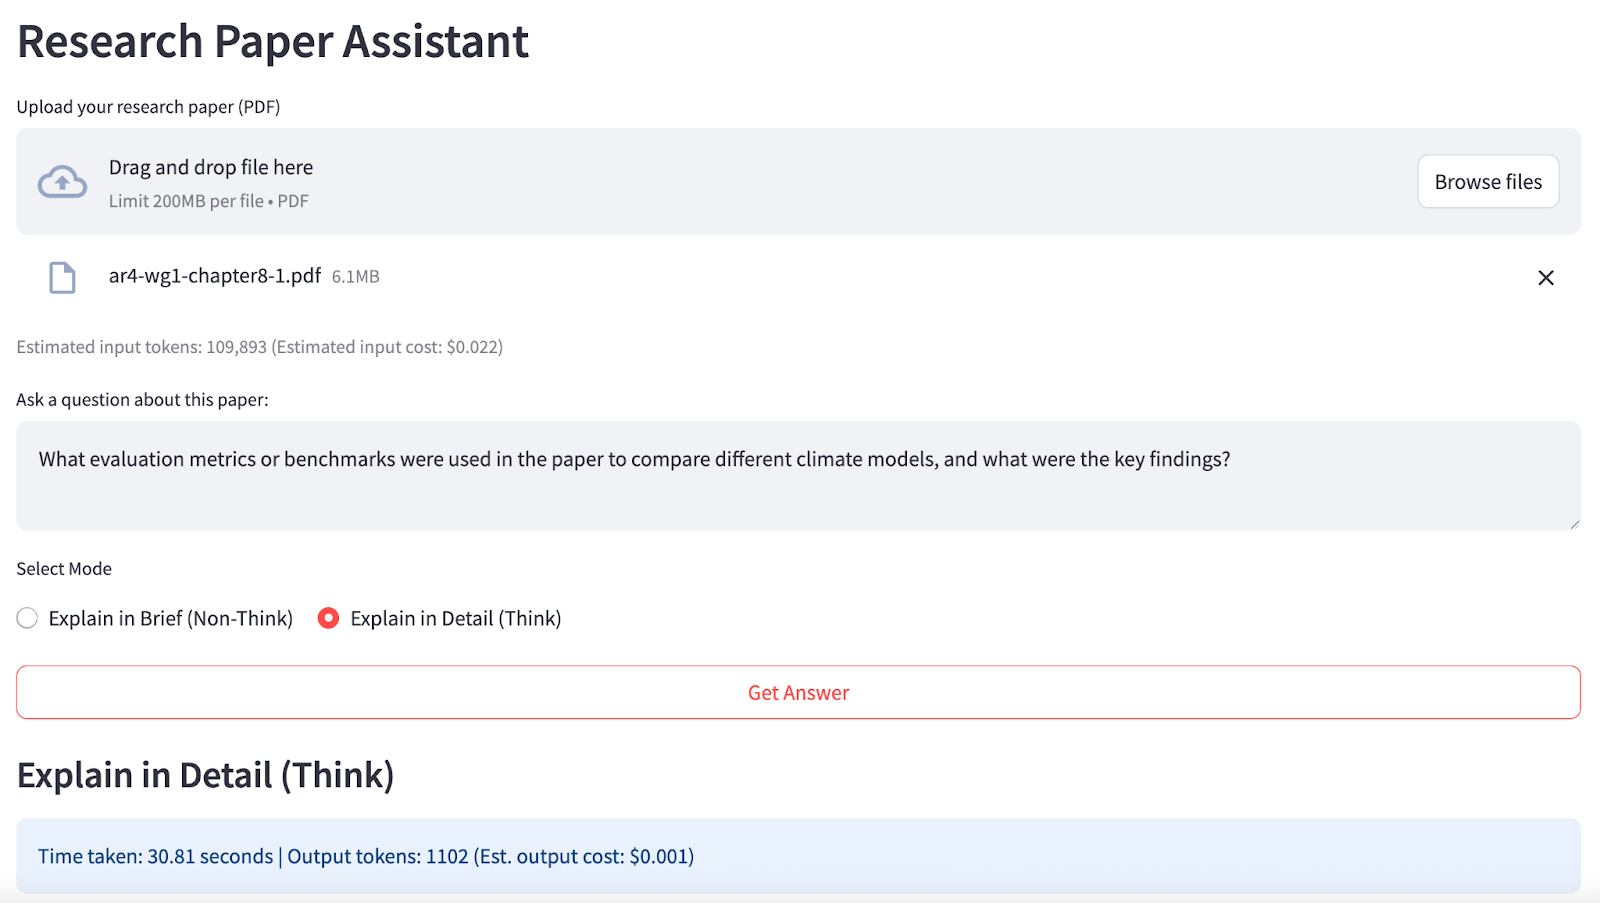
Am Ende sieht deine App so aus:
DeepSeek V3.1 ist ein hybrides Mixture-of-Experts (MoE)-Modell mit 671 Milliarden Parametern, trainiert für zwei Antwortstile: „Thinking“ (detailliert, begründet) und „Non-Thinking“ (faktisch, prägnant). Es unterstützt Kontexte bis 128.000 Tokens und ist über die OpenAI-kompatible API von OpenRouter erreichbar.
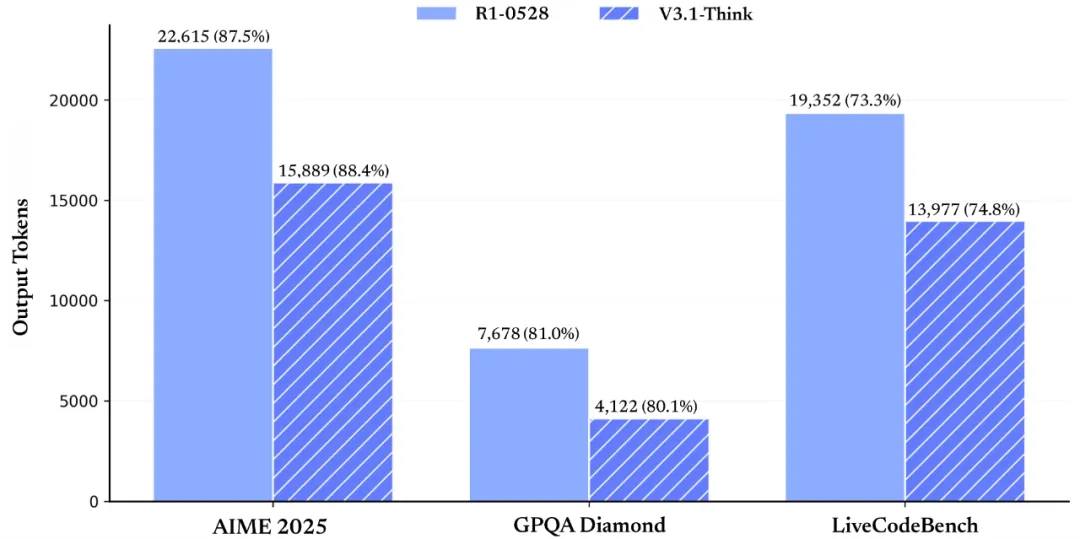
Quelle: DeepSeek
Die wichtigsten Funktionen von DeepSeek V3.1 sind:
In diesem Abschnitt zeige ich, wie ich DeepSeek V3.1 genutzt habe, um jedes hochgeladene PDF-Paper in einen interaktiven, KI-gestützten Forschungsassistenten zu verwandeln.
So funktioniert es:
Bevor wir starten, prüfen wir die Voraussetzungen.
Installiere zunächst folgende Pakete:
pip install streamlit openai pypdfDamit hast du alle Kernabhängigkeiten für UI, PDF-Verarbeitung und API-Requests installiert.
Das DeepSeek V3.1-Modell ist über mehrere Plattformen verfügbar, darunter die DeepSeek Official API. Für diese Demo habe ich jedoch OpenRouter verwendet. Dort bekommst du Zugriff auf mehrere API-Keys für zahlreiche Modelle – für diese Demo die kostengünstigste Option. So richtest du den API-Key für DeepSeek V3.1 ein:
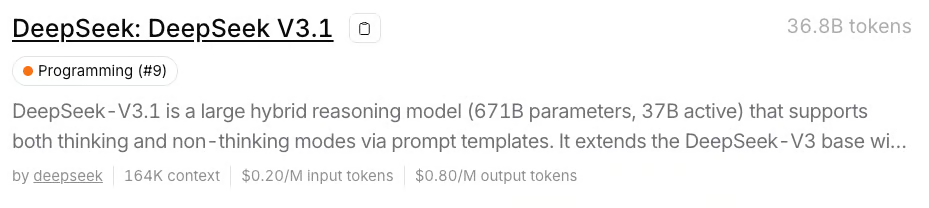
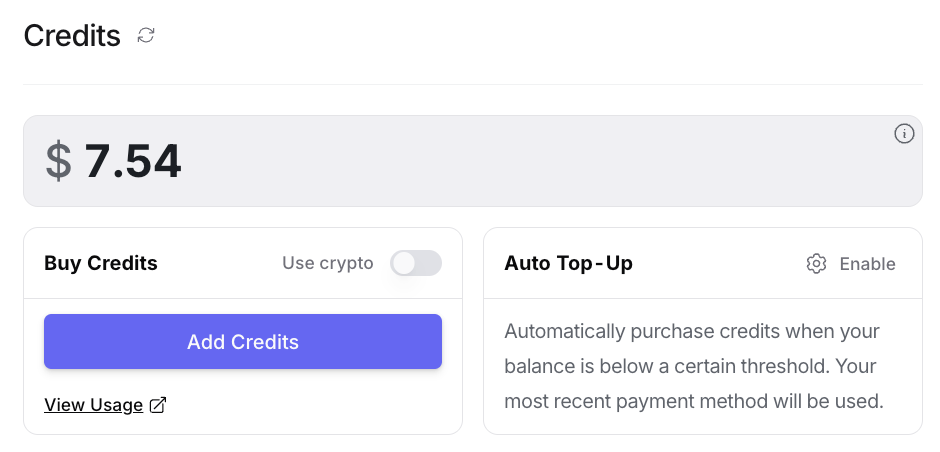
Setze nun den API-Key als Umgebungsvariable, bevor du die App startest:
export OPENROUTER_API_KEY=your_api_keyDie offizielle DeepSeek-API eignet sich am besten für hochvolumige, automatisierte Workloads.
Für die meisten Forschungs-, Bildungs- oder Demo-Anwendungen – inklusive dieses Streamlit Research Paper Assistant – bevorzuge ich OpenRouter: einfacher, flexibler, mit transparenten globalen Preisen ohne Zeitfenster-Beschränkungen oder Cache-Logik. Ideal für Ad-hoc-Analysen, individuelle Dokumentabfragen und leichte Zusammenarbeit.
Hinweis: Die Nutzung von DeepSeek V3.1 über die API benötigt für die UI nur etwa 8 GB Arbeitsspeicher. Du musst das 670B-Parameter-Modell also nicht lokal hosten – das würde über 170 GB Speicherplatz und eine starke GPU erfordern.
Damit DeepSeek V3.1 über eine benutzerfreundliche Oberfläche nutzbar ist, verwenden wir Streamlit als App-Framework und verbinden es über die OpenAI-kompatible API von OpenRouter mit dem Modell.
Dieser Schritt umfasst Umgebung, API-Authentifizierung und grundlegende Streamlit-Konfiguration.
import streamlit as stimport pypdfimport tempfilefrom openai import OpenAIimport osimport timeimport rest.set_page_config( page_title="DeepSeek V3.1 Research Assistant", layout="wide")with st.sidebar: st.title("Research Paper Assistant") st.info("Tip: Ask about the methods, findings, or reasoning for best results.")OPENROUTER_API_KEY = os.environ.get("OPENROUTER_API_KEY", "")if not OPENROUTER_API_KEY: st.warning("Add your OpenRouter API key to an environment variable.") st.stop()client = OpenAI( base_url="https://openrouter.ai/api/v1", api_key=OPENROUTER_API_KEY,)Der Aufruf von st.set_page_config() setzt Seitentitel und Layout der Streamlit-App. Der OpenRouter-API-Key wird aus den Umgebungsvariablen gelesen, und ein OpenAI-kompatibler Client zeigt auf den OpenRouter-Endpunkt. So werden alle nachfolgenden LLM-Calls korrekt geroutet und für DeepSeek V3.1 authentifiziert.
Bevor wir den Haupt-Workflow bauen, brauchen wir robuste Utilities für Dokumentverarbeitung und Ressourcenabschätzung. Wir definieren Funktionen, um Text aus hochgeladenen PDFs zu extrahieren, eine Vorschau zu erzeugen, die ungefähre Tokenzahl zu zählen und die Kosten anhand der OpenRouter-Preise für DeepSeek V3.1 zu schätzen.
def pdf_to_text(uploaded_file): with tempfile.NamedTemporaryFile(delete=False, suffix=".pdf") as tmp_file: tmp_file.write(uploaded_file.read()) tmp_path = tmp_file.name reader = pypdf.PdfReader(tmp_path) text = "" for page in reader.pages: page_text = page.extract_text() if page_text: text += page_text + "\n" return textdef preview_pdf_text(text, max_chars=600): preview = text[:max_chars] if len(text) > max_chars: preview += "\n...\n[Preview truncated]" return previewdef count_tokens(text): return max(1, int(len(text) / 4))def estimate_cost(tokens, mode="input"): if mode == "input": return tokens / 1_000_000 * 0.20 else: return tokens / 1_000_000 * 0.80Mit diesen Helpern ist das Backend gut vorbereitet für eine skalierbare Research-Assistant-Oberfläche:
pdf_to_text() wandelt mehrseitige PDFs in Fließtext um und behält Seitenumbrüche bei. So wird der Text LLM-tauglich und für nachgelagerte Schritte nutzbar.count_tokens() liefert eine grobe Tokenzahl zur Kontrolle der API-Nutzung im Hinblick auf das große Kontextfenster von DeepSeek. estimate_cost() übersetzt die Token in Echtzeit-Kostenfeedback basierend auf OpenRouter-Preisen für Input und Output – so bleibt das Budget pro Anfrage transparent.preview_pdf_text() erzeugt eine gekürzte Vorschau, damit Nutzende die Korrektheit und Relevanz des extrahierten Inhalts prüfen können, bevor Kosten anfallen oder Limits erreicht werden.Mit diesen Bausteinen können wir jetzt die komplette Streamlit-App für langkontextige, agentische Paper-Q&A zusammensetzen.
Auf Basis der Utilities bauen wir nun die Hauptoberfläche in Streamlit – inklusive PDF-Verarbeitung, Token-/Kostenschätzung, nutzergetriebenem Q&A und Live-Interaktion mit DeepSeek V3.1 via OpenRouter.
st.header("Research Paper Assistant")pdf_file = st.file_uploader("Upload your research paper (PDF)", type=["pdf"])if "paper_text" not in st.session_state or st.session_state.get("last_uploaded") != pdf_file: if pdf_file is not None: with st.spinner("Extracting text from PDF..."): st.session_state.paper_text = pdf_to_text(pdf_file) st.session_state.last_uploaded = pdf_file st.success(f"PDF uploaded. Total characters extracted: {len(st.session_state.paper_text):,}") with st.expander("Preview of extracted PDF text:"): st.code(preview_pdf_text(st.session_state.paper_text), language='markdown')paper_text = st.session_state.get("paper_text")if paper_text: input_tokens = count_tokens(paper_text) st.caption(f"Estimated input tokens: {input_tokens:,} (Estimated input cost: ${estimate_cost(input_tokens):.3f})") question = st.text_area("Ask a question about this paper:", height=80, placeholder="E.g. What are the main findings?") mode = st.radio( "Select Mode", ["Explain in Brief (Non-Think)", "Explain in Detail (Think)"], horizontal=True, ) go = st.button("Get Answer", use_container_width=True) if question and go: if mode == "Explain in Brief (Non-Think)": prompt = ( f"{paper_text}\n\n" f"Question: {question}\n" "First, answer in a few sentences. Then, quote 1–2 exact sentences from the above paper that best support your answer. " "Show each quote on a new line." ) thinking_flag = False header = "Explain in Brief (Non-Think)" else: prompt = ( f"{paper_text}\n\n" f"Question: {question}\n" "First, answer in detail with reasoning and evidence. Then, quote 2–3 exact sentences from the above paper that most strongly support your answer. " "List the quotes after your answer." ) thinking_flag = True header = "Explain in Detail (Think)" with st.spinner(f"Generating answer..."): start_time = time.perf_counter() try: response = client.chat.completions.create( model="deepseek/deepseek-chat-v3.1", messages=[ {"role": "system", "content": "You are a helpful research assistant."}, {"role": "user", "content": prompt} ], max_tokens=900, extra_body={"thinking": thinking_flag}, ) answer = response.choices[0].message.content.strip() output_tokens = count_tokens(answer) except Exception as e: answer = f"Error: {e}" output_tokens = 0 end_time = time.perf_counter() elapsed_time = end_time - start_time parts = re.split(r"(?:^|\n)(Quotes?:?)", answer, flags=re.IGNORECASE) if len(parts) >= 3: main_answer = parts[0].strip() quotes = parts[2].strip() else: main_answer = answer quotes = None st.markdown(f"### {header}") st.info(f"Time taken: {elapsed_time:.2f} seconds | Output tokens: {output_tokens} (Est. output cost: ${estimate_cost(output_tokens, 'output'):.3f})") st.write(main_answer) if quotes: st.markdown("**Supporting Quotes:**") st.success(quotes)Diese Streamlit-App setzt einen dynamischen Research Paper Assistant mit DeepSeek V3.1 um – vom Dokument-Import bis zur kontextbewussten LLM-Q&A. Das übernimmt die App:
Nutzende laden ein PDF hoch, anschließend:
st.session_state auf eine neue Datei. Falls ja, wird der Text extrahiert und zusammen mit der Upload-Referenz gecacht, um die Extraktion nicht bei jeder Interaktion zu wiederholen.Sobald ein Dokument geladen ist, kann eine Frage gestellt und zwischen Non-Think und Think gewählt werden. Die UI passt die Prompt-Instruktionen entsprechend an:
Wenn auf „Get Answer“ geklickt wird, dann:
thinking im OpenRouter-Request (extra_body={"thinking": thinking_flag}), damit das Modell im richtigen Reasoning-Modus läuft – unabhängig von der Temperatur.Die Antwort wird so geparst, dass Hauptteil und Zitate (falls vorhanden) getrennt sind. Danach rendert die UI beides, inklusive der exakten Textbelege aus dem Paper.
Wenn du es selbst ausprobieren willst, speichere den Code als app.py und starte:
streamlit run app.pyLerne KI mit diesen Kursen!
Kurs
Kurs
Kurs