
Last chance! 50% off DataCamp Premium
Sale ends in
Jika Anda memiliki sedikit pengalaman menerapkan algoritma machine learning, Anda akan mengetahui bahwa hal itu tidak mensyaratkan pengetahuan Statistik sebagai prasyarat.
Namun, mengetahui sebagian statistik akan bermanfaat untuk memahami machine learning secara teknis sekaligus intuitif. Pengetahuan statistik pada akhirnya akan diperlukan saat Anda mulai memvalidasi hasil dan menafsirkannya. Bagaimanapun juga, ketika ada data, ada statistik. Seperti Matematika adalah bahasa Sains, Statistik adalah salah satu bahasa khusus untuk Data Science dan Machine Learning.
Statistik adalah cabang matematika dengan banyak teori dan temuan. Namun, berbagai konsep, alat, teknik, dan notasi diambil dari bidang ini untuk membentuk machine learning seperti sekarang. Anda dapat menggunakan metode statistik deskriptif untuk membantu mengubah observasi menjadi informasi berguna yang dapat Anda pahami dan bagikan kepada orang lain. Anda dapat menggunakan teknik statistik inferensial untuk menarik kesimpulan dari sampel data kecil ke keseluruhan domain. Nanti dalam pos ini, Anda akan mempelajari statistik deskriptif dan inferensial. Jadi, jangan khawatir.
Sebelum memulai, mari kita lihat sepuluh contoh di mana metode statistik digunakan dalam proyek machine learning terapan:
Sumber: Statistical Methods for Machine Learning
Menarik, bukan?
Pos ini akan memberi Anda landasan yang kuat dalam statistik esensial namun diperlukan untuk menjadi praktisi machine learning yang baik.
Dalam pos ini, Anda akan mempelajari:
Ada banyak hal yang perlu dibahas, dan semua topiknya sama penting. Mari kita mulai!
Mari kita pelajari secara singkat cara mendefinisikan statistik dalam istilah sederhana.
Statistik dianggap sebagai subbidang matematika. Ini mengacu pada banyak metode untuk bekerja dengan data dan menggunakan data tersebut untuk menjawab berbagai jenis pertanyaan.
Ketika berbicara tentang alat statistik yang digunakan dalam praktik, akan membantu untuk membagi bidang statistik menjadi dua kelompok metode yang luas: statistik deskriptif untuk meringkas data, dan statistik inferensial untuk menarik kesimpulan dari sampel data (Statistics for Machine Learning (7-Day Mini-Course).

Sumber: IntellSpot
Statistik Inferensial: Statistik inferensial adalah metode yang membantu mengkuantifikasi sifat-sifat domain atau populasi dari sekumpulan observasi yang lebih kecil yang disebut sampel. Di bawah ini adalah infografik yang menggambarkan statistik inferensial dengan baik:
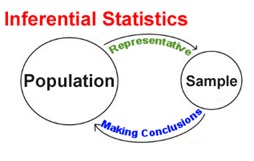
Sumber: Analytics Vidhya
Pada bagian berikutnya, Anda akan mempelajari penggunaan statistik untuk persiapan data.
Metode statistik diperlukan dalam pengembangan data latih dan uji untuk model machine learning Anda.
Ini mencakup teknik untuk:
Pemahaman dasar tentang distribusi data, statistik deskriptif, dan visualisasi data diperlukan untuk membantu Anda mengidentifikasi metode yang akan dipilih saat melakukan tugas-tugas ini.
Mari kita bahas secara singkat masing-masing poin di atas.
Mari kita lihat terlebih dahulu apa itu outlier.
Outlier dianggap sebagai observasi yang tampak menyimpang dari observasi lain dalam sampel. Gambar berikut membuat definisinya lebih jelas.

Sumber: MathWorks
Anda dapat menemukan outlier dalam data seperti pada gambar di atas.
Banyak algoritma machine learning sensitif terhadap rentang dan distribusi nilai atribut pada data masukan. Outlier pada data masukan dapat membelokkan dan menyesatkan proses pelatihan algoritma machine learning sehingga menghasilkan waktu pelatihan lebih lama, model kurang akurat, dan pada akhirnya hasil yang lebih buruk.
Identifikasi potensi outlier penting karena alasan berikut:
Outlier bisa mengindikasikan data yang buruk. Misalnya, data mungkin dikodekan secara tidak benar, atau eksperimen tidak berjalan dengan benar. Jika dapat ditentukan bahwa titik yang menyimpang memang keliru, maka nilai yang menyimpang tersebut harus dihapus dari analisis. Jika memungkinkan untuk diperbaiki, itu opsi lain.
Dalam beberapa kasus, mungkin tidak memungkinkan untuk menentukan apakah titik yang menyimpang adalah data buruk. Outlier bisa terjadi karena variasi acak atau mungkin mengindikasikan sesuatu yang menarik secara ilmiah. Bagaimanapun, Anda biasanya tidak ingin langsung menghapus observasi yang menyimpang. Namun, jika data mengandung outlier yang signifikan, Anda mungkin perlu mempertimbangkan penggunaan teknik statistik yang robust.
Jadi, outlier sering kali tidak baik untuk model prediktif Anda (meskipun, terkadang, outlier ini dapat dimanfaatkan sebagai keuntungan. Namun itu di luar cakupan pos ini). Anda memerlukan pengetahuan statistik untuk menangani outlier secara efektif.
Kebanyakan dataset saat ini mengalami masalah nilai hilang. Model machine learning Anda mungkin tidak terlatih secara efektif jika data yang Anda masukkan ke model berisi nilai hilang. Di sinilah alat dan teknik statistik membantu.
Banyak orang cenderung membuang instance data yang mengandung nilai hilang. Namun itu bukan praktik yang baik karena Anda bisa kehilangan fitur/representasi penting dari data. Meskipun ada metode lanjutan untuk menangani masalah nilai hilang, ini adalah teknik cepat yang biasa digunakan: Imputasi Rata-rata (Mean) dan Imputasi Median.
Penting bagi Anda untuk memahami apa itu mean dan median.
Misal, Anda memiliki fitur X1 yang bernilai - 13, 18, 13, 14, 13, 16, 14, 21, 13
Mean adalah rata-rata biasa, jadi saya jumlahkan lalu bagi:
(13 + 18 + 13 + 14 + 13 + 16 + 14 + 21 + 13) / 9 = 15
Perhatikan bahwa mean dalam kasus ini bukanlah nilai dari daftar asli. Ini adalah hasil yang umum. Anda tidak boleh mengasumsikan bahwa mean Anda akan menjadi salah satu angka asli.
Median adalah nilai tengah, jadi pertama-tama Anda harus menulis ulang daftar dalam urutan numerik:
13, 13, 13, 13, 14, 14, 16, 18, 21
Ada sembilan angka dalam daftar, jadi yang di tengah adalah angka ke-(9 + 1) / 2 = 10 / 2 = 5:
13, 13, 13, 13, 14, 14, 16, 18, 21
Jadi mediannya adalah 14.
Data dianggap sebagai mata uang dalam machine learning terapan. Oleh karena itu, pengumpulan dan penggunaannya sama-sama penting.
Pengambilan sampel data mengacu pada metode statistik untuk memilih observasi dari domain dengan tujuan memperkirakan parameter populasi. Dengan kata lain, sampling adalah proses aktif mengumpulkan observasi dengan maksud memperkirakan variabel populasi.
Setiap baris dataset merepresentasikan observasi yang mengindikasikan populasi tertentu. Saat bekerja dengan data, Anda sering kali tidak memiliki akses ke semua kemungkinan observasi. Ini bisa karena banyak alasan, misalnya:
Sering kali, Anda tidak memiliki proporsi sampel data yang tepat. Jadi, Anda harus melakukan under-sampling atau over-sampling berdasarkan jenis masalahnya.
Anda melakukan under-sampling ketika sampel data untuk kategori tertentu sangat tinggi dibandingkan yang lain, artinya Anda membuang sebagian sampel data dari kategori yang berlebih. Anda melakukan over-sampling ketika sampel data untuk jenis tertentu sangat rendah dibandingkan yang lain. Dalam kasus ini, Anda menghasilkan sampel data tambahan.
Ini berlaku juga untuk skenario multi-kelas.
Pengambilan sampel statistik adalah bidang studi yang luas, tetapi dalam machine learning terapan, ada tiga jenis sampling yang kemungkinan akan Anda gunakan: pengambilan sampel acak sederhana, sistematis, dan bertingkat.
Meskipun ini adalah jenis sampling yang lebih umum Anda temui, ada teknik lain (A Gentle Introduction to Statistical Sampling and Resampling).
Sering kali, fitur pada dataset Anda memiliki rentang yang sangat bervariasi. Beberapa fitur mungkin memiliki skala 0 hingga 100 sementara yang lain mungkin memiliki rentang 0,01 - 0,001, 10000 - 20000, dll.
Ini sangat bermasalah untuk pemodelan yang efisien. Karena perubahan kecil pada fitur yang memiliki rentang nilai lebih rendah daripada fitur lain mungkin tidak berdampak signifikan pada fitur lainnya. Hal ini mempengaruhi proses pembelajaran yang baik. Menangani masalah ini dikenal sebagai penskalaan data.
Ada berbagai teknik penskalaan data seperti penskalaan Min-Max, penskalaan Absolut, penskalaan Standar, dll.
Sesekali, dataset Anda berisi campuran data numerik dan non-numerik. Banyak kerangka kerja machine learning seperti scikit-learn mengharapkan semua data hadir dalam format numerik. Ini juga membantu mempercepat proses komputasi.
Sekali lagi, statistik datang menyelamatkan Anda.
Teknik seperti Label encoding, One-Hot encoding, dll. digunakan untuk mengonversi data non-numerik menjadi numerik.
Anda telah membahas banyak teori sejauh ini. Anda akan menerapkan sebagian di antaranya untuk merasakan secara langsung.
Anda akan mulai dengan menerapkan beberapa metode statistik untuk mendeteksi Outlier.
Anda akan menggunakan indeks Z-Score untuk mendeteksi outlier, dan untuk ini, Anda akan meneliti Boston House Price dataset. Mari mulai dengan mengimpor dataset dari utilitas sklearn, dan seiring berjalan Anda akan memulai konsep yang diperlukan.
import pandas as pd
import numpy as np
from sklearn.datasets import load_boston

# Load the Boston dataset into a variable called boston
boston = load_boston()
# Separate the features from the target
x = boston.data
y = boston.target
Untuk melihat dataset dalam format tabel standar dengan semua nama fitur, Anda akan mengonversinya menjadi dataframe pandas.
# Take the columns separately in a variable
columns = boston.feature_names

# Create the dataframe
boston_df = pd.DataFrame(boston.data)
boston_df.columns = columns
boston_df.head()

Merupakan praktik umum untuk memulai dengan analisis outlier univariat di mana Anda mempertimbangkan satu fitur pada satu waktu. Sering kali, box-plot sederhana dari fitur tertentu dapat memberikan titik awal yang baik. Anda akan membuat box-plot menggunakan seaborn dan Anda akan menggunakan fitur DIS.
import seaborn as sns
sns.boxplot(x=boston_df['DIS'])

import matplotlib.pyplot as plt
plt.show()
<matplotlib.axes._subplots.AxesSubplot at 0x8abded0>

Untuk menampilkan box-plot, Anda melakukan impor kedua pada matplotlib karena plot seaborn ditampilkan seperti plot matplotlib biasa.
Plot di atas menunjukkan tiga titik antara 10 hingga 12, ini adalah outlier karena tidak termasuk dalam kotak observasi lainnya. Di sini Anda menganalisis outlier univariat, yaitu Anda hanya menggunakan fitur DIS untuk memeriksa outlier.
Mari lanjutkan dengan Z-Score sekarang.
"Z-score adalah angka bertanda yang menyatakan berapa banyak simpangan baku nilai suatu observasi atau titik data berada di atas nilai mean dari apa yang diamati atau diukur." - Wikipedia
Gagasan di balik Z-score adalah mendeskripsikan setiap titik data terkait hubungannya dengan Simpangan Baku dan Mean untuk kelompok titik data tersebut. Z-score adalah tentang menemukan distribusi data di mana mean adalah 0, dan simpangan baku adalah 1, yaitu distribusi normal.
Tunggu! Bagaimana ini membantu mengidentifikasi outlier?
Nah, saat menghitung Z-score Anda melakukan penskalaan ulang dan pemusatan data (mean 0 dan simpangan baku 1) dan mencari instance yang terlalu jauh dari nol. Titik data yang terlalu jauh dari nol ini diperlakukan sebagai outlier. Dalam banyak kasus umum digunakan ambang 3 atau -3. Misalnya, jika nilai Z-score lebih besar dari 3 atau kurang dari -3. Titik data ini kemudian akan diidentifikasi sebagai outlier.
Anda akan menggunakan fungsi Z-score yang didefinisikan di pustaka scipy untuk mendeteksi outlier.
from scipy import stats

z = np.abs(stats.zscore(boston_df))
print(z)
[[0.41771335 0.28482986 1.2879095  ... 1.45900038 0.44105193 1.0755623 ]
 [0.41526932 0.48772236 0.59338101 ... 0.30309415 0.44105193 0.49243937]
 [0.41527165 0.48772236 0.59338101 ... 0.30309415 0.39642699 1.2087274 ]
 ...
 [0.41137448 0.48772236 0.11573841 ... 1.17646583 0.44105193 0.98304761]
 [0.40568883 0.48772236 0.11573841 ... 1.17646583 0.4032249  0.86530163]
 [0.41292893 0.48772236 0.11573841 ... 1.17646583 0.44105193 0.66905833]]
Tidak mungkin mendeteksi outlier hanya dengan melihat keluaran di atas. Anda lebih cerdas! Anda akan menentukan ambang untuk diri Anda sendiri, dan Anda akan menggunakan kondisi sederhana untuk mendeteksi outlier yang melampaui ambang tersebut.
threshold = 3
print(np.where(z > 3))
(array([ 55,  56,  57, 102, 141, 142, 152, 154, 155, 160, 162, 163, 199,
       200, 201, 202, 203, 204, 208, 209, 210, 211, 212, 216, 218, 219,
       220, 221, 222, 225, 234, 236, 256, 257, 262, 269, 273, 274, 276,
       277, 282, 283, 283, 284, 347, 351, 352, 353, 353, 354, 355, 356,
       357, 358, 363, 364, 364, 365, 367, 369, 370, 372, 373, 374, 374,
       380, 398, 404, 405, 406, 410, 410, 411, 412, 412, 414, 414, 415,
       416, 418, 418, 419, 423, 424, 425, 426, 427, 427, 429, 431, 436,
       437, 438, 445, 450, 454, 455, 456, 457, 466], dtype=int32), array([ 1,  1,  1, 11, 12,  3,  3,  3,  3,  3,  3,  3,  1,  1,  1,  1,  1,
        1,  3,  3,  3,  3,  3,  3,  3,  3,  3,  3,  3,  5,  3,  3,  1,  5,
        5,  3,  3,  3,  3,  3,  3,  1,  3,  1,  1,  7,  7,  1,  7,  7,  7,
        3,  3,  3,  3,  3,  5,  5,  5,  3,  3,  3, 12,  5, 12,  0,  0,  0,
        0,  5,  0, 11, 11, 11, 12,  0, 12, 11, 11,  0, 11, 11, 11, 11, 11,
       11,  0, 11, 11, 11, 11, 11, 11, 11, 11, 11, 11, 11, 11, 11],
      dtype=int32))
Lagi-lagi keluaran yang membingungkan! Array pertama berisi daftar nomor baris dan array kedua berisi nomor kolom masing-masing. Sebagai contoh, z[55][1] memiliki Z-score lebih tinggi dari 3.
print(z[55][1])
3.375038763517309
Jadi, rekaman ke-55 pada kolom ZN adalah outlier. Anda dapat melanjutkan dari sini.
Anda melihat bagaimana Anda dapat menggunakan Z-Score dan menetapkan ambangnya untuk mendeteksi potensi outlier dalam data. Selanjutnya, Anda akan melihat cara melakukan imputasi nilai hilang.
Anda akan menggunakan dataset terkenal Pima Indian Diabetes yang diketahui memiliki nilai hilang. Namun sebelum melangkah lebih jauh, Anda harus memuat dataset ke dalam ruang kerja Anda.
Anda akan memuat dataset ke objek DataFrame bernama data.
data = pd.read_csv("https://raw.githubusercontent.com/jbrownlee/Datasets/master/pima-indians-diabetes.data.csv",header=None)
print(data.describe())
                0           1           2           3           4           5  \
count  768.000000  768.000000  768.000000  768.000000  768.000000  768.000000
mean     3.845052  120.894531   69.105469   20.536458   79.799479   31.992578
std      3.369578   31.972618   19.355807   15.952218  115.244002    7.884160
min      0.000000    0.000000    0.000000    0.000000    0.000000    0.000000
25%      1.000000   99.000000   62.000000    0.000000    0.000000   27.300000
50%      3.000000  117.000000   72.000000   23.000000   30.500000   32.000000
75%      6.000000  140.250000   80.000000   32.000000  127.250000   36.600000
max     17.000000  199.000000  122.000000   99.000000  846.000000   67.100000

                6           7           8
count  768.000000  768.000000  768.000000
mean     0.471876   33.240885    0.348958
std      0.331329   11.760232    0.476951
min      0.078000   21.000000    0.000000
25%      0.243750   24.000000    0.000000
50%      0.372500   29.000000    0.000000
75%      0.626250   41.000000    1.000000
max      2.420000   81.000000    1.000000
Anda mungkin sudah memperhatikan bahwa nama kolom di sini berupa angka. Ini karena Anda menggunakan dataset yang sudah dipraproses. Tapi jangan khawatir, Anda akan mengetahui namanya segera.
Sekarang, dataset ini diketahui memiliki nilai hilang, namun sekilas dari statistik di atas, seolah-olah dataset tidak berisi nilai hilang sama sekali. Namun jika Anda melihat lebih dekat, Anda akan menemukan bahwa ada beberapa kolom di mana nilai nol sama sekali tidak valid. Nilai-nilai inilah yang hilang.
Secara khusus, kolom di bawah ini memiliki nilai nol tidak valid sebagai nilai minimum:
Mari konfirmasi ini dengan melihat data mentah, contoh berikut mencetak 20 baris pertama data.
data.head(20)
| 0 | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | |
|---|---|---|---|---|---|---|---|---|---|
| 0 | 6 | 148 | 72 | 35 | 0 | 33.6 | 0.627 | 50 | 1 |
| 1 | 1 | 85 | 66 | 29 | 0 | 26.6 | 0.351 | 31 | 0 |
| 2 | 8 | 183 | 64 | 0 | 0 | 23.3 | 0.672 | 32 | 1 |
| 3 | 1 | 89 | 66 | 23 | 94 | 28.1 | 0.167 | 21 | 0 |
| 4 | 0 | 137 | 40 | 35 | 168 | 43.1 | 2.288 | 33 | 1 |
| 5 | 5 | 116 | 74 | 0 | 0 | 25.6 | 0.201 | 30 | 0 |
| 6 | 3 | 78 | 50 | 32 | 88 | 31.0 | 0.248 | 26 | 1 |
| 7 | 10 | 115 | 0 | 0 | 0 | 35.3 | 0.134 | 29 | 0 |
| 8 | 2 | 197 | 70 | 45 | 543 | 30.5 | 0.158 | 53 | 1 |
| 9 | 8 | 125 | 96 | 0 | 0 | 0.0 | 0.232 | 54 | 1 |
| 10 | 4 | 110 | 92 | 0 | 0 | 37.6 | 0.191 | 30 | 0 |
| 11 | 10 | 168 | 74 | 0 | 0 | 38.0 | 0.537 | 34 | 1 |
| 12 | 10 | 139 | 80 | 0 | 0 | 27.1 | 1.441 | 57 | 0 |
| 13 | 1 | 189 | 60 | 23 | 846 | 30.1 | 0.398 | 59 | 1 |
| 14 | 5 | 166 | 72 | 19 | 175 | 25.8 | 0.587 | 51 | 1 |
| 15 | 7 | 100 | 0 | 0 | 0 | 30.0 | 0.484 | 32 | 1 |
| 16 | 0 | 118 | 84 | 47 | 230 | 45.8 | 0.551 | 31 | 1 |
| 17 | 7 | 107 | 74 | 0 | 0 | 29.6 | 0.254 | 31 | 1 |
| 18 | 1 | 103 | 30 | 38 | 83 | 43.3 | 0.183 | 33 | 0 |
| 19 | 1 | 115 | 70 | 30 | 96 | 34.6 | 0.529 | 32 | 1 |
Jelas terdapat nilai 0 pada kolom 2, 3, 4, dan 5.
Karena dataset ini memiliki nilai hilang yang dinyatakan sebagai 0, maka akan sedikit rumit untuk menanganinya hanya dengan cara konvensional. Mari kita ringkas pendekatan yang akan Anda ikuti untuk mengatasinya:
NaN.# Step 1: Get the count of zeros in each of the columns
print((data[[1,2,3,4,5]] == 0).sum())
1      5
2     35
3    227
4    374
5     11
dtype: int64
Anda dapat melihat bahwa kolom 1, 2, dan 5 hanya memiliki beberapa nilai nol, sedangkan kolom 3 dan 4 menunjukkan jauh lebih banyak, hampir setengah dari baris.
# Step -2: Mark zero values as missing or NaN
data[[1,2,3,4,5]] = data[[1,2,3,4,5]].replace(0, np.NaN)

# Count the number of NaN values in each column
print(data.isnull().sum())
0      0
1      5
2     35
3    227
4    374
5     11
6      0
7      0
8      0
dtype: int64
Mari pastikan pada tahap ini bahwa penggantian NaN berhasil dengan melihat dataset secara keseluruhan:
# Step 4
data.head(20)
| 0 | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | |
|---|---|---|---|---|---|---|---|---|---|
| 0 | 6 | 148.0 | 72.0 | 35.0 | NaN | 33.6 | 0.627 | 50 | 1 |
| 1 | 1 | 85.0 | 66.0 | 29.0 | NaN | 26.6 | 0.351 | 31 | 0 |
| 2 | 8 | 183.0 | 64.0 | NaN | NaN | 23.3 | 0.672 | 32 | 1 |
| 3 | 1 | 89.0 | 66.0 | 23.0 | 94.0 | 28.1 | 0.167 | 21 | 0 |
| 4 | 0 | 137.0 | 40.0 | 35.0 | 168.0 | 43.1 | 2.288 | 33 | 1 |
| 5 | 5 | 116.0 | 74.0 | NaN | NaN | 25.6 | 0.201 | 30 | 0 |
| 6 | 3 | 78.0 | 50.0 | 32.0 | 88.0 | 31.0 | 0.248 | 26 | 1 |
| 7 | 10 | 115.0 | NaN | NaN | NaN | 35.3 | 0.134 | 29 | 0 |
| 8 | 2 | 197.0 | 70.0 | 45.0 | 543.0 | 30.5 | 0.158 | 53 | 1 |
| 9 | 8 | 125.0 | 96.0 | NaN | NaN | NaN | 0.232 | 54 | 1 |
| 10 | 4 | 110.0 | 92.0 | NaN | NaN | 37.6 | 0.191 | 30 | 0 |
| 11 | 10 | 168.0 | 74.0 | NaN | NaN | 38.0 | 0.537 | 34 | 1 |
| 12 | 10 | 139.0 | 80.0 | NaN | NaN | 27.1 | 1.441 | 57 | 0 |
| 13 | 1 | 189.0 | 60.0 | 23.0 | 846.0 | 30.1 | 0.398 | 59 | 1 |
| 14 | 5 | 166.0 | 72.0 | 19.0 | 175.0 | 25.8 | 0.587 | 51 | 1 |
| 15 | 7 | 100.0 | NaN | NaN | NaN | 30.0 | 0.484 | 32 | 1 |
| 16 | 0 | 118.0 | 84.0 | 47.0 | 230.0 | 45.8 | 0.551 | 31 | 1 |
| 17 | 7 | 107.0 | 74.0 | NaN | NaN | 29.6 | 0.254 | 31 | 1 |
| 18 | 1 | 103.0 | 30.0 | 38.0 | 83.0 | 43.3 | 0.183 | 33 | 0 |
| 19 | 1 | 115.0 | 70.0 | 30.0 | 96.0 | 34.6 | 0.529 | 32 | 1 |
Anda dapat melihat bahwa penandaan nilai hilang memberikan efek yang diinginkan.
Sampai saat ini, Anda menganalisis tren esensial ketika data hilang dan bagaimana Anda dapat memanfaatkan ukuran statistik sederhana untuk menanganinya. Sekarang, Anda akan mengimputasi nilai hilang menggunakan Imputasi Rata-rata (Mean) yang pada dasarnya mengimputasi rata-rata kolom masing-masing menggantikan nilai hilang.
# Step 5: Call the fillna() function with the imputation strategy
data.fillna(data.mean(), inplace=True)

# Count the number of NaN values in each column to verify
print(data.isnull().sum())
0    0
1    0
2    0
3    0
4    0
5    0
6    0
7    0
8    0
dtype: int64
Bagus!
Artikel DataCamp ini secara efektif memandu Anda menerapkan penskalaan data sebagai langkah prapemrosesan data. Pastikan untuk memeriksanya.
Selanjutnya, Anda akan melakukan pengodean variabel.
Sebelumnya, Anda membutuhkan dataset yang benar-benar berisi data non-numerik. Anda akan menggunakan Iris dataset yang terkenal untuk ini.
# Load the dataset to a DataFrame object iris
iris = pd.read_csv("http://archive.ics.uci.edu/ml/machine-learning-databases/iris/iris.data",header=None)
# See first 20 rows of the dataset
iris.head(20)
| 0 | 1 | 2 | 3 | 4 | |
|---|---|---|---|---|---|
| 0 | 5.1 | 3.5 | 1.4 | 0.2 | Iris-setosa |
| 1 | 4.9 | 3.0 | 1.4 | 0.2 | Iris-setosa |
| 2 | 4.7 | 3.2 | 1.3 | 0.2 | Iris-setosa |
| 3 | 4.6 | 3.1 | 1.5 | 0.2 | Iris-setosa |
| 4 | 5.0 | 3.6 | 1.4 | 0.2 | Iris-setosa |
| 5 | 5.4 | 3.9 | 1.7 | 0.4 | Iris-setosa |
| 6 | 4.6 | 3.4 | 1.4 | 0.3 | Iris-setosa |
| 7 | 5.0 | 3.4 | 1.5 | 0.2 | Iris-setosa |
| 8 | 4.4 | 2.9 | 1.4 | 0.2 | Iris-setosa |
| 9 | 4.9 | 3.1 | 1.5 | 0.1 | Iris-setosa |
| 10 | 5.4 | 3.7 | 1.5 | 0.2 | Iris-setosa |
| 11 | 4.8 | 3.4 | 1.6 | 0.2 | Iris-setosa |
| 12 | 4.8 | 3.0 | 1.4 | 0.1 | Iris-setosa |
| 13 | 4.3 | 3.0 | 1.1 | 0.1 | Iris-setosa |
| 14 | 5.8 | 4.0 | 1.2 | 0.2 | Iris-setosa |
| 15 | 5.7 | 4.4 | 1.5 | 0.4 | Iris-setosa |
| 16 | 5.4 | 3.9 | 1.3 | 0.4 | Iris-setosa |
| 17 | 5.1 | 3.5 | 1.4 | 0.3 | Iris-setosa |
| 18 | 5.7 | 3.8 | 1.7 | 0.3 | Iris-setosa |
| 19 | 5.1 | 3.8 | 1.5 | 0.3 | Iris-setosa |
Anda dapat dengan mudah mengonversi nilai string menjadi nilai integer menggunakan LabelEncoder. Tiga nilai kelas (Iris-setosa, Iris-versicolor, Iris-virginica) dipetakan ke nilai integer (0, 1, 2).
Pada kasus ini, kolom/fitur keempat dari dataset berisi nilai non-numerik. Jadi Anda perlu memisahkannya.
# Convert the DataFrame to a NumPy array
iris = iris.values

# Separate
Y = iris[:,4]
# Label Encode string class values as integers
from sklearn.preprocessing import LabelEncoder

label_encoder = LabelEncoder()
label_encoder = label_encoder.fit(Y)
label_encoded_y = label_encoder.transform(Y)
Sekarang, mari pelajari area lain di mana kebutuhan akan pengetahuan dasar statistik sangat krusial.
Anda telah merancang dan mengembangkan model machine learning Anda. Kini, Anda ingin mengevaluasi kinerja model pada data uji. Dalam hal ini, Anda memanfaatkan berbagai metrik statistik seperti Precision, Recall, ROC, AUC, RMSE, dll. Anda juga memanfaatkan berbagai teknik resampling data seperti k-fold Cross-Validation.
Statistik dapat secara efektif digunakan untuk:
Penting untuk dicatat bahwa hipotesis mengacu pada model yang dipelajari; hasil dari menjalankan algoritma pembelajaran pada suatu dataset. Mengevaluasi dan membandingkan hipotesis berarti membandingkan model yang dipelajari, yang berbeda dari mengevaluasi dan membandingkan algoritma machine learning, yang bisa saja dilatih pada sampel berbeda dari masalah yang sama atau berbagai masalah.
Mari pelajari Gaussian dan statistik deskriptif sekarang.
Sebuah sampel data tidak lain adalah cuplikan dari populasi yang lebih luas dari semua potensi observasi yang dapat diambil dari suatu domain atau dihasilkan oleh suatu proses.
Menariknya, banyak observasi mengikuti pola atau distribusi khas yang disebut distribusi normal, atau lebih formalnya, distribusi Gaussian. Ini adalah distribusi berbentuk lonceng yang mungkin sudah Anda kenal. Gambar berikut menunjukkan distribusi Gaussian:
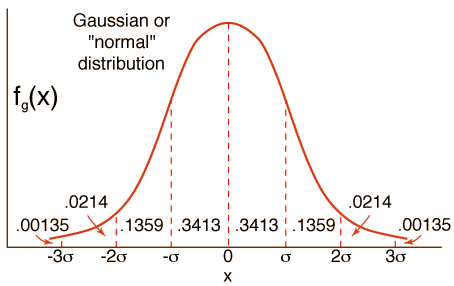
Sumber: HyperPhysics
Proses Gaussian dan distribusi Gaussian adalah subbidang tersendiri. Namun, Anda sekarang akan mempelajari dua bahan paling esensial yang membangun keseluruhan dunia distribusi Gaussian secara umum.
Setiap data sampel yang diambil dari distribusi Gaussian dapat diringkas dengan dua parameter:
Istilah varians juga melahirkan istilah penting lainnya, yaitu simpangan baku, yang merupakan akar kuadrat dari varians.
Mean, varians, dan simpangan baku dapat dihitung langsung dari sampel data menggunakan numpy.
Anda akan terlebih dahulu menghasilkan sampel berisi 100 angka acak yang diambil dari distribusi Gaussian dengan mean 50 dan simpangan baku 5. Anda kemudian akan menghitung statistik ringkasnya.
Pertama, Anda akan mengimpor semua dependensi.
#  Dependencies
from numpy.random import seed
from numpy.random import randn
from numpy import mean
from numpy import var
from numpy import std
Selanjutnya, Anda menetapkan seed generator angka acak agar hasil Anda dapat direproduksi.
seed(1)
# Generate univariate observations
data = 5 * randn(10000) + 50
# Calculate statistics
print('Mean: %.3f' % mean(data))
print('Variance: %.3f' % var(data))
print('Standard Deviation: %.3f' % std(data))
Mean: 50.049
Variance: 24.939
Standard Deviation: 4.994
Cukup dekat, ya?
Mari pelajari topik berikutnya sekarang.
Secara umum, fitur-fitur dalam suatu dataset sering kali saling berkaitan, yang sangat wajar terjadi dalam praktik. Dalam istilah statistik, hubungan antara fitur-fitur dalam dataset Anda (sederhana atau kompleks) sering disebut sebagai korelasi.
Penting untuk mengetahui derajat korelasi fitur-fitur dalam suatu dataset. Langkah ini pada dasarnya berfungsi sebagai seleksi fitur yang berkaitan dengan pemilihan fitur terpenting dari sebuah dataset. Langkah ini adalah salah satu yang paling vital dalam pipeline machine learning standar karena dapat memberikan lonjakan akurasi yang besar dengan waktu yang lebih singkat.
Untuk pemahaman yang lebih baik dan tetap praktis, mari pahami mengapa fitur bisa saling berkaitan:
Korelasi antar fitur dapat berupa tiga jenis: - Korelasi positif di mana kedua fitur berubah ke arah yang sama, korelasi netral ketika tidak ada hubungan perubahan pada kedua fitur, korelasi negatif di mana kedua fitur berubah ke arah berlawanan.
Pengukuran korelasi membentuk dasar teknik seleksi fitur berbasis filter. Lihat artikel ini jika Anda ingin mempelajari lebih lanjut tentang seleksi fitur.
Anda dapat memodelkan secara matematis hubungan antara sampel dari dua variabel menggunakan metode statistik yang disebut koefisien korelasi Pearson, dinamai menurut pengembang metodenya, Karl Pearson.
Anda dapat menghitung skor korelasi Pearson menggunakan fungsi corr() dari pandas dengan parameter method sebagai pearson. Mari pelajari korelasi antar fitur pada dataset Pima Indians Diabetes yang Anda gunakan sebelumnya. Anda sudah memiliki datanya dalam bentuk yang baik.
# Data
data.head()
| 0 | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | |
|---|---|---|---|---|---|---|---|---|---|
| 0 | 6 | 148.0 | 72.0 | 35.00000 | 155.548223 | 33.6 | 0.627 | 50 | 1 |
| 1 | 1 | 85.0 | 66.0 | 29.00000 | 155.548223 | 26.6 | 0.351 | 31 | 0 |
| 2 | 8 | 183.0 | 64.0 | 29.15342 | 155.548223 | 23.3 | 0.672 | 32 | 1 |
| 3 | 1 | 89.0 | 66.0 | 23.00000 | 94.000000 | 28.1 | 0.167 | 21 | 0 |
| 4 | 0 | 137.0 | 40.0 | 35.00000 | 168.000000 | 43.1 | 2.288 | 33 | 1 |
# Create the matrix of correlation score between the features and the label
scoreTable = data.corr(method='pearson')
# Visulaize the matrix
data.corr(method='pearson').style.format("{:.2}").background_gradient(cmap=plt.get_cmap('coolwarm'), axis=1)

Anda dapat dengan jelas melihat korelasi Pearson antara semua fitur dan label pada dataset.
Pada bagian berikutnya, Anda akan mempelajari statistik non-parametrik.
Bagian besar dari bidang statistik dan metode statistik didedikasikan untuk data dengan distribusi yang diketahui.
Statistik non-parametrik berguna ketika tidak ada atau hanya sedikit informasi yang tersedia tentang parameter populasi. Uji non-parametrik tidak membuat asumsi tentang distribusi data.
Dalam kasus ketika Anda bekerja dengan data nonparametrik, metode statistik nonparametrik khusus dapat digunakan yang mengabaikan semua informasi tentang distribusi. Karena itu, metode ini sering disebut sebagai metode bebas distribusi.
Namun sebelum metode statistik nonparametrik dapat diterapkan, data harus dikonversi ke format peringkat (rank). Metode statistik yang mengharapkan data dalam format peringkat kadang-kadang disebut statistik peringkat. Contoh statistik peringkat dapat berupa korelasi peringkat dan uji hipotesis statistik peringkat. Memeringkat data persis seperti namanya.
Salah satu uji hipotesis statistik nonparametrik yang banyak digunakan untuk memeriksa perbedaan antara dua sampel independen adalah uji Mann-Whitney U, dinamai menurut Henry Mann dan Donald Whitney.
Anda akan mengimplementasikan uji ini di Python melalui mannwhitneyu() yang disediakan oleh SciPy.
# The dependencies that you need
from scipy.stats import mannwhitneyu
from numpy.random import rand

# seed the random number generator
seed(1)
# Generate two independent samples
data1 = 50 + (rand(100) * 10)
data2 = 51 + (rand(100) * 10)
# Compare samples
stat, p = mannwhitneyu(data1, data2)
print('Statistics = %.3f, p = %.3f' % (stat, p))
# Interpret
alpha = 0.05
if p > alpha:
    print('Same distribution (fail to reject H0)')
else:
    print('Different distribution (reject H0)')
Statistics = 4077.000, p = 0.012
Different distribution (reject H0)
alpha adalah parameter ambang yang diputuskan oleh Anda. Fungsi mannwhitneyu() mengembalikan dua hal:
statistic: Statistik Mann-Whitney U, sama dengan min(U untuk x, U untuk y) jika alternative bernilai None (tidak disarankan; ada untuk kompatibilitas mundur), dan U untuk y jika tidak.
pvalue: p-value dengan asumsi distribusi normal asimtotik.
Jika Anda ingin mempelajari metode lain dari statistik non-parametrik, Anda dapat melakukannya dari sini.
Dua uji signifikansi statistik non-parametrik populer lainnya yang dapat Anda gunakan adalah:
Akhirnya Anda sampai di penghujung. Dalam artikel ini, Anda mempelajari berbagai konsep statistik esensial yang berperan sangat krusial dalam proyek machine learning Anda. Jadi, memahaminya memang penting.
Dari sekadar pengenalan statistik, Anda melangkah ke pemeringkatan statistik dengan beberapa implementasi. Itu jelas sebuah pencapaian. Anda mempelajari tiga dataset berbeda, memaksimalkan fungsionalitas pandas dan numpy dan terlebih lagi, Anda juga menggunakan SciPy. Berikut beberapa tautan untuk Anda jika ingin melangkah lebih jauh:
Berikut adalah sumber daya yang saya gunakan untuk menulis blog ini:
Beri tahu saya pendapat/pertanyaan Anda di kolom komentar. Juga, lihat kursus DataCamp "Statistical Thinking in Python" yang sangat selaras dengan praktik.
Kursus Python
Kursus
Kursus
Kursus
blogs
David Woods
13 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
Dario Radečić
15 mnt
blogs
Javier Canales Luna
14 mnt



