Curso
Introdução ao Python
4 h
7M
Se você tem pouca experiência aplicando algoritmos de machine learning, já deve ter percebido que eles não exigem Estatística como pré-requisito.
Mesmo assim, conhecer um pouco de estatística ajuda muito a entender machine learning de forma técnica e também intuitiva. Esse conhecimento acaba sendo necessário quando você quiser validar e interpretar seus resultados. Afinal, onde existe dado, existe estatística. Assim como a Matemática é a linguagem da Ciência, a Estatística é uma linguagem essencial para Data Science e Machine Learning.
Estatística é um ramo da matemática com muitas teorias e descobertas. Diversos conceitos, ferramentas, técnicas e notações desse campo foram incorporados para tornar o machine learning o que ele é hoje. Você pode usar métodos estatísticos descritivos para transformar observações em informações úteis que você entende e consegue compartilhar. Pode usar técnicas inferenciais para extrapolar de pequenas amostras para um domínio inteiro. Mais adiante, você vai ver estatística descritiva e inferencial. Então, sem stress.
Antes de começar, veja dez exemplos de onde métodos estatísticos entram em um projeto prático de machine learning:
Fonte: Statistical Methods for Machine Learning
Interessante, né?
Este post vai te dar uma base sólida no essencial de estatística para você se tornar um bom profissional de machine learning.
Neste post, você vai ver:
Tem bastante coisa pela frente, e todos os tópicos são importantes. Vamos nessa!
Vamos entender rapidamente como definir estatística em termos simples.
Estatística é um subcampo da matemática. Ela reúne um conjunto de métodos para trabalhar com dados e usá-los para responder a muitos tipos de perguntas.
Quando falamos das ferramentas estatísticas usadas na prática, é útil dividir o campo em dois grandes grupos de métodos: estatística descritiva, para resumir dados, e estatística inferencial, para tirar conclusões a partir de amostras (Statistics for Machine Learning (7-Day Mini-Course)).

Fonte: IntellSpot
Estatística inferencial: reúne métodos para quantificar propriedades de um domínio ou população a partir de um conjunto menor de observações, chamado amostra. O infográfico abaixo explica bem a estatística inferencial:
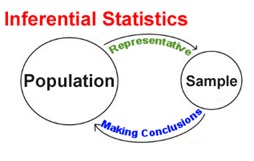
Fonte: Analytics Vidhya
Na próxima seção, você vai ver o uso de estatística na preparação de dados.
Métodos estatísticos são necessários ao desenvolver os dados de treino e teste do seu modelo de machine learning.
Isso inclui técnicas para:
Um entendimento básico de distribuições, estatísticas descritivas e visualização de dados ajuda a escolher os métodos adequados para cada tarefa.
Vamos analisar rapidamente cada ponto.
Primeiro, o que é um outlier?
Um outlier é uma observação que parece se desviar das demais observações da amostra. A figura a seguir deixa a definição mais clara.

Fonte: MathWorks
Você consegue identificar os outliers nos dados como mostrado acima.
Muitos algoritmos de machine learning são sensíveis ao intervalo e à distribuição dos valores dos atributos de entrada. Outliers podem distorcer e confundir o processo de treino, resultando em tempos mais longos, modelos menos precisos e, no fim, resultados piores.
Identificar outliers potenciais é vital pelos seguintes motivos:
Um outlier pode indicar dado ruim. Por exemplo, dado codificado errado ou experimento com falha. Se você determinar que um ponto discrepante é de fato um erro, remova-o da análise. Se for possível corrigi-lo, melhor ainda.
Em alguns casos, não dá para saber se um outlier é um dado ruim. Outliers podem ser variação aleatória ou algo cientificamente interessante. Em geral, você não deve simplesmente deletá-los. Mas, se houver outliers significativos, considere usar técnicas estatísticas robustas.
Ou seja, outliers costumam atrapalhar modelos preditivos (embora às vezes possam ser aproveitados — mas isso foge do escopo deste post). Você precisa do conhecimento estatístico para tratá-los bem.
Muitos conjuntos de dados sofrem com valores ausentes. Seu modelo pode não treinar bem se os dados de entrada tiverem lacunas. Ferramentas e técnicas estatísticas entram aqui para te salvar.
Muita gente descarta instâncias com valores ausentes. Não é boa prática: você pode perder características importantes dos dados. Embora existam métodos avançados para lidar com isso, duas técnicas rápidas e comuns são: imputação pela média e imputação pela mediana.
É fundamental entender média e mediana.
Suponha que você tenha a feature X1 com estes valores - 13, 18, 13, 14, 13, 16, 14, 21, 13
A média é a usual: some e depois divida:
(13 + 18 + 13 + 14 + 13 + 16 + 14 + 21 + 13) / 9 = 15
Note que a média, neste caso, não é um valor da lista original. Isso é comum. Não assuma que a média será um dos números originais.
A mediana é o valor central, então primeiro ordene a lista:
13, 13, 13, 13, 14, 14, 16, 18, 21
Há nove números, então o central é o (9 + 1) / 2 = 10 / 2 = 5º número:
13, 13, 13, 13, 14, 14, 16, 18, 21
A mediana é 14.
Dados são a moeda do machine learning aplicado. Por isso, coletá-los e usá-los bem é igualmente importante.
Amostragem se refere a métodos estatísticos para selecionar observações do domínio com o objetivo de estimar um parâmetro populacional. Em outras palavras, é o processo ativo de coletar observações para estimar uma variável da população.
Cada linha de um dataset representa uma observação indicativa de uma população. Na prática, você raramente tem acesso a todas as observações possíveis. Motivos comuns:
Muitas vezes, as proporções entre classes ficam desbalanceadas. Então você pode fazer under-sampling ou over-sampling, conforme o problema.
No under-sampling, quando uma classe tem amostras demais, você reduz essa classe descartando parte das amostras. No over-sampling, quando uma classe tem poucas amostras, você aumenta essa classe gerando novas amostras.
Isso também vale para cenários multiclasse.
Amostragem estatística é um campo amplo, mas, em ML aplicado, três tipos aparecem bastante: amostragem aleatória simples, amostragem sistemática e amostragem estratificada.
Embora essas sejam as mais comuns, existem outras técnicas (A Gentle Introduction to Statistical Sampling and Resampling).
Frequentemente, as features do seu dataset têm faixas muito diferentes. Algumas variam de 0 a 100, outras de 0,01 a 0,001, 10000 a 20000, etc.
Isso atrapalha a modelagem. Uma mudança pequena em uma feature de baixa escala pode não ter impacto frente a outra de alta escala. Isso prejudica o aprendizado. Tratar esse problema é o escalonamento de dados.
Existem técnicas como Min-Max scaling, escalonamento absoluto, padronização, entre outras.
Às vezes, seus dados misturam valores numéricos e não numéricos. Muitos frameworks, como o scikit-learn, esperam tudo em formato numérico, o que também acelera o processamento.
De novo, a estatística te ajuda.
Técnicas como Label Encoding e One-Hot Encoding convertem dados não numéricos em numéricos.
Você viu bastante teoria. Agora vamos aplicar algumas coisas para sentir na prática.
Comece aplicando métodos estatísticos para detectar outliers.
Vamos usar o índice de Z-Score para detectar outliers, investigando o Boston House Price dataset. Vamos importar o dataset pelas utilidades do sklearn e, no caminho, revisar os conceitos necessários.
import pandas as pd
import numpy as np
from sklearn.datasets import load_boston

# Load the Boston dataset into a variable called boston
boston = load_boston()
# Separate the features from the target
x = boston.data
y = boston.target
Para ver o dataset em formato tabular padrão com os nomes das features, vamos convertê-lo em um dataframe do pandas.
# Take the columns separately in a variable
columns = boston.feature_names

# Create the dataframe
boston_df = pd.DataFrame(boston.data)
boston_df.columns = columns
boston_df.head()

É comum começar com análise univariada de outliers, olhando uma feature por vez. Um boxplot simples de uma feature já dá um bom ponto de partida. Vamos fazer um boxplot com seaborn usando a feature DIS.
import seaborn as sns
sns.boxplot(x=boston_df['DIS'])

import matplotlib.pyplot as plt
plt.show()
<matplotlib.axes._subplots.AxesSubplot at 0x8abded0>

Para exibir o boxplot, importamos matplotlib, já que os gráficos do seaborn são exibidos como plots do matplotlib.
O gráfico mostra três pontos entre 10 e 12; são outliers, pois estão fora da “caixa” das demais observações. Aqui você analisou outliers univariados, isto é, usou apenas a feature DIS.
Vamos ao Z-Score.
"O Z-score é o número assinado de desvios-padrão pelo qual o valor de uma observação está acima (ou abaixo) da média do que está sendo medido." - Wikipedia
A ideia é descrever qualquer ponto de dado em relação à média e ao desvio-padrão do grupo. O Z-score reescala e centraliza os dados (média 0 e desvio-padrão 1), aproximando de uma distribuição normal.
Mas como isso ajuda a identificar outliers?
Ao calcular o Z-score, você centraliza e padroniza os dados e procura instâncias muito distantes de zero. Esses pontos muito distantes são tratados como outliers. Em geral, usa-se o limite 3 ou -3. Por exemplo, se o Z-score for maior que 3 ou menor que -3, o ponto é identificado como outlier.
Vamos usar a função Z-score da biblioteca scipy para detectar outliers.
from scipy import stats

z = np.abs(stats.zscore(boston_df))
print(z)
[[0.41771335 0.28482986 1.2879095  ... 1.45900038 0.44105193 1.0755623 ]
 [0.41526932 0.48772236 0.59338101 ... 0.30309415 0.44105193 0.49243937]
 [0.41527165 0.48772236 0.59338101 ... 0.30309415 0.39642699 1.2087274 ]
 ...
 [0.41137448 0.48772236 0.11573841 ... 1.17646583 0.44105193 0.98304761]
 [0.40568883 0.48772236 0.11573841 ... 1.17646583 0.4032249  0.86530163]
 [0.41292893 0.48772236 0.11573841 ... 1.17646583 0.44105193 0.66905833]]
Não dá para achar outliers só olhando o output. Vamos definir um limiar e usar uma condição simples para achar valores que o ultrapassem.
threshold = 3
print(np.where(z > 3))
(array([ 55,  56,  57, 102, 141, 142, 152, 154, 155, 160, 162, 163, 199,
       200, 201, 202, 203, 204, 208, 209, 210, 211, 212, 216, 218, 219,
       220, 221, 222, 225, 234, 236, 256, 257, 262, 269, 273, 274, 276,
       277, 282, 283, 283, 284, 347, 351, 352, 353, 353, 354, 355, 356,
       357, 358, 363, 364, 364, 365, 367, 369, 370, 372, 373, 374, 374,
       380, 398, 404, 405, 406, 410, 410, 411, 412, 412, 414, 414, 415,
       416, 418, 418, 419, 423, 424, 425, 426, 427, 427, 429, 431, 436,
       437, 438, 445, 450, 454, 455, 456, 457, 466], dtype=int32), array([ 1,  1,  1, 11, 12,  3,  3,  3,  3,  3,  3,  3,  1,  1,  1,  1,  1,
        1,  3,  3,  3,  3,  3,  3,  3,  3,  3,  3,  3,  5,  3,  3,  1,  5,
        5,  3,  3,  3,  3,  3,  3,  1,  3,  1,  1,  7,  7,  1,  7,  7,  7,
        3,  3,  3,  3,  3,  5,  5,  5,  3,  3,  3, 12,  5, 12,  0,  0,  0,
        0,  5,  0, 11, 11, 11, 12,  0, 12, 11, 11,  0, 11, 11, 11, 11, 11,
       11,  0, 11, 11, 11, 11, 11, 11, 11, 11, 11, 11, 11, 11, 11],
      dtype=int32))
De novo, a saída é pouco amigável. O primeiro array traz as linhas, e o segundo, as colunas. Por exemplo, z[55][1] tem Z-score maior que 3.
print(z[55][1])
3.375038763517309
Logo, o 55º registro na coluna ZN é um outlier. Você pode estender a análise a partir daqui.
Viu como usar Z-Score e um limiar para detectar potenciais outliers. Agora, vamos ver imputação de valores ausentes.
Vamos usar o famoso dataset Pima Indian Diabetes, conhecido por conter valores ausentes. Primeiro, carregue o dataset no seu ambiente.
Carregue-o em um DataFrame chamado data.
data = pd.read_csv("https://raw.githubusercontent.com/jbrownlee/Datasets/master/pima-indians-diabetes.data.csv",header=None)
print(data.describe())
                0           1           2           3           4           5  \
count  768.000000  768.000000  768.000000  768.000000  768.000000  768.000000
mean     3.845052  120.894531   69.105469   20.536458   79.799479   31.992578
std      3.369578   31.972618   19.355807   15.952218  115.244002    7.884160
min      0.000000    0.000000    0.000000    0.000000    0.000000    0.000000
25%      1.000000   99.000000   62.000000    0.000000    0.000000   27.300000
50%      3.000000  117.000000   72.000000   23.000000   30.500000   32.000000
75%      6.000000  140.250000   80.000000   32.000000  127.250000   36.600000
max     17.000000  199.000000  122.000000   99.000000  846.000000   67.100000

                6           7           8
count  768.000000  768.000000  768.000000
mean     0.471876   33.240885    0.348958
std      0.331329   11.760232    0.476951
min      0.078000   21.000000    0.000000
25%      0.243750   24.000000    0.000000
50%      0.372500   29.000000    0.000000
75%      0.626250   41.000000    1.000000
max      2.420000   81.000000    1.000000
Você deve ter notado que os nomes das colunas são numéricos — o dataset já veio pré-processado. Sem problemas: já já descobrimos o que é o quê.
Este dataset é conhecido por ter valores ausentes, mas à primeira vista parece não haver. Olhando com atenção, há colunas em que zero é um valor totalmente inválido. Esses zeros representam ausências.
Especificamente, as colunas abaixo têm mínimo igual a zero, o que é inválido:
Vamos confirmar olhando os dados brutos — abaixo estão as primeiras 20 linhas.
data.head(20)
| 0 | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | |
|---|---|---|---|---|---|---|---|---|---|
| 0 | 6 | 148 | 72 | 35 | 0 | 33.6 | 0.627 | 50 | 1 |
| 1 | 1 | 85 | 66 | 29 | 0 | 26.6 | 0.351 | 31 | 0 |
| 2 | 8 | 183 | 64 | 0 | 0 | 23.3 | 0.672 | 32 | 1 |
| 3 | 1 | 89 | 66 | 23 | 94 | 28.1 | 0.167 | 21 | 0 |
| 4 | 0 | 137 | 40 | 35 | 168 | 43.1 | 2.288 | 33 | 1 |
| 5 | 5 | 116 | 74 | 0 | 0 | 25.6 | 0.201 | 30 | 0 |
| 6 | 3 | 78 | 50 | 32 | 88 | 31.0 | 0.248 | 26 | 1 |
| 7 | 10 | 115 | 0 | 0 | 0 | 35.3 | 0.134 | 29 | 0 |
| 8 | 2 | 197 | 70 | 45 | 543 | 30.5 | 0.158 | 53 | 1 |
| 9 | 8 | 125 | 96 | 0 | 0 | 0.0 | 0.232 | 54 | 1 |
| 10 | 4 | 110 | 92 | 0 | 0 | 37.6 | 0.191 | 30 | 0 |
| 11 | 10 | 168 | 74 | 0 | 0 | 38.0 | 0.537 | 34 | 1 |
| 12 | 10 | 139 | 80 | 0 | 0 | 27.1 | 1.441 | 57 | 0 |
| 13 | 1 | 189 | 60 | 23 | 846 | 30.1 | 0.398 | 59 | 1 |
| 14 | 5 | 166 | 72 | 19 | 175 | 25.8 | 0.587 | 51 | 1 |
| 15 | 7 | 100 | 0 | 0 | 0 | 30.0 | 0.484 | 32 | 1 |
| 16 | 0 | 118 | 84 | 47 | 230 | 45.8 | 0.551 | 31 | 1 |
| 17 | 7 | 107 | 74 | 0 | 0 | 29.6 | 0.254 | 31 | 1 |
| 18 | 1 | 103 | 30 | 38 | 83 | 43.3 | 0.183 | 33 | 0 |
| 19 | 1 | 115 | 70 | 30 | 96 | 34.6 | 0.529 | 32 | 1 |
Claramente há valores 0 nas colunas 2, 3, 4 e 5.
Como o dataset marca ausências com 0, tratá-las só com técnicas convencionais pode ser traiçoeiro. Vamos resumir a abordagem:
NaN nessas colunas.fillna() com a estratégia de imputação.# Step 1: Get the count of zeros in each of the columns
print((data[[1,2,3,4,5]] == 0).sum())
1      5
2     35
3    227
4    374
5     11
dtype: int64
Vemos que as colunas 1, 2 e 5 têm poucos zeros, enquanto 3 e 4 têm bem mais — quase metade das linhas.
# Step -2: Mark zero values as missing or NaN
data[[1,2,3,4,5]] = data[[1,2,3,4,5]].replace(0, np.NaN)

# Count the number of NaN values in each column
print(data.isnull().sum())
0      0
1      5
2     35
3    227
4    374
5     11
6      0
7      0
8      0
dtype: int64
Vamos garantir que a substituição por NaN funcionou olhando o dataset:
# Step 4
data.head(20)
| 0 | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | |
|---|---|---|---|---|---|---|---|---|---|
| 0 | 6 | 148.0 | 72.0 | 35.0 | NaN | 33.6 | 0.627 | 50 | 1 |
| 1 | 1 | 85.0 | 66.0 | 29.0 | NaN | 26.6 | 0.351 | 31 | 0 |
| 2 | 8 | 183.0 | 64.0 | NaN | NaN | 23.3 | 0.672 | 32 | 1 |
| 3 | 1 | 89.0 | 66.0 | 23.0 | 94.0 | 28.1 | 0.167 | 21 | 0 |
| 4 | 0 | 137.0 | 40.0 | 35.0 | 168.0 | 43.1 | 2.288 | 33 | 1 |
| 5 | 5 | 116.0 | 74.0 | NaN | NaN | 25.6 | 0.201 | 30 | 0 |
| 6 | 3 | 78.0 | 50.0 | 32.0 | 88.0 | 31.0 | 0.248 | 26 | 1 |
| 7 | 10 | 115.0 | NaN | NaN | NaN | 35.3 | 0.134 | 29 | 0 |
| 8 | 2 | 197.0 | 70.0 | 45.0 | 543.0 | 30.5 | 0.158 | 53 | 1 |
| 9 | 8 | 125.0 | 96.0 | NaN | NaN | NaN | 0.232 | 54 | 1 |
| 10 | 4 | 110.0 | 92.0 | NaN | NaN | 37.6 | 0.191 | 30 | 0 |
| 11 | 10 | 168.0 | 74.0 | NaN | NaN | 38.0 | 0.537 | 34 | 1 |
| 12 | 10 | 139.0 | 80.0 | NaN | NaN | 27.1 | 1.441 | 57 | 0 |
| 13 | 1 | 189.0 | 60.0 | 23.0 | 846.0 | 30.1 | 0.398 | 59 | 1 |
| 14 | 5 | 166.0 | 72.0 | 19.0 | 175.0 | 25.8 | 0.587 | 51 | 1 |
| 15 | 7 | 100.0 | NaN | NaN | NaN | 30.0 | 0.484 | 32 | 1 |
| 16 | 0 | 118.0 | 84.0 | 47.0 | 230.0 | 45.8 | 0.551 | 31 | 1 |
| 17 | 7 | 107.0 | 74.0 | NaN | NaN | 29.6 | 0.254 | 31 | 1 |
| 18 | 1 | 103.0 | 30.0 | 38.0 | 83.0 | 43.3 | 0.183 | 33 | 0 |
| 19 | 1 | 115.0 | 70.0 | 30.0 | 96.0 | 34.6 | 0.529 | 32 | 1 |
Perceba que marcar os valores ausentes funcionou como esperado.
Até aqui, você analisou tendências quando faltam dados e como usar medidas simples para lidar com isso. Agora, vamos imputar usando a média da coluna no lugar dos NaNs.
# Step 5: Call the fillna() function with the imputation strategy
data.fillna(data.mean(), inplace=True)

# Count the number of NaN values in each column to verify
print(data.isnull().sum())
0    0
1    0
2    0
3    0
4    0
5    0
6    0
7    0
8    0
dtype: int64
Perfeito!
Este artigo da DataCamp mostra como implementar escalonamento de dados no pré-processamento. Vale conferir.
Em seguida, vamos fazer codificação de variáveis.
Para isso, precisamos de um dataset com dados não numéricos. Vamos usar o famoso Iris dataset.
# Load the dataset to a DataFrame object iris
iris = pd.read_csv("http://archive.ics.uci.edu/ml/machine-learning-databases/iris/iris.data",header=None)
# See first 20 rows of the dataset
iris.head(20)
| 0 | 1 | 2 | 3 | 4 | |
|---|---|---|---|---|---|
| 0 | 5.1 | 3.5 | 1.4 | 0.2 | Iris-setosa |
| 1 | 4.9 | 3.0 | 1.4 | 0.2 | Iris-setosa |
| 2 | 4.7 | 3.2 | 1.3 | 0.2 | Iris-setosa |
| 3 | 4.6 | 3.1 | 1.5 | 0.2 | Iris-setosa |
| 4 | 5.0 | 3.6 | 1.4 | 0.2 | Iris-setosa |
| 5 | 5.4 | 3.9 | 1.7 | 0.4 | Iris-setosa |
| 6 | 4.6 | 3.4 | 1.4 | 0.3 | Iris-setosa |
| 7 | 5.0 | 3.4 | 1.5 | 0.2 | Iris-setosa |
| 8 | 4.4 | 2.9 | 1.4 | 0.2 | Iris-setosa |
| 9 | 4.9 | 3.1 | 1.5 | 0.1 | Iris-setosa |
| 10 | 5.4 | 3.7 | 1.5 | 0.2 | Iris-setosa |
| 11 | 4.8 | 3.4 | 1.6 | 0.2 | Iris-setosa |
| 12 | 4.8 | 3.0 | 1.4 | 0.1 | Iris-setosa |
| 13 | 4.3 | 3.0 | 1.1 | 0.1 | Iris-setosa |
| 14 | 5.8 | 4.0 | 1.2 | 0.2 | Iris-setosa |
| 15 | 5.7 | 4.4 | 1.5 | 0.4 | Iris-setosa |
| 16 | 5.4 | 3.9 | 1.3 | 0.4 | Iris-setosa |
| 17 | 5.1 | 3.5 | 1.4 | 0.3 | Iris-setosa |
| 18 | 5.7 | 3.8 | 1.7 | 0.3 | Iris-setosa |
| 19 | 5.1 | 3.8 | 1.5 | 0.3 | Iris-setosa |
Você pode converter facilmente strings para inteiros usando o LabelEncoder. As três classes (Iris-setosa, Iris-versicolor, Iris-virginica) são mapeadas para inteiros (0, 1, 2).
Neste caso, a quinta coluna/feature do dataset contém valores não numéricos. Então precisamos separá-la.
# Convert the DataFrame to a NumPy array
iris = iris.values

# Separate
Y = iris[:,4]
# Label Encode string class values as integers
from sklearn.preprocessing import LabelEncoder

label_encoder = LabelEncoder()
label_encoder = label_encoder.fit(Y)
label_encoded_y = label_encoder.transform(Y)
Agora, vamos ver outra área em que noções básicas de estatística são cruciais.
Você projetou e desenvolveu seu modelo. Agora quer avaliar o desempenho dele nos dados de teste. Para isso, usamos métricas estatísticas como Precisão (Precision), Revocação (Recall), ROC, AUC, RMSE etc. Também usamos técnicas de reamostragem como a validação cruzada k-fold.
A estatística pode ser usada para:
Importante: aqui, hipótese se refere a modelos aprendidos; os resultados de treinar um algoritmo em um dataset. Avaliar e comparar hipóteses significa comparar modelos aprendidos, o que é diferente de avaliar e comparar algoritmos de machine learning, que podem ser treinados em amostras ou problemas diferentes.
Vamos agora para Gaussiana e estatísticas descritivas.
Uma amostra de dados é um recorte de uma população maior de possíveis observações de um domínio ou processo.
Muitas observações seguem um padrão típico chamado distribuição normal, ou Gaussiana — o famoso formato de sino. A figura a seguir mostra uma distribuição gaussiana:
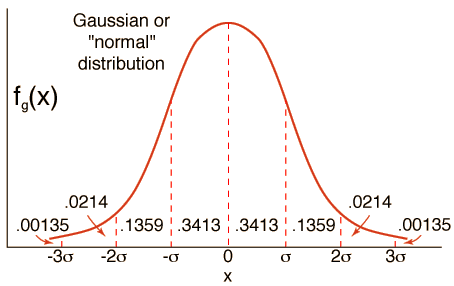
Fonte: HyperPhysics
Processos e distribuições gaussianas são um mundo à parte. Mas vamos ver dois ingredientes essenciais que sustentam esse universo.
Qualquer amostra vinda de uma Gaussiana pode ser resumida com dois parâmetros:
Da variância surge o desvio-padrão, que é apenas a raiz quadrada da variância.
Média, variância e desvio-padrão podem ser calculados diretamente de amostras com numpy.
Vamos gerar uma amostra de 10.000 números aleatórios de uma Gaussiana com média 50 e desvio-padrão 5 e calcular os resumos.
Primeiro, importe as dependências.
#  Dependencies
from numpy.random import seed
from numpy.random import randn
from numpy import mean
from numpy import var
from numpy import std
Agora, fixe a semente do gerador aleatório para reprodutibilidade.
seed(1)
# Generate univariate observations
data = 5 * randn(10000) + 50
# Calculate statistics
print('Mean: %.3f' % mean(data))
print('Variance: %.3f' % var(data))
print('Standard Deviation: %.3f' % std(data))
Mean: 50.049
Variance: 24.939
Standard Deviation: 4.994
Bem próximo do esperado, certo?
Vamos ao próximo tópico.
Em geral, as features de um dataset têm algum grau de relação entre si — o que é natural. Em termos estatísticos, essa relação é a correlação.
É importante descobrir o grau de correlação entre as features. Isso funciona como uma seleção de features, ajudando a escolher as mais relevantes. É uma etapa vital no pipeline de ML, pois pode aumentar muito a acurácia e ainda reduzir tempo.
Para entender melhor, veja por que features podem se relacionar:
A correlação pode ser de três tipos: positiva (ambas variam no mesmo sentido), nula (sem relação) e negativa (variando em sentidos opostos).
Medições de correlação são base de técnicas de seleção de features por filtro. Veja este artigo para saber mais.
Você pode medir a relação entre duas variáveis com o coeficiente de correlação de Pearson, desenvolvido por Karl Pearson.
No pandas, use corr() com method='pearson'. Vamos analisar a correlação no Pima Indians Diabetes que já está preparado.
# Data
data.head()
| 0 | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | |
|---|---|---|---|---|---|---|---|---|---|
| 0 | 6 | 148.0 | 72.0 | 35.00000 | 155.548223 | 33.6 | 0.627 | 50 | 1 |
| 1 | 1 | 85.0 | 66.0 | 29.00000 | 155.548223 | 26.6 | 0.351 | 31 | 0 |
| 2 | 8 | 183.0 | 64.0 | 29.15342 | 155.548223 | 23.3 | 0.672 | 32 | 1 |
| 3 | 1 | 89.0 | 66.0 | 23.00000 | 94.000000 | 28.1 | 0.167 | 21 | 0 |
| 4 | 0 | 137.0 | 40.0 | 35.00000 | 168.000000 | 43.1 | 2.288 | 33 | 1 |
# Create the matrix of correlation score between the features and the label
scoreTable = data.corr(method='pearson')
# Visulaize the matrix
data.corr(method='pearson').style.format("{:.2}").background_gradient(cmap=plt.get_cmap('coolwarm'), axis=1)

Você vê claramente a correlação de Pearson entre todas as features e o rótulo do dataset.
Na próxima seção, veremos estatística não paramétrica.
Uma grande parte da estatística trata de dados com distribuição conhecida.
A estatística não paramétrica ajuda quando há pouca ou nenhuma informação sobre os parâmetros da população. Testes não paramétricos não assumem distribuição específica dos dados.
Quando os dados são não paramétricos, métodos especializados descartam informações sobre a distribuição — por isso são chamados de métodos livres de distribuição.
Mas, antes de aplicar um método não paramétrico, os dados geralmente são convertidos para postos (ranks). Métodos que esperam dados ranqueados são chamados de estatísticas de postos. Exemplos incluem correlação por postos e testes de hipótese por postos. Ranqueamento é exatamente isso: ordenar e atribuir posições.
Um teste não paramétrico muito usado para verificar diferença entre duas amostras independentes é o teste U de Mann-Whitney, nomeado por Henry Mann e Donald Whitney.
Você pode implementá-lo em Python com mannwhitneyu() do SciPy.
# The dependencies that you need
from scipy.stats import mannwhitneyu
from numpy.random import rand

# seed the random number generator
seed(1)
# Generate two independent samples
data1 = 50 + (rand(100) * 10)
data2 = 51 + (rand(100) * 10)
# Compare samples
stat, p = mannwhitneyu(data1, data2)
print('Statistics = %.3f, p = %.3f' % (stat, p))
# Interpret
alpha = 0.05
if p > alpha:
    print('Same distribution (fail to reject H0)')
else:
    print('Different distribution (reject H0)')
Statistics = 4077.000, p = 0.012
Different distribution (reject H0)
alpha é o limiar que você define. A função mannwhitneyu() retorna:
statistic: a estatística U de Mann-Whitney, igual a min(U para x, U para y) se alternative for None (descontinuado; por compatibilidade), e U para y caso contrário.
pvalue: p-valor assumindo distribuição normal assintótica.
Para estudar outros métodos de estatística não paramétrica, veja aqui.
Outros dois testes populares de significância não paramétricos são:
Chegamos ao fim. Neste artigo, você revisou vários conceitos essenciais de estatística que têm papel crucial nos seus projetos de machine learning. Entendê-los é fundamental.
Da introdução à estatística até testes e ranqueamentos, com várias implementações. Foi e tanto. Você trabalhou com três datasets, explorou bastante pandas e numpy e ainda usou SciPy. Abaixo, alguns links para avançar:
Estes foram os recursos usados como base para este blog:
Deixe suas dúvidas e comentários abaixo. E confira o curso da DataCamp "Statistical Thinking in Python", com foco prático.
Cursos de Python
Curso
Curso
Curso
blog
Thaylise Nakamoto
9 min
Tutorial
Abid Ali Awan
6 min
Tutorial
Avinash Navlani
10 min
Tutorial
Moez Ali
14 min
Tutorial
Aditya Sharma
8 min
Tutorial
Moez Ali
9 min