कोर्स
Python परिचय
4 घंटा
7M
यदि आपके पास मशीन लर्निंग एल्गोरिद्म लागू करने का थोड़ा अनुभव है, तो आपने पाया होगा कि इसकी पूर्व-आवश्यकता के रूप में सांख्यिकी का ज्ञान अनिवार्य नहीं है।
फिर भी, कुछ सांख्यिकी जानना मशीन लर्निंग को तकनीकी और सहज, दोनों तरह से समझने में सहायक होता है। जब आप अपने परिणामों का वैधीकरण और उनकी व्याख्या करना शुरू करते हैं, तब अंततः सांख्यिकी की जरूरत पड़ती ही है। आखिरकार, जहां डेटा है, वहां सांख्यिकी है। जैसे गणित विज्ञान की भाषा है, वैसे ही सांख्यिकी डेटा साइंस और मशीन लर्निंग के लिए विशिष्ट भाषा है।
सांख्यिकी गणित का एक क्षेत्र है जिसमें बहुत-सी सिद्धांत और खोजें हैं। फिर भी, आज की मशीन लर्निंग को बनाने में इस क्षेत्र की कई अवधारणाएं, टूल, तकनीकें और संकेतन अपनाए गए हैं। आप विवरणात्मक (descriptive) सांख्यिकीय विधियों का उपयोग करके अवलोकनों को उपयोगी जानकारी में बदल सकते हैं जिसे आप समझ सकें और दूसरों के साथ साझा कर सकें। आप अनुमानात्मक (inferential) सांख्यिकीय तकनीकों का उपयोग करके छोटे सैंपल्स से पूरे डोमेन तक निष्कर्ष निकाल सकते हैं। आगे इस पोस्ट में, आप विवरणात्मक और अनुमानात्मक सांख्यिकी पढ़ेंगे। तो, चिंता न करें।
शुरू करने से पहले, आइए उन दस उदाहरणों से गुजरते हैं जहां किसी वास्तविक मशीन लर्निंग प्रोजेक्ट में सांख्यिकीय विधियों का उपयोग होता है:
स्रोत: Statistical Methods for Machine Learning
क्या यह रोचक नहीं है?
यह पोस्ट आपको उन आवश्यक परंतु बुनियादी सांख्यिकी का मजबूत आधार देगी जो एक अच्छे मशीन लर्निंग प्रैक्टिशनर बनने के लिए जरूरी हैं।
इस पोस्ट में, आप पढ़ेंगे:
आपके पास कवर करने के लिए बहुत कुछ है, और सभी विषय समान रूप से महत्वपूर्ण हैं। चलिए शुरुआत करते हैं!
आइए संक्षेप में समझते हैं कि सरल शब्दों में सांख्यिकी को कैसे परिभाषित करें।
सांख्यिकी गणित का एक उपक्षेत्र माना जाता है। यह डेटा के साथ काम करने और उस डेटा का उपयोग करके कई तरह के प्रश्नों के उत्तर देने की अनेक विधियों को संदर्भित करता है।
जब बात व्यावहारिक रूप से इस्तेमाल होने वाले सांख्यिकीय टूल्स की आती है, तो क्षेत्र को व्यापक रूप से दो समूहों में बांटना उपयोगी होता है: डेटा का सार प्रस्तुत करने के लिए विवरणात्मक सांख्यिकी, और डेटा के सैंपल्स से निष्कर्ष निकालने के लिए अनुमानात्मक सांख्यिकी (Statistics for Machine Learning (7-Day Mini-Course)).

स्रोत: IntellSpot
अनुमानात्मक सांख्यिकी: ऐसी विधियां जो डोमेन या जनसंख्या के गुणों को एक छोटे अवलोकनों के सेट (सैंपल) से परिमाणित करने में मदद करती हैं। नीचे एक इन्फ़ोग्राफिक है जो अनुमानात्मक सांख्यिकी को सुंदर ढंग से समझाता है:
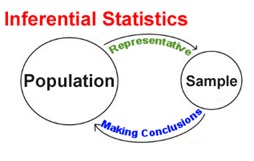
स्रोत: Analytics Vidhya
अगले खंड में, आप डेटा तैयारी के लिए सांख्यिकी का उपयोग पढ़ेंगे।
आपके मशीन लर्निंग मॉडल के लिए ट्रेन और टेस्ट डेटा के विकास में सांख्यिकीय विधियों की आवश्यकता होती है।
इसमें निम्नलिखित तकनीकें शामिल हैं:
डेटा वितरण, विवरणात्मक सांख्यिकी और डेटा विज़ुअलाइज़ेशन की बुनियादी समझ इन कार्यों के लिए उपयुक्त विधियों की पहचान करने में सहायक होती है।
आइए ऊपर दिए गए प्रत्येक बिंदु का संक्षेप में विश्लेषण करते हैं।
पहले देखते हैं कि आउट्लायर क्या होता है।
आउट्लायर वह अवलोकन माना जाता है जो सैंपल में अन्य अवलोकनों से विचलित प्रतीत होता है। निम्नलिखित चित्र इस परिभाषा को और स्पष्ट करता है।

स्रोत: MathWorks
ऊपर दिए चित्र के अनुसार आप डेटा में आउट्लायर देख सकते हैं।
कई मशीन लर्निंग एल्गोरिद्म इनपुट डेटा में एट्रिब्यूट मानों की रेंज और वितरण के प्रति संवेदनशील होते हैं। इनपुट डेटा में आउट्लायर ट्रेनिंग प्रक्रिया को विकृत कर सकते हैं, जिससे ट्रेनिंग समय बढ़ता है, मॉडल कम सटीक होते हैं और अंततः औसत से कम परिणाम मिलते हैं।
संभावित आउट्लायर की पहचान निम्न कारणों से महत्वपूर्ण है:
आउट्लायर यह संकेत कर सकता है कि डेटा खराब है। उदाहरण के लिए, डेटा गलत कोडित हो सकता है, या प्रयोग ठीक से नहीं चला। यदि यह निर्धारित किया जा सके कि आउट्लायर पॉइंट वास्तव में त्रुटिपूर्ण है, तो उसे विश्लेषण से हटा देना चाहिए। यदि उसे सुधारना संभव हो, तो वह भी एक विकल्प है।
कुछ मामलों में यह निर्धारित करना संभव नहीं होता कि आउट्लायर खराब डेटा पॉइंट है या नहीं। आउट्लायर यादृच्छिक भिन्नता के कारण हो सकते हैं या वैज्ञानिक रूप से रोचक किसी बात का संकेत दे सकते हैं। किसी भी स्थिति में, आप आम तौर पर आउट्लायर अवलोकन को बस हटा देना नहीं चाहेंगे। फिर भी, यदि डेटा में महत्वपूर्ण आउट्लायर हैं, तो आपको मजबूत (robust) सांख्यिकीय तकनीकों पर विचार करना पड़ सकता है।
तो, आउट्लायर अक्सर आपके प्रेडिक्टिव मॉडलों के लिए अच्छे नहीं होते (हालांकि, कभी-कभी इन्हें लाभ के रूप में भी इस्तेमाल किया जा सकता है, पर यह इस पोस्ट के दायरे से बाहर है)। आउट्लायर को कुशलतापूर्वक संभालने के लिए आपको सांख्यिकीय समझ की आवश्यकता है।
अधिकांश डेटासेट आजकल मिसिंग वैल्यू की समस्या से ग्रस्त होते हैं। यदि आपके द्वारा मॉडल को खिलाया जा रहा डेटा मिसिंग वैल्यू रखता है, तो आपका मशीन लर्निंग मॉडल प्रभावी रूप से प्रशिक्षित नहीं हो पाएगा। यहां सांख्यिकीय टूल और तकनीकें मदद में आती हैं।
कई लोग उन डेटा इंस्टेंस को त्याग देते हैं जिनमें मिसिंग वैल्यू होती है। पर यह अच्छी प्रैक्टिस नहीं है क्योंकि इस प्रक्रिया में आप डेटा की आवश्यक विशेषताएं/प्रतिनिधित्व खो सकते हैं। यद्यपि मिसिंग वैल्यू से निपटने के उन्नत तरीके मौजूद हैं, फिर भी ये तेज़ तकनीकें अक्सर अपनाई जाती हैं: Mean Imputation और Median Imputation।
यह समझना आवश्यक है कि मीन और मीडियन क्या होते हैं।
मान लीजिए, आपके पास एक फीचर X1 है जिसके मान हैं - 13, 18, 13, 14, 13, 16, 14, 21, 13
मीन सामान्य औसत होता है, तो मैं जोड़कर भाग दूंगा:
(13 + 18 + 13 + 14 + 13 + 16 + 14 + 21 + 13) / 9 = 15
ध्यान दें कि इस मामले में मीन मूल सूची का मान नहीं है। यह सामान्य बात है। आपको यह मानकर नहीं चलना चाहिए कि आपका मीन मूल संख्याओं में से कोई एक होगा।
मीडियन मध्य मान होता है, इसलिए पहले आपको सूची को संख्यात्मक क्रम में लिखना होगा:
13, 13, 13, 13, 14, 14, 16, 18, 21
सूची में नौ संख्याएं हैं, इसलिए मध्य वाला (9 + 1) / 2 = 10 / 2 = 5वां नंबर होगा:
13, 13, 13, 13, 14, 14, 16, 18, 21
तो मीडियन 14 है।
डेटा को लागू मशीन लर्निंग की मुद्रा माना जाता है। इसलिए, इसका संग्रह और उपयोग, दोनों समान रूप से महत्वपूर्ण हैं।
डेटा सैंपलिंग ऐसे सांख्यिकीय तरीकों को संदर्भित करता है जो डोमेन से अवलोकन चुनते हैं ताकि जनसंख्या पैरामीटर का आकलन किया जा सके। दूसरे शब्दों में, सैंपलिंग अवलोकन एकत्र करने की एक सक्रिय प्रक्रिया है जिसका उद्देश्य किसी जनसंख्या वेरिएबल का आकलन करना है।
डेटासेट की प्रत्येक पंक्ति एक अवलोकन का प्रतिनिधित्व करती है जो किसी विशेष जनसंख्या का संकेतक है। डेटा के साथ काम करते समय, अक्सर आपके पास सभी संभावित अवलोकनों की पहुंच नहीं होती। इसके कई कारण हो सकते हैं, जैसे:
अक्सर, आपके पास डेटा सैंपल्स का सही अनुपात नहीं होगा। इसलिए, समस्या के प्रकार के आधार पर आपको अंडर-सैंपलिंग या ओवर-सैंपलिंग करनी होगी।
जब किसी विशेष श्रेणी के लिए डेटा सैंपल्स अन्य की तुलना में बहुत अधिक होते हैं, तब आप अंडर-सैंपलिंग करते हैं, यानी जहां वे ज्यादा हैं वहां से कुछ सैंपल्स हटाते हैं। जब किसी विशेष श्रेणी के सैंपल्स अन्य की तुलना में बहुत कम होते हैं, तब आप ओवर-सैंपलिंग करते हैं। इस स्थिति में, आप सैंपल्स जनरेट करते हैं।
यह बहु-श्रेणी (multi-class) परिदृश्यों पर भी लागू होता है।
सांख्यिकीय सैंपलिंग एक बड़ा अध्ययन क्षेत्र है, लेकिन लागू मशीन लर्निंग में, आप आमतौर पर तीन प्रकार की सैंपलिंग का उपयोग कर सकते हैं: सरल रैंडम सैंपलिंग, व्यवस्थित (systematic) सैंपलिंग, और स्तरीकृत (stratified) सैंपलिंग।
यद्यपि ये वे सामान्य प्रकार हैं जिनसे आप रूबरू होंगे, अन्य तकनीकें भी हैं (A Gentle Introduction to Statistical Sampling and Resampling).
अक्सर आपके डेटासेट की विशेषताओं (features) की रेंज में बहुत अंतर हो सकता है। कुछ फीचर्स 0 से 100 की स्केल पर हो सकते हैं जबकि अन्य 0.01 - 0.001, 10000- 20000 आदि की रेंज में।
यह कुशल मॉडलिंग के लिए समस्याजनक है। क्योंकि निम्न मान-रेंज वाले फीचर में छोटी-सी परिवर्तनशीलता का उच्च रेंज वाले फीचर्स पर पर्याप्त प्रभाव नहीं पड़ता। यह अच्छे लर्निंग की प्रक्रिया को प्रभावित करता है। इस समस्या से निपटने को डेटा स्केलिंग कहते हैं।
डेटा स्केलिंग की विभिन्न तकनीकें हैं, जैसे Min-Max स्केलिंग, Absolute स्केलिंग, Standard स्केलिंग, आदि।
कभी-कभी आपके डेटासेट्स में संख्यात्मक और गैर-संख्यात्मक डेटा का मिश्रण होता है। कई मशीन लर्निंग फ्रेमवर्क, जैसे scikit-learn, अपेक्षा करते हैं कि सारा डेटा संख्यात्मक प्रारूप में हो। यह गणना को भी तेज बनाता है।
यहां भी सांख्यिकी आपकी मदद को आती है।
Label encoding, One-Hot encoding जैसी तकनीकों का उपयोग गैर-संख्यात्मक डेटा को संख्यात्मक में बदलने के लिए किया जाता है।
आपने अभी तक काफी थ्योरी कवर कर ली। अब इनमें से कुछ को लागू करके वास्तविक अनुभव लें।
आप कुछ सांख्यिकीय विधियों को लागू करके आउट्लायर का पता लगाना शुरू करेंगे।
आप आउट्लायर पहचानने के लिए Z-Score सूचकांक का उपयोग करेंगे, और इसके लिए Boston House Price dataset का अध्ययन करेंगे। आइए sklearn की यूटिलिटीज़ से डेटासेट इम्पोर्ट करके शुरू करें, और जैसे-जैसे आगे बढ़ेंगे, आवश्यक अवधारणाएं स्पष्ट होंगी।
import pandas as pd
import numpy as np
from sklearn.datasets import load_boston

# Load the Boston dataset into a variable called boston
boston = load_boston()
# Separate the features from the target
x = boston.data
y = boston.target
डेटासेट को सभी फीचर नामों के साथ मानक सारणीबद्ध प्रारूप में देखने के लिए, आप इसे pandas डेटा फ्रेम में बदलेंगे।
# Take the columns separately in a variable
columns = boston.feature_names

# Create the dataframe
boston_df = pd.DataFrame(boston.data)
boston_df.columns = columns
boston_df.head()

आम तौर पर, एकवेरिकी (univariate) आउट्लायर विश्लेषण से शुरुआत करना अच्छा होता है जहां आप एक बार में केवल एक फीचर पर विचार करते हैं। अक्सर, किसी विशेष फीचर का एक साधारण बॉक्स-प्लॉट आपको अच्छा शुरुआती संकेत दे सकता है। आप seaborn से बॉक्स-प्लॉट बनाएंगे और DIS फीचर का उपयोग करेंगे।
import seaborn as sns
sns.boxplot(x=boston_df['DIS'])

import matplotlib.pyplot as plt
plt.show()
<matplotlib.axes._subplots.AxesSubplot at 0x8abded0>

बॉक्स-प्लॉट देखने के लिए आपने matplotlib का दूसरा इम्पोर्ट किया क्योंकि seaborn के प्लॉट साधारण matplotlib प्लॉट की तरह ही दिखाए जाते हैं।
ऊपर के प्लॉट में 10 से 12 के बीच तीन बिंदु दिखते हैं, ये आउट्लायर हैं क्योंकि ये अन्य अवलोकनों के बॉक्स में शामिल नहीं हैं। यहां आपने एकवेरिक आउट्लायर का विश्लेषण किया, यानी आउट्लायर जांचने के लिए केवल DIS फीचर का इस्तेमाल किया।
अब Z-Score पर आगे बढ़ते हैं।
"Z-स्कोर वह साइन किए हुए मानक विचलनों की संख्या है जितना कोई अवलोकन या डेटा बिंदु, देखे/मापे जा रहे समूह के औसत से ऊपर होता है।" - Wikipedia
Z-स्कोर के पीछे विचार यह है कि किसी भी डेटा बिंदु को उस समूह के Mean और Standard Deviation के संदर्भ में वर्णित किया जाए। Z-स्कोर डेटा के उस वितरण को खोजने के बारे में है जहां मीन 0 और मानक विचलन 1 होता है, अर्थात् नार्मल डिस्ट्रीब्यूशन।
रुकिए! यह आउट्लायर पहचानने में कैसे मदद करता है?
जब आप Z-स्कोर की गणना करते हैं तो आप डेटा को री-स्केल और सेंटर करते हैं (मीन 0 और मानक विचलन 1) और उन इंस्टेंस पर नज़र रखते हैं जो शून्य से बहुत दूर हैं। जो डेटा पॉइंट शून्य से बहुत दूर होते हैं उन्हें आउट्लायर माना जाता है। सामान्य मामलों में 3 या -3 की दहलीज (थ्रेशोल्ड) उपयोग होती है। उदाहरण के लिए, यदि Z-स्कोर का मान क्रमशः 3 से बड़ा या -3 से छोटा है, तो वह डेटा पॉइंट आउट्लायर माना जाएगा।
आप आउट्लायर पहचानने के लिए scipy लाइब्रेरी में परिभाषित Z-score फ़ंक्शन का उपयोग करेंगे।
from scipy import stats

z = np.abs(stats.zscore(boston_df))
print(z)
[[0.41771335 0.28482986 1.2879095  ... 1.45900038 0.44105193 1.0755623 ]
 [0.41526932 0.48772236 0.59338101 ... 0.30309415 0.44105193 0.49243937]
 [0.41527165 0.48772236 0.59338101 ... 0.30309415 0.39642699 1.2087274 ]
 ...
 [0.41137448 0.48772236 0.11573841 ... 1.17646583 0.44105193 0.98304761]
 [0.40568883 0.48772236 0.11573841 ... 1.17646583 0.4032249  0.86530163]
 [0.41292893 0.48772236 0.11573841 ... 1.17646583 0.44105193 0.66905833]]
सिर्फ ऊपर के आउटपुट को देखकर आउट्लायर पहचानना संभव नहीं। आप और समझदार हैं! आप खुद के लिए एक थ्रेशोल्ड परिभाषित करेंगे, और उस थ्रेशोल्ड को पार करने वाले आउट्लायर का पता लगाने के लिए सरल शर्त लगाएंगे।
threshold = 3
print(np.where(z > 3))
(array([ 55,  56,  57, 102, 141, 142, 152, 154, 155, 160, 162, 163, 199,
       200, 201, 202, 203, 204, 208, 209, 210, 211, 212, 216, 218, 219,
       220, 221, 222, 225, 234, 236, 256, 257, 262, 269, 273, 274, 276,
       277, 282, 283, 283, 284, 347, 351, 352, 353, 353, 354, 355, 356,
       357, 358, 363, 364, 364, 365, 367, 369, 370, 372, 373, 374, 374,
       380, 398, 404, 405, 406, 410, 410, 411, 412, 412, 414, 414, 415,
       416, 418, 418, 419, 423, 424, 425, 426, 427, 427, 429, 431, 436,
       437, 438, 445, 450, 454, 455, 456, 457, 466], dtype=int32), array([ 1,  1,  1, 11, 12,  3,  3,  3,  3,  3,  3,  3,  1,  1,  1,  1,  1,
        1,  3,  3,  3,  3,  3,  3,  3,  3,  3,  3,  3,  5,  3,  3,  1,  5,
        5,  3,  3,  3,  3,  3,  3,  1,  3,  1,  1,  7,  7,  1,  7,  7,  7,
        3,  3,  3,  3,  3,  5,  5,  5,  3,  3,  3, 12,  5, 12,  0,  0,  0,
        0,  5,  0, 11, 11, 11, 12,  0, 12, 11, 11,  0, 11, 11, 11, 11, 11,
       11,  0, 11, 11, 11, 11, 11, 11, 11, 11, 11, 11, 11, 11, 11],
      dtype=int32))
फिर भी आउटपुट भ्रमित करने वाला है! पहली ऐरे में रो नंबर हैं और दूसरी में उनके संबंधित कॉलम नंबर। उदाहरण के लिए, z[55][1] का Z-स्कोर 3 से अधिक है।
print(z[55][1])
3.375038763517309
तो, 55वीं रिकॉर्ड में ZN कॉलम पर आउट्लायर है। आप यहां से आगे बढ़ा सकते हैं।
आपने देखा कि कैसे Z-स्कोर का उपयोग कर और उसका थ्रेशोल्ड सेट कर, डेटा में संभावित आउट्लायर का पता लगाया जा सकता है। अब आप मिसिंग वैल्यू इम्प्यूटेशन करेंगे।
आप प्रसिद्ध Pima Indian Diabetes डेटासेट का उपयोग करेंगे जो मिसिंग वैल्यू के लिए जाना जाता है। आगे बढ़ने से पहले, आपको डेटासेट को अपने वर्कस्पेस में लोड करना होगा।
आप डेटासेट को data नामक DataFrame ऑब्जेक्ट में लोड करेंगे।
data = pd.read_csv("https://raw.githubusercontent.com/jbrownlee/Datasets/master/pima-indians-diabetes.data.csv",header=None)
print(data.describe())
                0           1           2           3           4           5  \
count  768.000000  768.000000  768.000000  768.000000  768.000000  768.000000
mean     3.845052  120.894531   69.105469   20.536458   79.799479   31.992578
std      3.369578   31.972618   19.355807   15.952218  115.244002    7.884160
min      0.000000    0.000000    0.000000    0.000000    0.000000    0.000000
25%      1.000000   99.000000   62.000000    0.000000    0.000000   27.300000
50%      3.000000  117.000000   72.000000   23.000000   30.500000   32.000000
75%      6.000000  140.250000   80.000000   32.000000  127.250000   36.600000
max     17.000000  199.000000  122.000000   99.000000  846.000000   67.100000

                6           7           8
count  768.000000  768.000000  768.000000
mean     0.471876   33.240885    0.348958
std      0.331329   11.760232    0.476951
min      0.078000   21.000000    0.000000
25%      0.243750   24.000000    0.000000
50%      0.372500   29.000000    0.000000
75%      0.626250   41.000000    1.000000
max      2.420000   81.000000    1.000000
आपने देखा होगा कि यहां कॉलम के नाम संख्यात्मक हैं। इसका कारण यह है कि आप पहले से प्रीप्रोसेस्ड डेटासेट का उपयोग कर रहे हैं। लेकिन चिंता न करें, नाम आप जल्द ही जान लेंगे।
यह डेटासेट मिसिंग वैल्यू के लिए जाना जाता है, लेकिन ऊपर दिए गए सांख्यिकीय सार से पहली नज़र में ऐसा लग सकता है कि डेटासेट में मिसिंग वैल्यू है ही नहीं। पर थोड़ा ध्यान से देखें, तो कुछ कॉलम ऐसे हैं जहां ज़ीरो मान पूरी तरह अवैध है। यही वे मान हैं जो वास्तव में मिसिंग हैं।
विशेष रूप से, नीचे दिए गए कॉलम में न्यूनतम मान शून्य है जो अवैध है:
इसे कच्चे डेटा को देखकर पुष्ट करते हैं, नीचे उदाहरण पहले 20 रो प्रिंट करता है।
data.head(20)
| 0 | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | |
|---|---|---|---|---|---|---|---|---|---|
| 0 | 6 | 148 | 72 | 35 | 0 | 33.6 | 0.627 | 50 | 1 |
| 1 | 1 | 85 | 66 | 29 | 0 | 26.6 | 0.351 | 31 | 0 |
| 2 | 8 | 183 | 64 | 0 | 0 | 23.3 | 0.672 | 32 | 1 |
| 3 | 1 | 89 | 66 | 23 | 94 | 28.1 | 0.167 | 21 | 0 |
| 4 | 0 | 137 | 40 | 35 | 168 | 43.1 | 2.288 | 33 | 1 |
| 5 | 5 | 116 | 74 | 0 | 0 | 25.6 | 0.201 | 30 | 0 |
| 6 | 3 | 78 | 50 | 32 | 88 | 31.0 | 0.248 | 26 | 1 |
| 7 | 10 | 115 | 0 | 0 | 0 | 35.3 | 0.134 | 29 | 0 |
| 8 | 2 | 197 | 70 | 45 | 543 | 30.5 | 0.158 | 53 | 1 |
| 9 | 8 | 125 | 96 | 0 | 0 | 0.0 | 0.232 | 54 | 1 |
| 10 | 4 | 110 | 92 | 0 | 0 | 37.6 | 0.191 | 30 | 0 |
| 11 | 10 | 168 | 74 | 0 | 0 | 38.0 | 0.537 | 34 | 1 |
| 12 | 10 | 139 | 80 | 0 | 0 | 27.1 | 1.441 | 57 | 0 |
| 13 | 1 | 189 | 60 | 23 | 846 | 30.1 | 0.398 | 59 | 1 |
| 14 | 5 | 166 | 72 | 19 | 175 | 25.8 | 0.587 | 51 | 1 |
| 15 | 7 | 100 | 0 | 0 | 0 | 30.0 | 0.484 | 32 | 1 |
| 16 | 0 | 118 | 84 | 47 | 230 | 45.8 | 0.551 | 31 | 1 |
| 17 | 7 | 107 | 74 | 0 | 0 | 29.6 | 0.254 | 31 | 1 |
| 18 | 1 | 103 | 30 | 38 | 83 | 43.3 | 0.183 | 33 | 0 |
| 19 | 1 | 115 | 70 | 30 | 96 | 34.6 | 0.529 | 32 | 1 |
स्पष्ट है कि कॉलम 2, 3, 4 और 5 में 0 मान मौजूद हैं।
क्योंकि इस डेटासेट में मिसिंग वैल्यू के रूप में 0 इस्तेमाल हुए हैं, इसलिए केवल पारंपरिक उपायों से इसे संभालना पेचीदा हो सकता है। आइए उस दृष्टिकोण को संक्षेप में बताते हैं जिसे आप अपनाएंगे:
NaN से बदलें।# Step 1: Get the count of zeros in each of the columns
print((data[[1,2,3,4,5]] == 0).sum())
1      5
2     35
3    227
4    374
5     11
dtype: int64
आप देख सकते हैं कि कॉलम 1, 2 और 5 में कुछ ही शून्य हैं, जबकि कॉलम 3 और 4 में बहुत अधिक, लगभग आधी रो हैं।
# Step -2: Mark zero values as missing or NaN
data[[1,2,3,4,5]] = data[[1,2,3,4,5]].replace(0, np.NaN)

# Count the number of NaN values in each column
print(data.isnull().sum())
0      0
1      5
2     35
3    227
4    374
5     11
6      0
7      0
8      0
dtype: int64
आइए इस समय यह सुनिश्चित कर लें कि आपका NaN प्रतिस्थापन सफल रहा है, पूरे डेटासेट पर एक नज़र डालकर:
# Step 4
data.head(20)
| 0 | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | |
|---|---|---|---|---|---|---|---|---|---|
| 0 | 6 | 148.0 | 72.0 | 35.0 | NaN | 33.6 | 0.627 | 50 | 1 |
| 1 | 1 | 85.0 | 66.0 | 29.0 | NaN | 26.6 | 0.351 | 31 | 0 |
| 2 | 8 | 183.0 | 64.0 | NaN | NaN | 23.3 | 0.672 | 32 | 1 |
| 3 | 1 | 89.0 | 66.0 | 23.0 | 94.0 | 28.1 | 0.167 | 21 | 0 |
| 4 | 0 | 137.0 | 40.0 | 35.0 | 168.0 | 43.1 | 2.288 | 33 | 1 |
| 5 | 5 | 116.0 | 74.0 | NaN | NaN | 25.6 | 0.201 | 30 | 0 |
| 6 | 3 | 78.0 | 50.0 | 32.0 | 88.0 | 31.0 | 0.248 | 26 | 1 |
| 7 | 10 | 115.0 | NaN | NaN | NaN | 35.3 | 0.134 | 29 | 0 |
| 8 | 2 | 197.0 | 70.0 | 45.0 | 543.0 | 30.5 | 0.158 | 53 | 1 |
| 9 | 8 | 125.0 | 96.0 | NaN | NaN | NaN | 0.232 | 54 | 1 |
| 10 | 4 | 110.0 | 92.0 | NaN | NaN | 37.6 | 0.191 | 30 | 0 |
| 11 | 10 | 168.0 | 74.0 | NaN | NaN | 38.0 | 0.537 | 34 | 1 |
| 12 | 10 | 139.0 | 80.0 | NaN | NaN | 27.1 | 1.441 | 57 | 0 |
| 13 | 1 | 189.0 | 60.0 | 23.0 | 846.0 | 30.1 | 0.398 | 59 | 1 |
| 14 | 5 | 166.0 | 72.0 | 19.0 | 175.0 | 25.8 | 0.587 | 51 | 1 |
| 15 | 7 | 100.0 | NaN | NaN | NaN | 30.0 | 0.484 | 32 | 1 |
| 16 | 0 | 118.0 | 84.0 | 47.0 | 230.0 | 45.8 | 0.551 | 31 | 1 |
| 17 | 7 | 107.0 | 74.0 | NaN | NaN | 29.6 | 0.254 | 31 | 1 |
| 18 | 1 | 103.0 | 30.0 | 38.0 | 83.0 | 43.3 | 0.183 | 33 | 0 |
| 19 | 1 | 115.0 | 70.0 | 30.0 | 96.0 | 34.6 | 0.529 | 32 | 1 |
आप देख सकते हैं कि मिसिंग वैल्यू मार्क करना अपेक्षित रूप से काम कर गया।
अब तक आपने देखा कि डेटा मिसिंग होने पर आवश्यक प्रवृत्तियां कैसी होती हैं और सरल सांख्यिकीय उपायों से इसे कैसे संभाला जा सकता है। अब आप Mean Imputation का उपयोग करके मिसिंग वैल्यू भरेंगे, जिसमें संबंधित कॉलम के औसत से मिसिंग वैल्यू को बदला जाता है।
# Step 5: Call the fillna() function with the imputation strategy
data.fillna(data.mean(), inplace=True)

# Count the number of NaN values in each column to verify
print(data.isnull().sum())
0    0
1    0
2    0
3    0
4    0
5    0
6    0
7    0
8    0
dtype: int64
उत्तम!
यह DataCamp लेख डेटा प्रीप्रोसेसिंग चरण के रूप में डेटा स्केलिंग लागू करने में प्रभावी मार्गदर्शन देता है। जरूर देखें।
अब आप वेरिएबल एनकोडिंग करेंगे।
उससे पहले, आपको ऐसा डेटासेट चाहिए जिसमें वास्तव में गैर-संख्यात्मक डेटा हो। इसके लिए आप प्रसिद्ध Iris डेटासेट का उपयोग करेंगे।
# Load the dataset to a DataFrame object iris
iris = pd.read_csv("http://archive.ics.uci.edu/ml/machine-learning-databases/iris/iris.data",header=None)
# See first 20 rows of the dataset
iris.head(20)
| 0 | 1 | 2 | 3 | 4 | |
|---|---|---|---|---|---|
| 0 | 5.1 | 3.5 | 1.4 | 0.2 | Iris-setosa |
| 1 | 4.9 | 3.0 | 1.4 | 0.2 | Iris-setosa |
| 2 | 4.7 | 3.2 | 1.3 | 0.2 | Iris-setosa |
| 3 | 4.6 | 3.1 | 1.5 | 0.2 | Iris-setosa |
| 4 | 5.0 | 3.6 | 1.4 | 0.2 | Iris-setosa |
| 5 | 5.4 | 3.9 | 1.7 | 0.4 | Iris-setosa |
| 6 | 4.6 | 3.4 | 1.4 | 0.3 | Iris-setosa |
| 7 | 5.0 | 3.4 | 1.5 | 0.2 | Iris-setosa |
| 8 | 4.4 | 2.9 | 1.4 | 0.2 | Iris-setosa |
| 9 | 4.9 | 3.1 | 1.5 | 0.1 | Iris-setosa |
| 10 | 5.4 | 3.7 | 1.5 | 0.2 | Iris-setosa |
| 11 | 4.8 | 3.4 | 1.6 | 0.2 | Iris-setosa |
| 12 | 4.8 | 3.0 | 1.4 | 0.1 | Iris-setosa |
| 13 | 4.3 | 3.0 | 1.1 | 0.1 | Iris-setosa |
| 14 | 5.8 | 4.0 | 1.2 | 0.2 | Iris-setosa |
| 15 | 5.7 | 4.4 | 1.5 | 0.4 | Iris-setosa |
| 16 | 5.4 | 3.9 | 1.3 | 0.4 | Iris-setosa |
| 17 | 5.1 | 3.5 | 1.4 | 0.3 | Iris-setosa |
| 18 | 5.7 | 3.8 | 1.7 | 0.3 | Iris-setosa |
| 19 | 5.1 | 3.8 | 1.5 | 0.3 | Iris-setosa |
आप LabelEncoder का उपयोग करके स्ट्रिंग मानों को आसानी से पूर्णांक मानों में बदल सकते हैं। तीन क्लास मान (Iris-setosa, Iris-versicolor, Iris-virginica) को पूर्णांकों (0, 1, 2) में मैप किया जाता है।
इस मामले में, डेटासेट का चौथा कॉलम/फीचर गैर-संख्यात्मक मान रखता है। इसलिए आपको इसे अलग करना होगा।
# Convert the DataFrame to a NumPy array
iris = iris.values

# Separate
Y = iris[:,4]
# Label Encode string class values as integers
from sklearn.preprocessing import LabelEncoder

label_encoder = LabelEncoder()
label_encoder = label_encoder.fit(Y)
label_encoded_y = label_encoder.transform(Y)
अब, एक और क्षेत्र पढ़ते हैं जहां सांख्यिकी के प्राथमिक ज्ञान की आवश्यकता बहुत महत्वपूर्ण है।
आपने अपना मशीन लर्निंग मॉडल डिज़ाइन और विकसित कर लिया है। अब आप अपने मॉडल के प्रदर्शन का टेस्ट डेटा पर मूल्यांकन करना चाहते हैं। इस संदर्भ में, आप Precision, Recall, ROC, AUC, RMSE आदि जैसे विभिन्न सांख्यिकीय मेट्रिक्स की मदद लेते हैं। आप k-fold Cross-Validation जैसी कई डेटा रिसैंपलिंग तकनीकों की भी मदद लेते हैं।
सांख्यिकी का प्रभावी उपयोग इन कार्यों में किया जा सकता है:
यह ध्यान रखना महत्वपूर्ण है कि यहां परिकल्पना से तात्पर्य सीखे गए मॉडलों से है; यानी किसी डेटासेट पर लर्निंग एल्गोरिद्म चलाने के परिणाम। परिकल्पनाओं का मूल्यांकन और तुलना करना मतलब सीखे गए मॉडलों की तुलना करना है, जो मशीन लर्निंग एल्गोरिद्म के मूल्यांकन/तुलना से भिन्न है क्योंकि एल्गोरिद्म अलग-अलग सैंपल्स या अलग समस्याओं पर प्रशिक्षित हो सकते हैं।
अब गॉसियन और विवरणात्मक सांख्यिकी पढ़ते हैं।
डेटा का एक सैंपल किसी व्यापक जनसंख्या का स्नैपशॉट भर होता है, जो किसी डोमेन से लिए जा सकने वाले या किसी प्रक्रिया द्वारा जनरेट किए जा सकने वाले संभावित अवलोकनों का समूह है।
रोचक रूप से, कई अवलोकन एक विशिष्ट पैटर्न या वितरण में फिट होते हैं जिसे सामान्य वितरण या औपचारिक रूप से गॉसियन वितरण कहा जाता है। यह वह घंटी-आकार (bell-shaped) वितरण है जिससे आप परिचित होंगे। निम्नलिखित चित्र एक गॉसियन वितरण दिखाता है:
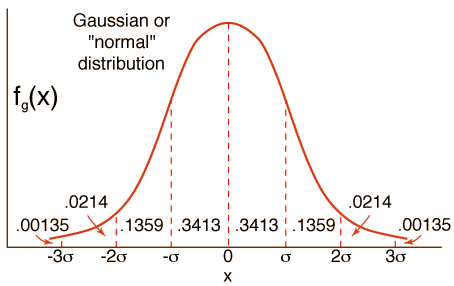
स्रोत: HyperPhysics
गॉसियन प्रक्रियाएं और गॉसियन वितरण अपने आप में बड़े उप-क्षेत्र हैं। लेकिन अब आप उन दो सबसे आवश्यक अवयवों का अध्ययन करेंगे जो सामान्य तौर पर गॉसियन वितरणों की दुनिया बनाते हैं।
गॉसियन वितरण से लिए गए किसी भी सैंपल डेटा को दो पैरामीटर से सारांशित किया जा सकता है:
Variance शब्द एक और महत्वपूर्ण पद को जन्म देता है, यानी Standard Deviation, जो बस वैरिएंस का वर्गमूल है।
मीन, वैरिएंस और स्टैंडर्ड डिविएशन को सीधे numpy की मदद से डेटा सैंपल्स से गणना किया जा सकता है।
आप पहले 50 के मीन और 5 के स्टैंडर्ड डिविएशन वाले गॉसियन वितरण से 100 यादृच्छिक संख्याओं का सैंपल जनरेट करेंगे। फिर आप सार-सांख्यिकी की गणना करेंगे।
सबसे पहले, सभी निर्भरताएं इम्पोर्ट करेंगे।
#  Dependencies
from numpy.random import seed
from numpy.random import randn
from numpy import mean
from numpy import var
from numpy import std
इसके बाद, आप रैंडम नंबर जेनरेटर का सीड सेट करेंगे ताकि आपके परिणाम पुनरुत्पाद्य (reproducible) हों।
seed(1)
# Generate univariate observations
data = 5 * randn(10000) + 50
# Calculate statistics
print('Mean: %.3f' % mean(data))
print('Variance: %.3f' % var(data))
print('Standard Deviation: %.3f' % std(data))
Mean: 50.049
Variance: 24.939
Standard Deviation: 4.994
काफी करीब, है न?
अब अगले विषय पर चलते हैं।
आम तौर पर, किसी डेटासेट में शामिल फीचर्स आपस में संबंधित हो सकते हैं, जो व्यवहार में स्वाभाविक है। सांख्यिकीय भाषा में, आपके डेटासेट के फीचर्स के बीच इस संबंध (चाहे सरल हो या जटिल) को अक्सर correlation कहा जाता है।
किसी डेटासेट में फीचर्स के सहसंबंध की डिग्री जानना महत्वपूर्ण है। यह चरण मूलतः फीचर चयन का कार्य करता है, जिसका उद्देश्य किसी डेटासेट से सबसे महत्वपूर्ण फीचर्स चुनना है। यह मानक मशीन लर्निंग पाइपलाइन के सबसे महत्वपूर्ण चरणों में से एक है क्योंकि इससे कम समय में ही आपके एक्यूरेसी में उल्लेखनीय बढ़ोतरी हो सकती है।
बेहतर समझ और अधिक व्यावहारिक रखने के लिए, आइए समझते हैं कि फीचर्स आपस में क्यों संबंधित हो सकते हैं:
फीचर्स के बीच सहसंबंध तीन प्रकार का हो सकता है: - सकारात्मक सहसंबंध जहां दोनों फीचर एक ही दिशा में बदलते हैं, तटस्थ सहसंबंध जब दोनों के परिवर्तन में कोई संबंध नहीं, नकारात्मक सहसंबंध जहां दोनों फीचर विपरीत दिशाओं में बदलते हैं।
सहसंबंध माप फिल्टर-आधारित फीचर चयन तकनीकों की नींव बनते हैं। यदि आप फीचर चयन के बारे में अधिक पढ़ना चाहते हैं, तो यह लेख देखें।
आप दो वेरिएबल्स के सैंपल्स के बीच संबंध को गणितीय रूप से Pearson’s correlation coefficient से माप सकते हैं, जिसे इस विधि के विकासकर्ता Karl Pearson के नाम पर रखा गया है।
आप pandas की corr() फ़ंक्शन में method पैरामीटर को pearson देकर Pearson का सहसंबंध स्कोर निकाल सकते हैं। आइए पहले इस्तेमाल किए गए Pima Indians Diabetes डेटासेट के फीचर्स के बीच सहसंबंध का अध्ययन करते हैं। आपका डेटा पहले से ठीक रूप में है।
# Data
data.head()
| 0 | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | |
|---|---|---|---|---|---|---|---|---|---|
| 0 | 6 | 148.0 | 72.0 | 35.00000 | 155.548223 | 33.6 | 0.627 | 50 | 1 |
| 1 | 1 | 85.0 | 66.0 | 29.00000 | 155.548223 | 26.6 | 0.351 | 31 | 0 |
| 2 | 8 | 183.0 | 64.0 | 29.15342 | 155.548223 | 23.3 | 0.672 | 32 | 1 |
| 3 | 1 | 89.0 | 66.0 | 23.00000 | 94.000000 | 28.1 | 0.167 | 21 | 0 |
| 4 | 0 | 137.0 | 40.0 | 35.00000 | 168.000000 | 43.1 | 2.288 | 33 | 1 |
# Create the matrix of correlation score between the features and the label
scoreTable = data.corr(method='pearson')
# Visulaize the matrix
data.corr(method='pearson').style.format("{:.2}").background_gradient(cmap=plt.get_cmap('coolwarm'), axis=1)

आप स्पष्ट रूप से डेटासेट के सभी फीचर्स और लेबल के बीच Pearson का सहसंबंध देख सकते हैं।
अगले खंड में, आप अपरामित सांख्यिकी पढ़ेंगे।
सांख्यिकी और सांख्यिकीय विधियों का बड़ा हिस्सा ऐसे डेटा को समर्पित है जहां वितरण ज्ञात होता है।
जब जनसंख्या पैरामीटर्स के बारे में कम या कोई सूचना नहीं होती, तब अपरामित सांख्यिकी काम आती है। अपरामित परीक्षण डेटा के वितरण के बारे में कोई मान्यताएं नहीं लगाते।
जहां आप नॉन-पैरामेट्रिक डेटा के साथ काम कर रहे हों, वहां विशिष्ट नॉन-पैरामेट्रिक सांख्यिकीय विधियां इस्तेमाल की जा सकती हैं जो वितरण के बारे में सभी जानकारी त्याग देती हैं। इसलिए इन्हें अक्सर distribution-free विधियां कहा जाता है।
पर किसी नॉन-पैरामेट्रिक सांख्यिकीय विधि को लागू करने से पहले, डेटा को रैंक प्रारूप में बदला जाना चाहिए। जो विधियां रैंक प्रारूप में डेटा की अपेक्षा करती हैं, उन्हें कभी-कभी rank statistics कहा जाता है। रैंक सांख्यिकी के उदाहरण रैंक सहसंबंध और रैंक सांख्यिकीय परिकल्पना परीक्षण हो सकते हैं। रैंकिंग डेटा नाम से ही स्पष्ट है।
दो स्वतंत्र सैंपल्स के बीच भिन्नता की जांच करने के लिए व्यापक रूप से इस्तेमाल होने वाला अपरामित सांख्यिकीय परिकल्पना परीक्षण Mann-Whitney U test है, जिसका नाम Henry Mann और Donald Whitney के नाम पर है।
आप इस परीक्षण को Python में SciPy के दिए गए mannwhitneyu() के जरिए लागू करेंगे।
# The dependencies that you need
from scipy.stats import mannwhitneyu
from numpy.random import rand

# seed the random number generator
seed(1)
# Generate two independent samples
data1 = 50 + (rand(100) * 10)
data2 = 51 + (rand(100) * 10)
# Compare samples
stat, p = mannwhitneyu(data1, data2)
print('Statistics = %.3f, p = %.3f' % (stat, p))
# Interpret
alpha = 0.05
if p > alpha:
    print('Same distribution (fail to reject H0)')
else:
    print('Different distribution (reject H0)')
Statistics = 4077.000, p = 0.012
Different distribution (reject H0)
alpha वह थ्रेशोल्ड पैरामीटर है जिसे आप तय करते हैं। mannwhitneyu() दो चीजें लौटाता है:
statistic: Mann-Whitney U सांख्यिक, जो alternative None होने पर min(U for x, U for y) के बराबर होता है (डिप्रिकेटेड; बैकवर्ड कंपैटिबिलिटी हेतु), अन्यथा U for y।
pvalue: असिम्प्टोटिक नार्मल वितरण मानकर p-वैल्यू।
यदि आप अपरामित सांख्यिकी की अन्य विधियां पढ़ना चाहते हैं, तो यहां देखें।
अन्य दो लोकप्रिय अपरामित सांख्यिकीय महत्वपूर्णता परीक्षण जिन्हें आप उपयोग कर सकते हैं:
आप अंत तक पहुंच गए हैं। इस लेख में, आपने कई आवश्यक सांख्यिकीय अवधारणाएं पढ़ीं जो आपके मशीन लर्निंग प्रोजेक्ट्स में बहुत महत्वपूर्ण भूमिका निभाती हैं। इसलिए, उन्हें समझना उतना ही महत्वपूर्ण है।
सिर्फ एक परिचय से शुरू करके, आप सांख्यिकीय रैंकिंग तक गए, वह भी कई इम्प्लिमेंटेशंस के साथ। यह निश्चित रूप से एक उल्लेखनीय उपलब्धि है। आपने तीन अलग-अलग डेटासेट पढ़े, pandas और numpy की क्षमताओं का भरपूर उपयोग किया और साथ ही SciPy का भी इस्तेमाल किया। यदि आप आगे बढ़ना चाहते हैं, तो कुछ लिंक नीचे हैं:
इस ब्लॉग को लिखने में मैंने जिन संसाधनों की मदद ली, वे हैं:
कमेंट्स सेक्शन में अपने विचार/प्रश्न बताएं। साथ ही DataCamp का "Statistical Thinking in Python" कोर्स भी देखें, जो व्यावहारिक रूप से काफ़ी अनुकूल है।
Python कोर्स
कोर्स
कोर्स
कोर्स