
Last chance! 50% off DataCamp Premium
Sale ends in
Makine öğrenmesi algoritmalarını uygulama konusunda az deneyiminiz varsa, bunun ön koşul olarak İstatistik bilgisi gerektirmediğini fark etmiş olabilirsiniz.
Ancak, biraz istatistik bilmek, makine öğrenmesini hem teknik hem de sezgisel olarak anlamak için faydalı olabilir. Sonuçlarınızı doğrulamaya ve yorumlamaya başladığınızda bir miktar istatistik bilgisi eninde sonunda gerekecektir. Ne de olsa, veri varsa istatistik de vardır. Matematik bilimin diliyse, istatistik de Veri Bilimi ve Makine Öğreniminin kendine has dilidir.
İstatistik, birçok kuram ve bulgu içeren bir matematik alt alanıdır. Bununla birlikte, bu alandan alınan çeşitli kavramlar, araçlar, teknikler ve gösterimler, makine öğrenimini bugün olduğu hale getirmiştir. Betimsel istatistiksel yöntemleri kullanarak gözlemleri, anlayıp başkalarıyla paylaşabileceğiniz faydalı bilgilere dönüştürebilirsiniz. Çıkarımsal istatistik teknikleriyle küçük veri örneklerinden tüm alanlara ilişkin akıl yürütebilirsiniz. Bu yazının ilerleyen kısımlarında betimsel ve çıkarımsal istatistikleri inceleyeceksiniz. Yani endişelenmeyin.
Başlamadan önce, uygulamalı bir makine öğrenmesi projesinde istatistiksel yöntemlerin kullanıldığı on örneği hızlıca gözden geçirelim:
Kaynak: Statistical Methods for Machine Learning
Etkileyici değil mi?
Bu yazı, iyi bir makine öğrenmesi uygulayıcısı olmak için gerekli ve vazgeçilmez istatistiklerde sağlam bir temel sağlayacaktır.
Bu yazıda şunları inceleyeceksiniz:
Ele alınacak çok konu var ve hepsi eşit derecede önemli. Hadi başlayalım!
İstatistik nasıl basitçe tanımlanır, kısaca inceleyelim.
İstatistik, matematiğin bir alt dalı olarak kabul edilir. Verilerle çalışmak ve bu verileri kullanarak pek çok türde soruya yanıt vermek için kullanılan çok sayıda yöntemi ifade eder.
Uygulamada kullanılan istatistiksel araçlara gelince, alanı iki geniş yöntem grubuna ayırmak faydalı olabilir: verileri özetlemek için betimsel istatistikler ve örneklerden sonuç çıkarmak için çıkarımsal istatistikler (Statistics for Machine Learning (7-Day Mini-Course).

Kaynak: IntellSpot
Çıkarımsal İstatistikler: Çıkarımsal istatistikler, örnek adı verilen daha küçük bir gözlem kümesinden alanın veya popülasyonun özelliklerini nicelendirmeye yardımcı olan yöntemlerdir. Aşağıda çıkarımsal istatistikleri güzelce açıklayan bir infografik yer almaktadır:
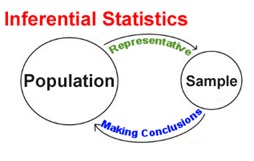
Kaynak: Analytics Vidhya
Bir sonraki bölümde, veri hazırlama için istatistik kullanımını inceleyeceksiniz.
Makine öğrenmesi modeliniz için eğitim ve test verilerini geliştirirken istatistiksel yöntemlere ihtiyaç duyulur.
Bu; şu teknikleri kapsar:
Bu görevleri yaparken hangi yöntemlerin seçileceğini belirlemek için veri dağılımları, betimsel istatistikler ve veri görselleştirme konusunda temel bir anlayış gereklidir.
Yukarıdaki noktaların her birini kısaca analiz edelim.
Önce aykırı değerin ne olduğuna bakalım.
Aykırı değer, örnekteki diğer gözlemlerden saptığı görünen bir gözlem olarak kabul edilir. Aşağıdaki şekil tanımı daha belirgin hale getirir.

Kaynak: MathWorks
Yukarıdaki şekilde gösterildiği gibi verideki aykırı değerleri fark edebilirsiniz.
Birçok makine öğrenmesi algoritması, girdi verilerindeki öznitelik değerlerinin aralığına ve dağılımına duyarlıdır. Girdi verilerindeki aykırı değerler, makine öğrenmesi algoritmalarının eğitim sürecini çarpıtabilir ve yanıltabilir; bunun sonucunda eğitim süreleri uzar, modeller daha az isabetli olur ve nihayetinde daha vasat sonuçlar elde edilir.
Olası aykırı değerlerin belirlenmesi şu nedenlerle kritiktir:
Bir aykırı değer, verinin hatalı olduğuna işaret edebilir. Örneğin, veri yanlış kodlanmış olabilir veya deney düzgün çalışmamış olabilir. Eğer aykırı bir noktanın gerçekten hatalı olduğu belirlenebilirse, aykırı olan değerin analizden çıkarılması gerekir. Düzeltmek mümkünse bu da başka bir seçenektir.
Bazı durumlarda, aykırı bir noktanın hatalı bir veri noktası olup olmadığını belirlemek mümkün olmayabilir. Aykırı değerler rastgele varyasyondan kaynaklanabilir veya bilimsel olarak ilginç bir şeye işaret ediyor olabilir. Her halükârda, genellikle aykırı gözlemi doğrudan silmek istemezsiniz. Ancak veride önemli aykırı değerler varsa, sağlam (robust) istatistiksel tekniklerin kullanımını düşünmeniz gerekebilir.
Dolayısıyla, aykırı değerler çoğu zaman kestirim (tahmin) modelleriniz için iyi değildir (Her ne kadar bazen bu aykırı değerler avantaj olarak kullanılabilse de bu yazının kapsamı dışındadır). Aykırı değerleri etkin biçimde ele almak için istatistiksel bilgiye ihtiyacınız var.
Günümüzde veri kümelerinin çoğu kayıp değer sorunundan muzdariptir. Modele beslediğiniz veriler kayıp değer içeriyorsa makine öğrenmesi modeliniz etkin şekilde eğitilemeyebilir. İşte bu noktada istatistiksel araç ve teknikler imdada yetişir.
Birçok kişi kayıp değer içeren veri örneklerini atma eğilimindedir. Ancak bu iyi bir uygulama değildir; çünkü bu süreçte verinin önemli özelliklerini/temsillerini kaybedebilirsiniz. Kayıp değer problemleriyle başa çıkmak için ileri yöntemler olsa da genellikle başvurulan hızlı teknikler şunlardır: Ortalama ile Atama ve Medyan ile Atama.
Ortalama ve medyanın ne olduğunu anlamanız çok önemlidir.
Diyelim ki X1 adlı bir özelliğiniz var ve değerleri şöyle: 13, 18, 13, 14, 13, 16, 14, 21, 13
Ortalama bildiğimiz aritmetik ortalamadır; toplayıp böleceğim:
(13 + 18 + 13 + 14 + 13 + 16 + 14 + 21 + 13) / 9 = 15
Dikkat edin, bu durumda ortalama, özgün listedeki bir değer değil. Bu yaygın bir sonuçtur. Ortalamanızın, özgün sayılarınızdan biri olacağını varsaymamalısınız.
Medyan ortadaki değerdir; bu nedenle önce listeyi sayısal sıraya göre yeniden yazmanız gerekir:
13, 13, 13, 13, 14, 14, 16, 18, 21
Listede dokuz sayı var; dolayısıyla ortadaki sayı (9 + 1) / 2 = 10 / 2 = 5. sayıdır:
13, 13, 13, 13, 14, 14, 16, 18, 21
Yani medyan 14'tür.
Veri, uygulamalı makine öğrenmesinin para birimi olarak görülür. Bu nedenle, hem toplanması hem de kullanımı eşit derecede önemlidir.
Veri örnekleme, bir popülasyon parametresini tahmin etme amacıyla alandan gözlemler seçmeye yönelik istatistiksel yöntemleri ifade eder. Başka bir deyişle, örnekleme; bir popülasyon değişkenini tahmin etme niyetiyle gözlem toplamaya yönelik etkin bir süreçtir.
Bir veri kümesindeki her satır, belirli bir popülasyonu temsil eden bir gözlemdir. Verilerle çalışırken çoğu zaman mümkün olan tüm gözlemlere erişiminiz olmaz. Bunun birçok nedeni olabilir, örneğin:
Çoğu zaman veri örneklerinin doğru oranına sahip olmazsınız. Bu yüzden probleme bağlı olarak eksik örnekleme (under-sampling) veya fazla örnekleme (over-sampling) yapmanız gerekir.
Belirli bir kategori için veri örnekleri diğerlerine kıyasla çok yüksekse eksik örnekleme yaparsınız; yani yüksek olduğu kategoriden bazı örnekleri atarsınız. Belirli bir tür için veri örnekleri diğerine kıyasla belirgin şekilde düşükse fazla örnekleme yaparsınız; bu durumda veri örnekleri üretirsiniz.
Bu, çok sınıflı senaryolar için de geçerlidir.
İstatistiksel örnekleme geniş bir çalışma alanıdır; ancak uygulamalı makine öğrenmesinde muhtemelen kullanacağınız üç örnekleme türü vardır: basit rastgele örnekleme, sistematik örnekleme ve tabakalı örnekleme.
Bunlar karşılaşabileceğiniz en yaygın örnekleme türleri olmakla birlikte başka teknikler de vardır (A Gentle Introduction to Statistical Sampling and Resampling).
Çoğu zaman, veri kümenizdeki özelliklerin aralıkları çok farklı olabilir. Bazı özellikler 0 ile 100 arasında bir ölçeğe sahipken, diğerlerinin aralıkları 0,01 - 0,001, 10000 - 20000 vb. olabilir.
Bu, verimli modelleme için çok sorunludur. Çünkü değeri daha küçük aralıkta olan bir özellikteki küçük bir değişim, diğer özellikler üzerinde kayda değer bir etki yaratmayabilir. Bu durum iyi bir öğrenme sürecini olumsuz etkiler. Bu sorunla başa çıkmaya veri ölçekleme denir.
Min-Maks ölçekleme, Mutlak ölçekleme, Standart ölçekleme vb. farklı veri ölçekleme teknikleri vardır.
Bazen veri kümeleriniz hem sayısal hem de sayısal olmayan verilerin bir karışımını içerir. scikit-learn gibi birçok makine öğrenmesi çatısı, tüm verilerin sayısal biçimde olmasını bekler. Bu, hesaplama sürecini hızlandırmak için de faydalıdır.
Yine istatistik yardıma koşar.
Etiket kodlama, Tek-sıcak (One-Hot) kodlama vb. teknikler, sayısal olmayan verileri sayısala dönüştürmek için kullanılır.
Şimdilik epey teori gördünüz. Bunların bazılarını uygulayarak gerçeğe daha yakın bir his edineceksiniz.
Aykırı Değerleri tespit etmek için bazı istatistiksel yöntemleri uygulayarak başlayacaksınız.
Aykırı değerleri tespit etmek için Z-Skoru indeksini kullanacak ve bunun için Boston Konut Fiyatları veri setini inceleyeceksiniz. Başlangıçta veri setini sklearn yardımcılarından içe aktaralım; ilerledikçe gerekli kavramları da öğrenmeye başlayacaksınız.
import pandas as pd
import numpy as np
from sklearn.datasets import load_boston

# Load the Boston dataset into a variable called boston
boston = load_boston()
# Separate the features from the target
x = boston.data
y = boston.target
Veri setini tüm özellik adlarıyla standart bir tablo biçiminde görmek için bunu bir pandas veri çerçevesine dönüştüreceksiniz.
# Take the columns separately in a variable
columns = boston.feature_names

# Create the dataframe
boston_df = pd.DataFrame(boston.data)
boston_df.columns = columns
boston_df.head()

Genellikle tek değişkenli aykırı değer analiziyle başlamak yaygındır; burada aynı anda yalnızca bir özelliği ele alırsınız. Çoğu zaman, belirli bir özelliğin basit bir kutu grafiği size iyi bir başlangıç noktası verebilir. seaborn kullanarak bir kutu grafiği oluşturacak ve DIS özelliğini kullanacaksınız.
import seaborn as sns
sns.boxplot(x=boston_df['DIS'])

import matplotlib.pyplot as plt
plt.show()
<matplotlib.axes._subplots.AxesSubplot at 0x8abded0>

Kutu grafiğini görüntülemek için ikinci kez matplotlib içe aktardınız; çünkü seaborn grafikleri, sıradan matplotlib grafikleri gibi görüntülenir.
Yukarıdaki grafik 10 ile 12 arasında üç nokta gösteriyor; bunlar, diğer gözlemlerin kutusu içinde yer almadıkları için aykırı değerlerdir. Burada tek değişkenli aykırı değer analizi yaptınız; yani aykırı değerleri kontrol etmek için yalnızca DIS özelliğini kullandınız.
Şimdi Z-Skoru ile devam edelim.
"Z-skoru, bir gözlemin veya veri noktasının değeri ile gözlenen veya ölçülen şeyin ortalama değeri arasındaki standart sapma sayısının işaretli halidir." - Vikipedi
Z-skorunun ardındaki fikir, herhangi bir veri noktasını, veri noktaları grubunun Standart Sapma ve Ortalama ile ilişkisi açısından tanımlamaktır. Z-skoru, ortalamanın 0 ve standart sapmanın 1 olduğu, yani normal dağılımı bulmaya yöneliktir.
Bekleyin! Bu, aykırı değerlerin belirlenmesine nasıl yardımcı oluyor?
Z-skorunu hesaplarken veriyi yeniden ölçeklendirir ve merkeze alırsınız (ortalama 0 ve standart sapma 1) ve sıfırdan çok uzak olan örneklere bakarsınız. Sıfırdan aşırı uzak olan bu veri noktaları aykırı değer olarak kabul edilir. En yaygın durumlarda 3 veya -3 eşiği kullanılır. Örneğin, Z-skoru değeri sırasıyla 3'ten büyük veya -3'ten küçükse bu veri noktası aykırı değer olarak tanımlanır.
Aykırı değerleri tespit etmek için scipy kütüphanesinde tanımlı Z-score fonksiyonunu kullanacaksınız.
from scipy import stats

z = np.abs(stats.zscore(boston_df))
print(z)
[[0.41771335 0.28482986 1.2879095  ... 1.45900038 0.44105193 1.0755623 ]
 [0.41526932 0.48772236 0.59338101 ... 0.30309415 0.44105193 0.49243937]
 [0.41527165 0.48772236 0.59338101 ... 0.30309415 0.39642699 1.2087274 ]
 ...
 [0.41137448 0.48772236 0.11573841 ... 1.17646583 0.44105193 0.98304761]
 [0.40568883 0.48772236 0.11573841 ... 1.17646583 0.4032249  0.86530163]
 [0.41292893 0.48772236 0.11573841 ... 1.17646583 0.44105193 0.66905833]]
Yukarıdaki çıktıya bakarak aykırı değerleri tespit etmek mümkün değil. Daha zekice davranacaksınız! Kendiniz için bir eşik tanımlayacak ve bu eşiği aşan aykırı değerleri tespit etmek için basit bir koşul kullanacaksınız.
threshold = 3
print(np.where(z > 3))
(array([ 55,  56,  57, 102, 141, 142, 152, 154, 155, 160, 162, 163, 199,
       200, 201, 202, 203, 204, 208, 209, 210, 211, 212, 216, 218, 219,
       220, 221, 222, 225, 234, 236, 256, 257, 262, 269, 273, 274, 276,
       277, 282, 283, 283, 284, 347, 351, 352, 353, 353, 354, 355, 356,
       357, 358, 363, 364, 364, 365, 367, 369, 370, 372, 373, 374, 374,
       380, 398, 404, 405, 406, 410, 410, 411, 412, 412, 414, 414, 415,
       416, 418, 418, 419, 423, 424, 425, 426, 427, 427, 429, 431, 436,
       437, 438, 445, 450, 454, 455, 456, 457, 466], dtype=int32), array([ 1,  1,  1, 11, 12,  3,  3,  3,  3,  3,  3,  3,  1,  1,  1,  1,  1,
        1,  3,  3,  3,  3,  3,  3,  3,  3,  3,  3,  3,  5,  3,  3,  1,  5,
        5,  3,  3,  3,  3,  3,  3,  1,  3,  1,  1,  7,  7,  1,  7,  7,  7,
        3,  3,  3,  3,  3,  5,  5,  5,  3,  3,  3, 12,  5, 12,  0,  0,  0,
        0,  5,  0, 11, 11, 11, 12,  0, 12, 11, 11,  0, 11, 11, 11, 11, 11,
       11,  0, 11, 11, 11, 11, 11, 11, 11, 11, 11, 11, 11, 11, 11],
      dtype=int32))
Yine kafa karıştırıcı bir çıktı! İlk dizi satır numaralarının listesini, ikinci dizi ise bunların ilgili sütun numaralarını içerir. Örneğin, z[55][1] değeri 3'ten büyük bir Z-skoruna sahiptir.
print(z[55][1])
3.375038763517309
Yani ZN sütunundaki 55. kayıt bir aykırı değerdir. Buradan sonrasını genişletebilirsiniz.
Z-Skorunu nasıl kullanabileceğinizi ve eşiğini ayarlayarak verideki potansiyel aykırı değerleri nasıl tespit edebileceğinizi gördünüz. Sırada kayıp değer ataması var.
Kayıp değerleriyle bilinen ünlü Pima Indian Diabetes veri setini kullanacaksınız. Ancak daha ileri gitmeden önce veri setini çalışma alanınıza yüklemeniz gerekiyor.
Veri setini data adlı bir DataFrame nesnesine yükleyeceksiniz.
data = pd.read_csv("https://raw.githubusercontent.com/jbrownlee/Datasets/master/pima-indians-diabetes.data.csv",header=None)
print(data.describe())
                0           1           2           3           4           5  \
count  768.000000  768.000000  768.000000  768.000000  768.000000  768.000000
mean     3.845052  120.894531   69.105469   20.536458   79.799479   31.992578
std      3.369578   31.972618   19.355807   15.952218  115.244002    7.884160
min      0.000000    0.000000    0.000000    0.000000    0.000000    0.000000
25%      1.000000   99.000000   62.000000    0.000000    0.000000   27.300000
50%      3.000000  117.000000   72.000000   23.000000   30.500000   32.000000
75%      6.000000  140.250000   80.000000   32.000000  127.250000   36.600000
max     17.000000  199.000000  122.000000   99.000000  846.000000   67.100000

                6           7           8
count  768.000000  768.000000  768.000000
mean     0.471876   33.240885    0.348958
std      0.331329   11.760232    0.476951
min      0.078000   21.000000    0.000000
25%      0.243750   24.000000    0.000000
50%      0.372500   29.000000    0.000000
75%      0.626250   41.000000    1.000000
max      2.420000   81.000000    1.000000
Sütun adlarının burada sayısal olduğunu fark etmiş olabilirsiniz. Bunun nedeni, önceden işlenmiş bir veri seti kullanıyor olmanız. Ama merak etmeyin, adları yakında keşfedeceksiniz.
Bu veri setinin kayıp değerlere sahip olduğu bilinir; ancak yukarıdaki istatistiklere ilk bakışta veri seti hiç kayıp değer içermiyor gibi görünebilir. Fakat daha yakından bakarsanız, bazı sütunlarda sıfır değerinin tamamen geçersiz olduğunu göreceksiniz. İşte bunlar kayıp değerlerdir.
Özellikle aşağıdaki sütunlarda minimum olarak geçersiz sıfır değeri vardır:
Bunu ham veriye bakarak doğrulayalım; örnek, verinin ilk 20 satırını yazdırır.
data.head(20)
| 0 | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | |
|---|---|---|---|---|---|---|---|---|---|
| 0 | 6 | 148 | 72 | 35 | 0 | 33.6 | 0.627 | 50 | 1 |
| 1 | 1 | 85 | 66 | 29 | 0 | 26.6 | 0.351 | 31 | 0 |
| 2 | 8 | 183 | 64 | 0 | 0 | 23.3 | 0.672 | 32 | 1 |
| 3 | 1 | 89 | 66 | 23 | 94 | 28.1 | 0.167 | 21 | 0 |
| 4 | 0 | 137 | 40 | 35 | 168 | 43.1 | 2.288 | 33 | 1 |
| 5 | 5 | 116 | 74 | 0 | 0 | 25.6 | 0.201 | 30 | 0 |
| 6 | 3 | 78 | 50 | 32 | 88 | 31.0 | 0.248 | 26 | 1 |
| 7 | 10 | 115 | 0 | 0 | 0 | 35.3 | 0.134 | 29 | 0 |
| 8 | 2 | 197 | 70 | 45 | 543 | 30.5 | 0.158 | 53 | 1 |
| 9 | 8 | 125 | 96 | 0 | 0 | 0.0 | 0.232 | 54 | 1 |
| 10 | 4 | 110 | 92 | 0 | 0 | 37.6 | 0.191 | 30 | 0 |
| 11 | 10 | 168 | 74 | 0 | 0 | 38.0 | 0.537 | 34 | 1 |
| 12 | 10 | 139 | 80 | 0 | 0 | 27.1 | 1.441 | 57 | 0 |
| 13 | 1 | 189 | 60 | 23 | 846 | 30.1 | 0.398 | 59 | 1 |
| 14 | 5 | 166 | 72 | 19 | 175 | 25.8 | 0.587 | 51 | 1 |
| 15 | 7 | 100 | 0 | 0 | 0 | 30.0 | 0.484 | 32 | 1 |
| 16 | 0 | 118 | 84 | 47 | 230 | 45.8 | 0.551 | 31 | 1 |
| 17 | 7 | 107 | 74 | 0 | 0 | 29.6 | 0.254 | 31 | 1 |
| 18 | 1 | 103 | 30 | 38 | 83 | 43.3 | 0.183 | 33 | 0 |
| 19 | 1 | 115 | 70 | 30 | 96 | 34.6 | 0.529 | 32 | 1 |
Açıkça görüldüğü gibi 2, 3, 4 ve 5. sütunlarda 0 değerleri var.
Bu veri setinde kayıp değerler 0 ile gösterildiği için, yalnızca geleneksel yollarla ele almak zor olabilir. Bununla mücadele etmek için izleyeceğiniz yaklaşımı özetleyelim:
NaN ile değiştirin.# Step 1: Get the count of zeros in each of the columns
print((data[[1,2,3,4,5]] == 0).sum())
1      5
2     35
3    227
4    374
5     11
dtype: int64
Gördüğünüz gibi 1, 2 ve 5. sütunlarda az sayıda sıfır değer varken, 3 ve 4. sütunlarda çok daha fazla, neredeyse satırların yarısında var.
# Step -2: Mark zero values as missing or NaN
data[[1,2,3,4,5]] = data[[1,2,3,4,5]].replace(0, np.NaN)

# Count the number of NaN values in each column
print(data.isnull().sum())
0      0
1      5
2     35
3    227
4    374
5     11
6      0
7      0
8      0
dtype: int64
Bu noktada NaN ile değiştirme işleminin başarılı olduğundan emin olmak için veri setinin tamamına bir göz atalım:
# Step 4
data.head(20)
| 0 | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | |
|---|---|---|---|---|---|---|---|---|---|
| 0 | 6 | 148.0 | 72.0 | 35.0 | NaN | 33.6 | 0.627 | 50 | 1 |
| 1 | 1 | 85.0 | 66.0 | 29.0 | NaN | 26.6 | 0.351 | 31 | 0 |
| 2 | 8 | 183.0 | 64.0 | NaN | NaN | 23.3 | 0.672 | 32 | 1 |
| 3 | 1 | 89.0 | 66.0 | 23.0 | 94.0 | 28.1 | 0.167 | 21 | 0 |
| 4 | 0 | 137.0 | 40.0 | 35.0 | 168.0 | 43.1 | 2.288 | 33 | 1 |
| 5 | 5 | 116.0 | 74.0 | NaN | NaN | 25.6 | 0.201 | 30 | 0 |
| 6 | 3 | 78.0 | 50.0 | 32.0 | 88.0 | 31.0 | 0.248 | 26 | 1 |
| 7 | 10 | 115.0 | NaN | NaN | NaN | 35.3 | 0.134 | 29 | 0 |
| 8 | 2 | 197.0 | 70.0 | 45.0 | 543.0 | 30.5 | 0.158 | 53 | 1 |
| 9 | 8 | 125.0 | 96.0 | NaN | NaN | NaN | 0.232 | 54 | 1 |
| 10 | 4 | 110.0 | 92.0 | NaN | NaN | 37.6 | 0.191 | 30 | 0 |
| 11 | 10 | 168.0 | 74.0 | NaN | NaN | 38.0 | 0.537 | 34 | 1 |
| 12 | 10 | 139.0 | 80.0 | NaN | NaN | 27.1 | 1.441 | 57 | 0 |
| 13 | 1 | 189.0 | 60.0 | 23.0 | 846.0 | 30.1 | 0.398 | 59 | 1 |
| 14 | 5 | 166.0 | 72.0 | 19.0 | 175.0 | 25.8 | 0.587 | 51 | 1 |
| 15 | 7 | 100.0 | NaN | NaN | NaN | 30.0 | 0.484 | 32 | 1 |
| 16 | 0 | 118.0 | 84.0 | 47.0 | 230.0 | 45.8 | 0.551 | 31 | 1 |
| 17 | 7 | 107.0 | 74.0 | NaN | NaN | 29.6 | 0.254 | 31 | 1 |
| 18 | 1 | 103.0 | 30.0 | 38.0 | 83.0 | 43.3 | 0.183 | 33 | 0 |
| 19 | 1 | 115.0 | 70.0 | 30.0 | 96.0 | 34.6 | 0.529 | 32 | 1 |
Kayıp değerleri işaretlemenin istenen etkiyi yarattığını görebilirsiniz.
Şimdiye kadar, veriler kayıp olduğunda temel eğilimleri analiz ettiniz ve bunu kontrol altına almak için basit istatistiksel önlemlerden nasıl yararlanabileceğinizi gördünüz. Şimdi, eksik değerleri ilgili sütunun ortalamasını koyarak yapılan Ortalama ile Atama yöntemiyle dolduracaksınız.
# Step 5: Call the fillna() function with the imputation strategy
data.fillna(data.mean(), inplace=True)

# Count the number of NaN values in each column to verify
print(data.isnull().sum())
0    0
1    0
2    0
3    0
4    0
5    0
6    0
7    0
8    0
dtype: int64
Harika!
Bu DataCamp makalesi, bir veri ön işleme adımı olarak veri ölçekleme uygulamasında sizi etkili şekilde yönlendirir. Mutlaka göz atın.
Sırada değişken kodlama var.
Öncesinde gerçekten sayısal olmayan veri içeren bir veri setine ihtiyacınız var. Bunun için ünlü Iris veri setini kullanacaksınız.
# Load the dataset to a DataFrame object iris
iris = pd.read_csv("http://archive.ics.uci.edu/ml/machine-learning-databases/iris/iris.data",header=None)
# See first 20 rows of the dataset
iris.head(20)
| 0 | 1 | 2 | 3 | 4 | |
|---|---|---|---|---|---|
| 0 | 5.1 | 3.5 | 1.4 | 0.2 | Iris-setosa |
| 1 | 4.9 | 3.0 | 1.4 | 0.2 | Iris-setosa |
| 2 | 4.7 | 3.2 | 1.3 | 0.2 | Iris-setosa |
| 3 | 4.6 | 3.1 | 1.5 | 0.2 | Iris-setosa |
| 4 | 5.0 | 3.6 | 1.4 | 0.2 | Iris-setosa |
| 5 | 5.4 | 3.9 | 1.7 | 0.4 | Iris-setosa |
| 6 | 4.6 | 3.4 | 1.4 | 0.3 | Iris-setosa |
| 7 | 5.0 | 3.4 | 1.5 | 0.2 | Iris-setosa |
| 8 | 4.4 | 2.9 | 1.4 | 0.2 | Iris-setosa |
| 9 | 4.9 | 3.1 | 1.5 | 0.1 | Iris-setosa |
| 10 | 5.4 | 3.7 | 1.5 | 0.2 | Iris-setosa |
| 11 | 4.8 | 3.4 | 1.6 | 0.2 | Iris-setosa |
| 12 | 4.8 | 3.0 | 1.4 | 0.1 | Iris-setosa |
| 13 | 4.3 | 3.0 | 1.1 | 0.1 | Iris-setosa |
| 14 | 5.8 | 4.0 | 1.2 | 0.2 | Iris-setosa |
| 15 | 5.7 | 4.4 | 1.5 | 0.4 | Iris-setosa |
| 16 | 5.4 | 3.9 | 1.3 | 0.4 | Iris-setosa |
| 17 | 5.1 | 3.5 | 1.4 | 0.3 | Iris-setosa |
| 18 | 5.7 | 3.8 | 1.7 | 0.3 | Iris-setosa |
| 19 | 5.1 | 3.8 | 1.5 | 0.3 | Iris-setosa |
Dize değerlerini LabelEncoder ile kolayca tamsayı değerlere dönüştürebilirsiniz. Üç sınıf değeri (Iris-setosa, Iris-versicolor, Iris-virginica) tamsayı değerlere (0, 1, 2) eşlenir.
Bu durumda, veri setinin dördüncü sütunu/özelliği sayısal olmayan değerler içeriyor. Bu yüzden onu ayırmanız gerekir.
# Convert the DataFrame to a NumPy array
iris = iris.values

# Separate
Y = iris[:,4]
# Label Encode string class values as integers
from sklearn.preprocessing import LabelEncoder

label_encoder = LabelEncoder()
label_encoder = label_encoder.fit(Y)
label_encoded_y = label_encoder.transform(Y)
Şimdi, temel istatistik bilgisinin çok kritik olduğu bir başka alanı inceleyelim.
Makine öğrenmesi modelinizi tasarladınız ve geliştirdiniz. Şimdi, modelinizin test verisi üzerindeki performansını değerlendirmek istiyorsunuz. Bu bağlamda, Kesinlik (Precision), Duyarlılık (Recall), ROC, AUC, RMSE vb. çeşitli istatistiksel ölçütlerden yararlanırsınız. Ayrıca k-katlı Çapraz Doğrulama gibi çoklu veri yeniden örnekleme tekniklerinden de destek alırsınız.
İstatistik şu amaçlarla etkili biçimde kullanılabilir:
Önemli bir not: Hipotez, öğrenme algoritmasının bir veri kümesi üzerinde çalıştırılmasının sonuçları olan öğrenilmiş modellere atıfta bulunur. Hipotezi değerlendirmek ve karşılaştırmak, öğrenilmiş modelleri karşılaştırmak anlamına gelir; bu, aynı problemden farklı örnekler veya çeşitli problemler üzerinde eğitilebilecek makine öğrenmesi algoritmalarını değerlendirmek ve karşılaştırmaktan farklıdır.
Şimdi Gauss ve Betimsel istatistikleri inceleyelim.
Bir veri örneği, bir alan veya süreç tarafından alınabilecek ya da üretilebilecek tüm potansiyel gözlemlerden daha geniş bir popülasyonun anlık görüntüsünden ibarettir.
İlginç bir şekilde, birçok gözlem tipik bir örüntüye veya dağılıma uyar; buna normal dağılım veya daha resmî olarak Gauss dağılımı denir. Muhtemelen aşina olduğunuz çan eğrisi biçimindeki dağılımdır. Aşağıdaki şekil bir Gauss dağılımını gösterir:
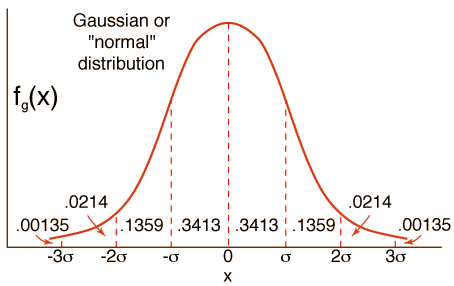
Kaynak: HyperPhysics
Gauss süreçleri ve Gauss dağılımları başlı başına başka alt alanlardır. Ancak şimdi, genel olarak Gauss dağılımlarının tüm dünyasını inşa eden en temel iki bileşeni inceleyeceksiniz.
Gauss dağılımından alınan herhangi bir örnek veri iki parametreyle özetlenebilir:
Varyans terimi, bir diğer kritik terimi doğurur; o da varyansın karekökü olan standart sapmadır.
Ortalama, varyans ve standart sapma, veri örneklerinden doğrudan numpy kullanılarak hesaplanabilir.
Önce, ortalaması 50 ve standart sapması 5 olan bir Gauss dağılımından çekilen 100 rastgele sayı örneği üreteceksiniz. Ardından özet istatistikleri hesaplayacaksınız.
İlk olarak tüm bağımlılıkları içe aktaracaksınız.
#  Dependencies
from numpy.random import seed
from numpy.random import randn
from numpy import mean
from numpy import var
from numpy import std
Sonraki adımda, sonuçlarınızın tekrar üretilebilir olması için rastgele sayı üreteci tohumunu ayarlayın.
seed(1)
# Generate univariate observations
data = 5 * randn(10000) + 50
# Calculate statistics
print('Mean: %.3f' % mean(data))
print('Variance: %.3f' % var(data))
print('Standard Deviation: %.3f' % std(data))
Mean: 50.049
Variance: 24.939
Standard Deviation: 4.994
Yeterince yakın, öyle değil mi?
Şimdi sıradaki konuyu inceleyelim.
Genel olarak, bir veri kümesinde yer alan özellikler pratikte sıklıkla birbirleriyle ilişkili olabilir. İstatistiksel olarak, veri kümenizdeki özellikler arasındaki bu ilişki (basit ya da karmaşık olsun) genellikle korelasyon olarak adlandırılır.
Bir veri kümesindeki özelliklerin korelasyon derecesini bulmak kritik önemdedir. Bu adım esasen, bir veri kümesinden en önemli özelliklerin seçilmesiyle ilgilenen özellik seçimi olarak hizmet eder. Bu adım, standart bir makine öğrenmesi hattının en hayati adımlarından biridir; zira çok daha kısa sürede kayda değer bir doğruluk artışı sağlayabilir.
Daha iyi anlamak ve pratiğe yakın tutmak için özelliklerin neden birbirleriyle ilişkili olabileceğini açıklayalım:
Özellikler arasındaki korelasyon üç tür olabilir: - Pozitif korelasyon (her iki özellik de aynı yönde değişir), Yansız (nötr) korelasyon (iki özelliğin değişimi arasında ilişki yoktur), Negatif korelasyon (iki özellik zıt yönlerde değişir).
Korelasyon ölçümleri, filtre tabanlı özellik seçimi tekniklerinin temelini oluşturur. Özellik seçimi hakkında daha fazla çalışmak isterseniz bu makaleye göz atın.
İki değişkenin örnekleri arasındaki ilişkiyi, yöntemin geliştiricisi Karl Pearson'ın adını taşıyan istatistiksel bir yöntem olan Pearson korelasyon katsayısı ile matematiksel olarak ifade edebilirsiniz.
Pearson korelasyon puanını, pandas'ın corr() fonksiyonunu method parametresi pearson olacak şekilde kullanarak hesaplayabilirsiniz. Daha önce kullandığınız Pima Indians Diabetes veri setindeki özellikler arasındaki korelasyonu inceleyelim. Verileriniz zaten iyi durumda.
# Data
data.head()
| 0 | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | |
|---|---|---|---|---|---|---|---|---|---|
| 0 | 6 | 148.0 | 72.0 | 35.00000 | 155.548223 | 33.6 | 0.627 | 50 | 1 |
| 1 | 1 | 85.0 | 66.0 | 29.00000 | 155.548223 | 26.6 | 0.351 | 31 | 0 |
| 2 | 8 | 183.0 | 64.0 | 29.15342 | 155.548223 | 23.3 | 0.672 | 32 | 1 |
| 3 | 1 | 89.0 | 66.0 | 23.00000 | 94.000000 | 28.1 | 0.167 | 21 | 0 |
| 4 | 0 | 137.0 | 40.0 | 35.00000 | 168.000000 | 43.1 | 2.288 | 33 | 1 |
# Create the matrix of correlation score between the features and the label
scoreTable = data.corr(method='pearson')
# Visulaize the matrix
data.corr(method='pearson').style.format("{:.2}").background_gradient(cmap=plt.get_cmap('coolwarm'), axis=1)

Veri setindeki tüm özelliklerle etiket arasındaki Pearson korelasyonunu açıkça görebilirsiniz.
Bir sonraki bölümde parametrik olmayan istatistikleri inceleyeceksiniz.
İstatistik ve istatistiksel yöntemlerin geniş bir kısmı, dağılımın bilindiği verilere adanmıştır.
Parametrik olmayan istatistikler, popülasyon parametreleri hakkında az ya da hiç bilgi olmadığında işe yarar. Parametrik olmayan testler, veri dağılımı hakkında hiçbir varsayımda bulunmaz.
Parametrik olmayan verilerle çalıştığınız durumda, dağılıma ilişkin tüm bilgileri göz ardı eden özel parametrik olmayan istatistiksel yöntemler kullanılabilir. Bu nedenle bu yöntemlere sıklıkla dağılımdan bağımsız yöntemler denir.
Ancak bir parametrik olmayan istatistiksel yöntem uygulanmadan önce, veriler sıralama (rank) biçimine dönüştürülmelidir. Verilerin sıralama biçiminde olmasını bekleyen istatistiksel yöntemlere bazen rank istatistikleri denir. Rank istatistiklerine örnek olarak rank korelasyonu ve rank istatistiksel hipotez testleri verilebilir. Verilerin sıralanması, adından da anlaşılacağı gibidir.
İki bağımsız örneklem arasında fark olup olmadığını kontrol etmek için yaygın olarak kullanılan parametrik olmayan bir istatistiksel hipotez testi, Henry Mann ve Donald Whitney'nin adını taşıyan Mann-Whitney U testidir.
Bu testi Python'da SciPy tarafından sağlanan mannwhitneyu() ile uygulayacaksınız.
# The dependencies that you need
from scipy.stats import mannwhitneyu
from numpy.random import rand

# seed the random number generator
seed(1)
# Generate two independent samples
data1 = 50 + (rand(100) * 10)
data2 = 51 + (rand(100) * 10)
# Compare samples
stat, p = mannwhitneyu(data1, data2)
print('Statistics = %.3f, p = %.3f' % (stat, p))
# Interpret
alpha = 0.05
if p > alpha:
    print('Same distribution (fail to reject H0)')
else:
    print('Different distribution (reject H0)')
Statistics = 4077.000, p = 0.012
Different distribution (reject H0)
alpha, sizin tarafınızdan belirlenen eşik parametresidir. mannwhitneyu() iki şey döndürür:
istatistik: Mann-Whitney U istatistiği; alternative None ise min(U for x, U for y) değerine eşittir (kullanımdan kaldırılmıştır; geriye dönük uyumluluk için vardır), aksi halde y için U değerini verir.
p-değeri: Asimptotik normal dağılım varsayımı altında p-değeri.
Parametrik olmayan istatistiğin diğer yöntemlerini incelemek isterseniz buradan bakabilirsiniz.
Kullanabileceğiniz diğer iki popüler parametrik olmayan istatistiksel anlamlılık testi şunlardır:
Nihayet sona geldiniz. Bu yazıda, makine öğrenmesi projelerinizde çok kritik rol oynayan çeşitli temel istatistiksel kavramları incelediniz. Dolayısıyla bunları anlamak bir o kadar önemlidir.
İstatistiğe basit bir girişten, çeşitli uygulamalarla sıralı istatistiklere kadar ilerlediniz. Bu kesinlikle kayda değer bir başarı. Üç farklı veri setini incelediniz, pandas ve numpy işlevlerini sonuna kadar kullandınız ve ayrıca SciPy de kullandınız. İlerlemek isterseniz aşağıda bazı bağlantılar var:
Bu blogu yazarken yararlandığım kaynaklar şunlardır:
Görüşlerinizi/sorularınızı yorumlarda paylaşın. Ayrıca, oldukça pratik bir yaklaşıma sahip olan DataCamp'in "Python'da İstatistiksel Düşünme" kursuna da göz atın.
Python kursları
Kurs
Kurs
Kurs
blog
Dario Radečić
15 dk.
blog
Abid Ali Awan
14 dk.
Eğitim
Adel Nehme
Eğitim
Kurtis Pykes
8 dk.




