Khóa học
Nhập môn Python
4 giờ
7.1M
Nếu bạn mới có ít kinh nghiệm áp dụng thuật toán machine learning, hẳn bạn đã nhận ra rằng việc này không đòi hỏi phải biết trước về Thống kê.
Tuy vậy, nắm một số kiến thức thống kê sẽ có lợi để hiểu machine learning cả về mặt kỹ thuật lẫn trực giác. Cuối cùng thì, khi bạn muốn bắt đầu kiểm định và diễn giải kết quả của mình, kiến thức thống kê sẽ trở nên cần thiết. Suy cho cùng, hễ có dữ liệu là có thống kê. Giống như Toán học là ngôn ngữ của Khoa học, Thống kê là một kiểu ngôn ngữ dành cho Khoa học Dữ liệu và Machine Learning.
Thống kê là một lĩnh vực của toán học với nhiều lý thuyết và phát hiện. Tuy nhiên, nhiều khái niệm, công cụ, kỹ thuật và ký hiệu từ lĩnh vực này đã được vận dụng để tạo nên machine learning ngày nay. Bạn có thể dùng các phương pháp thống kê mô tả để biến các quan sát thành thông tin hữu ích mà bạn có thể hiểu và chia sẻ. Bạn có thể dùng các kỹ thuật thống kê suy luận để suy ra từ các mẫu dữ liệu nhỏ cho cả miền dữ liệu. Phần sau của bài viết, bạn sẽ học về thống kê mô tả và thống kê suy luận. Vậy nên, đừng lo.
Trước khi bắt đầu, hãy điểm qua mười ví dụ nơi các phương pháp thống kê được dùng trong một dự án machine learning ứng dụng:
Nguồn: Statistical Methods for Machine Learning
Thú vị phải không?
Bài viết này sẽ cung cấp cho bạn nền tảng vững chắc về những thống kê cơ bản nhưng cần thiết để trở thành một người thực hành machine learning giỏi.
Trong bài viết này, bạn sẽ học:
Có khá nhiều nội dung và tất cả đều quan trọng như nhau. Bắt đầu thôi!
Hãy ngắn gọn xem định nghĩa thống kê một cách đơn giản.
Thống kê được coi là một phân ngành của toán học. Nó đề cập đến vô số phương pháp làm việc với dữ liệu và sử dụng dữ liệu đó để trả lời nhiều loại câu hỏi.
Khi xét đến các công cụ thống kê dùng trong thực tế, chia lĩnh vực thống kê thành hai nhóm phương pháp rộng có thể giúp ích: thống kê mô tả để tóm tắt dữ liệu, và thống kê suy luận để rút kết luận từ mẫu dữ liệu (Statistics for Machine Learning (7-Day Mini-Course).

Nguồn: IntellSpot
Thống kê suy luận: Là các phương pháp giúp định lượng các thuộc tính của miền hay quần thể từ một tập quan sát nhỏ hơn gọi là mẫu. Dưới đây là một đồ họa thông tin minh họa đẹp về thống kê suy luận:
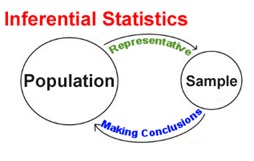
Nguồn: Analytics Vidhya
Ở phần tiếp theo, bạn sẽ học cách dùng thống kê để chuẩn bị dữ liệu.
Các phương pháp thống kê là cần thiết khi xây dựng dữ liệu huấn luyện và kiểm tra cho mô hình machine learning của bạn.
Điều này bao gồm các kỹ thuật:
Cần có hiểu biết cơ bản về phân phối dữ liệu, thống kê mô tả và trực quan hóa dữ liệu để giúp bạn xác định phương pháp nên chọn khi thực hiện những tác vụ này.
Hãy lần lượt phân tích ngắn gọn từng điểm trên.
Trước hết, ngoại lai là gì.
Ngoại lai được coi là một quan sát có vẻ lệch hẳn so với các quan sát khác trong mẫu. Hình sau làm rõ định nghĩa này hơn.

Nguồn: MathWorks
Bạn có thể nhận ra các ngoại lai trong dữ liệu như trong hình trên.
Nhiều thuật toán machine learning nhạy cảm với khoảng và phân phối của các giá trị thuộc tính trong dữ liệu đầu vào. Ngoại lai trong dữ liệu đầu vào có thể làm lệch và gây nhiễu quá trình huấn luyện của thuật toán, dẫn tới thời gian huấn luyện lâu hơn, mô hình kém chính xác hơn và rốt cuộc là kết quả tầm thường hơn.
Nhận diện ngoại lai tiềm năng là thiết yếu vì các lý do sau:
Ngoại lai có thể cho thấy dữ liệu bị lỗi. Ví dụ, dữ liệu có thể được mã sai, hoặc thí nghiệm chạy không đúng. Nếu xác định được điểm ngoại lai thực sự là lỗi, thì giá trị đó nên được loại khỏi phân tích. Nếu có thể sửa thì đó là một lựa chọn khác.
Đôi khi không thể xác định liệu một điểm ngoại lai có phải là dữ liệu xấu không. Ngoại lai có thể do nhiễu ngẫu nhiên hoặc có thể gợi ý điều gì đó thú vị về mặt khoa học. Dù thế nào, bạn thường không nên đơn giản xóa bỏ quan sát ngoại lai. Tuy nhiên, nếu dữ liệu chứa nhiều ngoại lai đáng kể, bạn có thể cần xem xét dùng các kỹ thuật thống kê vững.
Vì vậy, ngoại lai thường không tốt cho các mô hình dự báo của bạn (mặc dù đôi khi có thể tận dụng chúng như một lợi thế, nhưng điều đó nằm ngoài phạm vi bài viết này). Bạn cần hiểu biết thống kê để xử lý ngoại lai hiệu quả.
Phần lớn các tập dữ liệu hiện nay gặp vấn đề giá trị thiếu. Mô hình machine learning của bạn có thể không được huấn luyện hiệu quả nếu dữ liệu đưa vào chứa giá trị thiếu. Lúc này, các công cụ và kỹ thuật thống kê sẽ giải cứu bạn.
Nhiều người có xu hướng loại bỏ những bản ghi chứa giá trị thiếu. Nhưng đó không phải thực hành tốt vì trong quá trình đó bạn có thể mất các đặc trưng/biểu diễn quan trọng của dữ liệu. Mặc dù có những phương pháp nâng cao để xử lý giá trị thiếu, các kỹ thuật nhanh mà người ta thường dùng là: bù trung bình (Mean Imputation) và bù trung vị (Median Imputation).
Điều tối quan trọng là bạn hiểu trung bình và trung vị là gì.
Giả sử bạn có một đặc trưng X1 với các giá trị - 13, 18, 13, 14, 13, 16, 14, 21, 13
Trung bình là số trung bình cộng, vậy ta cộng rồi chia:
(13 + 18 + 13 + 14 + 13 + 16 + 14 + 21 + 13) / 9 = 15
Lưu ý rằng trung bình trong trường hợp này không phải là một giá trị từ danh sách ban đầu. Đây là kết quả thường gặp. Bạn không nên giả định trung bình sẽ là một trong các số gốc.
Trung vị là giá trị ở giữa, nên trước hết bạn phải sắp xếp lại danh sách theo thứ tự số:
13, 13, 13, 13, 14, 14, 16, 18, 21
Có chín số trong danh sách, vậy số ở giữa sẽ là số thứ (9 + 1) / 2 = 10 / 2 = 5:
13, 13, 13, 13, 14, 14, 16, 18, 21
Vậy trung vị là 14.
Dữ liệu được coi là “tiền tệ” của machine learning ứng dụng. Do đó, cả việc thu thập lẫn sử dụng đều quan trọng như nhau.
Lấy mẫu dữ liệu là các phương pháp thống kê để chọn các quan sát từ miền dữ liệu với mục tiêu ước lượng một tham số quần thể. Nói cách khác, lấy mẫu là quá trình chủ động thu thập quan sát với chủ đích ước lượng một biến của quần thể.
Mỗi hàng của tập dữ liệu đại diện cho một quan sát cho thấy đặc điểm của một quần thể cụ thể. Khi làm việc với dữ liệu, bạn thường không thể tiếp cận mọi quan sát có thể. Có thể vì nhiều lý do, ví dụ:
Nhiều khi, bạn sẽ không có đúng tỷ lệ mẫu dữ liệu. Vậy nên, bạn sẽ phải under-sample hoặc over-sample tùy theo loại vấn đề.
Bạn under-sample khi số mẫu dữ liệu của một hạng mục nào đó quá cao so với các hạng mục khác, tức là bạn loại bớt một số mẫu khỏi hạng mục có số lượng lớn. Bạn over-sample khi số mẫu dữ liệu của một loại nào đó rất thấp so với loại khác. Khi đó, bạn tạo thêm mẫu dữ liệu.
Điều này cũng áp dụng cho các bài toán đa lớp.
Lấy mẫu thống kê là một lĩnh vực lớn, nhưng trong machine learning ứng dụng, có ba kiểu lấy mẫu bạn có thể hay dùng: lấy mẫu ngẫu nhiên đơn giản, lấy mẫu hệ thống và lấy mẫu phân tầng.
Mặc dù đây là những kiểu lấy mẫu phổ biến mà bạn có thể gặp, vẫn còn các kỹ thuật khác (A Gentle Introduction to Statistical Sampling and Resampling).
Thường thì các đặc trưng trong tập dữ liệu của bạn có thể khác nhau rất nhiều về khoảng giá trị. Một số đặc trưng có thang đo từ 0 đến 100, trong khi số khác có khoảng 0.01 - 0.001, 10000 - 20000, v.v.
Điều này gây rắc rối cho việc mô hình hóa hiệu quả. Bởi vì một thay đổi nhỏ ở đặc trưng có khoảng giá trị thấp có thể không có tác động đáng kể lên những đặc trưng khác. Nó ảnh hưởng tới quá trình học tốt. Xử lý vấn đề này được gọi là chuẩn hóa/thu nhỏ dữ liệu.
Có nhiều kỹ thuật chuẩn hóa dữ liệu như Min-Max, chuẩn hóa tuyệt đối, chuẩn hóa chuẩn (Standard scaling), v.v.
Đôi khi tập dữ liệu của bạn chứa cả dữ liệu số và phi số. Nhiều framework machine learning như scikit-learn kỳ vọng toàn bộ dữ liệu ở dạng số. Điều này cũng giúp tăng tốc tính toán.
Một lần nữa, thống kê đến cứu bạn.
Các kỹ thuật như Label encoding, One-Hot encoding, v.v. được dùng để chuyển dữ liệu phi số thành số.
Bạn đã đi qua khá nhiều lý thuyết. Giờ hãy áp dụng một vài kỹ thuật để cảm nhận thực tế.
Bạn sẽ bắt đầu bằng cách áp dụng một số phương pháp thống kê để phát hiện Ngoại lai.
Bạn sẽ dùng chỉ số Z-Score để phát hiện ngoại lai, và cho việc này, bạn sẽ khảo sát tập dữ liệu Boston House Price. Hãy bắt đầu bằng cách nhập dữ liệu từ tiện ích của sklearn, và trong quá trình đó, bạn sẽ học các khái niệm cần thiết.
import pandas as pd
import numpy as np
from sklearn.datasets import load_boston

# Load the Boston dataset into a variable called boston
boston = load_boston()
# Separate the features from the target
x = boston.data
y = boston.target
Để xem dữ liệu ở dạng bảng chuẩn với đầy đủ tên đặc trưng, bạn sẽ chuyển nó thành một dataframe của pandas.
# Take the columns separately in a variable
columns = boston.feature_names

# Create the dataframe
boston_df = pd.DataFrame(boston.data)
boston_df.columns = columns
boston_df.head()

Thông lệ là bắt đầu với phân tích ngoại lai đơn biến, nơi bạn xem xét từng đặc trưng một. Thường thì một box-plot đơn giản của một đặc trưng có thể cho bạn điểm khởi đầu tốt. Bạn sẽ tạo box-plot bằng seaborn và dùng đặc trưng DIS.
import seaborn as sns
sns.boxplot(x=boston_df['DIS'])

import matplotlib.pyplot as plt
plt.show()
<matplotlib.axes._subplots.AxesSubplot at 0x8abded0>

Để hiển thị box-plot, bạn đã import thêm matplotlib vì biểu đồ seaborn hiển thị như biểu đồ matplotlib thông thường.
Biểu đồ trên cho thấy ba điểm giữa 10 đến 12, đây là các ngoại lai vì chúng không nằm trong hộp của các quan sát khác. Ở đây bạn phân tích ngoại lai đơn biến, tức là bạn chỉ dùng đặc trưng DIS để kiểm tra ngoại lai.
Giờ hãy tiếp tục với Z-Score.
"Z-score là số có dấu cho biết một quan sát hoặc điểm dữ liệu nằm cao hơn giá trị trung bình bao nhiêu độ lệch chuẩn của những gì đang được quan sát hoặc đo lường." - Wikipedia
Ý tưởng đằng sau Z-score là mô tả bất kỳ điểm dữ liệu nào theo mối quan hệ của nó với Độ lệch chuẩn và Trung bình của nhóm điểm dữ liệu. Z-score nhằm đưa phân phối dữ liệu về trung bình 0 và độ lệch chuẩn 1, tức là phân phối chuẩn.
Khoan! Điều này giúp nhận diện ngoại lai bằng cách nào?
Khi tính Z-score, bạn chuẩn hóa và đặt tâm dữ liệu (trung bình 0 và độ lệch chuẩn 1) và tìm các điểm cách xa 0 quá mức. Những điểm dữ liệu quá xa 0 được coi là ngoại lai. Trong hầu hết trường hợp, ngưỡng 3 hoặc -3 được dùng. Ví dụ, nếu giá trị Z-score lớn hơn 3 hoặc nhỏ hơn -3. Điểm dữ liệu này sẽ được nhận diện là ngoại lai.
Bạn sẽ dùng hàm Z-score được định nghĩa trong thư viện scipy để phát hiện ngoại lai.
from scipy import stats

z = np.abs(stats.zscore(boston_df))
print(z)
[[0.41771335 0.28482986 1.2879095  ... 1.45900038 0.44105193 1.0755623 ]
 [0.41526932 0.48772236 0.59338101 ... 0.30309415 0.44105193 0.49243937]
 [0.41527165 0.48772236 0.59338101 ... 0.30309415 0.39642699 1.2087274 ]
 ...
 [0.41137448 0.48772236 0.11573841 ... 1.17646583 0.44105193 0.98304761]
 [0.40568883 0.48772236 0.11573841 ... 1.17646583 0.4032249  0.86530163]
 [0.41292893 0.48772236 0.11573841 ... 1.17646583 0.44105193 0.66905833]]
Không thể phát hiện ngoại lai chỉ bằng cách nhìn vào đầu ra trên. Bạn thông minh hơn! Bạn sẽ tự đặt ngưỡng và dùng một điều kiện đơn giản để phát hiện các ngoại lai vượt ngưỡng.
threshold = 3
print(np.where(z > 3))
(array([ 55,  56,  57, 102, 141, 142, 152, 154, 155, 160, 162, 163, 199,
       200, 201, 202, 203, 204, 208, 209, 210, 211, 212, 216, 218, 219,
       220, 221, 222, 225, 234, 236, 256, 257, 262, 269, 273, 274, 276,
       277, 282, 283, 283, 284, 347, 351, 352, 353, 353, 354, 355, 356,
       357, 358, 363, 364, 364, 365, 367, 369, 370, 372, 373, 374, 374,
       380, 398, 404, 405, 406, 410, 410, 411, 412, 412, 414, 414, 415,
       416, 418, 418, 419, 423, 424, 425, 426, 427, 427, 429, 431, 436,
       437, 438, 445, 450, 454, 455, 456, 457, 466], dtype=int32), array([ 1,  1,  1, 11, 12,  3,  3,  3,  3,  3,  3,  3,  1,  1,  1,  1,  1,
        1,  3,  3,  3,  3,  3,  3,  3,  3,  3,  3,  3,  5,  3,  3,  1,  5,
        5,  3,  3,  3,  3,  3,  3,  1,  3,  1,  1,  7,  7,  1,  7,  7,  7,
        3,  3,  3,  3,  3,  5,  5,  5,  3,  3,  3, 12,  5, 12,  0,  0,  0,
        0,  5,  0, 11, 11, 11, 12,  0, 12, 11, 11,  0, 11, 11, 11, 11, 11,
       11,  0, 11, 11, 11, 11, 11, 11, 11, 11, 11, 11, 11, 11, 11],
      dtype=int32))
Lại là một đầu ra gây bối rối! Mảng đầu chứa danh sách số hàng và mảng sau chứa số cột tương ứng. Ví dụ, z[55][1] có Z-score lớn hơn 3.
print(z[55][1])
3.375038763517309
Vậy bản ghi thứ 55 ở cột ZN là ngoại lai. Bạn có thể mở rộng từ đây.
Bạn đã thấy cách dùng Z-Score và đặt ngưỡng để phát hiện các ngoại lai tiềm năng trong dữ liệu. Tiếp theo, bạn sẽ xem cách thực hiện bù khuyết giá trị thiếu.
Bạn sẽ dùng tập dữ liệu nổi tiếng Pima Indian Diabetes vốn được biết là có giá trị thiếu. Nhưng trước khi đi xa hơn, bạn sẽ nạp tập dữ liệu vào không gian làm việc.
Bạn sẽ nạp dữ liệu vào một đối tượng DataFrame tên data.
data = pd.read_csv("https://raw.githubusercontent.com/jbrownlee/Datasets/master/pima-indians-diabetes.data.csv",header=None)
print(data.describe())
                0           1           2           3           4           5  \
count  768.000000  768.000000  768.000000  768.000000  768.000000  768.000000
mean     3.845052  120.894531   69.105469   20.536458   79.799479   31.992578
std      3.369578   31.972618   19.355807   15.952218  115.244002    7.884160
min      0.000000    0.000000    0.000000    0.000000    0.000000    0.000000
25%      1.000000   99.000000   62.000000    0.000000    0.000000   27.300000
50%      3.000000  117.000000   72.000000   23.000000   30.500000   32.000000
75%      6.000000  140.250000   80.000000   32.000000  127.250000   36.600000
max     17.000000  199.000000  122.000000   99.000000  846.000000   67.100000

                6           7           8
count  768.000000  768.000000  768.000000
mean     0.471876   33.240885    0.348958
std      0.331329   11.760232    0.476951
min      0.078000   21.000000    0.000000
25%      0.243750   24.000000    0.000000
50%      0.372500   29.000000    0.000000
75%      0.626250   41.000000    1.000000
max      2.420000   81.000000    1.000000
Có thể bạn đã để ý rằng tên cột ở đây là số. Đó là vì bạn đang dùng một tập dữ liệu đã được tiền xử lý. Nhưng đừng lo, bạn sẽ khám phá tên ngay.
Tập dữ liệu này được biết là có giá trị thiếu, nhưng khi nhìn nhanh vào thống kê trên, có thể bạn thấy như không có giá trị thiếu nào. Tuy nhiên, nếu nhìn kỹ, bạn sẽ thấy có một số cột mà giá trị 0 là hoàn toàn vô lý. Đây chính là các giá trị thiếu.
Cụ thể, các cột dưới đây có giá trị tối thiểu là 0 không hợp lệ:
Hãy xác nhận điều này bằng cách xem dữ liệu thô, ví dụ sau in ra 20 hàng đầu tiên.
data.head(20)
| 0 | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | |
|---|---|---|---|---|---|---|---|---|---|
| 0 | 6 | 148 | 72 | 35 | 0 | 33.6 | 0.627 | 50 | 1 |
| 1 | 1 | 85 | 66 | 29 | 0 | 26.6 | 0.351 | 31 | 0 |
| 2 | 8 | 183 | 64 | 0 | 0 | 23.3 | 0.672 | 32 | 1 |
| 3 | 1 | 89 | 66 | 23 | 94 | 28.1 | 0.167 | 21 | 0 |
| 4 | 0 | 137 | 40 | 35 | 168 | 43.1 | 2.288 | 33 | 1 |
| 5 | 5 | 116 | 74 | 0 | 0 | 25.6 | 0.201 | 30 | 0 |
| 6 | 3 | 78 | 50 | 32 | 88 | 31.0 | 0.248 | 26 | 1 |
| 7 | 10 | 115 | 0 | 0 | 0 | 35.3 | 0.134 | 29 | 0 |
| 8 | 2 | 197 | 70 | 45 | 543 | 30.5 | 0.158 | 53 | 1 |
| 9 | 8 | 125 | 96 | 0 | 0 | 0.0 | 0.232 | 54 | 1 |
| 10 | 4 | 110 | 92 | 0 | 0 | 37.6 | 0.191 | 30 | 0 |
| 11 | 10 | 168 | 74 | 0 | 0 | 38.0 | 0.537 | 34 | 1 |
| 12 | 10 | 139 | 80 | 0 | 0 | 27.1 | 1.441 | 57 | 0 |
| 13 | 1 | 189 | 60 | 23 | 846 | 30.1 | 0.398 | 59 | 1 |
| 14 | 5 | 166 | 72 | 19 | 175 | 25.8 | 0.587 | 51 | 1 |
| 15 | 7 | 100 | 0 | 0 | 0 | 30.0 | 0.484 | 32 | 1 |
| 16 | 0 | 118 | 84 | 47 | 230 | 45.8 | 0.551 | 31 | 1 |
| 17 | 7 | 107 | 74 | 0 | 0 | 29.6 | 0.254 | 31 | 1 |
| 18 | 1 | 103 | 30 | 38 | 83 | 43.3 | 0.183 | 33 | 0 |
| 19 | 1 | 115 | 70 | 30 | 96 | 34.6 | 0.529 | 32 | 1 |
Rõ ràng có các giá trị 0 ở các cột 2, 3, 4 và 5.
Vì tập dữ liệu này có giá trị thiếu được ký hiệu là 0, nên xử lý chỉ bằng các cách thông thường có thể sẽ khó. Hãy tóm tắt cách tiếp cận bạn sẽ theo để xử lý:
NaN.# Step 1: Get the count of zeros in each of the columns
print((data[[1,2,3,4,5]] == 0).sum())
1      5
2     35
3    227
4    374
5     11
dtype: int64
Bạn có thể thấy các cột 1, 2 và 5 chỉ có vài giá trị 0, trong khi các cột 3 và 4 có nhiều hơn nhiều, gần một nửa số hàng.
# Step -2: Mark zero values as missing or NaN
data[[1,2,3,4,5]] = data[[1,2,3,4,5]].replace(0, np.NaN)

# Count the number of NaN values in each column
print(data.isnull().sum())
0      0
1      5
2     35
3    227
4    374
5     11
6      0
7      0
8      0
dtype: int64
Hãy chắc chắn ở thời điểm này rằng việc thay bằng NaN đã thành công bằng cách nhìn vào toàn bộ tập dữ liệu:
# Step 4
data.head(20)
| 0 | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | |
|---|---|---|---|---|---|---|---|---|---|
| 0 | 6 | 148.0 | 72.0 | 35.0 | NaN | 33.6 | 0.627 | 50 | 1 |
| 1 | 1 | 85.0 | 66.0 | 29.0 | NaN | 26.6 | 0.351 | 31 | 0 |
| 2 | 8 | 183.0 | 64.0 | NaN | NaN | 23.3 | 0.672 | 32 | 1 |
| 3 | 1 | 89.0 | 66.0 | 23.0 | 94.0 | 28.1 | 0.167 | 21 | 0 |
| 4 | 0 | 137.0 | 40.0 | 35.0 | 168.0 | 43.1 | 2.288 | 33 | 1 |
| 5 | 5 | 116.0 | 74.0 | NaN | NaN | 25.6 | 0.201 | 30 | 0 |
| 6 | 3 | 78.0 | 50.0 | 32.0 | 88.0 | 31.0 | 0.248 | 26 | 1 |
| 7 | 10 | 115.0 | NaN | NaN | NaN | 35.3 | 0.134 | 29 | 0 |
| 8 | 2 | 197.0 | 70.0 | 45.0 | 543.0 | 30.5 | 0.158 | 53 | 1 |
| 9 | 8 | 125.0 | 96.0 | NaN | NaN | NaN | 0.232 | 54 | 1 |
| 10 | 4 | 110.0 | 92.0 | NaN | NaN | 37.6 | 0.191 | 30 | 0 |
| 11 | 10 | 168.0 | 74.0 | NaN | NaN | 38.0 | 0.537 | 34 | 1 |
| 12 | 10 | 139.0 | 80.0 | NaN | NaN | 27.1 | 1.441 | 57 | 0 |
| 13 | 1 | 189.0 | 60.0 | 23.0 | 846.0 | 30.1 | 0.398 | 59 | 1 |
| 14 | 5 | 166.0 | 72.0 | 19.0 | 175.0 | 25.8 | 0.587 | 51 | 1 |
| 15 | 7 | 100.0 | NaN | NaN | NaN | 30.0 | 0.484 | 32 | 1 |
| 16 | 0 | 118.0 | 84.0 | 47.0 | 230.0 | 45.8 | 0.551 | 31 | 1 |
| 17 | 7 | 107.0 | 74.0 | NaN | NaN | 29.6 | 0.254 | 31 | 1 |
| 18 | 1 | 103.0 | 30.0 | 38.0 | 83.0 | 43.3 | 0.183 | 33 | 0 |
| 19 | 1 | 115.0 | 70.0 | 30.0 | 96.0 | 34.6 | 0.529 | 32 | 1 |
Bạn có thể thấy việc đánh dấu giá trị thiếu đã mang lại hiệu quả mong muốn.
Đến giờ, bạn đã phân tích các xu hướng cốt yếu khi dữ liệu bị thiếu và cách tận dụng các thước đo thống kê đơn giản để xử lý. Giờ, bạn sẽ bù khuyết các giá trị thiếu bằng bù trung bình, tức là điền trung bình của cột tương ứng vào chỗ giá trị thiếu.
# Step 5: Call the fillna() function with the imputation strategy
data.fillna(data.mean(), inplace=True)

# Count the number of NaN values in each column to verify
print(data.isnull().sum())
0    0
1    0
2    0
3    0
4    0
5    0
6    0
7    0
8    0
dtype: int64
Tuyệt vời!
Bài viết DataCamp này hướng dẫn hiệu quả cách bạn triển khai chuẩn hóa dữ liệu như một bước tiền xử lý. Nhớ xem nhé.
Tiếp theo, bạn sẽ làm mã hóa biến.
Trước đó, bạn cần một tập dữ liệu thực sự chứa dữ liệu phi số. Bạn sẽ dùng tập Iris nổi tiếng cho việc này.
# Load the dataset to a DataFrame object iris
iris = pd.read_csv("http://archive.ics.uci.edu/ml/machine-learning-databases/iris/iris.data",header=None)
# See first 20 rows of the dataset
iris.head(20)
| 0 | 1 | 2 | 3 | 4 | |
|---|---|---|---|---|---|
| 0 | 5.1 | 3.5 | 1.4 | 0.2 | Iris-setosa |
| 1 | 4.9 | 3.0 | 1.4 | 0.2 | Iris-setosa |
| 2 | 4.7 | 3.2 | 1.3 | 0.2 | Iris-setosa |
| 3 | 4.6 | 3.1 | 1.5 | 0.2 | Iris-setosa |
| 4 | 5.0 | 3.6 | 1.4 | 0.2 | Iris-setosa |
| 5 | 5.4 | 3.9 | 1.7 | 0.4 | Iris-setosa |
| 6 | 4.6 | 3.4 | 1.4 | 0.3 | Iris-setosa |
| 7 | 5.0 | 3.4 | 1.5 | 0.2 | Iris-setosa |
| 8 | 4.4 | 2.9 | 1.4 | 0.2 | Iris-setosa |
| 9 | 4.9 | 3.1 | 1.5 | 0.1 | Iris-setosa |
| 10 | 5.4 | 3.7 | 1.5 | 0.2 | Iris-setosa |
| 11 | 4.8 | 3.4 | 1.6 | 0.2 | Iris-setosa |
| 12 | 4.8 | 3.0 | 1.4 | 0.1 | Iris-setosa |
| 13 | 4.3 | 3.0 | 1.1 | 0.1 | Iris-setosa |
| 14 | 5.8 | 4.0 | 1.2 | 0.2 | Iris-setosa |
| 15 | 5.7 | 4.4 | 1.5 | 0.4 | Iris-setosa |
| 16 | 5.4 | 3.9 | 1.3 | 0.4 | Iris-setosa |
| 17 | 5.1 | 3.5 | 1.4 | 0.3 | Iris-setosa |
| 18 | 5.7 | 3.8 | 1.7 | 0.3 | Iris-setosa |
| 19 | 5.1 | 3.8 | 1.5 | 0.3 | Iris-setosa |
Bạn có thể dễ dàng chuyển các giá trị chuỗi thành số nguyên bằng LabelEncoder. Ba giá trị lớp (Iris-setosa, Iris-versicolor, Iris-virginica) được ánh xạ thành các số nguyên (0, 1, 2).
Trong trường hợp này, cột/đặc trưng thứ tư của tập dữ liệu chứa giá trị phi số. Vậy bạn cần tách nó ra.
# Convert the DataFrame to a NumPy array
iris = iris.values

# Separate
Y = iris[:,4]
# Label Encode string class values as integers
from sklearn.preprocessing import LabelEncoder

label_encoder = LabelEncoder()
label_encoder = label_encoder.fit(Y)
label_encoded_y = label_encoder.transform(Y)
Giờ, hãy tìm hiểu một lĩnh vực khác nơi kiến thức thống kê cơ bản là rất quan trọng.
Bạn đã thiết kế và phát triển mô hình machine learning của mình. Bây giờ, bạn muốn đánh giá hiệu năng mô hình trên dữ liệu kiểm tra. Về việc này, bạn nhờ đến các thước đo thống kê như Precision, Recall, ROC, AUC, RMSE, v.v. Bạn cũng dùng nhiều kỹ thuật lấy mẫu lại dữ liệu như k-fold Cross-Validation.
Thống kê có thể được dùng hiệu quả để:
Lưu ý rằng giả thuyết ở đây đề cập đến các mô hình đã học; tức là kết quả của việc chạy một thuật toán học trên một tập dữ liệu. Đánh giá và so sánh giả thuyết nghĩa là so sánh các mô hình đã học, khác với việc đánh giá và so sánh các thuật toán machine learning, vốn có thể được huấn luyện trên các mẫu khác nhau của cùng một bài toán hoặc các bài toán khác nhau.
Giờ hãy học về phân phối Gaussian và thống kê mô tả.
Một mẫu dữ liệu chỉ là ảnh chụp nhanh từ một quần thể rộng lớn hơn gồm tất cả các quan sát tiềm năng có thể lấy từ một miền hoặc sinh ra bởi một quá trình.
Thú vị là nhiều quan sát tuân theo một mẫu hình hay phân phối điển hình gọi là phân phối chuẩn, hay chính xác hơn là phân phối Gaussian. Đây là phân phối hình chuông mà bạn có thể đã biết. Hình sau mô tả một phân phối Gaussian:
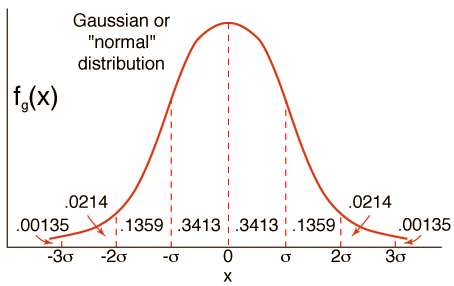
Nguồn: HyperPhysics
Các quá trình Gaussian và phân phối Gaussian là những phân ngành riêng biệt. Tuy nhiên, bây giờ bạn sẽ học hai thành phần quan trọng nhất tạo nên thế giới của các phân phối Gaussian nói chung.
Bất kỳ mẫu dữ liệu nào lấy từ một phân phối Gaussian có thể được tóm tắt bằng hai tham số:
Thuật ngữ phương sai cũng dẫn đến một thuật ngữ quan trọng khác là độ lệch chuẩn, tức là căn bậc hai của phương sai.
Trung bình, phương sai và độ lệch chuẩn có thể được tính trực tiếp từ các mẫu dữ liệu bằng numpy.
Trước tiên, bạn sẽ tạo một mẫu gồm 100 số ngẫu nhiên lấy từ phân phối Gaussian với trung bình 50 và độ lệch chuẩn 5. Sau đó bạn sẽ tính các thống kê tóm tắt.
Đầu tiên, bạn import mọi phụ thuộc.
#  Dependencies
from numpy.random import seed
from numpy.random import randn
from numpy import mean
from numpy import var
from numpy import std
Tiếp theo, bạn đặt seed cho bộ sinh số ngẫu nhiên để kết quả có thể tái lập.
seed(1)
# Generate univariate observations
data = 5 * randn(10000) + 50
# Calculate statistics
print('Mean: %.3f' % mean(data))
print('Variance: %.3f' % var(data))
print('Standard Deviation: %.3f' % std(data))
Mean: 50.049
Variance: 24.939
Standard Deviation: 4.994
Khá sát rồi, phải không?
Giờ hãy học chủ đề tiếp theo.
Nhìn chung, các đặc trưng trong một tập dữ liệu thường có thể liên hệ với nhau, điều này rất dễ xảy ra trong thực tế. Về mặt thống kê, mối quan hệ giữa các đặc trưng của tập dữ liệu (dù đơn giản hay phức tạp) thường được gọi là tương quan.
Việc tìm ra mức độ tương quan của các đặc trưng trong một tập dữ liệu là rất quan trọng. Bước này thực chất phục vụ cho lựa chọn đặc trưng, tức là chọn ra các đặc trưng quan trọng nhất từ một tập dữ liệu. Đây là một bước sống còn trong quy trình machine learning tiêu chuẩn vì nó có thể mang lại cú hích lớn về độ chính xác với thời gian ít hơn.
Để hiểu rõ hơn và thực tế hơn, hãy xem vì sao các đặc trưng có thể liên hệ với nhau:
Tương quan giữa các đặc trưng có thể thuộc ba loại: - Tương quan dương khi cả hai đặc trưng thay đổi cùng chiều, Tương quan trung tính khi không có mối quan hệ thay đổi, Tương quan âm khi hai đặc trưng thay đổi ngược chiều.
Các phép đo tương quan là nền tảng của các kỹ thuật chọn lọc đặc trưng kiểu bộ lọc. Xem bài viết này nếu bạn muốn học thêm về chọn lọc đặc trưng.
Bạn có thể mô tả toán học mối quan hệ giữa các mẫu của hai biến bằng một phương pháp thống kê gọi là hệ số tương quan Pearson, đặt theo tên người phát triển phương pháp, Karl Pearson.
Bạn có thể tính điểm tương quan Pearson bằng hàm corr() của pandas với tham số method là pearson. Hãy xem xét tương quan giữa các đặc trưng của tập dữ liệu Pima Indians Diabetes mà bạn đã dùng trước đó. Dữ liệu của bạn đã ở trạng thái tốt.
# Data
data.head()
| 0 | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | |
|---|---|---|---|---|---|---|---|---|---|
| 0 | 6 | 148.0 | 72.0 | 35.00000 | 155.548223 | 33.6 | 0.627 | 50 | 1 |
| 1 | 1 | 85.0 | 66.0 | 29.00000 | 155.548223 | 26.6 | 0.351 | 31 | 0 |
| 2 | 8 | 183.0 | 64.0 | 29.15342 | 155.548223 | 23.3 | 0.672 | 32 | 1 |
| 3 | 1 | 89.0 | 66.0 | 23.00000 | 94.000000 | 28.1 | 0.167 | 21 | 0 |
| 4 | 0 | 137.0 | 40.0 | 35.00000 | 168.000000 | 43.1 | 2.288 | 33 | 1 |
# Create the matrix of correlation score between the features and the label
scoreTable = data.corr(method='pearson')
# Visulaize the matrix
data.corr(method='pearson').style.format("{:.2}").background_gradient(cmap=plt.get_cmap('coolwarm'), axis=1)

Bạn có thể thấy rõ tương quan Pearson giữa tất cả các đặc trưng và nhãn của tập dữ liệu.
Ở phần tiếp theo, bạn sẽ học về thống kê phi tham số.
Một phần lớn của lĩnh vực thống kê và các phương pháp thống kê dành cho dữ liệu có phân phối đã biết.
Thống kê phi tham số hữu ích khi không có hoặc có rất ít thông tin về các tham số của quần thể. Các kiểm định phi tham số không đưa ra giả định về phân phối dữ liệu.
Khi bạn làm việc với dữ liệu phi tham số, có thể dùng các phương pháp thống kê phi tham số chuyên biệt bỏ qua mọi thông tin về phân phối. Do vậy, các phương pháp này thường được gọi là phương pháp không phụ thuộc phân phối.
Nhưng trước khi áp dụng một phương pháp thống kê phi tham số, dữ liệu phải được chuyển thành dạng thứ hạng. Các phương pháp thống kê kỳ vọng dữ liệu ở dạng thứ hạng đôi khi được gọi là thống kê thứ hạng. Ví dụ của thống kê thứ hạng có thể là tương quan thứ hạng và kiểm định giả thuyết thống kê dựa trên thứ hạng. Xếp hạng dữ liệu đúng như tên gọi của nó.
Một kiểm định giả thuyết thống kê phi tham số được dùng rộng rãi để kiểm tra sự khác biệt giữa hai mẫu độc lập là kiểm định Mann-Whitney U, đặt theo Henry Mann và Donald Whitney.
Bạn sẽ triển khai kiểm định này trong Python thông qua mannwhitneyu() được cung cấp bởi SciPy.
# The dependencies that you need
from scipy.stats import mannwhitneyu
from numpy.random import rand

# seed the random number generator
seed(1)
# Generate two independent samples
data1 = 50 + (rand(100) * 10)
data2 = 51 + (rand(100) * 10)
# Compare samples
stat, p = mannwhitneyu(data1, data2)
print('Statistics = %.3f, p = %.3f' % (stat, p))
# Interpret
alpha = 0.05
if p > alpha:
    print('Same distribution (fail to reject H0)')
else:
    print('Different distribution (reject H0)')
Statistics = 4077.000, p = 0.012
Different distribution (reject H0)
alpha là tham số ngưỡng do bạn quyết định. Hàm mannwhitneyu() trả về hai thứ:
statistic: Thống kê U của Mann-Whitney, bằng min(U cho x, U cho y) nếu alternative bằng None (đã lỗi thời; tồn tại để tương thích ngược), và U cho y trong các trường hợp khác.
pvalue: p-value giả định phân phối chuẩn tiệm cận.
Nếu bạn muốn học các phương pháp khác của thống kê phi tham số, bạn có thể xem tại đây.
Hai kiểm định ý nghĩa thống kê phi tham số phổ biến khác mà bạn có thể dùng là:
Bạn đã đi đến cuối cùng. Trong bài viết này, bạn đã học nhiều khái niệm thống kê thiết yếu đóng vai trò rất quan trọng trong các dự án machine learning của bạn. Vậy nên, hiểu chúng là điều cần thiết.
Từ phần giới thiệu đơn giản về thống kê, bạn đã tiến đến các phép xếp hạng thống kê cùng với nhiều phần triển khai. Đó chắc chắn là một thành tựu. Bạn đã làm việc với ba tập dữ liệu khác nhau, khai thác tối đa các chức năng của pandas và numpy và hơn nữa, bạn cũng dùng SciPy. Dưới đây là một số liên kết nếu bạn muốn tiến xa hơn:
Sau đây là các tài nguyên tôi đã tham khảo khi viết blog này:
Hãy cho tôi biết ý kiến/thắc mắc của bạn trong phần bình luận. Ngoài ra, hãy xem khóa học "Statistical Thinking in Python" của DataCamp vốn rất thực tiễn.
Khóa học Python
Khóa học
Khóa học
Khóa học
blog
Matt Crabtree
10 phút
