Kurs
Einführung in Python
4 Std.
7M
Wenn du wenig Erfahrung mit der Anwendung von Machine-Learning-Algorithmen hast, wirst du festgestellt haben, dass zunächst keine Statistikkenntnisse als Voraussetzung nötig sind.
Dennoch hilft Statistik enorm, um Machine Learning technisch wie auch intuitiv zu verstehen. Spätestens wenn du Ergebnisse validieren und interpretieren willst, kommst du nicht ohne Statistik aus. Wo es Daten gibt, gibt es auch Statistik. So wie Mathematik die Sprache der Wissenschaft ist, ist Statistik eine der Sprachen von Data Science und Machine Learning.
Statistik ist ein Teilgebiet der Mathematik mit vielen Theorien und Ergebnissen. Zahlreiche Konzepte, Werkzeuge, Verfahren und Notationen daraus machen Machine Learning erst zu dem, was es heute ist. Mit deskriptiven statistischen Methoden verwandelst du Beobachtungen in verständliche Informationen, die du auch anderen vermitteln kannst. Mit inferenzstatistischen Techniken schließt du aus kleinen Stichproben auf ganze Populationen. Später im Beitrag schauen wir uns Deskriptive und Inferenzstatistik an. Also kein Stress.
Bevor wir loslegen, hier zehn Beispiele, wo statistische Methoden in ML-Projekten praktisch eingesetzt werden:
Quelle: Statistical Methods for Machine Learning
Spannend, oder?
Dieser Beitrag vermittelt dir ein solides Fundament der wichtigsten Statistikthemen, die du brauchst, um Machine Learning professionell anzuwenden.
In diesem Beitrag lernst du:
Es gibt eine Menge zu entdecken, und jedes Thema ist wichtig. Legen wir los!
Definieren wir Statistik kurz und einfach.
Statistik ist ein Teilgebiet der Mathematik. Es umfasst zahlreiche Methoden, um mit Daten zu arbeiten und mithilfe dieser Daten unterschiedlichste Fragen zu beantworten.
In der Praxis ist es hilfreich, Statistik grob in zwei Bereiche zu gliedern: Deskriptive Statistik zur Zusammenfassung von Daten und Inferenzstatistik zum Schließen von Stichproben auf Populationen (Statistics for Machine Learning (7-Day Mini-Course)).

Quelle: IntellSpot
Inferenzstatistik: Methoden zur Quantifizierung von Eigenschaften einer Domäne bzw. Population anhand einer kleineren Menge beobachteter Daten, der Stichprobe. Die folgende Infografik beschreibt die Inferenzstatistik anschaulich:
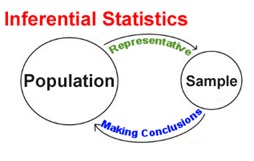
Quelle: Analytics Vidhya
Im nächsten Abschnitt siehst du, wie Statistik bei der Datenaufbereitung hilft.
Statistische Methoden brauchst du, um Trainings- und Testdaten für dein ML-Modell zu erstellen.
Dazu zählen Techniken für:
Ein Grundverständnis von Verteilungen, deskriptiver Statistik und Datenvisualisierung hilft dir, die richtigen Methoden für diese Aufgaben zu wählen.
Schauen wir uns die Punkte kurz an.
Was ist ein Ausreißer?
Ein Ausreißer ist eine Beobachtung, die deutlich von den übrigen Beobachtungen der Stichprobe abweicht. Die folgende Abbildung verdeutlicht die Definition.

Quelle: MathWorks
Wie in der Abbildung kannst du Ausreißer im Datensatz erkennen.
Viele ML-Algorithmen reagieren empfindlich auf Wertebereiche und Verteilungen der Eingabevariablen. Ausreißer können das Training verzerren und in die Irre führen – mit längeren Trainingszeiten, ungenaueren Modellen und am Ende schwächeren Ergebnissen.
Warum die Identifikation potenzieller Ausreißer so wichtig ist:
Ein Ausreißer kann auf fehlerhafte Daten hinweisen, z. B. falsch codierte Werte oder fehlgeschlagene Experimente. Lässt sich der Fehler bestätigen, sollte der Ausreißer entfernt oder – wenn möglich – korrigiert werden.
Oft lässt sich nicht zweifelsfrei klären, ob ein Ausreißer ein Fehler ist. Er kann zufällige Schwankung sein oder etwas fachlich Interessantes andeuten. In jedem Fall solltest du Ausreißer nicht blind löschen. Bei vielen Ausreißern bieten sich robuste statistische Verfahren an.
Ausreißer sind also oft schlecht für Vorhersagemodelle (auch wenn sie in speziellen Fällen nützlich sein können – das sprengt hier den Rahmen). Du brauchst statistisches Know-how, um sie sauber zu behandeln.
Viele Datensätze enthalten fehlende Werte. Dein ML-Modell lernt schlechter, wenn du es mit fehlenden Werten fütterst. Statistische Werkzeuge helfen hier.
Oft werden Instanzen mit fehlenden Werten einfach verworfen. Das ist riskant, weil du dabei wichtige Informationen verlieren kannst. Neben fortgeschrittenen Methoden gibt es schnelle Basistechniken: Mean Imputation und Median Imputation.
Dafür musst du Mittelwert und Median verstehen.
Angenommen, ein Feature X1 hat die Werte – 13, 18, 13, 14, 13, 16, 14, 21, 13
Der Mittelwert ist der Durchschnitt, also Summe durch Anzahl:
(13 + 18 + 13 + 14 + 13 + 16 + 14 + 21 + 13) / 9 = 15
Beachte: Der Mittelwert muss nicht zwingend einem Originalwert entsprechen.
Der Median ist der mittlere Wert. Sortiere zuerst:
13, 13, 13, 13, 14, 14, 16, 18, 21
Es sind neun Zahlen, die mittlere ist die (9 + 1) / 2 = 10 / 2 = 5. Zahl:
13, 13, 13, 13, 14, 14, 16, 18, 21
Der Median ist also 14.
Daten sind die Währung des angewandten Machine Learning. Erhebung und Nutzung sind gleichermaßen wichtig.
Stichprobenziehung bezeichnet statistische Methoden, um Beobachtungen auszuwählen, mit dem Ziel, einen Populationsparameter zu schätzen. Anders gesagt: Das aktive Sammeln von Beobachtungen, um eine Populationsgröße zu schätzen.
Jede Zeile eines Datensatzes ist eine Beobachtung und repräsentiert eine Population. Häufig hast du keinen Zugriff auf alle möglichen Beobachtungen, z. B. weil
Oft sind Klassen unausgewogen. Dann unter- oder übersampelst du je nach Problem.
Unter-Sampling: Eine Klasse hat viel mehr Beispiele – du verwirfst einige davon. Über-Sampling: Eine Klasse ist stark unterrepräsentiert – du erzeugst zusätzliche Beispiele.
Das gilt auch in Mehrklassen-Szenarien.
Für angewandtes ML sind vor allem drei Sampling-Methoden relevant: Simple Random Sampling, Systematic Sampling und Stratified Sampling.
Neben diesen verbreiteten Verfahren gibt es weitere Techniken (A Gentle Introduction to Statistical Sampling and Resampling).
Features eines Datensatzes können stark unterschiedliche Wertebereiche haben. Einige liegen zwischen 0 und 100, andere bei 0,01–0,001 oder 10.000–20.000 etc.
Das erschwert das Modeling. Kleine Änderungen in kleinskaligen Features gehen neben großskalierten oft unter. Die Lösung heißt Datenskalierung.
Gängige Verfahren sind Min-Max-Skalierung, Absolute Skalierung, Standardisierung u. a.
Datensätze enthalten oft numerische und nichtnumerische Merkmale. Viele ML-Frameworks wie scikit-learn erwarten rein numerische Daten – auch der Rechenaufwand sinkt so.
Wieder hilft Statistik.
Mit Techniken wie Label Encoding und One-Hot-Encoding wandelst du nichtnumerische Daten in numerische um.
Genug Theorie. Wenden wir einige Methoden an.
Wir starten mit statistischen Verfahren zur Ausreißererkennung.
Du nutzt den Z-Score, um Ausreißer zu finden, und arbeitest dazu mit dem Boston House Price Dataset. Importiere es aus den sklearn-Utilities – unterwegs erklären wir die nötigen Konzepte.
import pandas as pd
import numpy as np
from sklearn.datasets import load_boston

# Load the Boston dataset into a variable called boston
boston = load_boston()
# Separate the features from the target
x = boston.data
y = boston.target
Um den Datensatz tabellarisch mit Spaltennamen zu sehen, wandelst du ihn in ein pandas-DataFrame um.
# Take the columns separately in a variable
columns = boston.feature_names

# Create the dataframe
boston_df = pd.DataFrame(boston.data)
boston_df.columns = columns
boston_df.head()

Ein gängiger Start ist die univariate Ausreißeranalyse, also Feature für Feature. Ein einfaches Boxplot liefert oft einen guten Einstieg. Mit seaborn zeichnen wir ein Boxplot für das Feature DIS.
import seaborn as sns
sns.boxplot(x=boston_df['DIS'])

import matplotlib.pyplot as plt
plt.show()
<matplotlib.axes._subplots.AxesSubplot at 0x8abded0>

Für die Anzeige haben wir zusätzlich matplotlib importiert, da seaborn-Plots wie gewöhnliche Matplotlib-Grafiken gerendert werden.
Das Plot zeigt drei Punkte zwischen 10 und 12 – Ausreißer, da sie außerhalb der Box der übrigen Beobachtungen liegen. Hier hast du univariat analysiert, also nur DIS betrachtet.
Weiter geht’s mit dem Z-Score.
"Der Z-Score ist die signierte Anzahl an Standardabweichungen, die ein Beobachtungswert über bzw. unter dem Mittelwert der betrachteten Verteilung liegt." - Wikipedia
Die Idee: Wir beschreiben jeden Datenpunkt in Relation zu Mittelwert und Standardabweichung. Durch Zentrieren und Skalieren (Mittelwert 0, Standardabweichung 1) erhalten wir eine Normalverteilung.
Und wie hilft das bei Ausreißern?
Nach dem Standardisieren suchst du nach Werten, die weit von 0 entfernt sind. Typische Schwellwerte sind 3 oder -3. Liegt der Z-Score größer als 3 oder kleiner als -3, gilt der Punkt als Ausreißer.
Wir verwenden die Z-score-Funktion aus scipy.
from scipy import stats

z = np.abs(stats.zscore(boston_df))
print(z)
[[0.41771335 0.28482986 1.2879095  ... 1.45900038 0.44105193 1.0755623 ]
 [0.41526932 0.48772236 0.59338101 ... 0.30309415 0.44105193 0.49243937]
 [0.41527165 0.48772236 0.59338101 ... 0.30309415 0.39642699 1.2087274 ]
 ...
 [0.41137448 0.48772236 0.11573841 ... 1.17646583 0.44105193 0.98304761]
 [0.40568883 0.48772236 0.11573841 ... 1.17646583 0.4032249  0.86530163]
 [0.41292893 0.48772236 0.11573841 ... 1.17646583 0.44105193 0.66905833]]
Aus dem Roh-Array lassen sich Ausreißer schlecht ablesen. Also definierst du deinen Schwellwert und filterst entsprechend.
threshold = 3
print(np.where(z > 3))
(array([ 55,  56,  57, 102, 141, 142, 152, 154, 155, 160, 162, 163, 199,
       200, 201, 202, 203, 204, 208, 209, 210, 211, 212, 216, 218, 219,
       220, 221, 222, 225, 234, 236, 256, 257, 262, 269, 273, 274, 276,
       277, 282, 283, 283, 284, 347, 351, 352, 353, 353, 354, 355, 356,
       357, 358, 363, 364, 364, 365, 367, 369, 370, 372, 373, 374, 374,
       380, 398, 404, 405, 406, 410, 410, 411, 412, 412, 414, 414, 415,
       416, 418, 418, 419, 423, 424, 425, 426, 427, 427, 429, 431, 436,
       437, 438, 445, 450, 454, 455, 456, 457, 466], dtype=int32), array([ 1,  1,  1, 11, 12,  3,  3,  3,  3,  3,  3,  3,  1,  1,  1,  1,  1,
        1,  3,  3,  3,  3,  3,  3,  3,  3,  3,  3,  3,  5,  3,  3,  1,  5,
        5,  3,  3,  3,  3,  3,  3,  1,  3,  1,  1,  7,  7,  1,  7,  7,  7,
        3,  3,  3,  3,  3,  5,  5,  5,  3,  3,  3, 12,  5, 12,  0,  0,  0,
        0,  5,  0, 11, 11, 11, 12,  0, 12, 11, 11,  0, 11, 11, 11, 11, 11,
       11,  0, 11, 11, 11, 11, 11, 11, 11, 11, 11, 11, 11, 11, 11],
      dtype=int32))
Auch hier ist die Ausgabe kryptisch: Das erste Array sind Zeilennummern, das zweite die zugehörigen Spalten. Zum Beispiel hat z[55][1] einen Z-Score > 3.
print(z[55][1])
3.375038763517309
Der 55. Eintrag in Spalte ZN ist also ein Ausreißer. Von hier aus kannst du weiterarbeiten.
Du hast gesehen, wie du mit dem Z-Score und einem Schwellwert potenzielle Ausreißer findest. Als Nächstes schauen wir uns die Imputation fehlender Werte an.
Wir verwenden das bekannte Pima Indian Diabetes-Dataset, das fehlende Werte enthält. Zunächst lädst du den Datensatz in deinen Workspace.
Wir laden ihn in ein DataFrame data.
data = pd.read_csv("https://raw.githubusercontent.com/jbrownlee/Datasets/master/pima-indians-diabetes.data.csv",header=None)
print(data.describe())
                0           1           2           3           4           5  \
count  768.000000  768.000000  768.000000  768.000000  768.000000  768.000000
mean     3.845052  120.894531   69.105469   20.536458   79.799479   31.992578
std      3.369578   31.972618   19.355807   15.952218  115.244002    7.884160
min      0.000000    0.000000    0.000000    0.000000    0.000000    0.000000
25%      1.000000   99.000000   62.000000    0.000000    0.000000   27.300000
50%      3.000000  117.000000   72.000000   23.000000   30.500000   32.000000
75%      6.000000  140.250000   80.000000   32.000000  127.250000   36.600000
max     17.000000  199.000000  122.000000   99.000000  846.000000   67.100000

                6           7           8
count  768.000000  768.000000  768.000000
mean     0.471876   33.240885    0.348958
std      0.331329   11.760232    0.476951
min      0.078000   21.000000    0.000000
25%      0.243750   24.000000    0.000000
50%      0.372500   29.000000    0.000000
75%      0.626250   41.000000    1.000000
max      2.420000   81.000000    1.000000
Die Spalten sind hier numerisch benannt, weil es ein vorverarbeiteter Datensatz ist. Kein Problem, wir erschließen uns gleich, was was ist.
Das Dataset ist für fehlende Werte bekannt. Auf den ersten Blick wirken keine Werte fehlend, aber bei genauerem Hinsehen siehst du: In manchen Spalten ist der Minimalwert 0, obwohl 0 dort nicht plausibel ist. Das sind die fehlenden Werte.
Konkret sind folgende Spalten mit einem ungültigen Minimum 0 belegt:
Bestätigen wir das, indem wir die ersten 20 Zeilen anschauen.
data.head(20)
| 0 | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | |
|---|---|---|---|---|---|---|---|---|---|
| 0 | 6 | 148 | 72 | 35 | 0 | 33.6 | 0.627 | 50 | 1 |
| 1 | 1 | 85 | 66 | 29 | 0 | 26.6 | 0.351 | 31 | 0 |
| 2 | 8 | 183 | 64 | 0 | 0 | 23.3 | 0.672 | 32 | 1 |
| 3 | 1 | 89 | 66 | 23 | 94 | 28.1 | 0.167 | 21 | 0 |
| 4 | 0 | 137 | 40 | 35 | 168 | 43.1 | 2.288 | 33 | 1 |
| 5 | 5 | 116 | 74 | 0 | 0 | 25.6 | 0.201 | 30 | 0 |
| 6 | 3 | 78 | 50 | 32 | 88 | 31.0 | 0.248 | 26 | 1 |
| 7 | 10 | 115 | 0 | 0 | 0 | 35.3 | 0.134 | 29 | 0 |
| 8 | 2 | 197 | 70 | 45 | 543 | 30.5 | 0.158 | 53 | 1 |
| 9 | 8 | 125 | 96 | 0 | 0 | 0.0 | 0.232 | 54 | 1 |
| 10 | 4 | 110 | 92 | 0 | 0 | 37.6 | 0.191 | 30 | 0 |
| 11 | 10 | 168 | 74 | 0 | 0 | 38.0 | 0.537 | 34 | 1 |
| 12 | 10 | 139 | 80 | 0 | 0 | 27.1 | 1.441 | 57 | 0 |
| 13 | 1 | 189 | 60 | 23 | 846 | 30.1 | 0.398 | 59 | 1 |
| 14 | 5 | 166 | 72 | 19 | 175 | 25.8 | 0.587 | 51 | 1 |
| 15 | 7 | 100 | 0 | 0 | 0 | 30.0 | 0.484 | 32 | 1 |
| 16 | 0 | 118 | 84 | 47 | 230 | 45.8 | 0.551 | 31 | 1 |
| 17 | 7 | 107 | 74 | 0 | 0 | 29.6 | 0.254 | 31 | 1 |
| 18 | 1 | 103 | 30 | 38 | 83 | 43.3 | 0.183 | 33 | 0 |
| 19 | 1 | 115 | 70 | 30 | 96 | 34.6 | 0.529 | 32 | 1 |
Offensichtlich gibt es 0-Werte in den Spalten 2, 3, 4 und 5.
Da fehlende Werte hier als 0 codiert sind, ist der Umgang damit etwas tricky. Unser Vorgehen:
NaN ersetzen.fillna() mit der Imputationsstrategie aufrufen.# Step 1: Get the count of zeros in each of the columns
print((data[[1,2,3,4,5]] == 0).sum())
1      5
2     35
3    227
4    374
5     11
dtype: int64
Spalten 1, 2 und 5 haben nur wenige Nullen, 3 und 4 sehr viele – fast die Hälfte der Zeilen.
# Step -2: Mark zero values as missing or NaN
data[[1,2,3,4,5]] = data[[1,2,3,4,5]].replace(0, np.NaN)

# Count the number of NaN values in each column
print(data.isnull().sum())
0      0
1      5
2     35
3    227
4    374
5     11
6      0
7      0
8      0
dtype: int64
Zur Kontrolle schauen wir uns den Datensatz nochmals an:
# Step 4
data.head(20)
| 0 | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | |
|---|---|---|---|---|---|---|---|---|---|
| 0 | 6 | 148.0 | 72.0 | 35.0 | NaN | 33.6 | 0.627 | 50 | 1 |
| 1 | 1 | 85.0 | 66.0 | 29.0 | NaN | 26.6 | 0.351 | 31 | 0 |
| 2 | 8 | 183.0 | 64.0 | NaN | NaN | 23.3 | 0.672 | 32 | 1 |
| 3 | 1 | 89.0 | 66.0 | 23.0 | 94.0 | 28.1 | 0.167 | 21 | 0 |
| 4 | 0 | 137.0 | 40.0 | 35.0 | 168.0 | 43.1 | 2.288 | 33 | 1 |
| 5 | 5 | 116.0 | 74.0 | NaN | NaN | 25.6 | 0.201 | 30 | 0 |
| 6 | 3 | 78.0 | 50.0 | 32.0 | 88.0 | 31.0 | 0.248 | 26 | 1 |
| 7 | 10 | 115.0 | NaN | NaN | NaN | 35.3 | 0.134 | 29 | 0 |
| 8 | 2 | 197.0 | 70.0 | 45.0 | 543.0 | 30.5 | 0.158 | 53 | 1 |
| 9 | 8 | 125.0 | 96.0 | NaN | NaN | NaN | 0.232 | 54 | 1 |
| 10 | 4 | 110.0 | 92.0 | NaN | NaN | 37.6 | 0.191 | 30 | 0 |
| 11 | 10 | 168.0 | 74.0 | NaN | NaN | 38.0 | 0.537 | 34 | 1 |
| 12 | 10 | 139.0 | 80.0 | NaN | NaN | 27.1 | 1.441 | 57 | 0 |
| 13 | 1 | 189.0 | 60.0 | 23.0 | 846.0 | 30.1 | 0.398 | 59 | 1 |
| 14 | 5 | 166.0 | 72.0 | 19.0 | 175.0 | 25.8 | 0.587 | 51 | 1 |
| 15 | 7 | 100.0 | NaN | NaN | NaN | 30.0 | 0.484 | 32 | 1 |
| 16 | 0 | 118.0 | 84.0 | 47.0 | 230.0 | 45.8 | 0.551 | 31 | 1 |
| 17 | 7 | 107.0 | 74.0 | NaN | NaN | 29.6 | 0.254 | 31 | 1 |
| 18 | 1 | 103.0 | 30.0 | 38.0 | 83.0 | 43.3 | 0.183 | 33 | 0 |
| 19 | 1 | 115.0 | 70.0 | 30.0 | 96.0 | 34.6 | 0.529 | 32 | 1 |
Die Markierung der fehlenden Werte hat also funktioniert.
Jetzt imputieren wir mit Mean Imputation, also ersetzen fehlende Werte durch den Spaltenmittelwert.
# Step 5: Call the fillna() function with the imputation strategy
data.fillna(data.mean(), inplace=True)

# Count the number of NaN values in each column to verify
print(data.isnull().sum())
0    0
1    0
2    0
3    0
4    0
5    0
6    0
7    0
8    0
dtype: int64
Perfekt!
Dieser DataCamp-Artikel zeigt dir praxisnah, wie du Datenskalierung in der Vorverarbeitung umsetzt. Unbedingt reinschauen.
Als Nächstes folgt die Variablenkodierung.
Wir brauchen einen Datensatz mit nichtnumerischen Werten. Dafür eignet sich das Iris-Dataset.
# Load the dataset to a DataFrame object iris
iris = pd.read_csv("http://archive.ics.uci.edu/ml/machine-learning-databases/iris/iris.data",header=None)
# See first 20 rows of the dataset
iris.head(20)
| 0 | 1 | 2 | 3 | 4 | |
|---|---|---|---|---|---|
| 0 | 5.1 | 3.5 | 1.4 | 0.2 | Iris-setosa |
| 1 | 4.9 | 3.0 | 1.4 | 0.2 | Iris-setosa |
| 2 | 4.7 | 3.2 | 1.3 | 0.2 | Iris-setosa |
| 3 | 4.6 | 3.1 | 1.5 | 0.2 | Iris-setosa |
| 4 | 5.0 | 3.6 | 1.4 | 0.2 | Iris-setosa |
| 5 | 5.4 | 3.9 | 1.7 | 0.4 | Iris-setosa |
| 6 | 4.6 | 3.4 | 1.4 | 0.3 | Iris-setosa |
| 7 | 5.0 | 3.4 | 1.5 | 0.2 | Iris-setosa |
| 8 | 4.4 | 2.9 | 1.4 | 0.2 | Iris-setosa |
| 9 | 4.9 | 3.1 | 1.5 | 0.1 | Iris-setosa |
| 10 | 5.4 | 3.7 | 1.5 | 0.2 | Iris-setosa |
| 11 | 4.8 | 3.4 | 1.6 | 0.2 | Iris-setosa |
| 12 | 4.8 | 3.0 | 1.4 | 0.1 | Iris-setosa |
| 13 | 4.3 | 3.0 | 1.1 | 0.1 | Iris-setosa |
| 14 | 5.8 | 4.0 | 1.2 | 0.2 | Iris-setosa |
| 15 | 5.7 | 4.4 | 1.5 | 0.4 | Iris-setosa |
| 16 | 5.4 | 3.9 | 1.3 | 0.4 | Iris-setosa |
| 17 | 5.1 | 3.5 | 1.4 | 0.3 | Iris-setosa |
| 18 | 5.7 | 3.8 | 1.7 | 0.3 | Iris-setosa |
| 19 | 5.1 | 3.8 | 1.5 | 0.3 | Iris-setosa |
Mit dem LabelEncoder wandelst du Stringklassen bequem in Integer um. Die drei Klassen (Iris-setosa, Iris-versicolor, Iris-virginica) werden auf (0, 1, 2) gemappt.
In diesem Fall enthält die fünfte Spalte/Klasse nichtnumerische Werte. Trenne sie daher ab.
# Convert the DataFrame to a NumPy array
iris = iris.values

# Separate
Y = iris[:,4]
# Label Encode string class values as integers
from sklearn.preprocessing import LabelEncoder

label_encoder = LabelEncoder()
label_encoder = label_encoder.fit(Y)
label_encoded_y = label_encoder.transform(Y)
Als Nächstes ein Bereich, in dem grundlegende Statistik ebenfalls unverzichtbar ist.
Du hast dein Modell trainiert und möchtest die Performance auf Testdaten bewerten. Dazu nutzt du statistische Metriken wie Precision, Recall, ROC, AUC, RMSE etc. Außerdem helfen Resampling-Verfahren wie die k-fold Cross-Validation.
Mit Statistik kannst du u. a.:
Wichtig: Mit Hypothese sind gelernte Modelle gemeint – also die Ergebnisse eines Lernverfahrens auf einem Datensatz. Das Bewerten und Vergleichen von Hypothesen bedeutet, gelernte Modelle zu vergleichen – nicht zwingend die Lernalgorithmen selbst, die auf verschiedenen Stichproben oder Problemen trainiert sein können.
Weiter geht’s mit Gauß-Verteilung und deskriptiver Statistik.
Eine Stichprobe ist ein Schnappschuss aus der größeren Population möglicher Beobachtungen einer Domäne oder eines Prozesses.
Viele Beobachtungen folgen einer typischen Form, der Normal- bzw. Gauß-Verteilung – der bekannten Glockenkurve. So sieht sie aus:
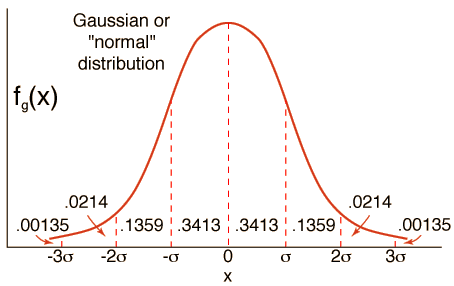
Quelle: HyperPhysics
Gauß-Prozesse und -Verteilungen sind eigene Welten. Wir betrachten zwei zentrale Bausteine.
Jede Stichprobe aus einer Gauß-Verteilung lässt sich mit zwei Parametern zusammenfassen:
Aus der Varianz ergibt sich die Standardabweichung als Quadratwurzel der Varianz.
Mittelwert, Varianz und Standardabweichung lassen sich direkt mit numpy berechnen.
Wir erzeugen 10.000 Zufallszahlen aus einer Gauß-Verteilung mit Mittelwert 50 und Standardabweichung 5 und berechnen die Kennzahlen.
Zuerst importieren wir die Abhängigkeiten.
#  Dependencies
from numpy.random import seed
from numpy.random import randn
from numpy import mean
from numpy import var
from numpy import std
Dann setzen wir den Zufallsgenerator auf einen festen Seed.
seed(1)
# Generate univariate observations
data = 5 * randn(10000) + 50
# Calculate statistics
print('Mean: %.3f' % mean(data))
print('Variance: %.3f' % var(data))
print('Standard Deviation: %.3f' % std(data))
Mean: 50.049
Variance: 24.939
Standard Deviation: 4.994
Na, ziemlich nah dran, oder?
Weiter zum nächsten Thema.
Features in Datensätzen hängen oft miteinander zusammen – das ist in der Praxis normal. Statistisch nennt man diese Beziehung Korrelation.
Die Stärke der Korrelation zu kennen, ist wichtig. Das hilft bei der Feature Selection, also der Auswahl der wichtigsten Merkmale. Dieser Schritt ist zentral im ML-Pipeline, weil er Genauigkeit steigern und Rechenzeit senken kann.
Warum sind Features oft korreliert?
Man unterscheidet: Positive Korrelation (beide steigen/fallen gemeinsam), Keine Korrelation (kein Zusammenhang) und Negative Korrelation (entgegengesetzte Richtungen).
Korrelationsmaße sind die Basis filterbasierter Feature-Selection-Verfahren. Lies diesen Artikel, wenn du tiefer einsteigen willst.
Die Beziehung zweier Variablen misst du z. B. mit dem Pearson-Korrelationskoeffizienten nach Karl Pearson.
Mit pandas berechnest du Pearson mit corr(method='pearson'). Untersuchen wir die Korrelationen im Pima-Indians-Diabetes-Dataset.
# Data
data.head()
| 0 | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | |
|---|---|---|---|---|---|---|---|---|---|
| 0 | 6 | 148.0 | 72.0 | 35.00000 | 155.548223 | 33.6 | 0.627 | 50 | 1 |
| 1 | 1 | 85.0 | 66.0 | 29.00000 | 155.548223 | 26.6 | 0.351 | 31 | 0 |
| 2 | 8 | 183.0 | 64.0 | 29.15342 | 155.548223 | 23.3 | 0.672 | 32 | 1 |
| 3 | 1 | 89.0 | 66.0 | 23.00000 | 94.000000 | 28.1 | 0.167 | 21 | 0 |
| 4 | 0 | 137.0 | 40.0 | 35.00000 | 168.000000 | 43.1 | 2.288 | 33 | 1 |
# Create the matrix of correlation score between the features and the label
scoreTable = data.corr(method='pearson')
# Visulaize the matrix
data.corr(method='pearson').style.format("{:.2}").background_gradient(cmap=plt.get_cmap('coolwarm'), axis=1)

Du siehst klar die Pearson-Korrelationen zwischen allen Features und dem Label.
Im nächsten Abschnitt geht es um nichtparametrische Statistik.
Ein großer Teil der Statistik befasst sich mit Daten, deren Verteilung bekannt ist.
Nichtparametrische Statistik ist hilfreich, wenn wenig bis keine Informationen über die Populationsparameter vorliegen. Nichtparametrische Tests machen keine Annahmen über die Verteilung.
Für nichtparametrische Daten gibt es spezialisierte Verfahren, die Verteilungsinformationen ignorieren. Daher heißen sie oft verteilungsfrei.
Bevor du solche Methoden anwendest, werden Daten oft in Ränge umgewandelt. Verfahren, die Rangdaten erwarten, heißen Rangstatistiken, z. B. Rangkorrelationen und Rangtests. Rangbildung ist wörtlich zu verstehen.
Ein weit verbreiteter nichtparametrischer Test zum Vergleich zweier unabhängiger Stichproben ist der Mann-Whitney-U-Test (Henry Mann, Donald Whitney).
In Python implementierst du ihn mit mannwhitneyu() aus SciPy.
# The dependencies that you need
from scipy.stats import mannwhitneyu
from numpy.random import rand

# seed the random number generator
seed(1)
# Generate two independent samples
data1 = 50 + (rand(100) * 10)
data2 = 51 + (rand(100) * 10)
# Compare samples
stat, p = mannwhitneyu(data1, data2)
print('Statistics = %.3f, p = %.3f' % (stat, p))
# Interpret
alpha = 0.05
if p > alpha:
    print('Same distribution (fail to reject H0)')
else:
    print('Different distribution (reject H0)')
Statistics = 4077.000, p = 0.012
Different distribution (reject H0)
alpha ist dein Signifikanzniveau. mannwhitneyu() liefert:
statistic: Die Mann-Whitney-U-Statistik, gleich min(U für x, U für y), wenn alternative None ist (veraltet; für Rückwärtskompatibilität), sonst U für y.
pvalue: p-Wert unter Annahme einer asymptotisch normalen Verteilung.
Weitere nichtparametrische Verfahren findest du hier.
Zwei weitere verbreitete Signifikanztests sind:
Geschafft! Du hast die wichtigsten statistischen Konzepte kennengelernt, die in ML-Projekten eine zentrale Rolle spielen. Das Verständnis dafür ist essenziell.
Von der Einführung über Rangstatistiken bis zu mehreren praktischen Umsetzungen: Du hast mit drei Datensätzen gearbeitet, pandas und numpy intensiv genutzt und zusätzlich SciPy eingesetzt. Wenn du weiter einsteigen willst, helfen dir diese Links:
Diese Ressourcen haben mir beim Schreiben geholfen:
Schreib mir deine Fragen und Gedanken in die Kommentare. Und schau dir auch DataCamps Kurs "Statistical Thinking in Python" an – sehr praxisnah.
Python-Kurse
Kurs
Kurs
Kurs