{count, plural, one {Cursus} other {Cursussen}}
Introductie tot Python
{hours} uur
7.1M
Als je weinig ervaring hebt met het toepassen van machinelearning-algoritmes, heb je vast gemerkt dat je er vooraf geen statistiek voor hoeft te kennen.
Toch is wat statistiek kennen nuttig om machine learning zowel technisch als intuïtief te begrijpen. Vroeg of laat heb je statistiek nodig om je resultaten te valideren en te interpreteren. Waar data is, is statistiek. Zoals wiskunde de taal van de wetenschap is, zo is statistiek een unieke taal voor Data Science en Machine Learning.
Statistiek is een deelgebied van de wiskunde met veel theorie en inzichten. Diverse concepten, tools, technieken en notaties uit dit vakgebied vormen de basis van wat machine learning vandaag is. Met beschrijvende statistiek kun je observaties omzetten in bruikbare informatie die je begrijpt en kunt delen. Met inferentiële statistiek kun je redeneren van kleine steekproeven naar volledige domeinen. Later in deze post behandel je beschrijvende en inferentiële statistiek. Geen zorgen.
Voor we beginnen, lopen we langs tien voorbeelden waarin statistische methoden in een toegepast machinelearning-project worden gebruikt:
Bron: Statistical Methods for Machine Learning
Fascinerend, toch?
Deze post geeft je een stevige basis in de essentiële statistiek die je nodig hebt om een goede machinelearning-practitioner te worden.
In deze post behandel je:
Er valt veel te behandelen en alles is even belangrijk. Aan de slag!
Definiëren we statistiek eerst kort in eenvoudige bewoordingen.
Statistiek wordt gezien als een subveld van de wiskunde. Het verwijst naar een veelheid aan methoden om met data te werken en die data te gebruiken om allerlei soorten vragen te beantwoorden.
Bij de statistische tools die in de praktijk worden gebruikt, is het handig om het vakgebied grofweg op te delen in twee groepen methoden: beschrijvende statistiek voor het samenvatten van data, en inferentiële statistiek voor het trekken van conclusies uit steekproeven van data (Statistics for Machine Learning (7-Day Mini-Course)).

Bron: IntellSpot
Inferentiële statistiek: Inferentiële statistiek omvat methoden die helpen eigenschappen van het domein of de populatie te kwantificeren op basis van een kleinere set waarnemingen, een steekproef. Hieronder staat een infographic die inferentiële statistiek mooi weergeeft:
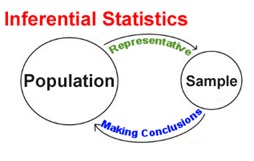
Bron: Analytics Vidhya
In de volgende sectie behandel je het gebruik van statistiek voor datavoorbereiding.
Statistische methoden zijn nodig bij het opstellen van train- en testdata voor je machinelearning-model.
Dit omvat technieken voor:
Een basisbegrip van dataverdelingen, beschrijvende statistiek en datavisualisatie helpt je de juiste methoden te kiezen voor deze taken.
Analyseren we elk van de bovenstaande punten kort.
Eerst: wat is een uitschieter?
Een uitschieter is een observatie die lijkt af te wijken van andere observaties in de steekproef. De volgende afbeelding maakt de definitie duidelijker.

Bron: MathWorks
Je kunt de uitschieters in de data herkennen zoals in de bovenstaande figuur.
Veel machinelearning-algoritmes zijn gevoelig voor het bereik en de verdeling van attribuutwaarden in de invoerdata. Uitschieters kunnen het trainingsproces vertekenen en misleiden, wat leidt tot langere trainingstijden, minder nauwkeurige modellen en uiteindelijk matige resultaten.
Het identificeren van potentiële uitschieters is cruciaal om de volgende redenen:
Een uitschieter kan wijzen op slechte data. Bijvoorbeeld: verkeerd gecodeerde data of een experiment dat niet goed is uitgevoerd. Als kan worden vastgesteld dat een uitschieter inderdaad foutief is, moet die waarde uit de analyse worden verwijderd. Als correctie mogelijk is, kan dat ook.
Soms is het niet mogelijk om te bepalen of een uitschieter een slechte datapunt is. Uitschieters kunnen door willekeurige variatie ontstaan of juist op iets wetenschappelijk interessants wijzen. In elk geval wil je zo’n observatie meestal niet zomaar verwijderen. Bevat de data echter significante uitschieters, overweeg dan robuuste statistische technieken.
Uitschieters zijn vaak ongunstig voor je voorspellende modellen (hoewel ze soms ook in je voordeel kunnen werken, maar dat valt buiten deze post). Je hebt statistische kennis nodig om uitschieters efficiënt te behandelen.
Veel datasets hebben last van ontbrekende waarden. Je model traint mogelijk niet effectief als de data die je invoert ontbrekende waarden bevat. Statistische tools en technieken schieten te hulp.
Veel mensen verwijderen instanties met een ontbrekende waarde. Dat is geen goede gewoonte, want je kunt zo essentiële kenmerken/representaties verliezen. Er zijn geavanceerde methoden om met ontbrekende waarden om te gaan, maar snelle technieken zijn: gemiddelde-imputatie en mediaan-imputatie.
Het is belangrijk dat je weet wat gemiddelde en mediaan zijn.
Stel, je hebt een feature X1 met deze waarden - 13, 18, 13, 14, 13, 16, 14, 21, 13
Het gemiddelde is het gebruikelijke gemiddelde, dus optellen en delen:
(13 + 18 + 13 + 14 + 13 + 16 + 14 + 21 + 13) / 9 = 15
Let op: het gemiddelde is hier geen waarde uit de oorspronkelijke lijst. Dat komt vaak voor. Ga er niet vanuit dat je gemiddelde een van de originele getallen is.
De mediaan is de middelste waarde, dus herschrijf eerst de lijst in numerieke volgorde:
13, 13, 13, 13, 14, 14, 16, 18, 21
Er staan negen getallen in de lijst, dus de middelste is het (9 + 1) / 2 = 10 / 2 = 5e getal:
13, 13, 13, 13, 14, 14, 16, 18, 21
De mediaan is dus 14.
Data is de valuta van toegepaste machine learning. Verzamelen en gebruiken zijn dus even belangrijk.
Steekproeven nemen verwijst naar statistische methoden om observaties uit het domein te selecteren met als doel een populatieparameter te schatten. Met andere woorden: sampling is het actief verzamelen van observaties om een populatievariabele te schatten.
Elke rij in een dataset vertegenwoordigt een observatie die iets zegt over een bepaalde populatie. Vaak heb je geen toegang tot alle mogelijke observaties. Bijvoorbeeld omdat:
Vaak heb je niet de juiste verhouding tussen datamonsters. Dan moet je onder- of over-samplen, afhankelijk van het probleem.
Je doet undersampling wanneer het aantal monsters voor een bepaalde categorie veel hoger is dan voor andere; je gooit dan een deel van die samples weg. Je doet oversampling wanneer het aantal monsters voor een bepaalde categorie juist veel lager is; dan genereer je extra samples.
Dit geldt ook voor multi-class-scenario’s.
Statistische steekproeftrekking is een groot studiegebied, maar in toegepaste machine learning gebruik je vaak drie typen: eenvoudige aselecte steekproef, systematische steekproef en gestratificeerde steekproef.
Hoewel dit de meest voorkomende typen zijn die je tegenkomt, zijn er ook andere technieken (A Gentle Introduction to Statistical Sampling and Resampling).
Vaak variëren de schalen van features in je dataset sterk. Sommige features hebben een schaal van 0 tot 100 terwijl andere bijvoorbeeld 0,01 - 0,001 of 10.000 - 20.000 hebben.
Dat is problematisch voor efficiënt modelleren. Een kleine verandering in een feature met een kleine schaal heeft mogelijk weinig impact vergeleken met een feature met een grote schaal. Dat belemmert goed leren. Dit probleem aanpakken heet dataschaling.
Er zijn verschillende technieken zoals min-max-schaal, absolute schaling, standaardschaling, enz.
Soms bevatten datasets een mix van numerieke en niet-numerieke data. Veel machinelearning-frameworks zoals scikit-learn verwachten volledig numerieke data. Dit versnelt ook de berekening.
Opnieuw biedt statistiek uitkomst.
Technieken zoals label-encoding en one-hot-encoding worden gebruikt om niet-numerieke data naar numeriek om te zetten.
Je hebt nu veel theorie behandeld. Laten we wat toepassen voor gevoel bij de praktijk.
Je begint met statistische methoden om uitschieters te detecteren.
Je gebruikt de Z-Score om uitschieters te detecteren en bekijkt hiervoor de Boston House Price-dataset. We beginnen met het importeren van de dataset uit de utilities van sklearn; gaandeweg komen de nodige concepten voorbij.
import pandas as pd
import numpy as np
from sklearn.datasets import load_boston

# Load the Boston dataset into a variable called boston
boston = load_boston()
# Separate the features from the target
x = boston.data
y = boston.target
Om de dataset in een standaard tabelvorm met alle featurenamen te zien, zet je deze om naar een pandas-dataframe.
# Take the columns separately in a variable
columns = boston.feature_names

# Create the dataframe
boston_df = pd.DataFrame(boston.data)
boston_df.columns = columns
boston_df.head()

Het is gebruikelijk om te beginnen met univariate uitschieteranalyse, waarbij je één feature tegelijk bekijkt. Een eenvoudige boxplot van een feature geeft vaak al een goed startpunt. Je maakt een boxplot met seaborn en gebruikt de feature DIS.
import seaborn as sns
sns.boxplot(x=boston_df['DIS'])

import matplotlib.pyplot as plt
plt.show()
<matplotlib.axes._subplots.AxesSubplot at 0x8abded0>

Om de boxplot te tonen, heb je ook matplotlib geïmporteerd, omdat seaborn-plots als gewone matplotlib-plots worden weergegeven.
De plot toont drie punten tussen 10 en 12; dit zijn uitschieters omdat ze niet in de box van de andere observaties vallen. Hier heb je univariate uitschieters geanalyseerd, dus alleen de DIS-feature gebruikt om uitschieters te checken.
Nu verder met de Z-score.
"De Z-score is het getekende aantal standaarddeviaties waarmee de waarde van een observatie of datapunt boven het gemiddelde ligt van wat wordt geobserveerd of gemeten." - Wikipedia
Het idee achter de Z-score is om elk datapunt te beschrijven ten opzichte van de standaarddeviatie en het gemiddelde van de groep punten. De Z-score draait om het herschalen en centreren van de data (gemiddelde 0 en standaarddeviatie 1), oftewel een normale verdeling.
Maar hoe helpt dit bij het identificeren van uitschieters?
Door de Z-score te berekenen, schaal en centreer je de data (gemiddelde 0 en standaarddeviatie 1) en zoek je naar instanties die ver van nul liggen. Datapunten die ver van nul liggen, worden als uitschieters beschouwd. Vaak wordt een drempel van 3 of -3 gebruikt. Dus als de Z-score respectievelijk groter is dan 3 of kleiner dan -3, dan is dat datapunt een uitschieter.
Je gebruikt de Z-score-functie uit de scipy-bibliotheek om uitschieters te detecteren.
from scipy import stats

z = np.abs(stats.zscore(boston_df))
print(z)
[[0.41771335 0.28482986 1.2879095  ... 1.45900038 0.44105193 1.0755623 ]
 [0.41526932 0.48772236 0.59338101 ... 0.30309415 0.44105193 0.49243937]
 [0.41527165 0.48772236 0.59338101 ... 0.30309415 0.39642699 1.2087274 ]
 ...
 [0.41137448 0.48772236 0.11573841 ... 1.17646583 0.44105193 0.98304761]
 [0.40568883 0.48772236 0.11573841 ... 1.17646583 0.4032249  0.86530163]
 [0.41292893 0.48772236 0.11573841 ... 1.17646583 0.44105193 0.66905833]]
Je kunt de uitschieters niet herkennen door alleen naar bovenstaande output te kijken. Jij pakt het slimmer aan: je definieert zelf een drempel en gebruikt een eenvoudige conditie om uitschieters te detecteren die die drempel overschrijden.
threshold = 3
print(np.where(z > 3))
(array([ 55,  56,  57, 102, 141, 142, 152, 154, 155, 160, 162, 163, 199,
       200, 201, 202, 203, 204, 208, 209, 210, 211, 212, 216, 218, 219,
       220, 221, 222, 225, 234, 236, 256, 257, 262, 269, 273, 274, 276,
       277, 282, 283, 283, 284, 347, 351, 352, 353, 353, 354, 355, 356,
       357, 358, 363, 364, 364, 365, 367, 369, 370, 372, 373, 374, 374,
       380, 398, 404, 405, 406, 410, 410, 411, 412, 412, 414, 414, 415,
       416, 418, 418, 419, 423, 424, 425, 426, 427, 427, 429, 431, 436,
       437, 438, 445, 450, 454, 455, 456, 457, 466], dtype=int32), array([ 1,  1,  1, 11, 12,  3,  3,  3,  3,  3,  3,  3,  1,  1,  1,  1,  1,
        1,  3,  3,  3,  3,  3,  3,  3,  3,  3,  3,  3,  5,  3,  3,  1,  5,
        5,  3,  3,  3,  3,  3,  3,  1,  3,  1,  1,  7,  7,  1,  7,  7,  7,
        3,  3,  3,  3,  3,  5,  5,  5,  3,  3,  3, 12,  5, 12,  0,  0,  0,
        0,  5,  0, 11, 11, 11, 12,  0, 12, 11, 11,  0, 11, 11, 11, 11, 11,
       11,  0, 11, 11, 11, 11, 11, 11, 11, 11, 11, 11, 11, 11, 11],
      dtype=int32))
Weer een verwarrende output! De eerste array bevat de rijnummers en de tweede array de bijbehorende kolomnummers. Bijvoorbeeld: z[55][1] heeft een Z-score groter dan 3.
print(z[55][1])
3.375038763517309
Dus het 55e record in kolom ZN is een uitschieter. Hier kun je op voortbouwen.
Je zag hoe je de Z-score kunt gebruiken en een drempel kunt instellen om potentiële uitschieters te detecteren. Vervolgens ga je missende waarden imputeren.
Je gebruikt de bekende Pima Indian Diabetes-dataset, die bekendstaat om ontbrekende waarden. Maar eerst laad je de dataset in je werkomgeving.
Je laadt de dataset in een DataFrame-object data.
data = pd.read_csv("https://raw.githubusercontent.com/jbrownlee/Datasets/master/pima-indians-diabetes.data.csv",header=None)
print(data.describe())
                0           1           2           3           4           5  \
count  768.000000  768.000000  768.000000  768.000000  768.000000  768.000000
mean     3.845052  120.894531   69.105469   20.536458   79.799479   31.992578
std      3.369578   31.972618   19.355807   15.952218  115.244002    7.884160
min      0.000000    0.000000    0.000000    0.000000    0.000000    0.000000
25%      1.000000   99.000000   62.000000    0.000000    0.000000   27.300000
50%      3.000000  117.000000   72.000000   23.000000   30.500000   32.000000
75%      6.000000  140.250000   80.000000   32.000000  127.250000   36.600000
max     17.000000  199.000000  122.000000   99.000000  846.000000   67.100000

                6           7           8
count  768.000000  768.000000  768.000000
mean     0.471876   33.240885    0.348958
std      0.331329   11.760232    0.476951
min      0.078000   21.000000    0.000000
25%      0.243750   24.000000    0.000000
50%      0.372500   29.000000    0.000000
75%      0.626250   41.000000    1.000000
max      2.420000   81.000000    1.000000
Je ziet dat de kolomnamen numeriek zijn. Dat komt doordat je een al voorbewerkte dataset gebruikt. Geen zorgen, de namen worden later duidelijk.
Deze dataset staat bekend om ontbrekende waarden, maar op het eerste gezicht lijkt dat niet zo. Kijk je beter, dan zie je dat sommige kolommen een nulwaarde hebben waar dat inhoudelijk niet kan. Dat zijn de ontbrekende waarden.
Specifiek hebben de volgende kolommen een ongeldige minimumwaarde van nul:
Bevestigen we dit door naar de ruwe data te kijken; hieronder de eerste 20 rijen.
data.head(20)
| 0 | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | |
|---|---|---|---|---|---|---|---|---|---|
| 0 | 6 | 148 | 72 | 35 | 0 | 33.6 | 0.627 | 50 | 1 |
| 1 | 1 | 85 | 66 | 29 | 0 | 26.6 | 0.351 | 31 | 0 |
| 2 | 8 | 183 | 64 | 0 | 0 | 23.3 | 0.672 | 32 | 1 |
| 3 | 1 | 89 | 66 | 23 | 94 | 28.1 | 0.167 | 21 | 0 |
| 4 | 0 | 137 | 40 | 35 | 168 | 43.1 | 2.288 | 33 | 1 |
| 5 | 5 | 116 | 74 | 0 | 0 | 25.6 | 0.201 | 30 | 0 |
| 6 | 3 | 78 | 50 | 32 | 88 | 31.0 | 0.248 | 26 | 1 |
| 7 | 10 | 115 | 0 | 0 | 0 | 35.3 | 0.134 | 29 | 0 |
| 8 | 2 | 197 | 70 | 45 | 543 | 30.5 | 0.158 | 53 | 1 |
| 9 | 8 | 125 | 96 | 0 | 0 | 0.0 | 0.232 | 54 | 1 |
| 10 | 4 | 110 | 92 | 0 | 0 | 37.6 | 0.191 | 30 | 0 |
| 11 | 10 | 168 | 74 | 0 | 0 | 38.0 | 0.537 | 34 | 1 |
| 12 | 10 | 139 | 80 | 0 | 0 | 27.1 | 1.441 | 57 | 0 |
| 13 | 1 | 189 | 60 | 23 | 846 | 30.1 | 0.398 | 59 | 1 |
| 14 | 5 | 166 | 72 | 19 | 175 | 25.8 | 0.587 | 51 | 1 |
| 15 | 7 | 100 | 0 | 0 | 0 | 30.0 | 0.484 | 32 | 1 |
| 16 | 0 | 118 | 84 | 47 | 230 | 45.8 | 0.551 | 31 | 1 |
| 17 | 7 | 107 | 74 | 0 | 0 | 29.6 | 0.254 | 31 | 1 |
| 18 | 1 | 103 | 30 | 38 | 83 | 43.3 | 0.183 | 33 | 0 |
| 19 | 1 | 115 | 70 | 30 | 96 | 34.6 | 0.529 | 32 | 1 |
Duidelijk zijn er 0-waarden in kolommen 2, 3, 4 en 5.
Omdat missende waarden als 0 zijn genoteerd, is het lastiger om dit met conventionele middelen af te handelen. Samenvatten van de aanpak:
NaN.# Step 1: Get the count of zeros in each of the columns
print((data[[1,2,3,4,5]] == 0).sum())
1      5
2     35
3    227
4    374
5     11
dtype: int64
Je ziet dat kolommen 1, 2 en 5 weinig nullen hebben, terwijl 3 en 4 er veel meer hebben, bijna de helft van de rijen.
# Step -2: Mark zero values as missing or NaN
data[[1,2,3,4,5]] = data[[1,2,3,4,5]].replace(0, np.NaN)

# Count the number of NaN values in each column
print(data.isnull().sum())
0      0
1      5
2     35
3    227
4    374
5     11
6      0
7      0
8      0
dtype: int64
Controleren we nu of de NaN-vervanging gelukt is door naar de dataset te kijken:
# Step 4
data.head(20)
| 0 | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | |
|---|---|---|---|---|---|---|---|---|---|
| 0 | 6 | 148.0 | 72.0 | 35.0 | NaN | 33.6 | 0.627 | 50 | 1 |
| 1 | 1 | 85.0 | 66.0 | 29.0 | NaN | 26.6 | 0.351 | 31 | 0 |
| 2 | 8 | 183.0 | 64.0 | NaN | NaN | 23.3 | 0.672 | 32 | 1 |
| 3 | 1 | 89.0 | 66.0 | 23.0 | 94.0 | 28.1 | 0.167 | 21 | 0 |
| 4 | 0 | 137.0 | 40.0 | 35.0 | 168.0 | 43.1 | 2.288 | 33 | 1 |
| 5 | 5 | 116.0 | 74.0 | NaN | NaN | 25.6 | 0.201 | 30 | 0 |
| 6 | 3 | 78.0 | 50.0 | 32.0 | 88.0 | 31.0 | 0.248 | 26 | 1 |
| 7 | 10 | 115.0 | NaN | NaN | NaN | 35.3 | 0.134 | 29 | 0 |
| 8 | 2 | 197.0 | 70.0 | 45.0 | 543.0 | 30.5 | 0.158 | 53 | 1 |
| 9 | 8 | 125.0 | 96.0 | NaN | NaN | NaN | 0.232 | 54 | 1 |
| 10 | 4 | 110.0 | 92.0 | NaN | NaN | 37.6 | 0.191 | 30 | 0 |
| 11 | 10 | 168.0 | 74.0 | NaN | NaN | 38.0 | 0.537 | 34 | 1 |
| 12 | 10 | 139.0 | 80.0 | NaN | NaN | 27.1 | 1.441 | 57 | 0 |
| 13 | 1 | 189.0 | 60.0 | 23.0 | 846.0 | 30.1 | 0.398 | 59 | 1 |
| 14 | 5 | 166.0 | 72.0 | 19.0 | 175.0 | 25.8 | 0.587 | 51 | 1 |
| 15 | 7 | 100.0 | NaN | NaN | NaN | 30.0 | 0.484 | 32 | 1 |
| 16 | 0 | 118.0 | 84.0 | 47.0 | 230.0 | 45.8 | 0.551 | 31 | 1 |
| 17 | 7 | 107.0 | 74.0 | NaN | NaN | 29.6 | 0.254 | 31 | 1 |
| 18 | 1 | 103.0 | 30.0 | 38.0 | 83.0 | 43.3 | 0.183 | 33 | 0 |
| 19 | 1 | 115.0 | 70.0 | 30.0 | 96.0 | 34.6 | 0.529 | 32 | 1 |
Je ziet dat het markeren van missende waarden het gewenste effect had.
Tot nu toe heb je trends geanalyseerd bij ontbrekende data en hoe je simpele statistische maten kunt gebruiken om grip te krijgen. Nu ga je de missende waarden imputeren met gemiddelde-imputatie: je vult het gemiddelde van de betreffende kolom in op de missende plekken.
# Step 5: Call the fillna() function with the imputation strategy
data.fillna(data.mean(), inplace=True)

# Count the number of NaN values in each column to verify
print(data.isnull().sum())
0    0
1    0
2    0
3    0
4    0
5    0
6    0
7    0
8    0
dtype: int64
Uitstekend!
Dit DataCamp-artikel begeleidt je effectief bij het implementeren van dataschaling als stap in de datapreprocessing. Zeker even bekijken.
Vervolgens ga je variabelen encoderen.
Daarvoor heb je een dataset nodig met niet-numerieke data. Je gebruikt de bekende Iris-dataset.
# Load the dataset to a DataFrame object iris
iris = pd.read_csv("http://archive.ics.uci.edu/ml/machine-learning-databases/iris/iris.data",header=None)
# See first 20 rows of the dataset
iris.head(20)
| 0 | 1 | 2 | 3 | 4 | |
|---|---|---|---|---|---|
| 0 | 5.1 | 3.5 | 1.4 | 0.2 | Iris-setosa |
| 1 | 4.9 | 3.0 | 1.4 | 0.2 | Iris-setosa |
| 2 | 4.7 | 3.2 | 1.3 | 0.2 | Iris-setosa |
| 3 | 4.6 | 3.1 | 1.5 | 0.2 | Iris-setosa |
| 4 | 5.0 | 3.6 | 1.4 | 0.2 | Iris-setosa |
| 5 | 5.4 | 3.9 | 1.7 | 0.4 | Iris-setosa |
| 6 | 4.6 | 3.4 | 1.4 | 0.3 | Iris-setosa |
| 7 | 5.0 | 3.4 | 1.5 | 0.2 | Iris-setosa |
| 8 | 4.4 | 2.9 | 1.4 | 0.2 | Iris-setosa |
| 9 | 4.9 | 3.1 | 1.5 | 0.1 | Iris-setosa |
| 10 | 5.4 | 3.7 | 1.5 | 0.2 | Iris-setosa |
| 11 | 4.8 | 3.4 | 1.6 | 0.2 | Iris-setosa |
| 12 | 4.8 | 3.0 | 1.4 | 0.1 | Iris-setosa |
| 13 | 4.3 | 3.0 | 1.1 | 0.1 | Iris-setosa |
| 14 | 5.8 | 4.0 | 1.2 | 0.2 | Iris-setosa |
| 15 | 5.7 | 4.4 | 1.5 | 0.4 | Iris-setosa |
| 16 | 5.4 | 3.9 | 1.3 | 0.4 | Iris-setosa |
| 17 | 5.1 | 3.5 | 1.4 | 0.3 | Iris-setosa |
| 18 | 5.7 | 3.8 | 1.7 | 0.3 | Iris-setosa |
| 19 | 5.1 | 3.8 | 1.5 | 0.3 | Iris-setosa |
Je kunt de stringwaarden eenvoudig omzetten naar gehele getallen met de LabelEncoder. De drie klassen (Iris-setosa, Iris-versicolor, Iris-virginica) worden dan gemapt op de integers (0, 1, 2).
In dit geval bevat de vierde kolom/feature niet-numerieke waarden. Die moet je dus apart nemen.
# Convert the DataFrame to a NumPy array
iris = iris.values

# Separate
Y = iris[:,4]
# Label Encode string class values as integers
from sklearn.preprocessing import LabelEncoder

label_encoder = LabelEncoder()
label_encoder = label_encoder.fit(Y)
label_encoded_y = label_encoder.transform(Y)
Nu bekijken we een ander gebied waar basiskennis statistiek cruciaal is.
Je hebt je machinelearning-model ontworpen en ontwikkeld. Nu wil je de prestaties op de testdata evalueren. Je gebruikt hierbij diverse statistische maatstaven zoals Precision, Recall, ROC, AUC, RMSE, enz. Ook maak je gebruik van verschillende resampling-technieken zoals k-fold cross-validation.
Statistiek kan effectief worden gebruikt om:
Belangrijk: met hypothese worden geleerde modellen bedoeld; de resultaten van het draaien van een leeralgoritme op een dataset. Het evalueren en vergelijken van de hypothese betekent dus modellen vergelijken, wat anders is dan leeralgoritmes vergelijken die op verschillende steekproeven of problemen zijn getraind.
Laten we nu Gaussische en beschrijvende statistiek bekijken.
Een steekproef is niets anders dan een momentopname uit een grotere populatie van alle potentiële observaties die uit een domein genomen of door een proces gegenereerd kunnen worden.
Opvallend genoeg volgen veel observaties een typisch patroon of verdeling: de normale verdeling, of formeler, de Gaussische verdeling. Dat is de klokvormige verdeling die je vast kent. De volgende figuur toont een Gaussische verdeling:
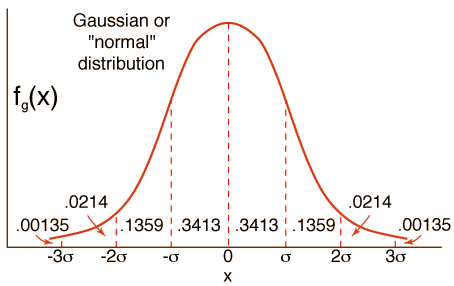
Bron: HyperPhysics
Gaussische processen en verdelingen vormen op zich al subvelden. Maar we bekijken nu twee van de belangrijkste bouwstenen van Gaussische verdelingen in het algemeen.
Elke steekproef uit een Gaussische verdeling kan worden samengevat met twee parameters:
De term variantie leidt ook tot een andere cruciale term: standaarddeviatie, simpelweg de vierkantswortel van de variantie.
Gemiddelde, variantie en standaarddeviatie kun je direct uit data berekenen met numpy.
Je genereert eerst 100 willekeurige getallen uit een Gaussische verdeling met gemiddelde 50 en standaarddeviatie 5. Daarna bereken je de samenvattende statistieken.
Eerst importeer je de afhankelijkheden.
#  Dependencies
from numpy.random import seed
from numpy.random import randn
from numpy import mean
from numpy import var
from numpy import std
Vervolgens stel je de seed van de willekeurige getallengenerator in, zodat je resultaten reproduceerbaar zijn.
seed(1)
# Generate univariate observations
data = 5 * randn(10000) + 50
# Calculate statistics
print('Mean: %.3f' % mean(data))
print('Variance: %.3f' % var(data))
print('Standard Deviation: %.3f' % std(data))
Mean: 50.049
Variance: 24.939
Standard Deviation: 4.994
Redelijk dichtbij, toch?
Door naar het volgende onderwerp.
Features in een dataset houden vaak verband met elkaar, wat in de praktijk heel logisch is. In statistische termen heet deze relatie tussen features (eenvoudig of complex) vaak correlatie.
Het is belangrijk om de mate van correlatie tussen features te bepalen. Deze stap fungeert als featureselectie: het selecteren van de belangrijkste features uit een dataset. Deze stap is cruciaal in een standaard machinelearning-pijplijn, omdat hij de nauwkeurigheid sterk kan verbeteren in minder tijd.
Om het praktisch te houden: waarom kunnen features met elkaar samenhangen?
Correlatie tussen features kan drie typen hebben: positieve correlatie waarbij beide features in dezelfde richting veranderen, neutrale correlatie wanneer er geen relatie is, en negatieve correlatie waarbij ze in tegengestelde richtingen veranderen.
Correlatiematen vormen de basis van filtergebaseerde featureselectietechnieken. Bekijk dit artikel als je meer wilt leren over featureselectie.
Je kunt de relatie tussen twee variabelen wiskundig vastleggen met een statistische methode genaamd de Pearson-correlatiecoëfficiënt, genoemd naar Karl Pearson.
Je kunt Pearson’s correlatie berekenen met de corr()-functie van pandas en method op pearson zetten. Laten we de correlatie bestuderen tussen de features van de Pima Indians Diabetes-dataset die je eerder gebruikte. De data is al in goede staat.
# Data
data.head()
| 0 | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | |
|---|---|---|---|---|---|---|---|---|---|
| 0 | 6 | 148.0 | 72.0 | 35.00000 | 155.548223 | 33.6 | 0.627 | 50 | 1 |
| 1 | 1 | 85.0 | 66.0 | 29.00000 | 155.548223 | 26.6 | 0.351 | 31 | 0 |
| 2 | 8 | 183.0 | 64.0 | 29.15342 | 155.548223 | 23.3 | 0.672 | 32 | 1 |
| 3 | 1 | 89.0 | 66.0 | 23.00000 | 94.000000 | 28.1 | 0.167 | 21 | 0 |
| 4 | 0 | 137.0 | 40.0 | 35.00000 | 168.000000 | 43.1 | 2.288 | 33 | 1 |
# Create the matrix of correlation score between the features and the label
scoreTable = data.corr(method='pearson')
# Visulaize the matrix
data.corr(method='pearson').style.format("{:.2}").background_gradient(cmap=plt.get_cmap('coolwarm'), axis=1)

Je ziet duidelijk de Pearson-correlatie tussen alle features en het label van de dataset.
In de volgende sectie behandel je niet-parametrische statistiek.
Een groot deel van statistiek en statistische methoden is gericht op data met een bekende verdeling.
Niet-parametrische statistiek is handig wanneer er weinig of geen informatie is over populatieparameters. Niet-parametrische tests doen geen aannames over de verdeling van de data.
Als je met niet-parametrische data werkt, kun je gespecialiseerde niet-parametrische methoden gebruiken die alle informatie over de verdeling negeren. Daarom worden ze vaak verdelingsvrije methoden genoemd.
Maar vóórdat een niet-parametrische methode kan worden toegepast, moet de data worden omgezet naar rangordeformaat. Statistische methoden die rangdata verwachten, worden soms rangstatistiek genoemd. Voorbeelden zijn rangcorrelatie en rang-hypothesetests. Data rangschikken is precies wat het zegt.
Een veelgebruikte niet-parametrische hypothesetest om een verschil tussen twee onafhankelijke steekproeven te checken is de Mann-Whitney U-test, genoemd naar Henry Mann en Donald Whitney.
Je implementeert deze test in Python via mannwhitneyu() uit SciPy.
# The dependencies that you need
from scipy.stats import mannwhitneyu
from numpy.random import rand

# seed the random number generator
seed(1)
# Generate two independent samples
data1 = 50 + (rand(100) * 10)
data2 = 51 + (rand(100) * 10)
# Compare samples
stat, p = mannwhitneyu(data1, data2)
print('Statistics = %.3f, p = %.3f' % (stat, p))
# Interpret
alpha = 0.05
if p > alpha:
    print('Same distribution (fail to reject H0)')
else:
    print('Different distribution (reject H0)')
Statistics = 4077.000, p = 0.012
Different distribution (reject H0)
alpha is de drempelparameter die je zelf kiest. De mannwhitneyu() geeft twee dingen terug:
statistic: De Mann-Whitney U-statistiek, gelijk aan min(U voor x, U voor y) als alternative gelijk is aan None (verouderd; voor backward compatibility), en anders U voor y.
pvalue: p-waarde onder aanname van een asymptotische normale verdeling.
Wil je meer niet-parametrische methoden bestuderen, kijk dan hier.
Twee andere populaire niet-parametrische significantietests die je kunt gebruiken zijn:
Je bent tot het einde gekomen. In dit artikel heb je allerlei essentiële statistische concepten bestudeerd die een cruciale rol spelen in je machinelearning-projecten. Ze begrijpen is dus simpelweg belangrijk.
Van een introductie tot statistiek ging je naar rangstatistiek, mét meerdere implementaties. Dat is zeker een prestatie. Je bekeek drie verschillende datasets, benut pandas en numpy ten volle en gebruikte bovendien SciPy. Hieronder wat links om verder te gaan:
De volgende bronnen heb ik gebruikt bij het schrijven van deze blog:
Laat je mening/vragen achter in de reacties. Bekijk ook DataCamps cursus "Statistical Thinking in Python", die zeer praktijkgericht is.
Python-cursussen
{count, plural, one {Cursus} other {Cursussen}}
{count, plural, one {Cursus} other {Cursussen}}
{count, plural, one {Cursus} other {Cursussen}}
{count, plural, one {blog} other {blogs}}
Adel Nehme
15 min

