Curso
Introducción a Python
4 h
7M
Si tienes poca experiencia aplicando algoritmos de aprendizaje automático, habrás visto que no exigen saber Estadística de antemano.
Aun así, conocer algo de estadística ayuda mucho a entender el machine learning tanto a nivel técnico como intuitivo. Además, tarde o temprano la vas a necesitar para validar e interpretar tus resultados. Al fin y al cabo, donde hay datos, hay estadística. Igual que las matemáticas son el lenguaje de la ciencia, la estadística es un idioma fundamental para la ciencia de datos y el aprendizaje automático.
La estadística es una rama de las matemáticas con multitud de teorías y resultados. De ella se han tomado conceptos, herramientas, técnicas y notación que han dado forma al machine learning actual. Puedes usar métodos estadísticos descriptivos para transformar observaciones en información útil que puedas entender y compartir. Con técnicas inferenciales puedes razonar desde pequeñas muestras hacia poblaciones completas. Más adelante verás estadística descriptiva e inferencial. Así que, tranquilo.
Antes de empezar, veamos diez ejemplos de dónde se usan métodos estadísticos en un proyecto práctico de machine learning:
Fuente: Statistical Methods for Machine Learning
¿Interesante, verdad?
Este post te dará una base sólida en la estadística esencial —y necesaria— para convertirte en un buen profesional de machine learning.
En este post vas a ver:
Tienes bastante por cubrir y todo es igual de importante. ¡Vamos allá!
Definamos rápidamente la estadística en términos sencillos.
La estadística es una subdisciplina de las matemáticas. Abarca multitud de métodos para trabajar con datos y utilizarlos para responder a muchas preguntas.
En la práctica, conviene dividir la estadística en dos grandes grupos de métodos: estadística descriptiva para resumir datos y estadística inferencial para sacar conclusiones a partir de muestras de datos (Statistics for Machine Learning (7-Day Mini-Course).

Fuente: IntellSpot
Estadística inferencial: son métodos que ayudan a cuantificar propiedades de un dominio o población a partir de un conjunto más pequeño de observaciones, la muestra. La infografía siguiente ilustra muy bien la estadística inferencial:
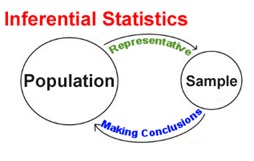
Fuente: Analytics Vidhya
En la siguiente sección verás cómo usar estadística para preparar datos.
Los métodos estadísticos son necesarios para generar los conjuntos de entrenamiento y prueba de tu modelo de machine learning.
Esto incluye técnicas de:
Necesitas una base sobre distribuciones de datos, estadística descriptiva y visualización para elegir bien qué métodos aplicar en cada tarea.
Analicemos brevemente cada punto.
Primero, ¿qué es un valor atípico?
Se considera valor atípico a una observación que parece desviarse del resto de observaciones de la muestra. La siguiente figura aclara la definición.

Fuente: MathWorks
Puedes localizar los atípicos en los datos como muestra la figura.
Muchos algoritmos de machine learning son sensibles al rango y la distribución de los valores de los atributos de entrada. Los atípicos pueden sesgar y confundir el entrenamiento, alargando los tiempos, reduciendo la precisión y, en definitiva, empeorando los resultados.
Identificar posibles atípicos es clave por estos motivos:
Un atípico podría indicar que el dato es erróneo. Por ejemplo, un código mal introducido o un experimento mal ejecutado. Si se determina que el punto atípico es efectivamente un error, conviene eliminarlo del análisis o corregirlo si es posible.
A veces no es posible saber si un atípico es un dato malo. Puede deberse a variación aleatoria o a algo científicamente interesante. En cualquier caso, no conviene borrarlo sin más. Si hay muchos atípicos, valora usar técnicas estadísticas robustas.
Así que, a menudo, los atípicos no ayudan a tus modelos predictivos (aunque a veces se pueden aprovechar, pero eso queda fuera de este post). Necesitas recursos estadísticos para gestionarlos bien.
Hoy en día, muchos conjuntos de datos sufren el problema de los valores faltantes. Tu modelo puede no entrenarse bien si los datos de entrada los contienen. Aquí entran en juego las herramientas y técnicas estadísticas.
Mucha gente descarta las instancias con valores faltantes. No es buena práctica, porque puedes perder información o representaciones importantes. Aunque existen métodos avanzados, dos técnicas rápidas muy usadas son la imputación por media y la imputación por mediana.
Es fundamental que entiendas qué son media y mediana.
Imagina que tienes una característica X1 con estos valores: 13, 18, 13, 14, 13, 16, 14, 21, 13
La media es el promedio habitual, suma y divide:
(13 + 18 + 13 + 14 + 13 + 16 + 14 + 21 + 13) / 9 = 15
Fíjate en que la media, en este caso, no es un valor de la lista original. Es habitual. No debes suponer que la media será uno de los números originales.
La mediana es el valor central; primero ordena la lista:
13, 13, 13, 13, 14, 14, 16, 18, 21
Hay nueve números, así que el central es el (9 + 1) / 2 = 10 / 2 = 5.º:
13, 13, 13, 13, 14, 14, 16, 18, 21
La mediana es 14.
El dato es la moneda del machine learning aplicado. Por tanto, su captura y uso son igual de importantes.
El muestreo de datos se refiere a métodos estadísticos para seleccionar observaciones de un dominio con el objetivo de estimar un parámetro poblacional. Es decir, es un proceso activo de recoger observaciones para estimar una variable de la población.
Cada fila de un dataset representa una observación indicativa de una población concreta. A menudo no tienes acceso a todas las observaciones posibles. Puede ser porque:
Muchas veces no tendrás la proporción adecuada de muestras por clase. Tendrás que submuestrear o sobremuestrear según el problema.
Haces submuestreo cuando una categoría tiene muchas más muestras que las demás; descartas parte de ellas. Haces sobremuestreo cuando una clase tiene muchas menos; generas nuevas muestras.
Esto también aplica a escenarios multiclase.
El muestreo estadístico es un campo amplio, pero en machine learning aplicado es probable que uses tres tipos: muestreo aleatorio simple, muestreo sistemático y muestreo estratificado.
Aunque estos son los más comunes, hay más técnicas (A Gentle Introduction to Statistical Sampling and Resampling).
A menudo, las características de tu dataset tienen rangos muy distintos. Algunas pueden ir de 0 a 100 y otras de 0,01 a 0,001, o 10000 a 20000, etc.
Esto dificulta un modelado eficiente. Un cambio pequeño en una variable de bajo rango puede no tener impacto frente a otras con valores grandes. Afecta al aprendizaje. Tratar este problema es el escalado de datos.
Hay distintas técnicas: Min-Max, escalado absoluto, estandarización, etc.
A veces tus datasets mezclan datos numéricos y no numéricos. Muchos frameworks como scikit-learn esperan todo en formato numérico, lo que además acelera el cómputo.
De nuevo, la estadística te saca del apuro.
Técnicas como Label encoding u One-Hot encoding convierten datos no numéricos en numéricos.
Ya has visto bastante teoría. Vamos a aplicar algunas ideas.
Empezarás aplicando métodos estadísticos para detectar valores atípicos.
Usarás el índice Z-Score para detectarlos y, para ello, investigarás el Boston House Price dataset. Empieza importando el dataset desde las utilidades de sklearn y, sobre la marcha, irás introduciendo los conceptos necesarios.
import pandas as pd
import numpy as np
from sklearn.datasets import load_boston

# Load the Boston dataset into a variable called boston
boston = load_boston()
# Separate the features from the target
x = boston.data
y = boston.target
Para ver el dataset en formato tabular con todos los nombres de las variables, lo convertirás a un dataframe de pandas.
# Take the columns separately in a variable
columns = boston.feature_names

# Create the dataframe
boston_df = pd.DataFrame(boston.data)
boston_df.columns = columns
boston_df.head()

Es habitual empezar con un análisis univariante de atípicos, considerando una variable cada vez. A menudo, un simple boxplot de una característica concreta es un buen punto de partida. Harás un boxplot con seaborn usando la variable DIS.
import seaborn as sns
sns.boxplot(x=boston_df['DIS'])

import matplotlib.pyplot as plt
plt.show()
<matplotlib.axes._subplots.AxesSubplot at 0x8abded0>

Para ver el boxplot, importaste matplotlib porque los gráficos de seaborn se muestran como gráficos normales de matplotlib.
El gráfico muestra tres puntos entre 10 y 12: son atípicos porque quedan fuera de la «caja» del resto de observaciones. Aquí analizaste un atípico univariante, es decir, usaste solo DIS para comprobar atípicos.
Pasemos ahora al Z-Score.
"El Z-score es el número (con signo) de desviaciones estándar que separan el valor de una observación de la media de lo que se está midiendo." - Wikipedia
La idea es describir cualquier punto de datos según su relación con la desviación estándar y la media del grupo. El Z-score reescala y centra los datos (media 0 y desviación estándar 1), es decir, los lleva a una distribución normal.
Espera, ¿y esto cómo ayuda a identificar atípicos?
Al calcular el Z-score reescalas y centras (media 0, desviación 1) y buscas instancias muy alejadas de cero. Esos puntos tan lejanos se consideran atípicos. En la práctica se usa un umbral de 3 o -3. Por ejemplo, si el Z-score es mayor que 3 o menor que -3, esa observación se marca como atípica.
Usarás la función Z-score de scipy para detectarlos.
from scipy import stats

z = np.abs(stats.zscore(boston_df))
print(z)
[[0.41771335 0.28482986 1.2879095  ... 1.45900038 0.44105193 1.0755623 ]
 [0.41526932 0.48772236 0.59338101 ... 0.30309415 0.44105193 0.49243937]
 [0.41527165 0.48772236 0.59338101 ... 0.30309415 0.39642699 1.2087274 ]
 ...
 [0.41137448 0.48772236 0.11573841 ... 1.17646583 0.44105193 0.98304761]
 [0.40568883 0.48772236 0.11573841 ... 1.17646583 0.4032249  0.86530163]
 [0.41292893 0.48772236 0.11573841 ... 1.17646583 0.44105193 0.66905833]]
No es posible detectar atípicos solo mirando ese volcado. Mejor define tu umbral y usa una condición sencilla para localizar los que lo superen.
threshold = 3
print(np.where(z > 3))
(array([ 55,  56,  57, 102, 141, 142, 152, 154, 155, 160, 162, 163, 199,
       200, 201, 202, 203, 204, 208, 209, 210, 211, 212, 216, 218, 219,
       220, 221, 222, 225, 234, 236, 256, 257, 262, 269, 273, 274, 276,
       277, 282, 283, 283, 284, 347, 351, 352, 353, 353, 354, 355, 356,
       357, 358, 363, 364, 364, 365, 367, 369, 370, 372, 373, 374, 374,
       380, 398, 404, 405, 406, 410, 410, 411, 412, 412, 414, 414, 415,
       416, 418, 418, 419, 423, 424, 425, 426, 427, 427, 429, 431, 436,
       437, 438, 445, 450, 454, 455, 456, 457, 466], dtype=int32), array([ 1,  1,  1, 11, 12,  3,  3,  3,  3,  3,  3,  3,  1,  1,  1,  1,  1,
        1,  3,  3,  3,  3,  3,  3,  3,  3,  3,  3,  3,  5,  3,  3,  1,  5,
        5,  3,  3,  3,  3,  3,  3,  1,  3,  1,  1,  7,  7,  1,  7,  7,  7,
        3,  3,  3,  3,  3,  5,  5,  5,  3,  3,  3, 12,  5, 12,  0,  0,  0,
        0,  5,  0, 11, 11, 11, 12,  0, 12, 11, 11,  0, 11, 11, 11, 11, 11,
       11,  0, 11, 11, 11, 11, 11, 11, 11, 11, 11, 11, 11, 11, 11],
      dtype=int32))
Otra salida confusa: el primer array contiene las filas y el segundo sus columnas respectivas. Por ejemplo, z[55][1] tiene un Z-score mayor que 3.
print(z[55][1])
3.375038763517309
Así que el registro 55 en la columna ZN es atípico. Desde aquí puedes extender el análisis.
Has visto cómo usar Z-Score y fijar un umbral para detectar posibles atípicos. A continuación, verás imputación de valores faltantes.
Usarás el conocido dataset de Pima Indian Diabetes, famoso por contener valores faltantes. Antes, cárgalo en tu espacio de trabajo.
Cargarás el dataset en un DataFrame llamado data.
data = pd.read_csv("https://raw.githubusercontent.com/jbrownlee/Datasets/master/pima-indians-diabetes.data.csv",header=None)
print(data.describe())
                0           1           2           3           4           5  \
count  768.000000  768.000000  768.000000  768.000000  768.000000  768.000000
mean     3.845052  120.894531   69.105469   20.536458   79.799479   31.992578
std      3.369578   31.972618   19.355807   15.952218  115.244002    7.884160
min      0.000000    0.000000    0.000000    0.000000    0.000000    0.000000
25%      1.000000   99.000000   62.000000    0.000000    0.000000   27.300000
50%      3.000000  117.000000   72.000000   23.000000   30.500000   32.000000
75%      6.000000  140.250000   80.000000   32.000000  127.250000   36.600000
max     17.000000  199.000000  122.000000   99.000000  846.000000   67.100000

                6           7           8
count  768.000000  768.000000  768.000000
mean     0.471876   33.240885    0.348958
std      0.331329   11.760232    0.476951
min      0.078000   21.000000    0.000000
25%      0.243750   24.000000    0.000000
50%      0.372500   29.000000    0.000000
75%      0.626250   41.000000    1.000000
max      2.420000   81.000000    1.000000
Habrás notado que las columnas tienen nombres numéricos: es un dataset ya preprocesado. No pasa nada, descubrirás los nombres en seguida.
Este dataset tiene valores faltantes, pero a primera vista podría parecer que no. Mirando más de cerca, verás que en algunas columnas el valor mínimo es 0 cuando no debería serlo. Esos ceros representan datos faltantes.
Concretamente, estas columnas tienen un 0 inválido como mínimo:
Confirmémoslo viendo los datos en bruto: a continuación se imprimen las 20 primeras filas.
data.head(20)
| 0 | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | |
|---|---|---|---|---|---|---|---|---|---|
| 0 | 6 | 148 | 72 | 35 | 0 | 33.6 | 0.627 | 50 | 1 |
| 1 | 1 | 85 | 66 | 29 | 0 | 26.6 | 0.351 | 31 | 0 |
| 2 | 8 | 183 | 64 | 0 | 0 | 23.3 | 0.672 | 32 | 1 |
| 3 | 1 | 89 | 66 | 23 | 94 | 28.1 | 0.167 | 21 | 0 |
| 4 | 0 | 137 | 40 | 35 | 168 | 43.1 | 2.288 | 33 | 1 |
| 5 | 5 | 116 | 74 | 0 | 0 | 25.6 | 0.201 | 30 | 0 |
| 6 | 3 | 78 | 50 | 32 | 88 | 31.0 | 0.248 | 26 | 1 |
| 7 | 10 | 115 | 0 | 0 | 0 | 35.3 | 0.134 | 29 | 0 |
| 8 | 2 | 197 | 70 | 45 | 543 | 30.5 | 0.158 | 53 | 1 |
| 9 | 8 | 125 | 96 | 0 | 0 | 0.0 | 0.232 | 54 | 1 |
| 10 | 4 | 110 | 92 | 0 | 0 | 37.6 | 0.191 | 30 | 0 |
| 11 | 10 | 168 | 74 | 0 | 0 | 38.0 | 0.537 | 34 | 1 |
| 12 | 10 | 139 | 80 | 0 | 0 | 27.1 | 1.441 | 57 | 0 |
| 13 | 1 | 189 | 60 | 23 | 846 | 30.1 | 0.398 | 59 | 1 |
| 14 | 5 | 166 | 72 | 19 | 175 | 25.8 | 0.587 | 51 | 1 |
| 15 | 7 | 100 | 0 | 0 | 0 | 30.0 | 0.484 | 32 | 1 |
| 16 | 0 | 118 | 84 | 47 | 230 | 45.8 | 0.551 | 31 | 1 |
| 17 | 7 | 107 | 74 | 0 | 0 | 29.6 | 0.254 | 31 | 1 |
| 18 | 1 | 103 | 30 | 38 | 83 | 43.3 | 0.183 | 33 | 0 |
| 19 | 1 | 115 | 70 | 30 | 96 | 34.6 | 0.529 | 32 | 1 |
Claramente hay ceros en las columnas 2, 3, 4 y 5.
Como este dataset marca faltantes con 0, manejarlo con medios convencionales puede ser engañoso. Resumamos el enfoque:
NaN.# Step 1: Get the count of zeros in each of the columns
print((data[[1,2,3,4,5]] == 0).sum())
1      5
2     35
3    227
4    374
5     11
dtype: int64
Ves que las columnas 1, 2 y 5 tienen pocos ceros, mientras que 3 y 4 tienen muchos, casi la mitad de las filas.
# Step -2: Mark zero values as missing or NaN
data[[1,2,3,4,5]] = data[[1,2,3,4,5]].replace(0, np.NaN)

# Count the number of NaN values in each column
print(data.isnull().sum())
0      0
1      5
2     35
3    227
4    374
5     11
6      0
7      0
8      0
dtype: int64
Asegurémonos ahora de que el reemplazo por NaN ha funcionado viendo el dataset:
# Step 4
data.head(20)
| 0 | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | |
|---|---|---|---|---|---|---|---|---|---|
| 0 | 6 | 148.0 | 72.0 | 35.0 | NaN | 33.6 | 0.627 | 50 | 1 |
| 1 | 1 | 85.0 | 66.0 | 29.0 | NaN | 26.6 | 0.351 | 31 | 0 |
| 2 | 8 | 183.0 | 64.0 | NaN | NaN | 23.3 | 0.672 | 32 | 1 |
| 3 | 1 | 89.0 | 66.0 | 23.0 | 94.0 | 28.1 | 0.167 | 21 | 0 |
| 4 | 0 | 137.0 | 40.0 | 35.0 | 168.0 | 43.1 | 2.288 | 33 | 1 |
| 5 | 5 | 116.0 | 74.0 | NaN | NaN | 25.6 | 0.201 | 30 | 0 |
| 6 | 3 | 78.0 | 50.0 | 32.0 | 88.0 | 31.0 | 0.248 | 26 | 1 |
| 7 | 10 | 115.0 | NaN | NaN | NaN | 35.3 | 0.134 | 29 | 0 |
| 8 | 2 | 197.0 | 70.0 | 45.0 | 543.0 | 30.5 | 0.158 | 53 | 1 |
| 9 | 8 | 125.0 | 96.0 | NaN | NaN | NaN | 0.232 | 54 | 1 |
| 10 | 4 | 110.0 | 92.0 | NaN | NaN | 37.6 | 0.191 | 30 | 0 |
| 11 | 10 | 168.0 | 74.0 | NaN | NaN | 38.0 | 0.537 | 34 | 1 |
| 12 | 10 | 139.0 | 80.0 | NaN | NaN | 27.1 | 1.441 | 57 | 0 |
| 13 | 1 | 189.0 | 60.0 | 23.0 | 846.0 | 30.1 | 0.398 | 59 | 1 |
| 14 | 5 | 166.0 | 72.0 | 19.0 | 175.0 | 25.8 | 0.587 | 51 | 1 |
| 15 | 7 | 100.0 | NaN | NaN | NaN | 30.0 | 0.484 | 32 | 1 |
| 16 | 0 | 118.0 | 84.0 | 47.0 | 230.0 | 45.8 | 0.551 | 31 | 1 |
| 17 | 7 | 107.0 | 74.0 | NaN | NaN | 29.6 | 0.254 | 31 | 1 |
| 18 | 1 | 103.0 | 30.0 | 38.0 | 83.0 | 43.3 | 0.183 | 33 | 0 |
| 19 | 1 | 115.0 | 70.0 | 30.0 | 96.0 | 34.6 | 0.529 | 32 | 1 |
Ves que marcar los faltantes ha tenido el efecto esperado.
Hasta ahora analizaste patrones cuando faltan datos y cómo apoyarte en medidas simples para gestionarlos. Ahora imputarás los faltantes con imputación por media, que consiste en sustituirlos por la media de su columna.
# Step 5: Call the fillna() function with the imputation strategy
data.fillna(data.mean(), inplace=True)

# Count the number of NaN values in each column to verify
print(data.isnull().sum())
0    0
1    0
2    0
3    0
4    0
5    0
6    0
7    0
8    0
dtype: int64
¡Perfecto!
Este artículo de DataCamp te guía muy bien para implementar el escalado de datos como paso de preprocesamiento. Échale un vistazo.
Después, harás codificación de variables.
Antes necesitas un dataset con datos no numéricos. Usarás el famoso Iris dataset.
# Load the dataset to a DataFrame object iris
iris = pd.read_csv("http://archive.ics.uci.edu/ml/machine-learning-databases/iris/iris.data",header=None)
# See first 20 rows of the dataset
iris.head(20)
| 0 | 1 | 2 | 3 | 4 | |
|---|---|---|---|---|---|
| 0 | 5.1 | 3.5 | 1.4 | 0.2 | Iris-setosa |
| 1 | 4.9 | 3.0 | 1.4 | 0.2 | Iris-setosa |
| 2 | 4.7 | 3.2 | 1.3 | 0.2 | Iris-setosa |
| 3 | 4.6 | 3.1 | 1.5 | 0.2 | Iris-setosa |
| 4 | 5.0 | 3.6 | 1.4 | 0.2 | Iris-setosa |
| 5 | 5.4 | 3.9 | 1.7 | 0.4 | Iris-setosa |
| 6 | 4.6 | 3.4 | 1.4 | 0.3 | Iris-setosa |
| 7 | 5.0 | 3.4 | 1.5 | 0.2 | Iris-setosa |
| 8 | 4.4 | 2.9 | 1.4 | 0.2 | Iris-setosa |
| 9 | 4.9 | 3.1 | 1.5 | 0.1 | Iris-setosa |
| 10 | 5.4 | 3.7 | 1.5 | 0.2 | Iris-setosa |
| 11 | 4.8 | 3.4 | 1.6 | 0.2 | Iris-setosa |
| 12 | 4.8 | 3.0 | 1.4 | 0.1 | Iris-setosa |
| 13 | 4.3 | 3.0 | 1.1 | 0.1 | Iris-setosa |
| 14 | 5.8 | 4.0 | 1.2 | 0.2 | Iris-setosa |
| 15 | 5.7 | 4.4 | 1.5 | 0.4 | Iris-setosa |
| 16 | 5.4 | 3.9 | 1.3 | 0.4 | Iris-setosa |
| 17 | 5.1 | 3.5 | 1.4 | 0.3 | Iris-setosa |
| 18 | 5.7 | 3.8 | 1.7 | 0.3 | Iris-setosa |
| 19 | 5.1 | 3.8 | 1.5 | 0.3 | Iris-setosa |
Puedes convertir fácilmente las clases de texto a enteros con LabelEncoder. Las tres clases (Iris-setosa, Iris-versicolor, Iris-virginica) se mapean a (0, 1, 2).
En este caso, la quinta columna/característica contiene valores no numéricos. Así que necesitas separarla.
# Convert the DataFrame to a NumPy array
iris = iris.values

# Separate
Y = iris[:,4]
# Label Encode string class values as integers
from sklearn.preprocessing import LabelEncoder

label_encoder = LabelEncoder()
label_encoder = label_encoder.fit(Y)
label_encoded_y = label_encoder.transform(Y)
Ahora pasemos a otra área donde el conocimiento básico de estadística es crucial.
Ya has diseñado y desarrollado tu modelo. Ahora quieres evaluar su rendimiento en los datos de prueba. Para ello, recurres a métricas estadísticas como precisión, recall, ROC, AUC, RMSE, etc. También a técnicas de remuestreo como la validación cruzada k-fold.
La estadística se puede usar para:
Ten en cuenta que aquí hipótesis se refiere a modelos aprendidos; el resultado de ejecutar un algoritmo de aprendizaje sobre un dataset. Evaluar y comparar hipótesis significa comparar modelos aprendidos, que no es lo mismo que evaluar y comparar algoritmos de aprendizaje, que podrían entrenarse con muestras distintas del mismo problema o con problemas diferentes.
Veamos ahora distribución gaussiana y estadística descriptiva.
Una muestra de datos no es más que una instantánea de una población más amplia de observaciones potenciales de un dominio o generadas por un proceso.
Curiosamente, muchas observaciones encajan en un patrón típico llamado distribución normal, o gaussiana. Es la famosa curva de campana. La siguiente figura la ilustra:
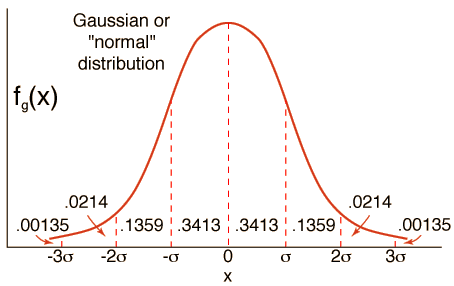
Fuente: HyperPhysics
Los procesos y distribuciones gaussianas son un subcampo en sí mismos. Ahora verás dos ingredientes esenciales que sustentan este mundo.
Cualquier muestra de una distribución gaussiana se resume con dos parámetros:
La varianza da lugar a otro término clave: la desviación estándar, que es la raíz cuadrada de la varianza.
Media, varianza y desviación estándar se calculan directamente con numpy.
Primero generarás 10000 números aleatorios de una gaussiana con media 50 y desviación 5. Luego calcularás los estadísticos resumen.
Importa las dependencias:
#  Dependencies
from numpy.random import seed
from numpy.random import randn
from numpy import mean
from numpy import var
from numpy import std
Después fija la semilla del generador para que los resultados sean reproducibles.
seed(1)
# Generate univariate observations
data = 5 * randn(10000) + 50
# Calculate statistics
print('Mean: %.3f' % mean(data))
print('Variance: %.3f' % var(data))
print('Standard Deviation: %.3f' % std(data))
Mean: 50.049
Variance: 24.939
Standard Deviation: 4.994
Clavado, ¿no?
Sigamos con el siguiente tema.
Las características de un dataset suelen estar relacionadas entre sí, algo bastante normal en la práctica. En términos estadísticos, esta relación (sea simple o compleja) es la correlación.
Es clave conocer el grado de correlación entre variables. Este paso funciona como selección de características, es decir, elegir las más importantes. Es uno de los pasos más relevantes en un flujo de machine learning estándar, porque puede darte un gran salto de precisión en menos tiempo.
Para entenderlo mejor, veamos por qué las características pueden relacionarse:
La correlación entre variables puede ser de tres tipos: positiva (ambas cambian en la misma dirección), nula (no hay relación) y negativa (cambian en direcciones opuestas).
Las medidas de correlación son la base de las técnicas de selección de variables tipo filtro. Revisa este artículo si quieres profundizar.
Puedes medir la relación entre dos variables con el coeficiente de correlación de Pearson, llamado así por su autor, Karl Pearson.
Puedes calcularla con corr() de pandas usando method='pearson'. Veamos la correlación entre las variables del dataset Pima Indians Diabetes que usaste antes. Ya tienes los datos listos.
# Data
data.head()
| 0 | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | |
|---|---|---|---|---|---|---|---|---|---|
| 0 | 6 | 148.0 | 72.0 | 35.00000 | 155.548223 | 33.6 | 0.627 | 50 | 1 |
| 1 | 1 | 85.0 | 66.0 | 29.00000 | 155.548223 | 26.6 | 0.351 | 31 | 0 |
| 2 | 8 | 183.0 | 64.0 | 29.15342 | 155.548223 | 23.3 | 0.672 | 32 | 1 |
| 3 | 1 | 89.0 | 66.0 | 23.00000 | 94.000000 | 28.1 | 0.167 | 21 | 0 |
| 4 | 0 | 137.0 | 40.0 | 35.00000 | 168.000000 | 43.1 | 2.288 | 33 | 1 |
# Create the matrix of correlation score between the features and the label
scoreTable = data.corr(method='pearson')
# Visulaize the matrix
data.corr(method='pearson').style.format("{:.2}").background_gradient(cmap=plt.get_cmap('coolwarm'), axis=1)

Puedes ver claramente la correlación de Pearson entre todas las características y la etiqueta del dataset.
En la siguiente sección verás estadística no paramétrica.
Gran parte de la estadística se dedica a datos cuya distribución es conocida.
La estadística no paramétrica es útil cuando hay poca o ninguna información sobre los parámetros de la población. Estas pruebas no hacen suposiciones sobre la distribución.
Si trabajas con datos no paramétricos, puedes usar métodos específicos que prescinden de toda información sobre la distribución. Por eso a menudo se llaman métodos libres de distribución.
Pero antes de aplicar un método no paramétrico, los datos deben convertirse en rangos. A los métodos que esperan datos ordenados por rangos se les llama estadística de rangos. Ejemplos: correlación por rangos y tests de hipótesis por rangos. Ranquear datos es exactamente eso: ordenarlos.
Una prueba de hipótesis no paramétrica muy usada para comparar dos muestras independientes es la prueba U de Mann-Whitney, de Henry Mann y Donald Whitney.
La implementarás en Python con mannwhitneyu() de SciPy.
# The dependencies that you need
from scipy.stats import mannwhitneyu
from numpy.random import rand

# seed the random number generator
seed(1)
# Generate two independent samples
data1 = 50 + (rand(100) * 10)
data2 = 51 + (rand(100) * 10)
# Compare samples
stat, p = mannwhitneyu(data1, data2)
print('Statistics = %.3f, p = %.3f' % (stat, p))
# Interpret
alpha = 0.05
if p > alpha:
    print('Same distribution (fail to reject H0)')
else:
    print('Different distribution (reject H0)')
Statistics = 4077.000, p = 0.012
Different distribution (reject H0)
alpha es el umbral que decides tú. mannwhitneyu() devuelve:
statistic: el estadístico U de Mann-Whitney, igual a min(U para x, U para y) si alternative es None (obsoleto; por compatibilidad), y U para y en otro caso.
pvalue: el p-valor suponiendo distribución normal asintótica.
Si quieres estudiar otros métodos de estadística no paramétrica, puedes empezar aquí.
Otras dos pruebas no paramétricas populares que puedes usar son:
Has llegado al final. En este artículo has visto una variedad de conceptos estadísticos esenciales que juegan un papel crucial en tus proyectos de machine learning. Entenderlos es importante.
Desde una simple introducción a la estadística hasta pruebas y rankings, con varias implementaciones. No está nada mal. Has trabajado con tres datasets, has exprimido pandas y numpy y también has usado SciPy. Aquí tienes algunos enlaces si quieres seguir:
Estos son los recursos que me han ayudado a escribir este blog:
Cuéntame tus dudas y comentarios. Y echa un ojo al curso de DataCamp "Statistical Thinking in Python", muy orientado a la práctica.
Cursos de Python
Curso
Curso
Curso
Tutorial
Abid Ali Awan
6 min
Tutorial
Moez Ali
14 min
Tutorial
Moez Ali
20 min
Tutorial
Aditya Sharma
8 min
Tutorial
Abid Ali Awan
15 min
Tutorial
Avinash Navlani
10 min



