

Mulai Menggunakan BentoML
Di bagian ini, kita akan menyajikan aplikasi AI sederhana yang menerima pertanyaan dan konteks dari pengguna lalu menghasilkan jawaban.
Kita akan mulai dengan memasang BentoML, PyTorch, dan pustaka Transformers menggunakan pip. Jalankan perintah berikut di terminal Anda:
$ pip install bentoml
$ pip install torch
$ pip install transformersSelanjutnya, kita akan membuat file service.py untuk mendefinisikan server AI.
Dengan perintah BentoML, kita akan mengimpor pipeline Transformers, yang memungkinkan kita memuat model dan melakukan inferensi hanya dengan 2 baris kode.
Kita akan menyiapkan contoh masukan teks dan konteks, mengonfigurasi layanan BentoML dengan parameter seperti jumlah CPU dan traffic timeout, serta menginisialisasi kelas Question_Answering menggunakan pipeline Transformers.
Terakhir, kita akan membuat API bernama generate(), yang menerima input dan output lalu mengembalikan jawaban yang dihasilkan.
from __future__ import annotations
import bentoml
with bentoml.importing():
from transformers import pipeline
EXAMPLE_INPUT = "How can I generate a secure password?"
EXAMPLE_CONTEXT = """
To generate a secure password, you can use tools like the LastPass Password Generator.
These tools create strong, random passwords that help prevent security threats by ensuring your accounts are protected against hacking attempts.
A secure password typically includes a mix of uppercase and lowercase letters, numbers, and special characters. Avoid using easily guessable information like names or birthdays.
Using a password manager like LastPass can also help you store and manage these secure passwords effectively.
"""
@bentoml.service(
resources={"cpu": "4"},
traffic={"timeout": 10},
)
class Question_Answering:
def __init__(self) -> None:
# Load model into pipeline
self.pipe = pipeline(
"question-answering",
model="deepset/roberta-base-squad2",
)
@bentoml.api
def generate(
self,
text: str =EXAMPLE_INPUT,
doc: str = EXAMPLE_CONTEXT,
) -> str:
result = self.pipe(question=text, context=doc)
return result["answer"]Sajikan layanan AI secara lokal dengan mengetik perintah berikut di terminal:
$ bentoml serve service:Question_Answering Seperti yang terlihat, kita telah memberikan perintah di atas dengan nama file (service) dan nama kelas Python (Question_Answering ) untuk inferensi model AI.
Dalam beberapa detik, akan dihasilkan URL yang dapat Anda salin dan tempel di peramban untuk mengakses server BentoML:
[cli] Starting production HTTP BentoServer from "app:Question_Answering" listening on http://localhost:3000 (Press CTRL+C to quit)Server BentoML cukup mirip dengan FastAPI swagger UI.
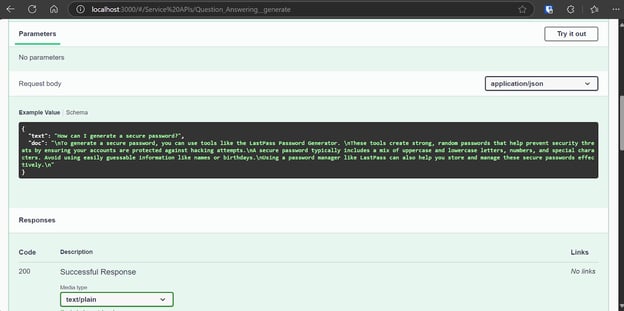
Mari uji server kita menggunakan opsi “Try it out”.
Layanan AI kita berjalan dengan baik dan berhasil menghasilkan respons yang akurat:
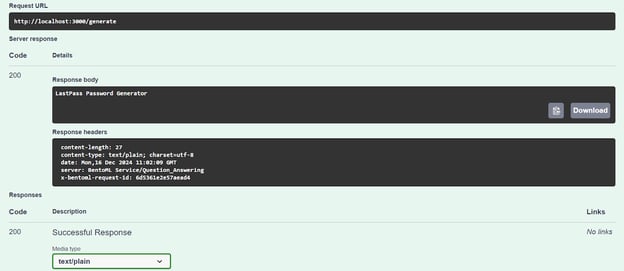
Kita juga dapat mengakses server AI menggunakan perintah CURL. Mari ajukan pertanyaan berbeda dan berikan konteksnya:
curl -X 'POST' \
'http://localhost:3000/generate' \
-H 'accept: text/plain' \
-H 'Content-Type: application/json' \
-d '{
"text": "How can I buy a cheap car?",
"doc": "Start by setting a budget and exploring sources like online marketplaces (Craigslist, Facebook Marketplace, Cars.com), local dealerships, or government auctions. Inspect the car thoroughly for issues like rust or mechanical problems, and consider bringing a trusted mechanic to avoid future repair costs. Research the reliability of specific brands and models using tools like Kelley Blue Book or Consumer Reports. Finally, negotiate the price to secure the best deal. Following these steps can help you find a dependable car within your budget."
}'Layanan AI kita berjalan mulus, dan hanya butuh 1 detik untuk menghasilkan respons bahkan di CPU:
negotiate the priceMendeploy Phi 3 Mini 4k Instruct di BentoCloud
Sekarang saatnya membangun aplikasi AI large language model (LLM) yang layak dan mendeploynya di BentoML dengan upaya dan sumber daya minimal.
Kita akan menggunakan kerangka kerja vLLM untuk membuat inferensi LLM ber-throughput tinggi dan mendeploynya pada instance GPU di BentoCloud. Meskipun terdengar kompleks, BentoCloud menangani sebagian besar pekerjaan berat, termasuk penyiapan infrastruktur, sehingga Anda dapat fokus membangun dan mendeploy layanan Anda.
1. Mengkloning proyek BentoML vLLM
BentoML menyediakan banyak contoh kode dan sumber daya untuk berbagai proyek LLM. Untuk memulai, kita akan mengkloning repositori BentoVLLM.
Buka proyek Phi 3 Mini 4k, dan pasang semua pustaka Python yang diperlukan:
$ git clone https://github.com/bentoml/BentoVLLM.git
$ cd BentoVLLM/phi-3-mini-4k-instruct
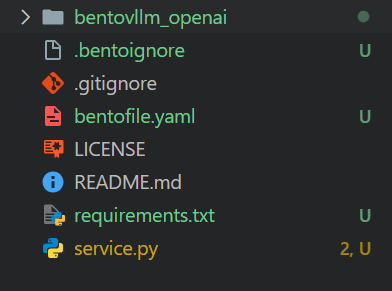
$ pip install -r requirements.txtBeginilah tampilan direktori proyek dengan semua berkasnya:
2. Memodifikasi bentofile.yaml
Kita akan memodifikasi bentofile.yaml untuk mengubah nama pemilik dan tahap.
File bentofile.yaml lebih sederhana dibanding Dockerfile dan menggunakan perintah berbeda untuk menyiapkan infrastrukturstruktur, lingkungan, dan konfigurasi server; Anda dapat mempelajari semua perintah dari opsi build Bento.
service: 'service:VLLM'
labels:
owner: Abid
stage: Guide
include:
- '*.py'
- 'bentovllm_openai/*.py'
python:
requirements_txt: './requirements.txt'
lock_packages: false
docker:
python_version: "3.11"3. Memahami berkas service.py
Kita tidak akan mengubah file service.py, melainkan mempelajarinya.
- Kodenya membuat server yang dapat menerima pertanyaan atau prompt dari pengguna dan menghasilkan respons menggunakan model AI pralatih (Phi-3-mini-4k-instruct).
- Menggunakan
@bentoml.serviceuntuk menangani deployment dan manajemen sumber daya, seperti penyiapan GPU dan manajemen lalu lintas. - API
generatedidefinisikan menggunakan dekorator@bentoml.api. API ini menerima prompt pengguna, sistem prompt opsional, dan batas token maksimum sebagai masukan, yang kemudian diberikan ke mesin inferensi vLLM untuk menghasilkan respons. - Metode
generatemelakukan streaming keluaran model dalam potongan, menghasilkan token segera setelah tersedia.
import uuid
from typing import AsyncGenerator, Optional
import bentoml
from annotated_types import Ge, Le
from typing_extensions import Annotated
from bentovllm_openai.utils import openai_endpoints
MAX_TOKENS = 1024
PROMPT_TEMPLATE = """<|system|>
{system_prompt}<|end|>
<|user|>
{user_prompt}<|end|>
<|assistant|>
"""
SYSTEM_PROMPT = """You are a helpful, respectful and honest assistant. Always answer as helpfully as possible, while being safe. Your answers should not include any harmful, unethical, racist, sexist, toxic, dangerous, or illegal content. Please ensure that your responses are socially unbiased and positive in nature.
If a question does not make any sense, or is not factually coherent, explain why instead of answering something not correct. If you don't know the answer to a question, please don't share false information."""
MODEL_ID = "microsoft/Phi-3-mini-4k-instruct"
@openai_endpoints(model_id=MODEL_ID)
@bentoml.service(
name="bentovllm-phi-3-mini-4k-instruct-service",
traffic={
"timeout": 300,
"concurrency": 256, # Matches the default max_num_seqs in the VLLM engine
},
resources={
"gpu": 1,
"gpu_type": "nvidia-tesla-t4",
},
)
class VLLM:
def __init__(self) -> None:
from transformers import AutoTokenizer
from vllm import AsyncEngineArgs, AsyncLLMEngine
ENGINE_ARGS = AsyncEngineArgs(
model=MODEL_ID,
max_model_len=MAX_TOKENS,
dtype="half",
enable_prefix_caching=True,
disable_sliding_window=True,
)
self.engine = AsyncLLMEngine.from_engine_args(ENGINE_ARGS)
self.tokenizer = AutoTokenizer.from_pretrained(MODEL_ID)
@bentoml.api
async def generate(
self,
prompt: str = "Explain superconductors in plain English",
system_prompt: Optional[str] = SYSTEM_PROMPT,
max_tokens: Annotated[int, Ge(128), Le(MAX_TOKENS)] = MAX_TOKENS,
) -> AsyncGenerator[str, None]:
from vllm import SamplingParams
SAMPLING_PARAM = SamplingParams(max_tokens=max_tokens)
if system_prompt is None:
system_prompt = SYSTEM_PROMPT
prompt = PROMPT_TEMPLATE.format(user_prompt=prompt, system_prompt=system_prompt)
stream = await self.engine.add_request(uuid.uuid4().hex, prompt, SAMPLING_PARAM)
cursor = 0
async for request_output in stream:
text = request_output.outputs[0].text
yield text[cursor:]
cursor = len(text)Saya merekomendasikan mengikuti skill track Developing AI Applications untuk mempelajari cara membuat aplikasi bertenaga AI dengan alat developer AI terbaru, termasuk OpenAI API, Hugging Face, dan LangChain.
4. Menyiapkan untuk BentoCloud
Buka bentofile.yaml dan tambahkan variabel lingkungan untuk token Hugging Face pada baris terakhir. Ini akan membantu kita memuat model dengan aman tanpa masalah dari server Hugging Face:
envs:
- name: HF_TOKENMasuk ke BentoCloud menggunakan CLI:
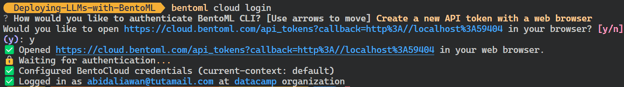
$ bentoml cloud loginAnda akan diminta membuat akun dan kemudian diminta membuat token API.
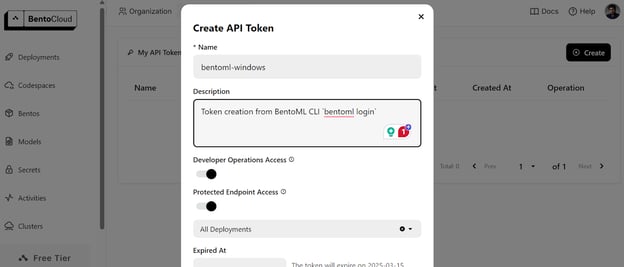
Setelah berhasil membuat token API, Anda akan melihat pesan sukses di terminal:
5. Mendeploy di BentoCloud
Sebelum mendeploy layanan AI di BentoCloud, kita perlu membuat variabel lingkungan di BentoCloud dengan membuka tab "Secrets" dan memberikan nama kunci serta kunci API Hugging Face.
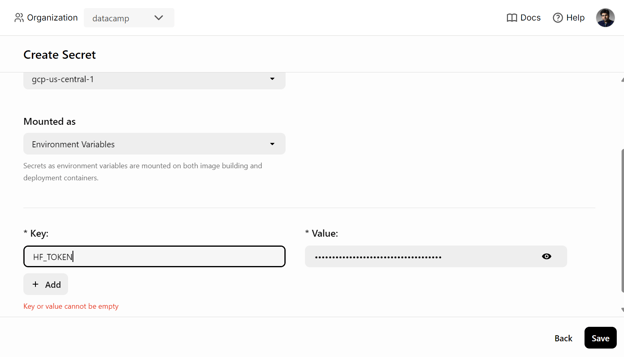
Setelah itu, gunakan perintah berikut untuk mendeploy layanan AI:
$ bentoml deploy . --secret huggingfaceProses ini akan memakan waktu beberapa menit untuk mengunduh model dan menyiapkan lingkungan agar server dapat berjalan.
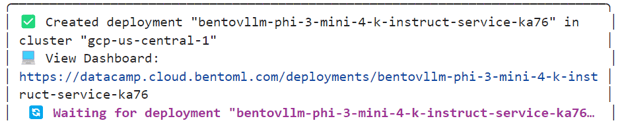
Anda dapat memeriksa status layanan AI Anda dengan membuka tab “Deployments”.
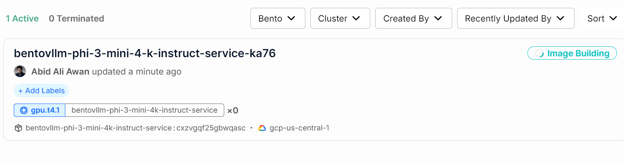
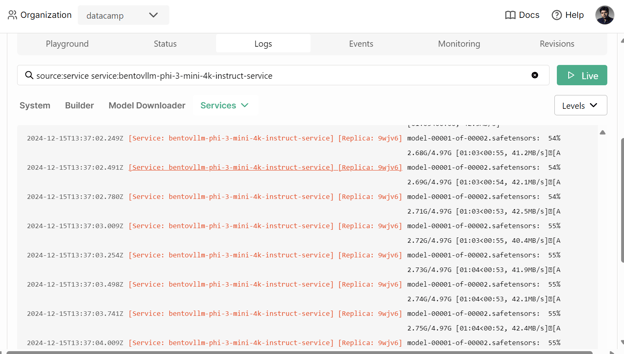
Anda juga dapat memeriksa semua log dan mengamati apa yang terjadi di latar belakang.
6. Mengakses layanan AI yang dideploy
Setelah layanan AI berhasil dideploy, kita akan mulai menguji layanan vLLM Phi 3 Mini.
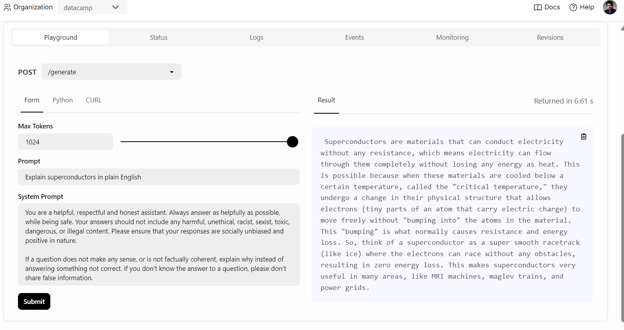
Untuk memulai, kita cukup mengeklik tab “Playground” di bawah opsi “Deployments”, masukkan prompt, dan klik tombol “submit” untuk menghasilkan respons. Respons akan di-stream secara real time.
 Kita juga dapat menggunakan klien Python BentoML untuk mengakses model yang dideploy dan menghasilkan respons. Ini akan membantu Anda mengintegrasikan layanan AI ke dalam aplikasi Anda:
import bentoml
with bentoml.SyncHTTPClient(
"https://bentovllm-phi-3-mini-4-k-instruct-service-ka76-39800880.mt-guc1.bentoml.ai"
) as client:
response = client.generate(
prompt="What is the largest lake in the world?"
)
for chunk in response:
print(chunk, end="", flush=True)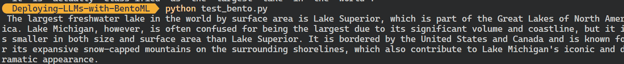
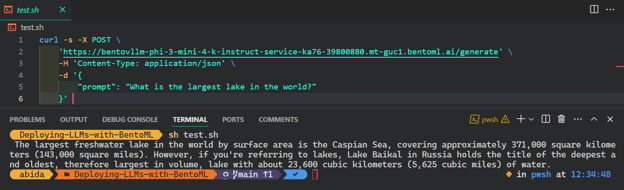
Cara paling populer dan termudah untuk mengakses layanan AI dari sistem operasi apa pun adalah menggunakan perintah CURL di terminal:
$ curl -s -X POST \
'https://bentovllm-phi-3-mini-4-k-instruct-service-ka76-39800880.mt-guc1.bentoml.ai/generate' \
-H 'Content-Type: application/json' \
-d '{
"prompt": "What is the largest lake in the world?"
}' 
7. Observabilitas
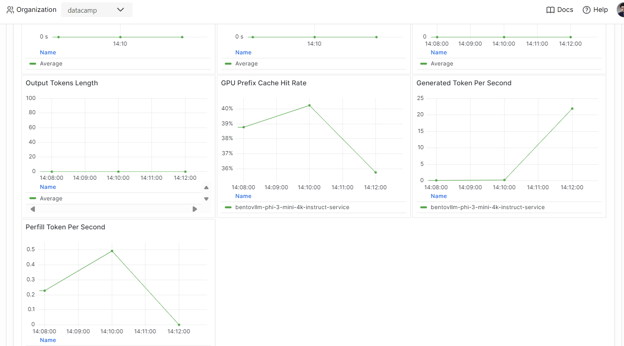
Buka tab "Monitoring" dan tinjau semua statistik terkait LLM, permintaan pengguna, perangkat keras, dan analitik pemantauan lainnya yang akan membantu Anda menilai kinerja server AI.
Anda juga dapat memeriksa tab "Logs" atau menggunakan CLI BentoML untuk menghasilkan log real time.
Penyajian dan deployment model adalah satu bagian dari pipeline MLOps. Dengan menyelesaikan kursus Fully Automated MLOps, Anda dapat mempelajari cara membangun arsitektur MLOps, teknik CI/CD/CM/CT, dan pola otomasi untuk mendeploy sistem ML yang dapat memberikan nilai secara berkelanjutan.
Kesimpulan
Jika Anda ingin mempelajari lebih lanjut tentang ekosistem BentoML, pendekatan terbaik adalah mulai membangun dan mendeploy layanan AI Anda. Anda menerima kredit gratis, sehingga dapat menggunakan GPU dan CPU untuk mengeksplor berbagai layanan. Ini bisa mencakup aplikasi Retrieval-Augmented Generation (RAG), function calling, Agentic LLM, atau aplikasi multimodal yang memproses gambar dan teks untuk menghasilkan respons.
Dalam tutorial praktik ini, kita mempelajari tentang BentoML dan cara menyajikan aplikasi AI apa pun secara lokal hanya dengan beberapa baris kode. Selanjutnya kita menggunakan mesin inferensi vLLM untuk membangun layanan BentoML dan mendeploynya di BentoCloud dengan beberapa langkah sederhana.
Pertimbangkan untuk mengikuti career track Associate AI Engineer for Developers untuk mempelajari cara mengintegrasikan AI ke dalam aplikasi perangkat lunak menggunakan API dan pustaka open-source.

Sebagai data scientist tersertifikasi, saya bersemangat memanfaatkan teknologi mutakhir untuk menciptakan aplikasi machine learning yang inovatif. Dengan latar belakang kuat di pengenalan ucapan, analisis dan pelaporan data, MLOps, conversational AI, dan NLP, saya mengasah keterampilan dalam mengembangkan sistem cerdas yang berdampak nyata. Selain keahlian teknis, saya juga komunikator andal yang mampu menyederhanakan konsep kompleks menjadi bahasa yang jelas dan ringkas. Karena itu, saya menjadi blogger yang dicari di bidang data science, membagikan wawasan dan pengalaman kepada komunitas profesional data yang terus berkembang. Saat ini, saya berfokus pada pembuatan dan penyuntingan konten, bekerja dengan large language model untuk mengembangkan konten yang kuat dan menarik agar membantu bisnis dan individu memaksimalkan data mereka.





Banyak data scientist dan machine learning engineer kesulitan dengan alat seperti Docker, Kubernetes, dan Terraform, serta membangun infrastruktur yang aman untuk model AI.
BentoML menyederhanakan proses ini, memungkinkan Anda membangun, menyajikan, dan mendeploy aplikasi AI hanya dengan beberapa baris kode Python.
Tutorial ini adalah panduan langkah demi langkah bagi siapa pun yang ingin mendeploy aplikasi AI mereka sendiri, yang dapat diakses dari mana saja melalui perintah CURL sederhana. Anda akan mempelajari kerangka kerja BentoML, membuat aplikasi AI tanya jawab secara lokal, dan mendeploy model Phi 3 mini di BentoCloud.
Apa itu BentoML?
BentoML adalah kerangka kerja penyajian dan deployment machine learning yang merampingkan proses deploy dan skala model AI. Ia mengotomatiskan tugas seperti pembuatan image Docker, penyiapan instance, manajemen infrastruktur dan keamanan, serta fitur-fitur esensial yang dibutuhkan untuk server siap produksi.
Dengan BentoML, Anda dapat mengembangkan dan mendeploy model AI kustom, model pralatih, atau solusi fine-tuned dalam hitungan menit dengan kode Python sederhana. Ini memberikan fleksibilitas untuk melakukan skala secara efisien di lingkungan cloud Anda sambil memastikan Anda tetap memegang kendali penuh atas keamanan dan kepatuhan.
BentoML merupakan bagian dari perangkat MLOps. Temukan alat MLOps kelas atas lainnya untuk pelatihan, pelacakan, deployment, orkestrasi, pengujian, pemantauan, dan manajemen infrastruktur dengan membaca blog 15 Alat LLMOps Teratas untuk Membangun Aplikasi AI pada 2024.
Cara kerja BentoML | Sumber gambar: BentoML
Bintang dalam ekosistem Bento adalah cloud-nya: BentoCloud merupakan perpanjangan dari kerangka kerja BentoML, menawarkan alat dan layanan tambahan untuk mempermudah deployment, pemantauan, dan penskalaan model AI.
Dengan mendaftar, pengguna dapat mengakses kredit gratis untuk memulai, menjadikannya opsi menarik bagi developer dan perusahaan.
Jika Anda bukan teknisi dan mencari solusi no-code hingga low-code untuk mengembangkan aplikasi LLM, saya sarankan mengikuti panduan Local AI dengan Docker, n8n, Qdrant, dan Ollama.