

Bắt đầu với BentoML
Trong phần này, chúng ta sẽ phục vụ một ứng dụng AI đơn giản nhận câu hỏi và ngữ cảnh từ người dùng rồi tạo ra câu trả lời.
Chúng ta sẽ bắt đầu bằng cách cài đặt BentoML, PyTorch và thư viện Transformers bằng pip. Chạy các lệnh sau trong terminal:
$ pip install bentoml
$ pip install torch
$ pip install transformersTiếp theo, chúng ta sẽ tạo tệp service.py để định nghĩa server AI.
Sử dụng các lệnh của BentoML, chúng ta sẽ import pipeline của Transformers, cho phép tải mô hình và suy luận chỉ với 2 dòng mã.
Chúng ta sẽ thiết lập ví dụ đầu vào văn bản và ngữ cảnh, cấu hình dịch vụ BentoML với các tham số như số CPU và thời gian chờ lưu lượng, và khởi tạo lớp Question_Answering bằng pipeline Transformers.
Cuối cùng, chúng ta sẽ tạo một API tên là generate(), nhận đầu vào và trả về câu trả lời đã tạo.
from __future__ import annotations
import bentoml
with bentoml.importing():
from transformers import pipeline
EXAMPLE_INPUT = "How can I generate a secure password?"
EXAMPLE_CONTEXT = """
To generate a secure password, you can use tools like the LastPass Password Generator.
These tools create strong, random passwords that help prevent security threats by ensuring your accounts are protected against hacking attempts.
A secure password typically includes a mix of uppercase and lowercase letters, numbers, and special characters. Avoid using easily guessable information like names or birthdays.
Using a password manager like LastPass can also help you store and manage these secure passwords effectively.
"""
@bentoml.service(
resources={"cpu": "4"},
traffic={"timeout": 10},
)
class Question_Answering:
def __init__(self) -> None:
# Load model into pipeline
self.pipe = pipeline(
"question-answering",
model="deepset/roberta-base-squad2",
)
@bentoml.api
def generate(
self,
text: str =EXAMPLE_INPUT,
doc: str = EXAMPLE_CONTEXT,
) -> str:
result = self.pipe(question=text, context=doc)
return result["answer"]Phục vụ dịch vụ AI cục bộ bằng cách gõ lệnh sau trong terminal:
$ bentoml serve service:Question_Answering Như bạn thấy, chúng ta đã cung cấp lệnh với tên tệp (service) và tên lớp Python (Question_Answering ) để suy luận mô hình AI.
Trong vài giây, nó sẽ tạo một URL mà bạn có thể sao chép và dán lên trình duyệt để truy cập server BentoML:
[cli] Starting production HTTP BentoServer from "app:Question_Answering" listening on http://localhost:3000 (Press CTRL+C to quit)Server BentoML khá giống với FastAPI swagger UI.
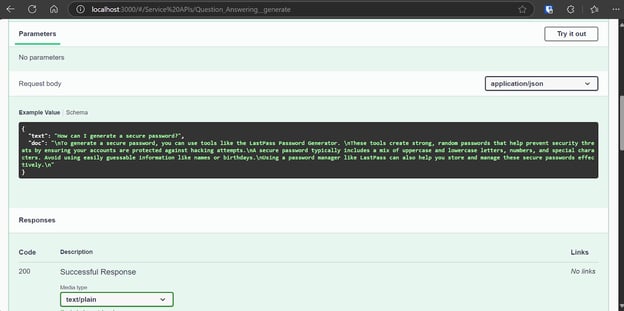
Hãy kiểm thử server bằng tùy chọn “Try it out”.
Dịch vụ AI của chúng ta hoạt động tốt và đã tạo ra câu trả lời chính xác:
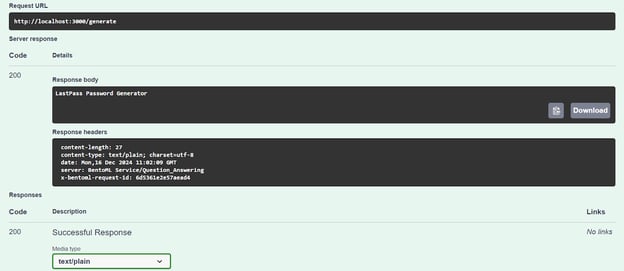
Chúng ta cũng có thể truy cập server AI bằng lệnh CURL. Hãy đặt một câu hỏi khác và cung cấp ngữ cảnh:
curl -X 'POST' \
'http://localhost:3000/generate' \
-H 'accept: text/plain' \
-H 'Content-Type: application/json' \
-d '{
"text": "How can I buy a cheap car?",
"doc": "Start by setting a budget and exploring sources like online marketplaces (Craigslist, Facebook Marketplace, Cars.com), local dealerships, or government auctions. Inspect the car thoroughly for issues like rust or mechanical problems, and consider bringing a trusted mechanic to avoid future repair costs. Research the reliability of specific brands and models using tools like Kelley Blue Book or Consumer Reports. Finally, negotiate the price to secure the best deal. Following these steps can help you find a dependable car within your budget."
}'Dịch vụ AI của chúng ta hoạt động trơn tru, và chỉ mất 1 giây để tạo phản hồi ngay cả trên CPU:
negotiate the priceTriển khai Phi 3 Mini 4k Instruct trên BentoCloud
Đã đến lúc xây dựng một ứng dụng AI với mô hình ngôn ngữ lớn (LLM) đúng nghĩa và triển khai nó trên BentoML với nỗ lực và tài nguyên tối thiểu.
Chúng ta sẽ dùng framework vLLM để tạo suy luận LLM thông lượng cao và triển khai trên một phiên bản GPU trên BentoCloud. Nghe có vẻ phức tạp, nhưng BentoCloud xử lý phần lớn công việc nặng nhọc, bao gồm thiết lập hạ tầng, để bạn có thể tập trung xây dựng và triển khai dịch vụ.
1. Nhân bản dự án vLLM của BentoML
BentoML cung cấp rất nhiều mã ví dụ và tài nguyên cho các dự án LLM khác nhau. Để bắt đầu, chúng ta sẽ clone repository BentoVLLM.
Đi tới dự án Phi 3 Mini 4k, và cài đặt tất cả thư viện Python cần thiết:
$ git clone https://github.com/bentoml/BentoVLLM.git
$ cd BentoVLLM/phi-3-mini-4k-instruct
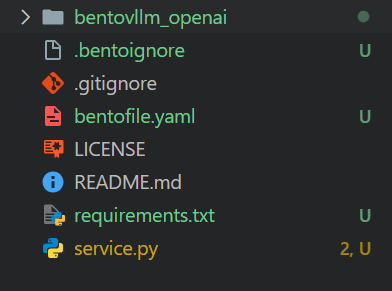
$ pip install -r requirements.txtCấu trúc thư mục dự án sẽ trông như thế này với đầy đủ các tệp:
2. Sửa đổi bentofile.yaml
Chúng ta sẽ chỉnh sửa bentofile.yaml để thay đổi tên owner và stage.
bentofile.yaml đơn giản hơn Dockerfile và sử dụng các lệnh khác nhau để thiết lập hạ tầng cấu hình môi trường và server; bạn có thể học tất cả lệnh từ tùy chọn build của Bento.
service: 'service:VLLM'
labels:
owner: Abid
stage: Guide
include:
- '*.py'
- 'bentovllm_openai/*.py'
python:
requirements_txt: './requirements.txt'
lock_packages: false
docker:
python_version: "3.11"3. Tìm hiểu tệp service.py
Chúng ta sẽ không thay đổi tệp service.py, thay vào đó sẽ tìm hiểu về nó.
- Mã tạo một server có thể nhận câu hỏi hoặc prompt từ người dùng và tạo phản hồi bằng mô hình AI tiền huấn luyện (Phi-3-mini-4k-instruct).
- Nó dùng
@bentoml.serviceđể xử lý triển khai và quản lý tài nguyên, như thiết lập GPU và quản lý lưu lượng. - API
generateđược định nghĩa bằng decorator@bentoml.api. Nó nhận prompt của người dùng, một system prompt tùy chọn và giới hạn token tối đa làm đầu vào, sau đó truyền tới engine suy luận vLLM để tạo phản hồi. - Phương thức
generatestream đầu ra của mô hình theo từng phần, tạo token ngay khi có sẵn.
import uuid
from typing import AsyncGenerator, Optional
import bentoml
from annotated_types import Ge, Le
from typing_extensions import Annotated
from bentovllm_openai.utils import openai_endpoints
MAX_TOKENS = 1024
PROMPT_TEMPLATE = """<|system|>
{system_prompt}<|end|>
<|user|>
{user_prompt}<|end|>
<|assistant|>
"""
SYSTEM_PROMPT = """You are a helpful, respectful and honest assistant. Always answer as helpfully as possible, while being safe. Your answers should not include any harmful, unethical, racist, sexist, toxic, dangerous, or illegal content. Please ensure that your responses are socially unbiased and positive in nature.
If a question does not make any sense, or is not factually coherent, explain why instead of answering something not correct. If you don't know the answer to a question, please don't share false information."""
MODEL_ID = "microsoft/Phi-3-mini-4k-instruct"
@openai_endpoints(model_id=MODEL_ID)
@bentoml.service(
name="bentovllm-phi-3-mini-4k-instruct-service",
traffic={
"timeout": 300,
"concurrency": 256, # Matches the default max_num_seqs in the VLLM engine
},
resources={
"gpu": 1,
"gpu_type": "nvidia-tesla-t4",
},
)
class VLLM:
def __init__(self) -> None:
from transformers import AutoTokenizer
from vllm import AsyncEngineArgs, AsyncLLMEngine
ENGINE_ARGS = AsyncEngineArgs(
model=MODEL_ID,
max_model_len=MAX_TOKENS,
dtype="half",
enable_prefix_caching=True,
disable_sliding_window=True,
)
self.engine = AsyncLLMEngine.from_engine_args(ENGINE_ARGS)
self.tokenizer = AutoTokenizer.from_pretrained(MODEL_ID)
@bentoml.api
async def generate(
self,
prompt: str = "Explain superconductors in plain English",
system_prompt: Optional[str] = SYSTEM_PROMPT,
max_tokens: Annotated[int, Ge(128), Le(MAX_TOKENS)] = MAX_TOKENS,
) -> AsyncGenerator[str, None]:
from vllm import SamplingParams
SAMPLING_PARAM = SamplingParams(max_tokens=max_tokens)
if system_prompt is None:
system_prompt = SYSTEM_PROMPT
prompt = PROMPT_TEMPLATE.format(user_prompt=prompt, system_prompt=system_prompt)
stream = await self.engine.add_request(uuid.uuid4().hex, prompt, SAMPLING_PARAM)
cursor = 0
async for request_output in stream:
text = request_output.outputs[0].text
yield text[cursor:]
cursor = len(text)Tôi khuyến nghị theo học lộ trình kỹ năng Developing AI Applications để học cách tạo ứng dụng tích hợp AI với các công cụ nhà phát triển mới nhất, bao gồm OpenAI API, Hugging Face và LangChain.
4. Thiết lập cho BentoCloud
Vào bentofile.yaml và thêm biến môi trường cho token Hugging Face ở dòng cuối. Điều này sẽ giúp chúng ta tải mô hình một cách an toàn mà không gặp sự cố từ máy chủ Hugging Face:
envs:
- name: HF_TOKENĐăng nhập vào BentoCloud bằng CLI:
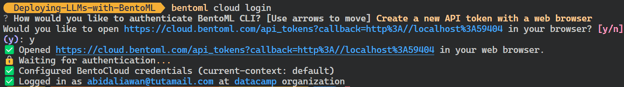
$ bentoml cloud loginCông cụ sẽ yêu cầu bạn tạo tài khoản rồi tạo API token.
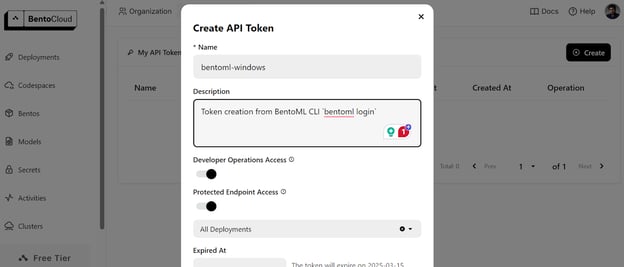
Sau khi tạo API token thành công, bạn sẽ thấy thông báo thành công trong terminal:
5. Triển khai trên BentoCloud
Trước khi triển khai dịch vụ AI lên BentoCloud, chúng ta cần tạo một biến môi trường trong BentoCloud bằng cách vào tab "Secrets" và cung cấp tên khóa cùng khóa API của Hugging Face.
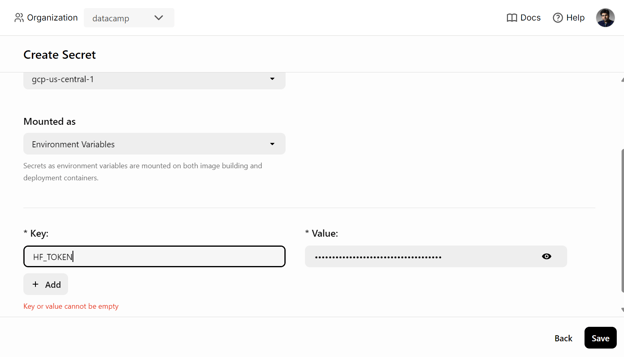
Sau đó, dùng lệnh sau để triển khai dịch vụ AI:
$ bentoml deploy . --secret huggingfaceSẽ mất vài phút để tải mô hình và thiết lập môi trường chạy server.
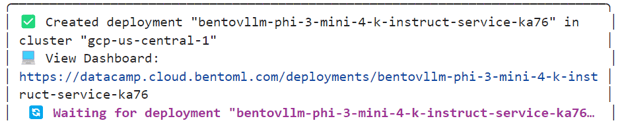
Bạn có thể kiểm tra trạng thái dịch vụ AI của mình bằng cách vào tab “Deployments”.
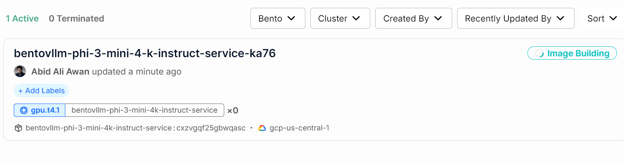
Bạn cũng có thể kiểm tra toàn bộ log và quan sát những gì diễn ra ở hậu trường.
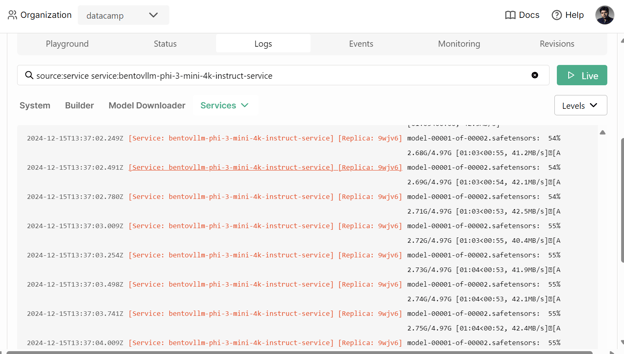
6. Truy cập dịch vụ AI đã triển khai
Khi dịch vụ AI được triển khai thành công, chúng ta sẽ bắt đầu kiểm thử dịch vụ vLLM Phi 3 Mini.
Để bắt đầu, bạn có thể đơn giản nhấp vào tab “Playground” dưới mục “Deployments”, nhập prompt, rồi bấm nút “submit” để tạo phản hồi. Phản hồi sẽ được stream theo thời gian thực.
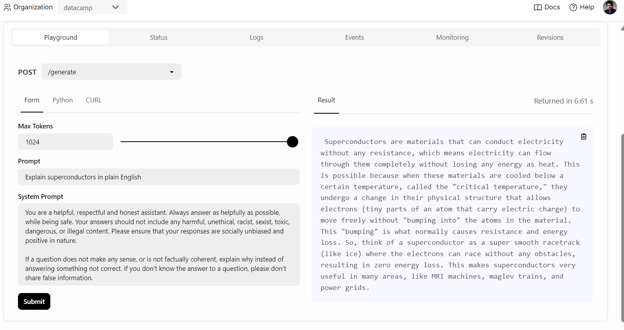 Chúng ta cũng có thể dùng client Python của BentoML để truy cập mô hình đã triển khai và tạo phản hồi. Cách này giúp bạn tích hợp dịch vụ AI vào ứng dụng của mình:
import bentoml
with bentoml.SyncHTTPClient(
"https://bentovllm-phi-3-mini-4-k-instruct-service-ka76-39800880.mt-guc1.bentoml.ai"
) as client:
response = client.generate(
prompt="What is the largest lake in the world?"
)
for chunk in response:
print(chunk, end="", flush=True)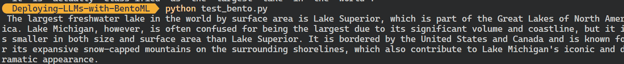
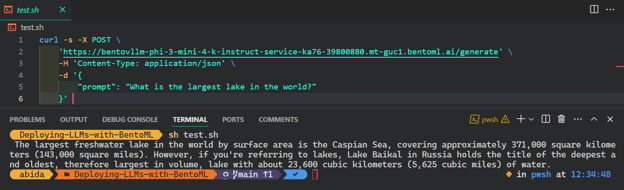
Cách phổ biến và đơn giản nhất để truy cập dịch vụ AI từ bất kỳ hệ điều hành nào là dùng lệnh CURL trong terminal:
$ curl -s -X POST \
'https://bentovllm-phi-3-mini-4-k-instruct-service-ka76-39800880.mt-guc1.bentoml.ai/generate' \
-H 'Content-Type: application/json' \
-d '{
"prompt": "What is the largest lake in the world?"
}' 
7. Quan sát (Observability)
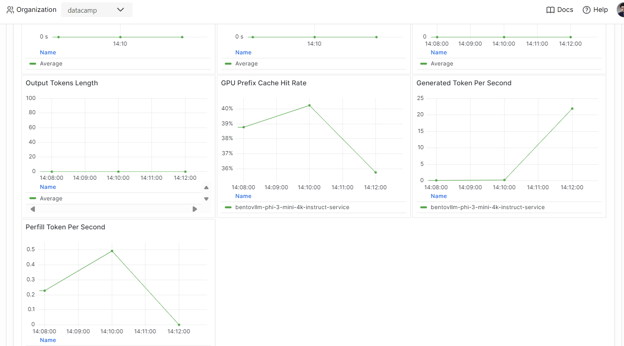
Vào tab "Monitoring" và xem toàn bộ thống kê liên quan tới LLM, yêu cầu người dùng, phần cứng và các phân tích giám sát khác giúp bạn đánh giá hiệu năng của server AI.
Bạn cũng có thể kiểm tra tab "Logs" hoặc dùng BentoML CLI để tạo log theo thời gian thực.
Phục vụ và triển khai mô hình chỉ là một phần của pipeline MLOps. Bằng cách hoàn thành khóa học Fully Automated MLOps, bạn có thể học cách xây dựng kiến trúc MLOps, kỹ thuật CI/CD/CM/CT và các mẫu tự động hóa để triển khai hệ thống ML có thể tạo ra giá trị lâu dài.
Kết luận
Nếu bạn muốn tìm hiểu thêm về hệ sinh thái BentoML, cách tốt nhất là bắt tay xây dựng và triển khai dịch vụ AI của riêng bạn. Bạn nhận được tín dụng miễn phí, cho phép dùng GPU và CPU để khám phá nhiều dịch vụ. Điều này có thể bao gồm ứng dụng Retrieval-Augmented Generation (RAG), function calling, Agentic LLMs hoặc ứng dụng đa phương thức xử lý hình ảnh và văn bản để tạo phản hồi.
Trong hướng dẫn thực hành này, chúng ta đã tìm hiểu về BentoML và cách phục vụ bất kỳ ứng dụng AI nào cục bộ chỉ với vài dòng mã. Sau đó, chúng ta dùng engine suy luận vLLM để xây dựng một dịch vụ BentoML và triển khai nó lên BentoCloud chỉ với vài bước đơn giản.
Hãy cân nhắc theo học lộ trình nghề nghiệp Associate AI Engineer for Developers để học cách tích hợp AI vào ứng dụng phần mềm bằng API và thư viện mã nguồn mở.

Là một nhà khoa học dữ liệu được chứng nhận, tôi đam mê tận dụng công nghệ tiên tiến để tạo ra các ứng dụng học máy đổi mới. Với nền tảng vững chắc về nhận dạng giọng nói, phân tích và báo cáo dữ liệu, MLOps, AI hội thoại và NLP, tôi đã rèn giũa kỹ năng phát triển các hệ thống thông minh có thể tạo ra tác động thực sự. Bên cạnh chuyên môn kỹ thuật, tôi cũng là một người truyền đạt tốt, có khả năng chắt lọc các khái niệm phức tạp thành ngôn ngữ rõ ràng, súc tích. Nhờ đó, tôi trở thành một blogger được nhiều người quan tâm trong lĩnh vực khoa học dữ liệu, chia sẻ góc nhìn và kinh nghiệm với cộng đồng các chuyên gia dữ liệu ngày càng lớn. Hiện tại, tôi tập trung vào sáng tạo và biên tập nội dung, làm việc với các mô hình ngôn ngữ lớn để phát triển nội dung mạnh mẽ và hấp dẫn, giúp doanh nghiệp và cá nhân tận dụng tối đa dữ liệu của mình.


Nhiều nhà khoa học dữ liệu và kỹ sư machine learning gặp khó khăn với các công cụ như Docker, Kubernetes và Terraform, cũng như trong việc xây dựng hạ tầng an toàn cho mô hình AI.
BentoML đơn giản hóa quy trình này, cho phép bạn xây dựng, phục vụ và triển khai ứng dụng AI chỉ với vài dòng mã Python.
Hướng dẫn này cung cấp lộ trình từng bước dành cho những ai muốn tự triển khai ứng dụng AI của mình, có thể truy cập ở mọi nơi qua một lệnh CURL đơn giản. Bạn sẽ tìm hiểu về framework BentoML, tạo ứng dụng AI hỏi–đáp chạy cục bộ và triển khai mô hình Phi 3 mini trên BentoCloud.
BentoML là gì?
BentoML là một framework phục vụ và triển khai machine learning giúp tinh gọn việc triển khai và mở rộng mô hình AI. Nó tự động hóa các tác vụ như tạo Docker image, thiết lập instance, quản lý hạ tầng và bảo mật, cùng những tính năng thiết yếu để có một server sẵn sàng cho sản xuất.
Với BentoML, bạn có thể phát triển và triển khai mô hình AI tùy chỉnh, mô hình tiền huấn luyện hoặc các giải pháp fine-tune trong vài phút với mã Python đơn giản. Nó cung cấp sự linh hoạt để mở rộng hiệu quả trong môi trường đám mây của bạn đồng thời đảm bảo bạn duy trì toàn quyền kiểm soát bảo mật và tuân thủ.
BentoML là một phần của bộ công cụ MLOps. Khám phá các công cụ MLOps hàng đầu khác cho việc huấn luyện, theo dõi, triển khai, điều phối, kiểm thử, giám sát và quản lý hạ tầng bằng cách đọc blog Top 15 công cụ LLMOps để xây dựng ứng dụng AI năm 2024.
BentoML hoạt động như thế nào | Nguồn ảnh: BentoML
Ngôi sao của hệ sinh thái Bento là nền tảng đám mây: BentoCloud là phần mở rộng của framework BentoML, cung cấp thêm công cụ và dịch vụ giúp việc triển khai, giám sát và mở rộng mô hình AI trở nên dễ dàng hơn nữa.
Khi đăng ký, người dùng có thể nhận tín dụng miễn phí để bắt đầu, khiến đây trở thành lựa chọn hấp dẫn cho nhà phát triển và doanh nghiệp.
Nếu bạn không thiên về kỹ thuật và đang tìm giải pháp no-code/low-code để phát triển ứng dụng LLM, tôi khuyến nghị làm theo hướng dẫn Local AI với Docker, n8n, Qdrant và Ollama.