

Aan de slag met BentoML
In deze sectie serven we een eenvoudige AI‑applicatie die vragen en context van de gebruiker neemt en een antwoord genereert.
We beginnen met het installeren van BentoML, PyTorch en de Transformers‑bibliotheek met pip. Voer de volgende commando’s uit in je terminal:
$ pip install bentoml
$ pip install torch
$ pip install transformersVervolgens maken we een service.py-bestand om de AI‑server te definiëren.
Met BentoML‑commando’s importeren we de Transformers‑pipeline, waarmee we het model kunnen laden en inference kunnen doen met slechts 2 regels code.
We stellen voorbeeld‑tekstinputs en context in, configureren de BentoML‑service met parameters zoals het aantal CPU’s en traffic‑timeout, en initialiseren de Question_Answering-klasse met de Transformers‑pipeline.
Tot slot maken we een API genaamd generate(), die inputs en outputs aanneemt en het gegenereerde antwoord teruggeeft.
from __future__ import annotations
import bentoml
with bentoml.importing():
from transformers import pipeline
EXAMPLE_INPUT = "How can I generate a secure password?"
EXAMPLE_CONTEXT = """
To generate a secure password, you can use tools like the LastPass Password Generator.
These tools create strong, random passwords that help prevent security threats by ensuring your accounts are protected against hacking attempts.
A secure password typically includes a mix of uppercase and lowercase letters, numbers, and special characters. Avoid using easily guessable information like names or birthdays.
Using a password manager like LastPass can also help you store and manage these secure passwords effectively.
"""
@bentoml.service(
resources={"cpu": "4"},
traffic={"timeout": 10},
)
class Question_Answering:
def __init__(self) -> None:
# Load model into pipeline
self.pipe = pipeline(
"question-answering",
model="deepset/roberta-base-squad2",
)
@bentoml.api
def generate(
self,
text: str =EXAMPLE_INPUT,
doc: str = EXAMPLE_CONTEXT,
) -> str:
result = self.pipe(question=text, context=doc)
return result["answer"]Serve de AI‑service lokaal door het volgende commando in de terminal te typen:
$ bentoml serve service:Question_Answering Zoals je ziet, hebben we hierboven de bestandsnaam (service) en de Python‑klasse (Question_Answering ) meegegeven voor AI‑modelinference.
Binnen enkele seconden verschijnt er een URL die je kunt kopiëren en plakken in de browser om de BentoML‑server te openen:
[cli] Starting production HTTP BentoServer from "app:Question_Answering" listening on http://localhost:3000 (Press CTRL+C to quit)De BentoML‑server lijkt sterk op de FastAPI Swagger UI.
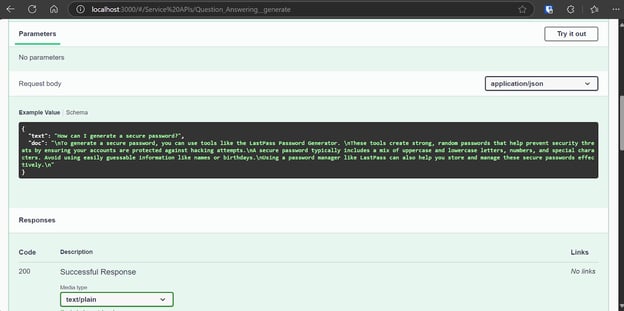
Laten we onze server testen met de optie “Try it out”.
Onze AI‑service werkt prima en heeft een nauwkeurig antwoord gegenereerd:
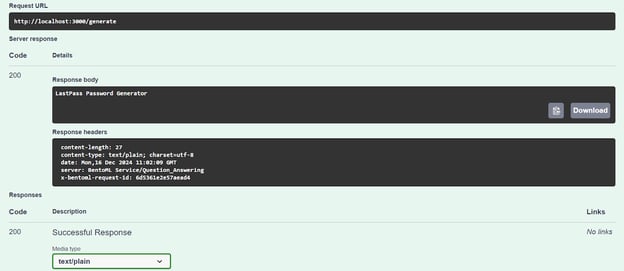
We kunnen de AI‑server ook benaderen met het CURL-commando. Laten we een andere vraag stellen en er context bij geven:
curl -X 'POST' \
'http://localhost:3000/generate' \
-H 'accept: text/plain' \
-H 'Content-Type: application/json' \
-d '{
"text": "How can I buy a cheap car?",
"doc": "Start by setting a budget and exploring sources like online marketplaces (Craigslist, Facebook Marketplace, Cars.com), local dealerships, or government auctions. Inspect the car thoroughly for issues like rust or mechanical problems, and consider bringing a trusted mechanic to avoid future repair costs. Research the reliability of specific brands and models using tools like Kelley Blue Book or Consumer Reports. Finally, negotiate the price to secure the best deal. Following these steps can help you find a dependable car within your budget."
}'Onze AI‑service draait soepel en had 1 seconde nodig om een antwoord te genereren, zelfs op de CPU:
negotiate the pricePhi 3 Mini 4k Instruct deployen op BentoCloud
Tijd om een volwaardige LLM‑toepassing te bouwen en deze met minimale moeite en resources op BentoML te deployen.
We gebruiken het vLLM-framework om een high‑throughput LLM‑inference te maken en te deployen op een GPU‑instance op BentoCloud. Hoewel dit complex kan klinken, neemt BentoCloud het meeste zware werk over, inclusief het opzetten van de infrastructuur, zodat jij je kunt richten op het bouwen en deployen van je service.
1. De BentoML vLLM‑projectrepo clonen
BentoML biedt volop voorbeeldcode en resources voor uiteenlopende LLM‑projecten. We klonen om te beginnen de BentoVLLM‑repository.
Ga naar het Phi 3 Mini 4k‑project en installeer alle vereiste Python‑bibliotheken:
$ git clone https://github.com/bentoml/BentoVLLM.git
$ cd BentoVLLM/phi-3-mini-4k-instruct
$ pip install -r requirements.txtZo ziet de projectmap eruit met alle bestanden:
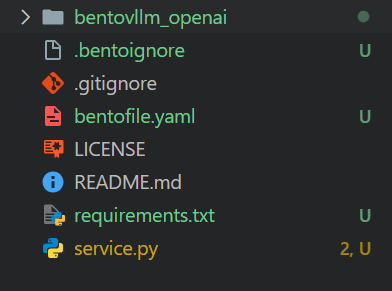
2. De bentofile.yaml aanpassen
We passen de bentofile.yaml aan om de eigenaar- en stagenamen te wijzigen.
De bentofile.yaml is eenvoudiger dan een Dockerfile en gebruikt andere commando’s voor het inrichten van infrastructuur, omgeving en serverconfiguraties; je vindt alle commando’s bij de Bento build‑opties.
service: 'service:VLLM'
labels:
owner: Abid
stage: Guide
include:
- '*.py'
- 'bentovllm_openai/*.py'
python:
requirements_txt: './requirements.txt'
lock_packages: false
docker:
python_version: "3.11"3. De service.py-file begrijpen
We gaan de service.py-file niet wijzigen, maar juist begrijpen.
- De code maakt een server die een vraag of prompt van een gebruiker kan aannemen en een antwoord genereert met een pre‑trained AI‑model (Phi‑3‑mini‑4k‑instruct).
- Hij gebruikt
@bentoml.servicevoor deployment en resourcemanagement, zoals het instellen van GPU’s en het beheren van verkeer. - De
generate-API is gedefinieerd met de@bentoml.api-decorator. Deze neemt een gebruikersprompt, een optionele system prompt en een maximum tokenlimiet als input, die vervolgens aan de vLLM‑inference‑engine worden doorgegeven om het antwoord te genereren. - De
generate-methode streamt de output van het model in stukjes en genereert tokens zodra ze beschikbaar zijn.
import uuid
from typing import AsyncGenerator, Optional
import bentoml
from annotated_types import Ge, Le
from typing_extensions import Annotated
from bentovllm_openai.utils import openai_endpoints
MAX_TOKENS = 1024
PROMPT_TEMPLATE = """<|system|>
{system_prompt}<|end|>
<|user|>
{user_prompt}<|end|>
<|assistant|>
"""
SYSTEM_PROMPT = """You are a helpful, respectful and honest assistant. Always answer as helpfully as possible, while being safe. Your answers should not include any harmful, unethical, racist, sexist, toxic, dangerous, or illegal content. Please ensure that your responses are socially unbiased and positive in nature.
If a question does not make any sense, or is not factually coherent, explain why instead of answering something not correct. If you don't know the answer to a question, please don't share false information."""
MODEL_ID = "microsoft/Phi-3-mini-4k-instruct"
@openai_endpoints(model_id=MODEL_ID)
@bentoml.service(
name="bentovllm-phi-3-mini-4k-instruct-service",
traffic={
"timeout": 300,
"concurrency": 256, # Matches the default max_num_seqs in the VLLM engine
},
resources={
"gpu": 1,
"gpu_type": "nvidia-tesla-t4",
},
)
class VLLM:
def __init__(self) -> None:
from transformers import AutoTokenizer
from vllm import AsyncEngineArgs, AsyncLLMEngine
ENGINE_ARGS = AsyncEngineArgs(
model=MODEL_ID,
max_model_len=MAX_TOKENS,
dtype="half",
enable_prefix_caching=True,
disable_sliding_window=True,
)
self.engine = AsyncLLMEngine.from_engine_args(ENGINE_ARGS)
self.tokenizer = AutoTokenizer.from_pretrained(MODEL_ID)
@bentoml.api
async def generate(
self,
prompt: str = "Explain superconductors in plain English",
system_prompt: Optional[str] = SYSTEM_PROMPT,
max_tokens: Annotated[int, Ge(128), Le(MAX_TOKENS)] = MAX_TOKENS,
) -> AsyncGenerator[str, None]:
from vllm import SamplingParams
SAMPLING_PARAM = SamplingParams(max_tokens=max_tokens)
if system_prompt is None:
system_prompt = SYSTEM_PROMPT
prompt = PROMPT_TEMPLATE.format(user_prompt=prompt, system_prompt=system_prompt)
stream = await self.engine.add_request(uuid.uuid4().hex, prompt, SAMPLING_PARAM)
cursor = 0
async for request_output in stream:
text = request_output.outputs[0].text
yield text[cursor:]
cursor = len(text)Ik raad de skill track Developing AI Applications aan om te leren hoe je AI‑gedreven applicaties bouwt met de nieuwste AI‑developertools, waaronder de OpenAI API, Hugging Face en LangChain.
4. Voorbereiden voor BentoCloud
Ga naar de bentofile.yaml en voeg op de laatste regel de omgevingsvariabele voor de Hugging Face‑token toe. Zo laden we het model veilig zonder problemen vanuit de Hugging Face‑server:
envs:
- name: HF_TOKENLog in bij BentoCloud via de CLI:
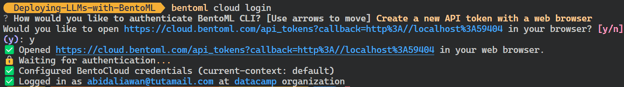
$ bentoml cloud loginJe wordt gevraagd een account aan te maken en vervolgens een API‑token te genereren.
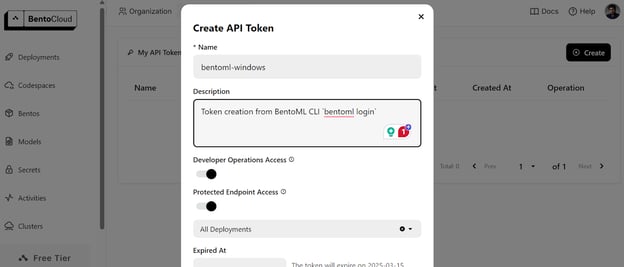
Na het succesvol aanmaken van het API‑token zie je in je terminal een succesmelding:
5. Deployen op BentoCloud
Voordat we de AI‑service op BentoCloud deployen, moeten we in BentoCloud een omgevingsvariabele aanmaken door naar het tabblad "Secrets" te gaan en de sleutelnaam en de Hugging Face API‑key op te geven.
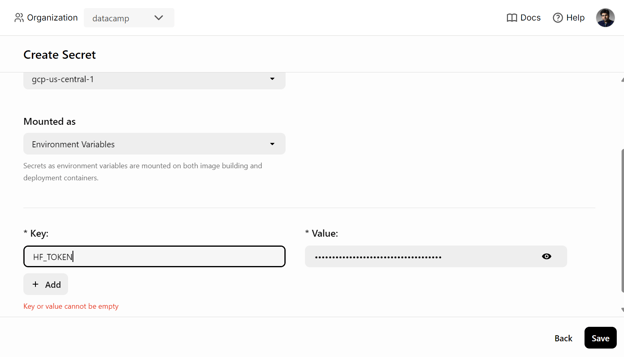
Gebruik daarna het volgende commando om de AI‑service te deployen:
$ bentoml deploy . --secret huggingfaceHet duurt een paar minuten om het model te downloaden en de omgeving voor de server in te richten.
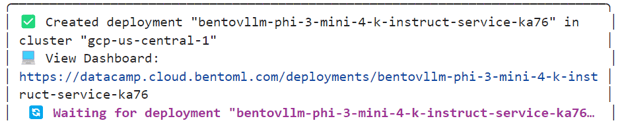
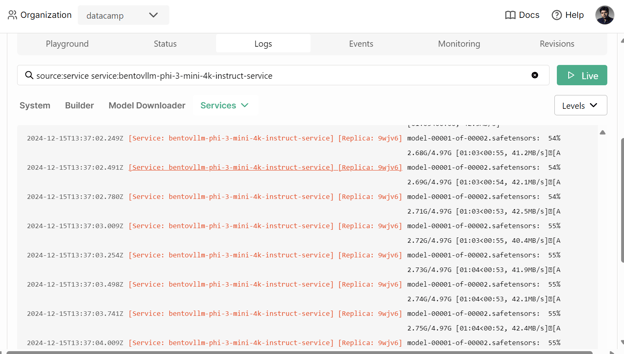
Je kunt de status van je AI‑service bekijken op het tabblad “Deployments”.
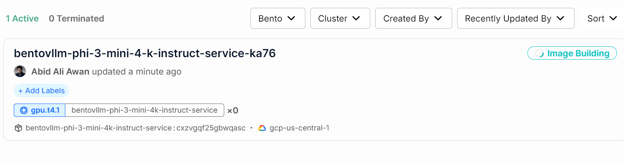
Je kunt ook alle logs bekijken en zien wat er achter de schermen gebeurt.
6. Toegang tot de gedeployde AI‑service
Zodra de AI‑service succesvol is gedeployed, gaan we de Phi 3 Mini vLLM‑service testen.
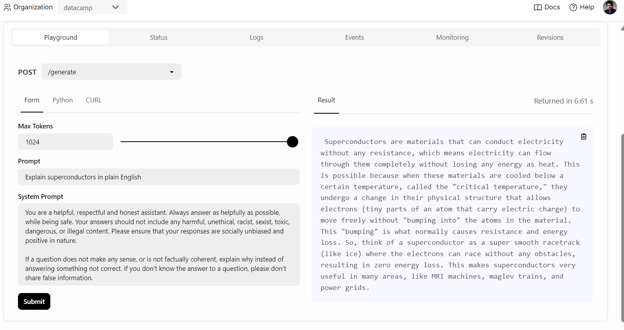
Klik om te beginnen op het tabblad “Playground” onder “Deployments”, voer de prompt in en klik op de knop “submit” om het antwoord te genereren. De respons wordt realtime gestreamd.
 We kunnen ook de BentoML Python‑client gebruiken om het gedeployde model aan te spreken en een respons te genereren. Dit helpt je de AI‑service in je applicatie te integreren:
import bentoml
with bentoml.SyncHTTPClient(
"https://bentovllm-phi-3-mini-4-k-instruct-service-ka76-39800880.mt-guc1.bentoml.ai"
) as client:
response = client.generate(
prompt="What is the largest lake in the world?"
)
for chunk in response:
print(chunk, end="", flush=True)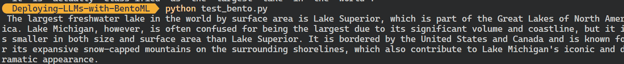
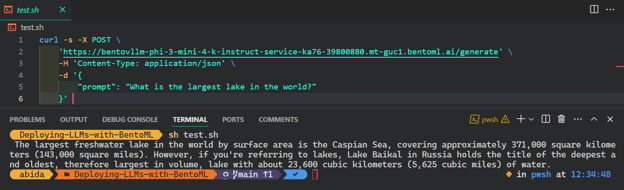
De populairste en eenvoudigste manier om de AI‑service vanaf elk besturingssysteem te benaderen is het CURL-commando in de terminal:
$ curl -s -X POST \
'https://bentovllm-phi-3-mini-4-k-instruct-service-ka76-39800880.mt-guc1.bentoml.ai/generate' \
-H 'Content-Type: application/json' \
-d '{
"prompt": "What is the largest lake in the world?"
}' 
7. Observability
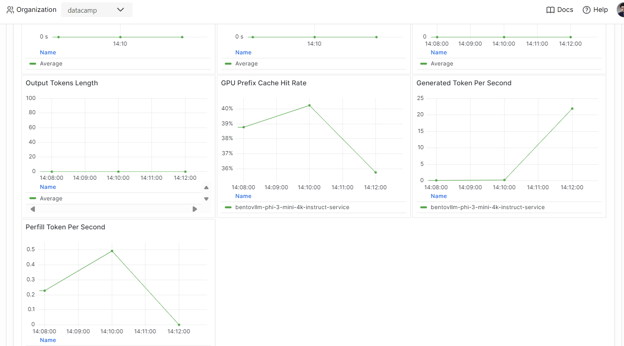
Ga naar het tabblad "Monitoring" en bekijk alle statistieken rond LLM’s, gebruikersverzoeken, hardware en andere monitoring‑analytics die je helpen de prestaties van de AI‑server te beoordelen.
Je kunt ook het tabblad "Logs" raadplegen of de BentoML CLI gebruiken om realtime logs te genereren.
Modellen serven en deployen is één onderdeel van de MLOps‑pipeline. In de cursus Fully Automated MLOps leer je MLOps‑architectuur, CI/CD/CM/CT‑technieken en automatiseringspatronen om ML‑systemen te deployen die blijvende waarde leveren.
Conclusie
Wil je meer leren over het BentoML‑ecosysteem, dan is de beste aanpak om je AI‑service te gaan bouwen en deployen. Je krijgt gratis credits, zodat je GPU’s en CPU’s kunt gebruiken om verschillende services te verkennen. Denk aan een Retrieval‑Augmented Generation (RAG)‑applicatie, function calling, Agentic LLM’s of een multimodale app die afbeeldingen en tekst verwerkt om antwoorden te genereren.
In deze hands‑on tutorial hebben we BentoML leren kennen en gezien hoe je lokaal elke AI‑applicatie kunt serven met slechts een paar regels code. Vervolgens hebben we de vLLM‑inference‑engine gebruikt om een BentoML‑service te bouwen en die in enkele eenvoudige stappen op BentoCloud gedeployed.
Overweeg de career track Associate AI Engineer for Developers om te leren hoe je AI integreert in softwareapplicaties met API’s en open‑sourcelibraries.

Als gecertificeerd data scientist haal ik met passie het maximale uit de nieuwste technologie om innovatieve machinelearning-toepassingen te bouwen. Met een sterke achtergrond in spraakherkenning, data-analyse en -rapportage, MLOps, conversationele AI en NLP heb ik mijn vaardigheden aangescherpt in het ontwikkelen van intelligente systemen die echt impact maken. Naast mijn technische expertise ben ik ook een sterke communicator met een talent om complexe concepten terug te brengen tot heldere, beknopte taal. Daardoor ben ik uitgegroeid tot een veelgelezen blogger over data science, waar ik mijn inzichten en ervaringen deel met een groeiende community van data-professionals. Op dit moment richt ik me op contentcreatie en redactie, waarbij ik met large language models werk aan krachtige en aansprekende content die zowel bedrijven als individuen helpt het beste uit hun data te halen.


Veel data scientists en machine learning engineers lopen vast op tools als Docker, Kubernetes en Terraform, en op het opzetten van veilige infrastructuur voor AI-modellen.
BentoML maakt dit eenvoudiger, zodat je AI‑toepassingen kunt bouwen, serven en deployen met slechts een paar regels Python-code.
Deze tutorial is een stapsgewijze gids voor iedereen die een eigen AI‑app wil deployen, overal toegankelijk via een simpele CURL‑opdracht. Je leert over het BentoML‑framework, lokaal een vraag‑antwoord AI‑app maken en het Phi 3 mini‑model deployen op de BentoCloud.
Wat is BentoML?
BentoML is een framework voor het serven en deployen van machine learning dat het uitrollen en schalen van AI‑modellen stroomlijnt. Het automatiseert taken als het maken van Docker‑images, het inrichten van instances, infrastructuur- en securitybeheer, en essentiële features voor een productieklare server.
Met BentoML kun je in enkele minuten eigen AI‑modellen, pre‑trained modellen of fine‑tuned oplossingen ontwikkelen en deployen met eenvoudige Python‑code. Het biedt de flexibiliteit om efficiënt te schalen binnen je cloudomgeving, terwijl je volledige controle houdt over security en compliance.
BentoML maakt deel uit van de MLOps-toolset. Ontdek andere toonaangevende MLOps‑tools voor trainen, tracken, deployen, orkestreren, testen, monitoren en infrastructuurbeheer in de blog Top 15 LLMOps-tools voor het bouwen van AI‑toepassingen in 2024.
Hoe BentoML werkt | Beeldbron: BentoML
De ster van het Bento‑ecosysteem is de cloud: BentoCloud is een uitbreiding op het BentoML‑framework en biedt extra tools en services om AI‑modellen nog makkelijker te deployen, monitoren en schalen.
Als je je aanmeldt, krijg je gratis credits om te starten, wat het aantrekkelijk maakt voor developers en organisaties.
Ben je niet technisch en zoek je een no‑code tot low‑code oplossing om een LLM‑app te ontwikkelen, volg dan de gids Local AI met Docker, n8n, Qdrant en Ollama.