

BentoML के साथ आरंभ करना
इस सेक्शन में, हम एक सरल AI एप्लिकेशन सर्व करेंगे जो उपयोगकर्ता से प्रश्न और संदर्भ लेता है और प्रतिक्रिया उत्पन्न करता है।
हम pip का उपयोग करके BentoML, PyTorch, और Transformers लाइब्रेरी इंस्टॉल करके शुरुआत करेंगे। अपने टर्मिनल में निम्न कमांड चलाएँ:
$ pip install bentoml
$ pip install torch
$ pip install transformersअगला कदम, हम AI सर्वर को परिभाषित करने के लिए service.py फ़ाइल बनाएंगे।
BentoML कमांड्स का उपयोग करते हुए, हम Transformers पाइपलाइन इम्पोर्ट करेंगे, जो हमें मात्र 2 पंक्तियों के कोड से मॉडल लोड करने और इंफरेंस करने देती है।
हम उदाहरण इनपुट और संदर्भ सेट करेंगे, CPUs की संख्या और ट्रैफ़िक टाइमआउट जैसे पैरामीटर्स के साथ BentoML सेवा कॉन्फ़िगर करेंगे, और Transformers पाइपलाइन का उपयोग करके Question_Answering क्लास इनिशियलाइज़ करेंगे।
अंत में, हम generate() नामक एक API बनाएंगे, जो इनपुट लेता है और जनरेट किया गया उत्तर लौटाता है।
from __future__ import annotations
import bentoml
with bentoml.importing():
from transformers import pipeline
EXAMPLE_INPUT = "How can I generate a secure password?"
EXAMPLE_CONTEXT = """
To generate a secure password, you can use tools like the LastPass Password Generator.
These tools create strong, random passwords that help prevent security threats by ensuring your accounts are protected against hacking attempts.
A secure password typically includes a mix of uppercase and lowercase letters, numbers, and special characters. Avoid using easily guessable information like names or birthdays.
Using a password manager like LastPass can also help you store and manage these secure passwords effectively.
"""
@bentoml.service(
resources={"cpu": "4"},
traffic={"timeout": 10},
)
class Question_Answering:
def __init__(self) -> None:
# Load model into pipeline
self.pipe = pipeline(
"question-answering",
model="deepset/roberta-base-squad2",
)
@bentoml.api
def generate(
self,
text: str =EXAMPLE_INPUT,
doc: str = EXAMPLE_CONTEXT,
) -> str:
result = self.pipe(question=text, context=doc)
return result["answer"]AI सेवा को लोकली सर्व करने के लिए टर्मिनल में निम्न कमांड टाइप करें:
$ bentoml serve service:Question_Answering जैसा कि आप देख सकते हैं, हमने ऊपर दिए गए कमांड में फ़ाइल नाम (service) और Python क्लास (Question_Answering ) का नाम AI मॉडल इंफरेंस के लिए प्रदान किया है।
कुछ ही सेकंड में, यह एक URL जनरेट करेगा जिसे आप ब्राउज़र में कॉपी-पेस्ट करके BentoML सर्वर एक्सेस कर सकते हैं:
[cli] Starting production HTTP BentoServer from "app:Question_Answering" listening on http://localhost:3000 (Press CTRL+C to quit)BentoML सर्वर FastAPI Swagger UI के काफी समान है।
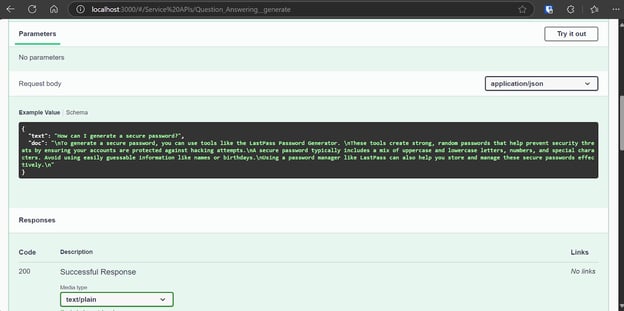
आइए “Try it out” विकल्प का उपयोग करके अपने सर्वर का परीक्षण करें।
हमारी AI सेवा ठीक से काम कर रही है और उसने सटीक प्रतिक्रिया जनरेट की है:
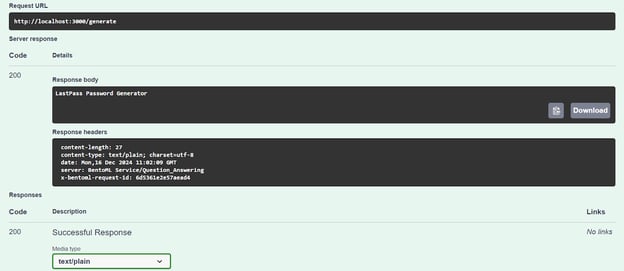
हम CURL कमांड का उपयोग करके भी AI सर्वर तक पहुंच सकते हैं। एक अलग प्रश्न पूछते हैं और उसे संदर्भ देते हैं:
curl -X 'POST' \
'http://localhost:3000/generate' \
-H 'accept: text/plain' \
-H 'Content-Type: application/json' \
-d '{
"text": "How can I buy a cheap car?",
"doc": "Start by setting a budget and exploring sources like online marketplaces (Craigslist, Facebook Marketplace, Cars.com), local dealerships, or government auctions. Inspect the car thoroughly for issues like rust or mechanical problems, and consider bringing a trusted mechanic to avoid future repair costs. Research the reliability of specific brands and models using tools like Kelley Blue Book or Consumer Reports. Finally, negotiate the price to secure the best deal. Following these steps can help you find a dependable car within your budget."
}'हमारी AI सेवा सुचारू रूप से काम कर रही है, और CPU पर भी प्रतिक्रिया जनरेट करने में 1 सेकंड लगा:
negotiate the priceBentoCloud पर Phi 3 Mini 4k Instruct डिप्लॉय करना
अब समय है एक सही मायने में बड़े भाषा मॉडल (LLM) आधारित AI एप्लिकेशन बनाने और न्यूनतम प्रयास व संसाधनों के साथ उसे BentoML पर डिप्लॉय करने का।
हम vLLM फ्रेमवर्क का उपयोग करेंगे ताकि उच्च-थ्रूपुट LLM इंफरेंस बनाया जा सके और उसे BentoCloud पर GPU इंस्टेंस पर डिप्लॉय किया जा सके। भले ही यह जटिल लगे, BentoCloud अधिकतर भारी काम, जैसे इन्फ्रास्ट्रक्चर सेटअप, संभालता है, ताकि आप अपनी सेवा बनाने और डिप्लॉय करने पर ध्यान केंद्रित कर सकें।
1. BentoML vLLM प्रोजेक्ट क्लोन करना
BentoML विभिन्न LLM प्रोजेक्ट्स के लिए बहुत-से उदाहरण कोड और संसाधन प्रदान करता है। आरंभ करने के लिए, हम BentoVLLM रिपॉजिटरी क्लोन करेंगे।
Phi 3 Mini 4k प्रोजेक्ट पर जाएं, और सभी आवश्यक Python लाइब्रेरीज़ इंस्टॉल करें:
$ git clone https://github.com/bentoml/BentoVLLM.git
$ cd BentoVLLM/phi-3-mini-4k-instruct
$ pip install -r requirements.txtसभी फ़ाइलों के साथ प्रोजेक्ट डायरेक्टरी इस तरह दिखती है:
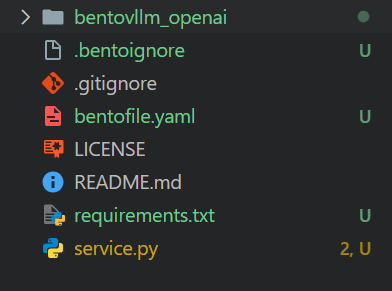
2. bentofile.yaml में बदलाव करना
हम bentofile.yaml में ओनर और स्टेज के नाम बदलने के लिए संशोधन करेंगे।
bentofile.yaml एक Dockerfile से सरल होता है और इन्फ्रास्ट्रक्चर, वातावरण, और सर्वर कॉन्फ़िगरेशन सेट करने के लिए अलग-अलग कमांड्स का उपयोग करता है; आप सभी कमांड्स Bento build options से सीख सकते हैं।
service: 'service:VLLM'
labels:
owner: Abid
stage: Guide
include:
- '*.py'
- 'bentovllm_openai/*.py'
python:
requirements_txt: './requirements.txt'
lock_packages: false
docker:
python_version: "3.11"3. service.py फ़ाइल समझना
हम service.py फ़ाइल में बदलाव नहीं करेंगे, बल्कि इसके बारे में जानेंगे।
- यह कोड एक सर्वर बनाता है जो उपयोगकर्ता से प्रश्न या प्रॉम्प्ट लेकर प्री-ट्रेंड AI मॉडल (Phi-3-mini-4k-instruct) की मदद से प्रतिक्रिया जनरेट करता है।
- यह
@bentoml.serviceका उपयोग डिप्लॉयमेंट और रिसोर्स मैनेजमेंट के लिए करता है, जैसे GPU सेट करना और ट्रैफ़िक मैनेज करना। generateAPI को@bentoml.apiडेकोरेटर के साथ परिभाषित किया गया है। यह उपयोगकर्ता प्रॉम्प्ट, एक वैकल्पिक सिस्टम प्रॉम्प्ट, और अधिकतम टोकन सीमा को इनपुट के रूप में लेता है, जिन्हें vLLM इंफरेंस इंजन को प्रतिक्रिया जनरेट करने के लिए दिया जाता है।generateमेथड मॉडल के आउटपुट को हिस्सों में स्ट्रीम करता है, जैसे ही टोकन उपलब्ध होते हैं उन्हें जनरेट करता जाता है।
import uuid
from typing import AsyncGenerator, Optional
import bentoml
from annotated_types import Ge, Le
from typing_extensions import Annotated
from bentovllm_openai.utils import openai_endpoints
MAX_TOKENS = 1024
PROMPT_TEMPLATE = """<|system|>
{system_prompt}<|end|>
<|user|>
{user_prompt}<|end|>
<|assistant|>
"""
SYSTEM_PROMPT = """You are a helpful, respectful and honest assistant. Always answer as helpfully as possible, while being safe. Your answers should not include any harmful, unethical, racist, sexist, toxic, dangerous, or illegal content. Please ensure that your responses are socially unbiased and positive in nature.
If a question does not make any sense, or is not factually coherent, explain why instead of answering something not correct. If you don't know the answer to a question, please don't share false information."""
MODEL_ID = "microsoft/Phi-3-mini-4k-instruct"
@openai_endpoints(model_id=MODEL_ID)
@bentoml.service(
name="bentovllm-phi-3-mini-4k-instruct-service",
traffic={
"timeout": 300,
"concurrency": 256, # Matches the default max_num_seqs in the VLLM engine
},
resources={
"gpu": 1,
"gpu_type": "nvidia-tesla-t4",
},
)
class VLLM:
def __init__(self) -> None:
from transformers import AutoTokenizer
from vllm import AsyncEngineArgs, AsyncLLMEngine
ENGINE_ARGS = AsyncEngineArgs(
model=MODEL_ID,
max_model_len=MAX_TOKENS,
dtype="half",
enable_prefix_caching=True,
disable_sliding_window=True,
)
self.engine = AsyncLLMEngine.from_engine_args(ENGINE_ARGS)
self.tokenizer = AutoTokenizer.from_pretrained(MODEL_ID)
@bentoml.api
async def generate(
self,
prompt: str = "Explain superconductors in plain English",
system_prompt: Optional[str] = SYSTEM_PROMPT,
max_tokens: Annotated[int, Ge(128), Le(MAX_TOKENS)] = MAX_TOKENS,
) -> AsyncGenerator[str, None]:
from vllm import SamplingParams
SAMPLING_PARAM = SamplingParams(max_tokens=max_tokens)
if system_prompt is None:
system_prompt = SYSTEM_PROMPT
prompt = PROMPT_TEMPLATE.format(user_prompt=prompt, system_prompt=system_prompt)
stream = await self.engine.add_request(uuid.uuid4().hex, prompt, SAMPLING_PARAM)
cursor = 0
async for request_output in stream:
text = request_output.outputs[0].text
yield text[cursor:]
cursor = len(text)मैं Developing AI Applications स्किल ट्रैक लेने की सलाह देता/देती हूँ ताकि आप OpenAI API, Hugging Face, और LangChain सहित नवीनतम AI डेवलपर टूल्स के साथ AI-संचालित एप्लिकेशन बनाना सीख सकें।
4. BentoCloud के लिए सेटअप करना
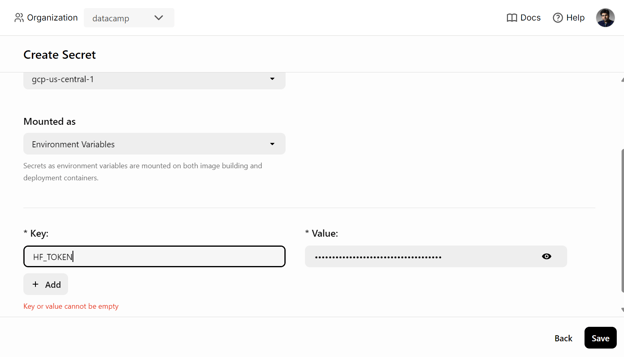
bentofile.yaml पर जाएं और अंतिम पंक्ति में Hugging Face टोकन के लिए वातावरण वेरिएबल जोड़ें। इससे हम Hugging Face सर्वर से मॉडल को सुरक्षित रूप से बिना किसी समस्या के लोड कर सकेंगे:
envs:
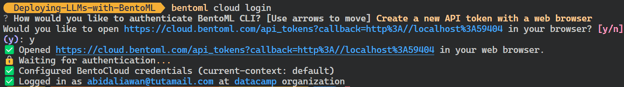
- name: HF_TOKENCLI का उपयोग करके BentoCloud में लॉग इन करें:
$ bentoml cloud loginयह आपसे अकाउंट बनाने के लिए कहेगा और फिर API टोकन बनाने के लिए कहेगा।
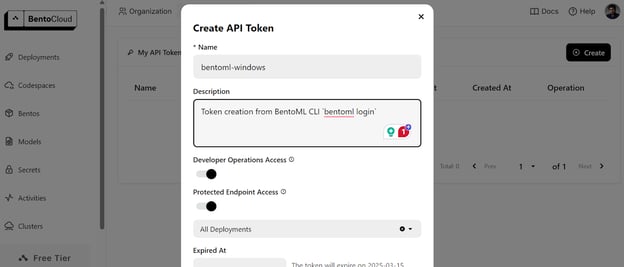
API टोकन सफलतापूर्वक बनाने के बाद, आपको अपने टर्मिनल में सफलता संदेश दिखाई देगा:
5. BentoCloud पर डिप्लॉय करना
AI सेवा को BentoCloud पर डिप्लॉय करने से पहले, हमें BentoCloud में "Secrets" टैब पर जाकर कुंजी का नाम और Hugging Face API कुंजी प्रदान करके एक वातावरण वेरिएबल बनाना होगा।
उसके बाद, AI सेवा डिप्लॉय करने के लिए निम्न कमांड का उपयोग करें:
$ bentoml deploy . --secret huggingfaceमॉडल डाउनलोड करने और सर्वर चलाने के लिए वातावरण सेट करने में कुछ मिनट लगेंगे।
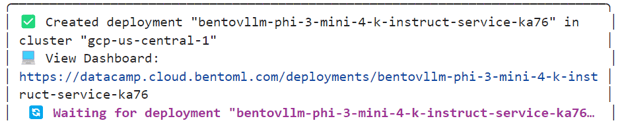
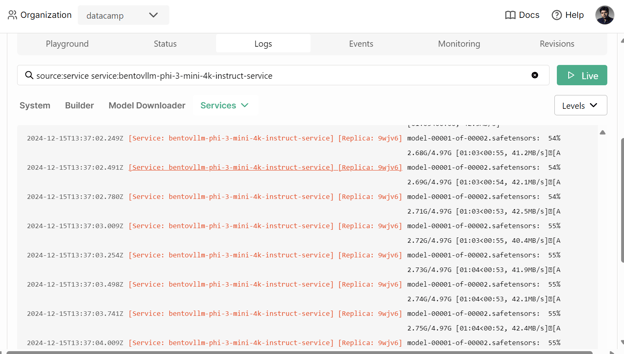
आप “Deployments” टैब में जाकर अपनी AI सेवा की स्थिति जांच सकते हैं।
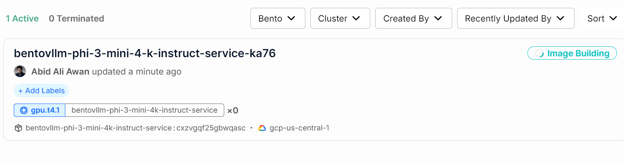
आप सभी लॉग्स भी देख सकते हैं और बैकग्राउंड में क्या हो रहा है, उसे ऑब्ज़र्व कर सकते हैं।
6. डिप्लॉय की गई AI सेवा तक पहुँचना
AI सेवा सफलतापूर्वक डिप्लॉय हो जाने के बाद, हम Phi 3 Mini vLLM सेवा का परीक्षण शुरू करेंगे।
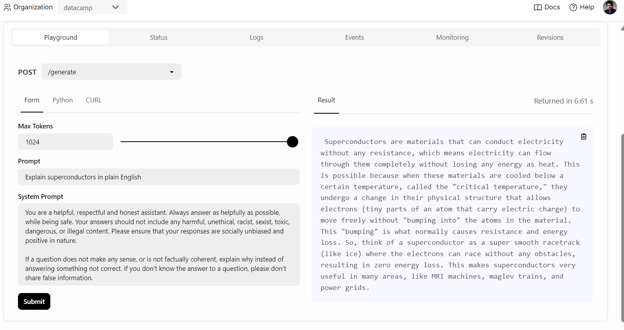
शुरू करने के लिए, हम “Deployments” विकल्प के अंतर्गत “Playground” टैब पर क्लिक कर सकते हैं, प्रॉम्प्ट दर्ज करें, और प्रतिक्रिया जनरेट करने के लिए “submit” बटन पर क्लिक करें। प्रतिक्रिया रियल-टाइम में स्ट्रीम होगी।
 हम BentoML Python क्लाइंट का उपयोग करके भी डिप्लॉय किए गए मॉडल तक पहुँच सकते हैं और प्रतिक्रिया जनरेट कर सकते हैं। यह आपके एप्लिकेशन में AI सेवा को एकीकृत करने में मदद करेगा:
import bentoml
with bentoml.SyncHTTPClient(
"https://bentovllm-phi-3-mini-4-k-instruct-service-ka76-39800880.mt-guc1.bentoml.ai"
) as client:
response = client.generate(
prompt="What is the largest lake in the world?"
)
for chunk in response:
print(chunk, end="", flush=True)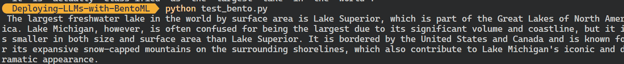
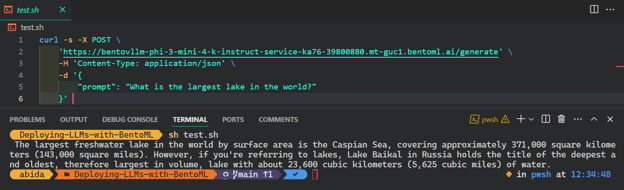
किसी भी ऑपरेटिंग सिस्टम से AI सेवा तक पहुँचने का सबसे लोकप्रिय और आसान तरीका टर्मिनल में CURL कमांड का उपयोग करना है:
$ curl -s -X POST \
'https://bentovllm-phi-3-mini-4-k-instruct-service-ka76-39800880.mt-guc1.bentoml.ai/generate' \
-H 'Content-Type: application/json' \
-d '{
"prompt": "What is the largest lake in the world?"
}' 
7. Observability
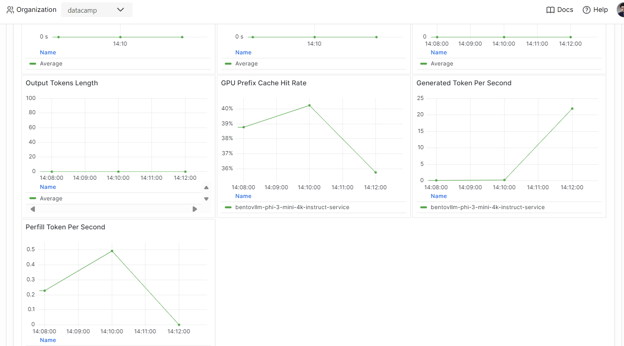
"Monitoring" टैब पर जाएं और LLMs, उपयोगकर्ता अनुरोधों, हार्डवेयर, और अन्य मॉनिटरिंग एनालिटिक्स से संबंधित सभी आँकड़ों की समीक्षा करें, जो आपको AI सर्वर के प्रदर्शन का आकलन करने में मदद करेंगे।
आप "Logs" टैब भी देख सकते हैं या रियल-टाइम लॉग्स जनरेट करने के लिए BentoML CLI का उपयोग कर सकते हैं।
सर्विंग और डिप्लॉयिंग मॉडल्स MLOps पाइपलाइन का एक हिस्सा हैं। Fully Automated MLOps कोर्स पूरा करके, आप MLOps आर्किटेक्चर, CI/CD/CM/CT तकनीकों, और ऑटोमेशन पैटर्न सीख सकते हैं, ताकि समय के साथ वैल्यू देने वाले ML सिस्टम डिप्लॉय किए जा सकें।
निष्कर्ष
यदि आप BentoML इकोसिस्टम के बारे में और सीखना चाहते हैं, तो सबसे अच्छा तरीका है कि आप अपना AI सर्विस बनाना और डिप्लॉय करना शुरू करें। आपको निःशुल्क क्रेडिट मिलते हैं, जिनकी मदद से आप GPUs और CPUs का उपयोग करके विभिन्न सेवाओं का अन्वेषण कर सकते हैं। इसमें Retrieval-Augmented Generation (RAG) एप्लिकेशन, फंक्शन कॉलिंग, Agentic LLMs, या ऐसा मल्टीमॉडल एप्लिकेशन शामिल हो सकता है जो छवियों और टेक्स्ट को प्रोसेस करके प्रतिक्रिया जनरेट करता है।
इस हैंड्स-ऑन ट्यूटोरियल में, हमने BentoML के बारे में सीखा और कुछ पंक्तियों के कोड से किसी भी AI एप्लिकेशन को लोकली सर्व करना जाना। फिर हमने vLLM इंफरेंस इंजन का उपयोग करके एक BentoML सेवा बनाई और कुछ आसान चरणों में उसे BentoCloud पर डिप्लॉय किया।
यह सीखने पर विचार करें: Associate AI Engineer for Developers करियर ट्रैक, ताकि आप APIs और ओपन-सोर्स लाइब्रेरीज़ का उपयोग करके सॉफ्टवेयर एप्लिकेशंस में AI को एकीकृत करना सीख सकें।

एक प्रमाणित डेटा साइंटिस्ट के रूप में, मैं अत्याधुनिक तकनीक का उपयोग करके नवाचारी मशीन लर्निंग अनुप्रयोग बनाने के लिए उत्साहित रहता/रहती हूँ। स्पीच रिकॉग्निशन, डेटा विश्लेषण और रिपोर्टिंग, MLOps, संवादात्मक AI और NLP में मजबूत पृष्ठभूमि के साथ, मैंने ऐसे बुद्धिमान सिस्टम विकसित करने में अपनी विशेषज्ञता निखारी है जो वास्तविक प्रभाव डाल सकें। तकनीकी दक्षता के अलावा, मैं जटिल अवधारणाओं को स्पष्ट और संक्षिप्त भाषा में प्रस्तुत करने में भी निपुण हूँ। परिणामस्वरूप, मैं डेटा साइंस पर एक मांग में रहने वाला/वाली ब्लॉगर बन गया/गई हूँ, और डेटा प्रोफेशनलों के बढ़ते समुदाय के साथ अपने अनुभव और विचार साझा करता/करती हूँ। वर्तमान में, मैं कंटेंट निर्माण और संपादन पर केंद्रित हूँ, बड़े भाषा मॉडलों के साथ काम करते हुए ऐसा प्रभावशाली और आकर्षक कंटेंट विकसित कर रहा/रही हूँ जो व्यवसायों और व्यक्तियों दोनों को अपने डेटा का अधिकतम लाभ उठाने में मदद कर सके।
कई डेटा वैज्ञानिक और मशीन लर्निंग इंजीनियर Docker, Kubernetes, और Terraform जैसे टूल्स के साथ-साथ AI मॉडलों के लिए सुरक्षित इन्फ्रास्ट्रक्चर बनाने में चुनौतियों का सामना करते हैं।
BentoML इस प्रक्रिया को सरल बनाता है, जिससे आप कुछ ही पंक्तियों के Python कोड के साथ AI एप्लिकेशन बना, सर्व, और डिप्लॉय कर सकते हैं।
यह ट्यूटोरियल उन व्यक्तियों के लिए चरण-दर-चरण मार्गदर्शिका है जो अपना AI ऐप डिप्लॉय करना चाहते हैं, जिसे एक साधारण CURL कमांड के माध्यम से कहीं से भी एक्सेस किया जा सके। आप BentoML फ्रेमवर्क के बारे में जानेंगे, लोकली एक प्रश्न-उत्तर AI ऐप बनाएंगे, और BentoCloud पर Phi 3 mini मॉडल डिप्लॉय करेंगे।
BentoML क्या है?
BentoML एक मशीन लर्निंग सर्विंग और डिप्लॉयमेंट फ्रेमवर्क है जो AI मॉडलों को डिप्लॉय और स्केल करने की प्रक्रिया को सुगम बनाता है। यह Docker इमेज निर्माण, इंस्टेंस सेटअप, इन्फ्रास्ट्रक्चर और सुरक्षा प्रबंधन, तथा प्रोडक्शन-रेडी सर्वर के लिए आवश्यक फ़ीचर्स जैसे कार्यों को स्वचालित करता है।
BentoML के साथ, आप सरल Python कोड में कुछ ही मिनटों में कस्टम AI मॉडल, प्री-ट्रेंड मॉडल, या फाइन-ट्यून समाधान विकसित और डिप्लॉय कर सकते हैं। यह आपके क्लाउड वातावरण में कुशलतापूर्वक स्केल करने की लचीलापन देता है, साथ ही यह सुनिश्चित करता है कि सुरक्षा और अनुपालन पर आपका पूरा नियंत्रण बना रहे।
BentoML MLOps टूलसेट का हिस्सा है। प्रशिक्षण, ट्रैकिंग, डिप्लॉयमेंट, ऑर्केस्ट्रेशन, परीक्षण, मॉनिटरिंग, और इन्फ्रास्ट्रक्चर प्रबंधन के लिए अन्य उत्कृष्ट MLOps टूल्स के बारे में जानने के लिए ब्लॉग 2024 में AI एप्लिकेशन बनाने के लिए शीर्ष 15 LLMOps टूल्स पढ़ें।
BentoML कैसे काम करता है | चित्र स्रोत: BentoML
Bento इकोसिस्टम का मुख्य आकर्षण इसका क्लाउड है: BentoCloud, BentoML के फ्रेमवर्क का एक एक्सटेंशन है, जो डिप्लॉयमेंट, मॉनिटरिंग, और AI मॉडलों को स्केल करना और भी आसान बनाने के लिए अतिरिक्त टूल्स और सेवाएं प्रदान करता है।
साइन अप करने पर, उपयोगकर्ताओं को आरंभ करने के लिए निःशुल्क क्रेडिट मिलते हैं, जो डेवलपर्स और एंटरप्राइज़ के लिए इसे एक आकर्षक विकल्प बनाता है।
यदि आप गैर-तकनीकी हैं और किसी LLM एप्लिकेशन के लिए नो-कोड से लो-कोड समाधान ढूंढ रहे हैं, तो मैं Docker, n8n, Qdrant, और Ollama के साथ Local AI गाइड का पालन करने की सलाह देता/देती हूँ।