

Primi passi con BentoML
In questa sezione serviremo una semplice applicazione di AI che prende domande e contesto dall'utente e genera la risposta.
Inizieremo installando BentoML, PyTorch e la libreria Transformers usando pip. Esegui i seguenti comandi nel terminale:
$ pip install bentoml
$ pip install torch
$ pip install transformersPoi creeremo un file service.py per definire il server di AI.
Con i comandi di BentoML importeremo la pipeline di Transformers, che ci permette di caricare il modello ed effettuare inferenza con appena 2 righe di codice.
Imposteremo esempi di input testuali e contesto, configureremo il servizio BentoML con parametri come numero di CPU e timeout del traffico e inizializzeremo la classe Question_Answering usando la pipeline di Transformers.
Infine, creeremo un'API chiamata generate(), che prende input e output e restituisce la risposta generata.
from __future__ import annotations
import bentoml
with bentoml.importing():
from transformers import pipeline
EXAMPLE_INPUT = "How can I generate a secure password?"
EXAMPLE_CONTEXT = """
To generate a secure password, you can use tools like the LastPass Password Generator.
These tools create strong, random passwords that help prevent security threats by ensuring your accounts are protected against hacking attempts.
A secure password typically includes a mix of uppercase and lowercase letters, numbers, and special characters. Avoid using easily guessable information like names or birthdays.
Using a password manager like LastPass can also help you store and manage these secure passwords effectively.
"""
@bentoml.service(
resources={"cpu": "4"},
traffic={"timeout": 10},
)
class Question_Answering:
def __init__(self) -> None:
# Load model into pipeline
self.pipe = pipeline(
"question-answering",
model="deepset/roberta-base-squad2",
)
@bentoml.api
def generate(
self,
text: str =EXAMPLE_INPUT,
doc: str = EXAMPLE_CONTEXT,
) -> str:
result = self.pipe(question=text, context=doc)
return result["answer"]Servi il servizio di AI in locale digitando il seguente comando nel terminale:
$ bentoml serve service:Question_Answering Come vedi, abbiamo fornito al comando sopra il nome del file (service) e il nome della classe Python (Question_Answering ) per l'inferenza del modello di AI.
In pochi secondi genererà un URL che puoi copiare e incollare nel browser per accedere al server BentoML:
[cli] Starting production HTTP BentoServer from "app:Question_Answering" listening on http://localhost:3000 (Press CTRL+C to quit)Il server BentoML è piuttosto simile alla swagger UI di FastAPI.
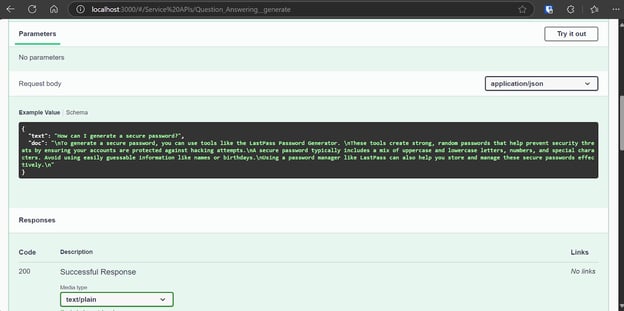
Testiamo il nostro server usando l'opzione “Try it out”.
Il nostro servizio di AI funziona bene e ha generato una risposta accurata:
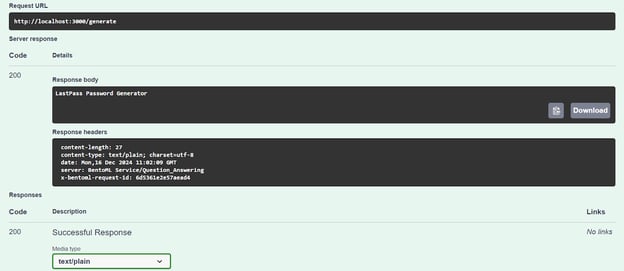
Possiamo anche accedere al server di AI usando il comando CURL. Facciamo una domanda diversa e forniamo il contesto:
curl -X 'POST' \
'http://localhost:3000/generate' \
-H 'accept: text/plain' \
-H 'Content-Type: application/json' \
-d '{
"text": "How can I buy a cheap car?",
"doc": "Start by setting a budget and exploring sources like online marketplaces (Craigslist, Facebook Marketplace, Cars.com), local dealerships, or government auctions. Inspect the car thoroughly for issues like rust or mechanical problems, and consider bringing a trusted mechanic to avoid future repair costs. Research the reliability of specific brands and models using tools like Kelley Blue Book or Consumer Reports. Finally, negotiate the price to secure the best deal. Following these steps can help you find a dependable car within your budget."
}'Il nostro servizio di AI funziona in modo fluido e ha impiegato 1 secondo per generare una risposta anche su CPU:
negotiate the priceDistribuire Phi 3 Mini 4k Instruct su BentoCloud
È il momento di costruire una vera applicazione di AI con un large language model (LLM) e distribuirla su BentoML con il minimo sforzo e risorse.
Useremo il framework vLLM per creare un'inferenza LLM ad alto throughput e distribuirla su un'istanza GPU su BentoCloud. Anche se può sembrare complesso, BentoCloud gestisce gran parte del lavoro pesante, inclusa la configurazione dell'infrastruttura, così puoi concentrarti sulla creazione e distribuzione del tuo servizio.
1. Clonare il progetto vLLM di BentoML
BentoML offre molto codice di esempio e risorse per vari progetti LLM. Per iniziare, cloneremo il repository BentoVLLM.
Vai al progetto Phi 3 Mini 4k e installa tutte le librerie Python richieste:
$ git clone https://github.com/bentoml/BentoVLLM.git
$ cd BentoVLLM/phi-3-mini-4k-instruct
$ pip install -r requirements.txtEcco come appare la directory del progetto con tutti i file:
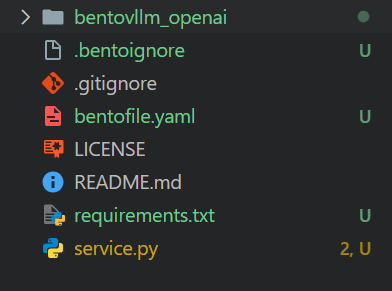
2. Modificare il bentofile.yaml
Modificheremo il bentofile.yaml per cambiare i nomi del proprietario e dello stage.
Il bentofile.yaml è più semplice di un Dockerfile e usa comandi diversi per configurare infrastruttura, ambiente e impostazioni del server; puoi imparare tutti i comandi dalle opzioni di build di Bento.
service: 'service:VLLM'
labels:
owner: Abid
stage: Guide
include:
- '*.py'
- 'bentovllm_openai/*.py'
python:
requirements_txt: './requirements.txt'
lock_packages: false
docker:
python_version: "3.11"3. Comprendere il file service.py
Non cambieremo il file service.py, ma lo analizzeremo.
- Il codice crea un server in grado di ricevere una domanda o un prompt da un utente e generare una risposta usando un modello di AI pre-addestrato (Phi-3-mini-4k-instruct).
- Usa
@bentoml.serviceper gestire deploy e risorse, come la configurazione delle GPU e la gestione del traffico. - L'API
generateè definita con il decorator@bentoml.api. Riceve un prompt dell'utente, un eventuale prompt di sistema e un limite massimo di token come input, che vengono poi forniti al motore di inferenza vLLM per generare la risposta. - Il metodo
generateeffettua lo streaming dell'output del modello in chunk, generando token non appena disponibili.
import uuid
from typing import AsyncGenerator, Optional
import bentoml
from annotated_types import Ge, Le
from typing_extensions import Annotated
from bentovllm_openai.utils import openai_endpoints
MAX_TOKENS = 1024
PROMPT_TEMPLATE = """<|system|>
{system_prompt}<|end|>
<|user|>
{user_prompt}<|end|>
<|assistant|>
"""
SYSTEM_PROMPT = """You are a helpful, respectful and honest assistant. Always answer as helpfully as possible, while being safe. Your answers should not include any harmful, unethical, racist, sexist, toxic, dangerous, or illegal content. Please ensure that your responses are socially unbiased and positive in nature.
If a question does not make any sense, or is not factually coherent, explain why instead of answering something not correct. If you don't know the answer to a question, please don't share false information."""
MODEL_ID = "microsoft/Phi-3-mini-4k-instruct"
@openai_endpoints(model_id=MODEL_ID)
@bentoml.service(
name="bentovllm-phi-3-mini-4k-instruct-service",
traffic={
"timeout": 300,
"concurrency": 256, # Matches the default max_num_seqs in the VLLM engine
},
resources={
"gpu": 1,
"gpu_type": "nvidia-tesla-t4",
},
)
class VLLM:
def __init__(self) -> None:
from transformers import AutoTokenizer
from vllm import AsyncEngineArgs, AsyncLLMEngine
ENGINE_ARGS = AsyncEngineArgs(
model=MODEL_ID,
max_model_len=MAX_TOKENS,
dtype="half",
enable_prefix_caching=True,
disable_sliding_window=True,
)
self.engine = AsyncLLMEngine.from_engine_args(ENGINE_ARGS)
self.tokenizer = AutoTokenizer.from_pretrained(MODEL_ID)
@bentoml.api
async def generate(
self,
prompt: str = "Explain superconductors in plain English",
system_prompt: Optional[str] = SYSTEM_PROMPT,
max_tokens: Annotated[int, Ge(128), Le(MAX_TOKENS)] = MAX_TOKENS,
) -> AsyncGenerator[str, None]:
from vllm import SamplingParams
SAMPLING_PARAM = SamplingParams(max_tokens=max_tokens)
if system_prompt is None:
system_prompt = SYSTEM_PROMPT
prompt = PROMPT_TEMPLATE.format(user_prompt=prompt, system_prompt=system_prompt)
stream = await self.engine.add_request(uuid.uuid4().hex, prompt, SAMPLING_PARAM)
cursor = 0
async for request_output in stream:
text = request_output.outputs[0].text
yield text[cursor:]
cursor = len(text)Ti consiglio lo skill track Developing AI Applications per imparare a creare applicazioni basate su AI con i più recenti strumenti per sviluppatori, tra cui l'API di OpenAI, Hugging Face e LangChain.
4. Configurazione per BentoCloud
Vai al bentofile.yaml e aggiungi in fondo la variabile d'ambiente per il token di Hugging Face. Questo ci aiuterà a caricare il modello in modo sicuro senza problemi dal server di Hugging Face:
envs:
- name: HF_TOKENAccedi a BentoCloud tramite CLI:
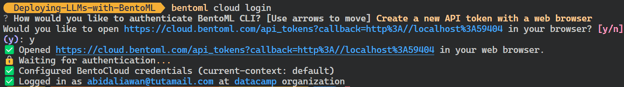
$ bentoml cloud loginTi chiederà di creare l'account e poi di creare il token API.
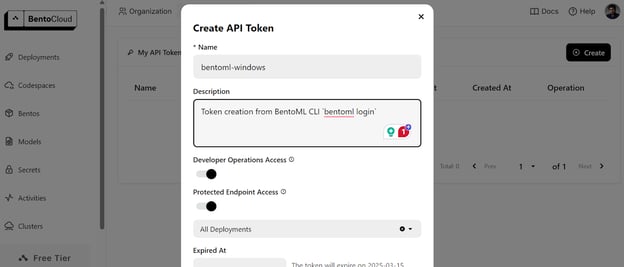
Dopo aver creato con successo il token API, vedrai nel terminale il messaggio di conferma:
5. Distribuire su BentoCloud
Prima di distribuire il servizio di AI su BentoCloud, dobbiamo creare una variabile d'ambiente su BentoCloud andando nella scheda "Secrets" e inserendo il nome della chiave e la chiave API di Hugging Face.
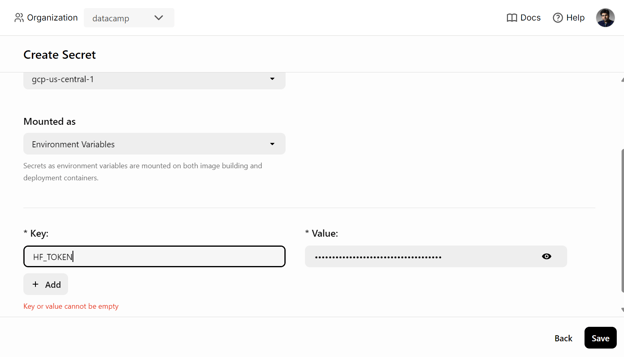
Dopodiché, usa il seguente comando per distribuire il servizio di AI:
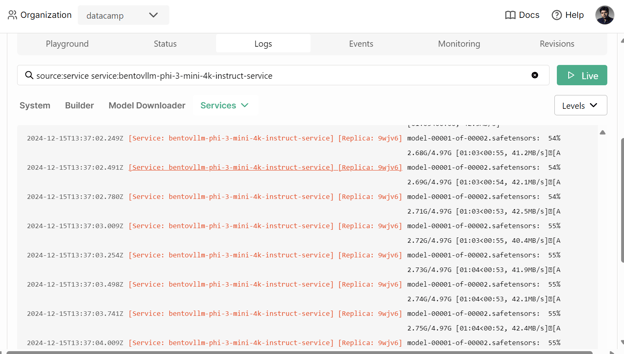
$ bentoml deploy . --secret huggingfaceCi vorranno alcuni minuti per scaricare il modello e predisporre l'ambiente per eseguire il server.
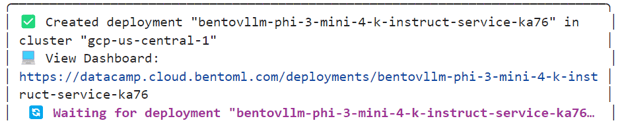
Puoi controllare lo stato del tuo servizio di AI andando nella scheda “Deployments”.
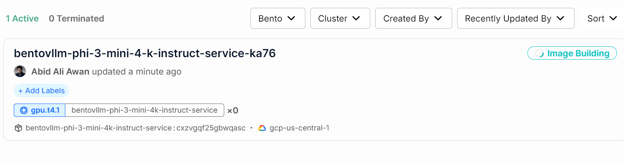
Puoi anche controllare tutti i log e osservare cosa succede in background.
6. Accesso al servizio di AI distribuito
Quando il servizio di AI è stato distribuito con successo, inizieremo a testare il servizio vLLM Phi 3 Mini.
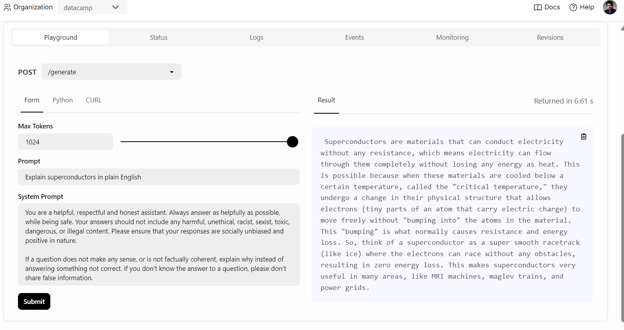
Per cominciare, possiamo semplicemente cliccare sulla scheda “Playground” sotto l'opzione “Deployments”, inserire il prompt e cliccare sul pulsante “submit” per generare la risposta. La risposta verrà trasmessa in tempo reale.
 Possiamo anche usare il client Python di BentoML per accedere al modello distribuito e generare una risposta. Questo ti aiuterà a integrare il servizio di AI nella tua applicazione:
import bentoml
with bentoml.SyncHTTPClient(
"https://bentovllm-phi-3-mini-4-k-instruct-service-ka76-39800880.mt-guc1.bentoml.ai"
) as client:
response = client.generate(
prompt="What is the largest lake in the world?"
)
for chunk in response:
print(chunk, end="", flush=True)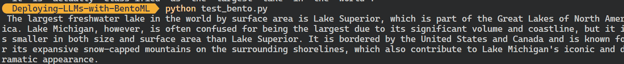
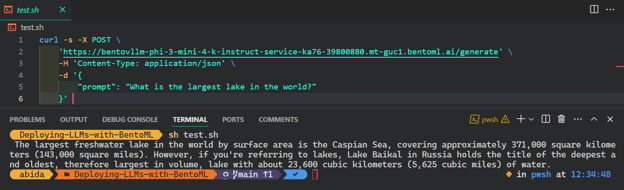
Il modo più comune e semplice per accedere al servizio di AI da qualsiasi sistema operativo è usare il comando CURL nel terminale:
$ curl -s -X POST \
'https://bentovllm-phi-3-mini-4-k-instruct-service-ka76-39800880.mt-guc1.bentoml.ai/generate' \
-H 'Content-Type: application/json' \
-d '{
"prompt": "What is the largest lake in the world?"
}' 
7. Observability
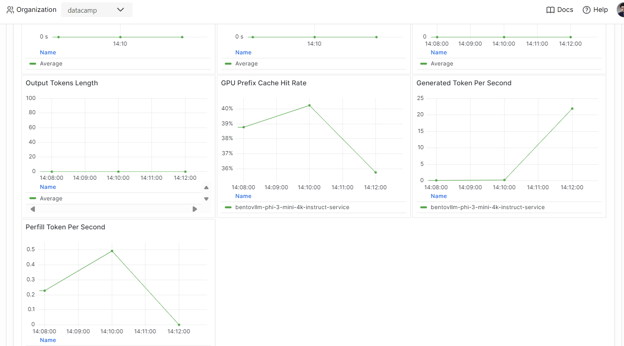
Vai alla scheda "Monitoring" e rivedi tutte le statistiche relative agli LLM, alle richieste degli utenti, all'hardware e ad altre analitiche di monitoraggio che ti aiuteranno a valutare le prestazioni del server di AI.
Puoi anche controllare la scheda "Logs" o usare la CLI di BentoML per generare log in tempo reale.
Il serving e il deploy dei modelli sono una parte della pipeline MLOps. Completando il corso Fully Automated MLOps, puoi imparare a costruire architetture MLOps, tecniche CI/CD/CM/CT e pattern di automazione per distribuire sistemi ML in grado di generare valore nel tempo.
Conclusione
Se vuoi saperne di più sull'ecosistema BentoML, il modo migliore è iniziare a creare e distribuire il tuo servizio di AI. Ricevi crediti gratuiti che ti permettono di usare GPU e CPU per esplorare vari servizi. Questo può includere un'applicazione di Retrieval-Augmented Generation (RAG), function calling, LLM agentici o un'app multimodale che elabora immagini e testo per generare risposte.
In questo tutorial pratico, abbiamo visto cos'è BentoML e come servire in locale qualsiasi applicazione di AI con poche righe di codice. Poi abbiamo usato il motore di inferenza vLLM per costruire un servizio BentoML e distribuirlo su BentoCloud in pochi semplici passaggi.
Valuta di seguire il career track Associate AI Engineer for Developers per imparare a integrare l'AI nelle applicazioni software usando API e librerie open source.

In quanto data scientist certificato, sono appassionato di sfruttare tecnologie all’avanguardia per creare applicazioni di machine learning innovative. Con una solida esperienza in riconoscimento vocale, analisi e reportistica dei dati, MLOps, AI conversazionale e NLP, ho affinato le mie competenze nello sviluppo di sistemi intelligenti in grado di avere un impatto concreto. Oltre alla mia expertise tecnica, sono anche un comunicatore efficace, con il talento di rendere chiari e sintetici concetti complessi. Di conseguenza, sono diventato un blogger molto seguito in ambito data science, condividendo idee ed esperienze con una community in crescita di professionisti dei dati. Attualmente mi concentro sulla creazione e sull’editing di contenuti, lavorando con large language model per sviluppare contenuti potenti e coinvolgenti che possano aiutare aziende e singoli a valorizzare al meglio i propri dati.





Molti data scientist e machine learning engineer incontrano difficoltà con strumenti come Docker, Kubernetes e Terraform, così come nella creazione di infrastrutture sicure per i modelli di AI.
BentoML semplifica questo processo, permettendoti di creare, servire e distribuire applicazioni di AI con poche righe di codice Python.
Questo tutorial è una guida passo passo per chi vuole distribuire la propria app di AI, accessibile ovunque tramite un semplice comando CURL. Imparerai a conoscere il framework BentoML, a creare in locale un'app di domanda-risposta e a distribuire il modello Phi 3 mini su BentoCloud.
Che cos'è BentoML?
BentoML è un framework per il serving e la distribuzione di modelli di machine learning che semplifica il deploy e lo scaling dei modelli di AI. Automatizza attività come la creazione di immagini Docker, la configurazione delle istanze, la gestione dell'infrastruttura e della sicurezza e le funzionalità essenziali richieste per un server pronto per la produzione.
Con BentoML puoi sviluppare e distribuire modelli di AI personalizzati, modelli pre-addestrati o soluzioni fine-tunate in pochi minuti con semplice codice Python. Offre la flessibilità di scalare in modo efficiente nel tuo ambiente cloud, garantendoti al contempo il pieno controllo su sicurezza e conformità.
BentoML fa parte della cassetta degli attrezzi MLOps. Scopri altri strumenti MLOps di prim'ordine per training, tracking, deploy, orchestrazione, testing, monitoring e gestione dell'infrastruttura leggendo il blog Top 15 LLMOps Tools for Building AI Applications in 2024.
Come funziona BentoML | Fonte immagine: BentoML
La stella dell'ecosistema Bento è il suo cloud: BentoCloud è un'estensione del framework di BentoML, che offre strumenti e servizi aggiuntivi per rendere ancora più semplice il deploy, il monitoraggio e lo scaling dei modelli di AI.
Registrandoti, puoi accedere a crediti gratuiti per iniziare, una scelta interessante per sviluppatori e aziende.
Se non sei tecnico e cerchi una soluzione no-code o low-code per sviluppare un'app LLM, ti consiglio di seguire la guida Local AI with Docker, n8n, Qdrant, and Ollama.