
Last chance! 50% off DataCamp Premium
Sale ends in
Lĩnh vực Khoa học Dữ liệu đã phát triển với tốc độ chưa từng có. Nó kết hợp rất nhiều miền khác nhau như Thống kê, Đại số tuyến tính, Học máy, Cơ sở dữ liệu và hòa quyện chúng theo cách có ý nghĩa nhất. Nhưng cốt lõi, điều gì khiến lĩnh vực này trở nên “điên rồ” đến vậy? - Các thuật toán thống kê mạnh mẽ
Một thuật toán thống kê sơ khai như vậy là Hồi quy tuyến tính. Dù đã rất lâu đời, nó vẫn không bao giờ quá cũ để một người mới vào nghề khoa học dữ liệu như bạn bỏ qua. Hiểu nguyên lý hoạt động của hồi quy tuyến tính rất quan trọng để lý giải sự hình thành của cả một lớp thuật toán thống kê gọi là Mô hình tuyến tính tổng quát. Hơn nữa, nó cũng giúp bạn hiểu các khía cạnh khác của một thuật toán thống kê/học máy điển hình, ví dụ: hàm chi phí, hệ số, tối ưu hóa, v.v.
Đúng như tiêu đề gợi ý, trong hướng dẫn này bạn sẽ tìm hiểu chi tiết về Hồi quy tuyến tính. Trước khi đi sâu vào lý thuyết đằng sau Hồi quy tuyến tính, hãy cùng làm rõ khái niệm hồi quy.
Hồi quy thuộc lớp nhiệm vụ Học có giám sát nơi các tập dữ liệu dùng cho mô hình hóa dự đoán/thống kê chứa nhãn liên tục. Nhưng hãy định nghĩa bài toán hồi quy theo cách toán học hơn.
Xét hình ảnh sau:  Nguồn: ghi chú bài giảng của Andrew Ng
Trong hình trên, X là tập các giá trị tương ứng với diện tích sinh hoạt của nhiều ngôi nhà (cũng được coi là không gian giá trị đầu vào) và y là giá của các ngôi nhà tương ứng nhưng lưu ý rằng các giá trị này được dự đoán bởi h. h là hàm ánh xạ các giá trị X sang y (thường gọi là bộ dự đoán). Vì lý do lịch sử, h được gọi là hàm giả thuyết. Lưu ý, tập dữ liệu này chỉ có một đặc trưng, tức diện tích sinh hoạt của các ngôi nhà; hãy coi đây là một tập dữ liệu đồ chơi để dễ hiểu.
Lưu ý rằng các giá trị dự đoán ở đây là liên tục. Vậy mục tiêu cuối cùng của bạn là: cho một tập huấn luyện, học một hàm $h : \mathcal{X} \rightarrow \mathcal{Y}$ sao cho h(x) là một bộ dự đoán “tốt” cho giá trị y tương ứng. Cũng cần nhớ rằng miền giá trị mà cả X và Y nhận đều là số thực và bạn có thể định nghĩa: $\mathcal{X} = \mathcal{Y} = \mathbb{IR}$, trong đó $\mathbb{IR}$ là tập tất cả các số thực.
Một cặp (x(i), y(i)) được gọi là một mẫu huấn luyện. Bạn có thể định nghĩa tập huấn luyện là {(x(i), y(i)) ; i = 1,...,m} (trong trường hợp tập huấn luyện có m mẫu và chỉ có một đặc trưng x trong dữ liệu).
Một chút toán học để bạn không nhầm ngay cả ở những điều đơn giản nhất. Theo Han, Kamber và Pei -
"Nói chung, các phương pháp này được dùng để dự đoán giá trị của biến phản hồi (phụ thuộc) từ một hoặc nhiều biến dự đoán (độc lập), trong đó các biến là dạng số." - Data Mining: Concepts and Techniques (ấn bản 3)
Đơn giản là vậy!
Như vậy, trong quá trình hiểu một bài toán hồi quy điển hình, bạn cũng đã thấy cách định nghĩa một hàm giả thuyết cho nó. Tuyệt vời. Bạn đã vào guồng rất đúng! Giờ hãy đi thẳng vào cơ chế của Hồi quy tuyến tính.
Trước khi đi vào chi tiết, chẳng phải sẽ hay hơn nếu nhìn lại thời điểm nó được phát hiện? Điều đó quay về tận thế kỷ 18. Nhà bác học Carl Friedrich Gauss được cho là người đầu tiên đề xuất dạng sơ khai nhất của hồi quy thống kê, dù có nhiều tranh luận về việc này. Ta không đi sâu vào tranh cãi đó. Nếu bạn hứng thú với tranh luận giữa Gauss và Adrien-Marie Legendre, đây là liên kết để xem.
Hồi quy tuyến tính có lẽ là một trong những thuật toán nổi tiếng và được hiểu rõ nhất trong thống kê và học máy. Nó được phát triển trong lĩnh vực thống kê và được nghiên cứu như một mô hình để hiểu mối quan hệ giữa biến đầu vào và đầu ra dạng số; theo thời gian, nó trở thành một phần không thể thiếu của hộp công cụ học máy hiện đại.
Hãy lấy một tập dữ liệu đồ chơi. Bạn sẽ dùng lại tập dữ liệu dự đoán giá nhà nhưng lần này có hai đặc trưng. Nhiệm vụ vẫn như cũ, tức là dự đoán giá nhà.
 Nguồn: ghi chú bài giảng của Andrew Ng
Như đã đề cập, giờ các x là hai chiều, nghĩa là tập dữ liệu của bạn có hai đặc trưng. Chẳng hạn, x1(i) là diện tích sinh hoạt của ngôi nhà thứ i trong tập huấn luyện, và x2(i) là số phòng ngủ của nó.
Để thực hiện hồi quy, bạn phải quyết định cách biểu diễn h. Ban đầu, giả sử bạn xấp xỉ y như một hàm tuyến tính của x:
Ở đây, các θi là tham số (còn gọi là trọng số) tham số hóa không gian các hàm tuyến tính ánh xạ từ $\mathcal{X}$ sang $\mathcal{Y}$. Nói đơn giản, các tham số này dùng để ánh xạ chính xác $\mathcal{X}$ tới $\mathcal{Y}$. Để đơn giản hóa, bạn sẽ bỏ chỉ số θ trong hθ(x) và viết đơn giản là h(x). Để ký hiệu gọn hơn nữa, bạn cũng quy ước x0 = 1 (đây là hạng chặn), sao cho

trong đó ở vế phải bạn coi cả θ và x là các vectơ, và n là số đặc trưng đầu vào (không tính x0).
Nhưng câu hỏi chính đặt ra lúc này là làm sao chọn hoặc học được các tham số θ? Bạn không thể thay đổi các đầu vào để dự đoán giá. Bạn chỉ có các tham số θ này để tinh chỉnh/điều chỉnh.
Một phương pháp nổi bật là làm cho h(x) gần với y, ít nhất là trên các mẫu huấn luyện bạn có. Để hiểu chính thức hơn, hãy thử định nghĩa một hàm xác định, với mỗi giá trị của θ, mức độ gần nhau giữa các h(x(i)) và y(i) tương ứng. Hàm đó có dạng sau:

Để hiểu vì sao dùng bình phương thay vì giá trị tuyệt đối, hãy coi hạng bình phương này là lợi thế cho các phép toán sẽ thực hiện khi huấn luyện mô hình hồi quy. Nếu muốn đào sâu, hãy xem ở đây.
Bạn vừa thấy một trong những công thức quan trọng nhất trong thế giới Khoa học Dữ liệu/Học máy/Thống kê. Nó được gọi là hàm chi phí.
Đây là suy dẫn cốt yếu vì không chỉ sinh ra bước phát triển tiếp theo của hồi quy tuyến tính (Bình phương tối thiểu thông thường) mà còn đặt nền tảng cho cả một lớp thuật toán mô hình tuyến tính (nhớ thuật ngữ Mô hình tuyến tính tổng quát chứ?).
Lưu ý rằng hồi quy tuyến tính thường chia thành hai dạng cơ bản:
Những điều này rất trực quan nhưng dễ gây nhầm lẫn.
Bạn đã đặt nền móng cho hồi quy tuyến tính. Giờ bạn sẽ tìm hiểu thêm về các cách ước lượng các tham số ở phần trên. Việc ước lượng tham số về bản chất chính là huấn luyện hồi quy tuyến tính. Có nhiều cách để huấn luyện một mô hình hồi quy tuyến tính, trong đó Bình phương tối thiểu thông thường (OLS) là phổ biến nhất. Vì vậy, gọi mô hình hồi quy tuyến tính được huấn luyện bằng OLS là Ordinary Least Squares Linear Regression hoặc đơn giản là Least Squares Regression là hợp lý.
Lưu ý: trong ngữ cảnh này, các tham số còn được gọi là hệ số của mô hình.
Học/huấn luyện một mô hình hồi quy tuyến tính về cơ bản là ước lượng giá trị của các hệ số/tham số dùng trong biểu diễn từ dữ liệu bạn có.
Trong phần này, bạn sẽ điểm qua một số kỹ thuật để chuẩn bị một mô hình hồi quy tuyến tính.
Ở phần trước, bạn dừng lại với ý tưởng chọn θ sao cho J(θ) nhỏ nhất. Để làm vậy, hãy dùng một thuật toán tìm kiếm bắt đầu với một “phỏng đoán ban đầu” cho θ, rồi lặp lại việc thay đổi θ để làm J(θ) nhỏ hơn, cho đến khi (hy vọng) hội tụ tới một giá trị θ cực tiểu J(θ). Cụ thể, xem xét thuật toán hạ gradient, bắt đầu với một θ ban đầu, và lặp lại cập nhật:
 Nguồn: ghi chú bài giảng của Andrew Ng
(Cập nhật này được thực hiện đồng thời cho mọi j = 0, . . . , n.) Ở đây, α được gọi là tốc độ học. Đây là thuật toán rất tự nhiên, liên tục bước theo hướng giảm dốc nhất của J. Tham số α điều khiển mức “dốc” mà thuật toán di chuyển để giảm J. Có thể minh họa như sau:
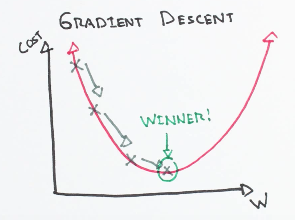 Nguồn: ml-cheatsheet
Trực giác mà nói, công thức trên biểu thị thay đổi nhỏ xảy ra trong J theo tham số θj và nó ảnh hưởng đến giá trị ban đầu của θj như thế nào. Nhưng hãy để ý, bạn có đạo hàm riêng phần cần xử lý. Toàn bộ quá trình suy dẫn nằm ngoài phạm vi hướng dẫn này.
Chỉ cần lưu ý rằng với một mẫu huấn luyện đơn, ta có quy tắc cập nhật:
 Nguồn: ml-cheatsheet
Quy tắc này gọi là quy tắc cập nhật LMS (LMS viết tắt của “least mean squares”) và còn được biết đến là quy tắc học Widrow-Hoff.
Hãy tóm lược vài điểm trong bối cảnh OLS.
"Thủ tục Bình phương tối thiểu thông thường tìm cách tối thiểu hóa tổng bình phương phần dư. Nghĩa là, với một đường hồi quy đi qua dữ liệu, ta tính khoảng cách từ mỗi điểm dữ liệu đến đường hồi quy, bình phương nó, rồi cộng tất cả sai số bình phương lại. Đây là đại lượng mà OLS tìm cách tối thiểu hóa." - Jason Brownlee
Trong quy tắc huấn luyện trước đó, bạn đã có khái niệm về cách đưa hạ gradient vào ngữ cảnh này. Về bản chất, hạ gradient là quá trình tối ưu hóa các hệ số bằng cách liên tục giảm lỗi của mô hình trên dữ liệu huấn luyện.
Ngắn gọn hơn, nó khởi đầu với các giá trị ngẫu nhiên cho mỗi hệ số. Tổng sai số bình phương được tính cho từng cặp đầu vào và đầu ra. Một tốc độ học được dùng làm hệ số tỉ lệ, và các hệ số được cập nhật theo hướng làm giảm lỗi. Quá trình lặp lại cho đến khi đạt được tổng sai số bình phương tối thiểu hoặc không thể cải thiện thêm.
Tham số α (tốc độ học) rất quan trọng vì nó quyết định kích thước bước cải thiện ở mỗi vòng lặp.
Hiện có hai biến thể thường gặp của hạ gradient:
Vậy là đủ về hạ gradient cho hướng dẫn này. Giờ, hãy xem một cách khác để tối ưu mô hình hồi quy tuyến tính, tức là Regularization (chuẩn hóa/điều chuẩn).
DataCamp đã có một bài viết nhập môn về Regularization khá hay. Bạn có thể xem trước rồi quay lại bài này.
Nhìn chung, các phương pháp regularization hoạt động bằng cách phạt các hệ số của những đặc trưng có giá trị cực lớn, từ đó cố gắng giảm lỗi. Nó không chỉ giúp giảm lỗi mà còn giảm độ phức tạp mô hình. Điều này đặc biệt hữu ích khi bạn xử lý tập dữ liệu có số lượng đặc trưng lớn và mô hình cơ sở không phân biệt được tầm quan trọng giữa các đặc trưng (không phải mọi đặc trưng đều quan trọng như nhau, đúng không?).
Có hai biến thể regularization cho hồi quy tuyến tính:
Hồi quy Lasso: thêm một hạng phạt tương đương với giá trị tuyệt đối của độ lớn hệ số (còn gọi là điều chuẩn L1). Hạng phạt có dạng: 
trong đó,
Hồi quy Ridge: thêm một hạng phạt tương đương với bình phương độ lớn hệ số (còn gọi là điều chuẩn L2). Hạng phạt có dạng: 
Chẳng phải là có sao? Bạn đã thấy hồi quy tuyến tính giới thiệu khéo léo một số khái niệm cốt lõi của Học máy như hàm chi phí, tối ưu hóa, quan hệ giữa biến và nhiều điều khác. Tất cả những điều này đều quan trọng kể cả khi bạn xây dựng mạng nơ-ron. Tính ứng dụng có thể khác ở một số nơi, nhưng các khái niệm tổng thể vẫn gần như y hệt. Không hiểu những điều nền tảng này, bạn sẽ không thể lý giải vì sao mạng nơ-ron của mình hoạt động kém.
Hơn nữa, một ý tưởng đơn giản về việc suy ra mối quan hệ giữa các biến đã sinh ra rất nhiều khái niệm và quan trọng nhất là tạo ra cả một họ thuật toán mới - Mô hình tuyến tính tổng quát. Vì vậy, với người theo đuổi Khoa học Dữ liệu/Học máy/Trí tuệ nhân tạo, thuật toán này không thể bị bỏ qua. Đến giờ bạn hẳn đã hiểu điều đó!
Giờ, bạn sẽ tự triển khai một hồi quy tuyến tính đơn giản trong Python. Sẽ rất thú vị!
Trong nghiên cứu tình huống này, trước tiên bạn sẽ dùng thư viện Statsmodel cho Python. Đây là thư viện rất phổ biến, cung cấp các lớp và hàm để ước lượng nhiều mô hình thống kê khác nhau, cũng như thực hiện kiểm định thống kê và khám phá dữ liệu thống kê. Về dữ liệu, bạn sẽ dùng bộ Boston House nổi tiếng. scikit-learn có sẵn bộ dữ liệu này, nên bạn không cần tải riêng.
Bắt đầu bằng cách nhập thư viện statsmodels và tập dữ liệu:
import statsmodels.api as sm
from sklearn import datasets

data = datasets.load_boston()
Scikit-learn cung cấp mô tả tiện lợi cho tập dữ liệu, bạn có thể xem bằng:
print (data.DESCR)
Boston House Prices dataset
===========================

Notes
------
Data Set Characteristics:

    :Number of Instances: 506

    :Number of Attributes: 13 numeric/categorical predictive

    :Median Value (attribute 14) is usually the target

    :Attribute Information (in order):
        - CRIM     per capita crime rate by town
        - ZN       proportion of residential land zoned for lots over 25,000 sq.ft.
        - INDUS    proportion of non-retail business acres per town
        - CHAS     Charles River dummy variable (= 1 if tract bounds river; 0 otherwise)
        - NOX      nitric oxides concentration (parts per 10 million)
        - RM       average number of rooms per dwelling
        - AGE      proportion of owner-occupied units built prior to 1940
        - DIS      weighted distances to five Boston employment centres
        - RAD      index of accessibility to radial highways
        - TAX      full-value property-tax rate per $10,000
        - PTRATIO  pupil-teacher ratio by town
        - B        1000(Bk - 0.63)^2 where Bk is the proportion of blacks by town
        - LSTAT    % lower status of the population
        - MEDV     Median value of owner-occupied homes in $1000's

    :Missing Attribute Values: None

    :Creator: Harrison, D. and Rubinfeld, D.L.

This is a copy of UCI ML housing dataset.
http://archive.ics.uci.edu/ml/datasets/Housing


This dataset was taken from the StatLib library which is maintained at Carnegie Mellon University.

The Boston house-price data of Harrison, D. and Rubinfeld, D.L. 'Hedonic
prices and the demand for clean air', J. Environ. Economics & Management,
vol.5, 81-102, 1978.   Used in Belsley, Kuh & Welsch, 'Regression diagnostics
...', Wiley, 1980.   N.B. Various transformations are used in the table on
pages 244-261 of the latter.

The Boston house-price data has been used in many machine learning papers that address regression
problems.

**References**

   - Belsley, Kuh & Welsch, 'Regression diagnostics: Identifying Influential Data and Sources of Collinearity', Wiley, 1980. 244-261.
   - Quinlan, R. (1993). Combining Instance-Based and Model-Based Learning. In Proceedings on the Tenth International Conference of Machine Learning, 236-243, University of Massachusetts, Amherst. Morgan Kaufmann.
   - many more! (see http://archive.ics.uci.edu/ml/datasets/Housing)
Trước khi áp dụng hồi quy tuyến tính, bạn cần chuẩn bị dữ liệu và tách đặc trưng khỏi nhãn. MEDV (giá trị nhà trung vị) là nhãn trong trường hợp này. Bạn có thể truy cập các đặc trưng bằng thuộc tính feature_names.
Một chút kiến thức pandas sẽ hữu ích. Tờ gian lận này rất đáng xem nếu bạn muốn ôn lại các khái niệm cơ bản của pandas.
# Pandas and NumPy import
import numpy as np
import pandas as pd

# Set the features
df = pd.DataFrame(data.data, columns=data.feature_names)

# Set the target
target = pd.DataFrame(data.target, columns=["MEDV"])
Ở thời điểm này, bạn cần cân nhắc vài điều quan trọng về hồi quy tuyến tính trước khi áp dụng vào dữ liệu. Bạn có thể đã học sớm hơn trong hướng dẫn này, nhưng học các yếu tố này ngay lúc này sẽ giúp bạn có cảm nhận thực tế hơn.
Giờ hãy thực hành. Để đơn giản, bạn sẽ chỉ lấy đặc trưng RM — số phòng trung bình. Lưu ý Statsmodels không tự thêm hạng chặn (nhớ hệ số θ0). Hãy xem trước mô hình hồi quy không có hạng chặn:
X = df["RM"]
y = target["MEDV"]

# Fit and make the predictions by the model
model = sm.OLS(y, X).fit()
predictions = model.predict(X)

# Print out the statistics
model.summary()

Kết quả gì thế này! Quá dài để hiểu khi lần đầu nhìn thấy. Hãy đi qua những điểm then chốt:
OLS để huấn luyện mô hình hồi quy tuyến tính. RM tăng 1, giá trị dự đoán của MEDV tăng 3.634. Đây là các điểm quan trọng bạn nên chú ý lúc này (và bạn có thể bỏ qua cảnh báo).
Bạn có thể dễ dàng thêm hạng chặn vào mô hình hồi quy bằng X = sm.add_constant(X) (X là tên DataFrame chứa biến độc lập).
X = sm.add_constant(X)

model = sm.OLS(y, X).fit()
predictions = model.predict(X)

model.summary()

Có thể thấy rõ việc thêm hạng chặn ảnh hưởng trực tiếp đến hệ số. Không có hạng chặn, mô hình của bạn đi qua gốc tọa độ; còn giờ bạn có tung độ gốc là -34.67. Độ dốc của bộ dự đoán RM cũng đổi từ 3.634 thành 9.1021 (coef của RM).
Giờ bạn sẽ khớp một mô hình hồi quy với nhiều hơn một biến — bạn sẽ thêm LSTAT (tỷ lệ dân số có địa vị thấp) cùng với biến RM. Quy trình huấn luyện (fit) giữ nguyên như trước:
X = df[["RM", "LSTAT"]]
y = target["MEDV"]

model = sm.OLS(y, X).fit()
predictions = model.predict(X)

model.summary()

Hãy diễn giải kết quả này:
Mô hình này có giá trị R-squared cao hơn nhiều — 0.948, nghĩa là mô hình nắm bắt được 94.8% phương sai của biến phụ thuộc. Giờ hãy tìm hiểu mối quan hệ giữa hai biến RM và LSTAT với giá nhà trung vị. Khi RM tăng 1, MEDV tăng 4.9069, và khi LSTAT tăng 1, MEDV sẽ giảm 0.6557. Điều này cho thấy RM và LSTAT có ý nghĩa thống kê trong việc dự đoán (hay ước lượng) giá nhà trung vị.
Bạn cũng có thể diễn giải mối quan hệ này bằng ngôn ngữ đời thường:
Giờ thì hợp lý hơn rồi! Phải không?
Đây là ví dụ về hồi quy tuyến tính đơn và bội trong Statsmodels. Bài tập về nhà của bạn là tiếp tục khám phá và diễn giải kết quả với các đặc trưng khác.
Tiếp theo, hãy xem cách triển khai hồi quy tuyến tính bằng chính scikit-learn. Bạn đã nhập sẵn dữ liệu, nhưng cần nhập lớp linear_model.
from sklearn import linear_model
X = df
y = target["MEDV"]

lm = linear_model.LinearRegression()
model = lm.fit(X,y)
Việc huấn luyện mô hình đã hoàn tất. Triển khai sklearn này cũng dùng OLS. Hãy dự đoán một số giá trị MEDV cho năm mẫu đầu tiên.
predictions = lm.predict(X)
print(predictions[0:5])
[30.00821269 25.0298606 30.5702317 28.60814055 27.94288232]
Nếu muốn biết thêm chi tiết (như R-squared, hệ số, v.v.) của mô hình, bạn có thể làm rất dễ.
lm.score(X,y)
0.7406077428649427
lm.coef_
array([-1.07170557e-01,  4.63952195e-02,  2.08602395e-02,  2.68856140e+00,
       -1.77957587e+01,  3.80475246e+00,  7.51061703e-04, -1.47575880e+00,
        3.05655038e-01, -1.23293463e-02, -9.53463555e-01,  9.39251272e-03,
       -5.25466633e-01])
Tuyệt vời! Bạn đã đi đến cuối cùng. Bao quát một trong những thuật toán đơn giản và nền tảng nhất không hề dễ, nhưng bạn đã làm rất tốt. Bạn không chỉ quen thuộc với hồi quy tuyến tính đơn mà còn học được nhiều khía cạnh, thuật ngữ, yếu tố nền tảng của học máy. Bạn cũng đã thực hiện một nghiên cứu tình huống chuyên sâu bằng Python.
Hướng dẫn này cũng có thể là động lực để bạn tự triển khai Hồi quy tuyến tính từ đầu. Sau đây là các bước tóm tắt nếu ai đó muốn làm thật:
Sau đây là một số tài liệu tham khảo được dùng để biên soạn hướng dẫn này:
Nếu bạn muốn học thêm về bộ phân loại tuyến tính, hãy tham gia khóa Linear Classifiers in Python của DataCamp.
Hãy xem Hướng dẫn Phương trình chuẩn cho Hồi quy tuyến tính của chúng tôi.
Khóa học Python
Khóa học
Khóa học
Khóa học
blog
Matt Crabtree
10 phút
