कोर्स
Python परिचय
4 घंटा
7M
डेटा साइंस का क्षेत्र पहले कभी न देखी गई गति से आगे बढ़ा है। यह सांख्यिकी, रैखिक बीजगणित, मशीन लर्निंग, डेटाबेस जैसे कई अलग-अलग क्षेत्रों को समाहित करता है और उन्हें सबसे अर्थपूर्ण तरीके से एक साथ पिरोता है। लेकिन इसके मूल में, आखिर क्या चीज़ इस डोमेन को इतना शक्तिशाली बनाती है? - दमदार सांख्यिकीय एल्गोरिदम
ऐसा ही एक बहुत प्राचीन सांख्यिकीय एल्गोरिदम है रैखिक प्रतिगमन (Linear Regression)। भले ही यह काफ़ी पुराना है, एक उभरते डेटा वैज्ञानिक के रूप में इसे नज़रअंदाज़ करना उचित नहीं है। रैखिक प्रतिगमन के कार्य-तंत्र के सिद्धांत को समझना बहुत ज़रूरी है, क्योंकि इसी से Generalized Linear Models नामक सांख्यिकीय एल्गोरिदमों की पूरी श्रेणी के विकास को समझने में मदद मिलती है। साथ ही, यह आपको किसी सामान्य सांख्यिकीय/मशीन लर्निंग एल्गोरिदम के अन्य पहलू—जैसे लागत फलन (cost functions), गुणांक (coefficients), अनुकूलन (optimization) इत्यादि—समझने में भी मदद करेगा।
जैसा कि इस ट्यूटोरियल के शीर्षक से स्पष्ट है, आप यहाँ रैखिक प्रतिगमन को विस्तार से कवर करेंगे। रैखिक प्रतिगमन के सिद्धांत में गहराई से जाने से पहले, प्रतिगमन (regression) शब्द का अर्थ स्पष्ट कर लें।
प्रतिगमन उन कार्यों की श्रेणी में आता है जिन्हें Supervised Learning कहा जाता है, जहाँ भविष्यवाणी/सांख्यिकीय मॉडलिंग के लिए प्रयुक्त डेटासेट में सतत (continuous) लेबल होते हैं। पर आइए एक प्रतिगमन समस्या को थोड़ा औपचारिक (गणितीय) रूप में परिभाषित करें।
नीचे दी गई तस्वीर पर विचार करें:  स्रोत: Andrew Ng के व्याख्यान नोट्स
तो, ऊपर की छवि में, X उन मानों का समुच्चय है जो विभिन्न घरों के रहने लायक क्षेत्रफल (living area) से संबद्ध हैं (इन्हें इनपुट मानों का स्पेस भी मान सकते हैं) और y संबंधित घरों की कीमत है, पर ध्यान दें कि ये मान h द्वारा अनुमानित हैं। h वह फलन है जो X के मानों को y से निरूपित करता है (अक्सर इसे predictor कहा जाता है)। ऐतिहासिक कारणों से, इस h को hypothesis फलन भी कहा जाता है। ध्यान रहे कि इस डेटासेट में केवल एक फीचर है, यानी अलग-अलग घरों के रहने लायक क्षेत्रफल; समझने की सुविधा के लिए इसे खिलौना (toy) डेटासेट मानें।
ध्यान दें कि यहाँ अनुमानित मान सतत प्रकृति के हैं। अतः आपका अंतिम लक्ष्य है—दिए गए प्रशिक्षण सेट के लिए—एक फलन $h : \mathcal{X} \rightarrow \mathcal{Y}$ सीखना, ताकि h(x) संबंधित y के लिए एक "अच्छा" पूर्वानुमानक हो। साथ ही, X और Y दोनों जिन मानों को स्वीकार करते हैं, उनका डोमेन वास्तविक संख्याएँ हैं; आप इसे यूँ लिख सकते हैं: $\mathcal{X} = \mathcal{Y} = \mathbb{IR}$ जहाँ $\mathbb{IR}$ सभी वास्तविक संख्याओं का समुच्चय है।
युग्म (x(i), y(i)) को प्रशिक्षण उदाहरण (training example) कहते हैं। आप प्रशिक्षण सेट को {(x(i), y(i)) ; i = 1,...,m} के रूप में परिभाषित कर सकते हैं (यदि प्रशिक्षण सेट में m उदाहरण हैं और डेटासेट में केवल एक फीचर x है)।
थोड़ी-सी गणित इसलिए ताकि बुनियादी बातों में भी गलती न हो। Han, Kamber, और Pei के अनुसार—
"सामान्यतः, इन विधियों का उपयोग एक या अधिक पूर्वानुमानक (स्वतंत्र) संख्यात्मक चर से किसी प्रत्युत्तर (आश्रित) संख्यात्मक चर का मान पूर्वानुमानित करने के लिए किया जाता है।" - Data Mining: Concepts and Techniques (3rd edn.)
बिल्कुल सरल!
तो, एक सामान्य प्रतिगमन समस्या को समझते हुए आपने इसके लिए एक hypothesis कैसे परिभाषित करें, यह भी देखा। बढ़िया शुरुआत। अब आप सीधे रैखिक प्रतिगमन की यांत्रिकी में उतरेंगे।
विस्तार में जाने से पहले, यह जान लेना अच्छा होगा कि इसकी खोज कब हुई? यह कहानी 18वीं सदी तक जाती है। महान Carl Friedrich Gauss ने सांख्यिकीय प्रतिगमन के सबसे साधारण रूप का प्रस्ताव रखा था, हालाँकि इस पर मतभेद भी हैं। उन बहसों में न पड़ें। पर यदि आप Gauss और Adrien-Marie Legendre के बीच हुई बहसें देखना चाहें, तो यह लिंक देख सकते हैं।
रैखिक प्रतिगमन आँकड़ों और मशीन लर्निंग में शायद सबसे प्रसिद्ध और सबसे अच्छी तरह समझे गए एल्गोरिदमों में से एक है। इसे पहले सांख्यिकी के क्षेत्र में विकसित किया गया और इनपुट तथा आउटपुट संख्यात्मक चर के बीच संबंध को समझने के मॉडल के रूप में पढ़ा गया; समय के साथ यह आधुनिक मशीन लर्निंग टूलबॉक्स का अभिन्न हिस्सा बन गया है।
इसके लिए एक खिलौना डेटासेट लें। आप फिर से उसी घर-कीमत पूर्वानुमान डेटासेट का उपयोग करेंगे, पर इस बार दो फीचर होंगे। कार्य वही रहेगा—यानी घर की कीमत का पूर्वानुमान।
 स्रोत: Andrew Ng के व्याख्यान नोट्स
जैसा कि पहले बताया गया, अब x द्विविमीय हैं, यानी आपके डेटासेट में दो फीचर हैं। उदाहरण के लिए, प्रशिक्षण सेट के i-वें घर का रहने योग्य क्षेत्रफल x1(i) है, और उसके बेडरूमों की संख्या x2(i) है।
प्रतिगमन करने के लिए आपको यह तय करना होगा कि आप h को कैसे निरूपित करेंगे। प्रारंभिक विकल्प के रूप में मान लें कि आप y को x के एक रैखिक फलन से निकटता से निरूपित करना चाहते हैं:
यहाँ θi वे पैरामीटर (weights भी कहते हैं) हैं जो $\mathcal{X}$ से $\mathcal{Y}$ तक रैखिक फलनों के स्पेस को पैरामीटराइज़ करते हैं। सरल शब्दों में, ये पैरामीटर $\mathcal{X}$ को सटीक रूप से $\mathcal{Y}$ पर मैप करने में प्रयुक्त होते हैं। समझ को सरल रखने के लिए, आप hθ(x) में θ सबस्क्रिप्ट को हटा देंगे, और इसे h(x) ही लिखेंगे। संकेतन और सरल करने के लिए, आप x0 = 1 मानने का प्रचलन भी अपनाएँगे (यह intercept पद है), ताकि

जहाँ दाएँ तरफ आप θ और x दोनों को वेक्टर मान रहे हैं, और यहाँ n इनपुट इंस्टेंसों की संख्या है (x0 को गिने बिना)।
पर अब मुख्य प्रश्न उठता है—आप पैरामीटर θ कैसे चुनें या सीखें? आप तो अपने इनपुट उदाहरण नहीं बदल सकते। आपके पास बस यही θ पैरामीटर हैं जिन्हें समायोजित/ट्यून करना है।
एक प्रमुख तरीका यह है कि h(x) को y के क़रीब लाया जाए, कम से कम आपके पास मौजूद प्रशिक्षण उदाहरणों के लिए। इसे औपचारिक रूप में समझने के लिए, चलिए एक ऐसा फलन परिभाषित करते हैं जो प्रत्येक θ के मान के लिए बताए कि h(x(i)) संबंधित y(i) के कितना निकट है। फलन कुछ इस प्रकार होगा:

स्क्वेयर्ड (वर्ग) मान लेने के पीछे का कारण समझने के लिए, इसे आगे होने वाले प्रशिक्षण संबंधी ऑपरेशनों में लाभदायक मानिए। यदि आप गहराई से जानना चाहें, तो यह देखें।
आपने अभी डेटा साइंस/मशीन लर्निंग/सांख्यिकी की दुनिया के सबसे अहम सूत्रों में से एक देखा। इसे cost function कहा जाता है।
यह एक आवश्यक व्युत्पत्ति है क्योंकि यही रैखिक प्रतिगमन के अगले रूप (Ordinary Least Squares) को जन्म देती है और रैखिक मॉडलिंग एल्गोरिदमों की पूरी श्रेणी की नींव रखती है (याद है आपने Generalized Linear Models शब्द देखा था)।
यह ध्यान रखना महत्वपूर्ण है कि रैखिक प्रतिगमन को अक्सर दो बुनियादी रूपों में बाँटा जाता है:
ये बातें सीधी-सादी हैं, फिर भी अक्सर भ्रम पैदा कर सकती हैं।
आप रैखिक प्रतिगमन की नींव रख चुके हैं। अब आप ऊपर बताए गए पैरामीटरों का अनुमान लगाने के तरीकों के बारे में और जानेंगे। पैरामीटरों का यह अनुमान लगाना मूलतः रैखिक प्रतिगमन का प्रशिक्षण कहलाता है। रैखिक प्रतिगमन मॉडल को प्रशिक्षित करने के कई तरीके हैं, जिनमें Ordinary Least Squares (OLS) सबसे लोकप्रिय है। इसलिए OLS से प्रशिक्षित रैखिक प्रतिगमन मॉडल को Ordinary Least Squares Linear Regression या सिर्फ Least Squares Regression कहना उपयुक्त है।
ध्यान दें कि यहाँ संदर्भ में पैरामीटरों को मॉडल coefficients भी कहा जाता है।
रैखिक प्रतिगमन मॉडल सीखना/प्रशिक्षित करना मूल रूप से अभिव्यक्ति में प्रयुक्त गुणांकों/पैरामीटरों के मानों का, आपके डेटा से, अनुमान लगाना है।
इस खंड में, आप रैखिक प्रतिगमन मॉडल तैयार करने की कुछ तकनीकों पर संक्षेप में नज़र डालेंगे।
पिछले खंड में आपने J(θ) को न्यूनतम करने के लिए θ चुनने की धारणा देखी। ऐसा करने के लिए, एक खोज एल्गोरिदम अपनाएँ जो θ का कोई "प्रारंभिक अनुमान" लेकर शुरू हो, और क्रमिक रूप से θ को बदलकर J(θ) को छोटा करता जाए, जब तक कि आदर्श रूप से आप J(θ) को न्यूनतम करने वाले θ तक न पहुँच जाएँ। विशेष रूप से, gradient descent algorithm पर विचार करें, जो किसी प्रारंभिक θ से शुरू होकर, बार-बार यह अद्यतन करता है:
 स्रोत: Andrew Ng के व्याख्यान नोट्स
(यह अद्यतन j = 0, ... , n के सभी मानों के लिए एक साथ किया जाता है।) यहाँ α को learning rate कहते हैं। यह एक बहुत स्वाभाविक एल्गोरिदम है जो J की तीव्रतम घटाव दिशा में बार-बार एक कदम लेता है। यह α पद प्रभावी रूप से नियंत्रित करता है कि आपका एल्गोरिदम J में गिरावट की दिशा में कितनी तेज़ी से बढ़ेगा। इसे निम्न चित्र से समझा जा सकता है:
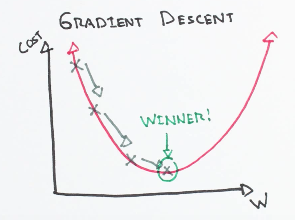 स्रोत: ml-cheatsheet
सहज रूप में, ऊपर का सूत्र J में θj पैरामीटर के सापेक्ष होने वाले छोटे परिवर्तन और उसके θj के प्रारंभिक मान पर प्रभाव को दर्शाता है। लेकिन गौर करें, यहाँ एक आंशिक अवकलज (partial derivative) है। इसका पूरा व्युत्पादन इस ट्यूटोरियल के दायरे से बाहर है।
बस यह नोट करें कि एक एकल प्रशिक्षण उदाहरण के लिए, यह अद्यतन नियम देता है:
 स्रोत: ml-cheatsheet
इसे LMS अपडेट नियम कहा जाता है (LMS = “least mean squares”) और यह Widrow-Hoff learning rule के नाम से भी जाना जाता है।
चलिए OLS के संदर्भ में कुछ बातें समेट लें।
"Ordinary Least Squares प्रक्रिया का लक्ष्य वर्ग अवशेषों (squared residuals) के योग को न्यूनतम करना है। यानी, डेटा पर खींची गई प्रतिगमन रेखा से प्रत्येक डेटा बिंदु की दूरी निकालें, उसका वर्ग करें, और सभी वर्ग त्रुटियों को जोड़ दें। OLS इसी मात्रा को न्यूनतम करने का प्रयास करता है।" - Jason Brownlee
पिछले प्रशिक्षण नियम में, आपने देख लिया कि ग्रेडिएंट डिसेंट को इस संदर्भ में कैसे शामिल किया जा सकता है। मूलतः, ग्रेडिएंट डिसेंट मॉडल की त्रुटि को आपके प्रशिक्षण डेटा पर क्रमिक रूप से घटाते हुए गुणांकों के मानों का अनुकूलन करने की प्रक्रिया है।
संक्षेप में, यह प्रत्येक गुणांक के लिए यादृच्छिक मानों से शुरू करता है। प्रत्येक इनपुट-आउटपुट जोड़े के लिए वर्ग त्रुटियों का योग निकाला जाता है। लर्निंग रेट को एक स्केल फैक्टर के रूप में उपयोग किया जाता है, और गुणांकों को त्रुटि को न्यूनतम करने की दिशा में अद्यतन किया जाता है। यह प्रक्रिया तब तक दोहराई जाती है जब तक न्यूनतम सम-वर्ग त्रुटि न मिल जाए या आगे सुधार संभव न हो।
यहाँ α (लर्निंग रेट) बहुत महत्वपूर्ण है क्योंकि यह प्रक्रिया की प्रत्येक पुनरावृत्ति में लिए जाने वाले सुधारात्मक कदम के आकार को निर्धारित करता है।
अब ग्रेडिएंट डिसेंट के दो सामान्य रूप हैं:
इस ट्यूटोरियल में ग्रेडिएंट डिसेंट के लिए इतना ही काफी है। अब आप रैखिक प्रतिगमन मॉडल को अनुकूलित करने के एक और तरीके पर नज़र डालेंगे—Regularization।
DataCamp पर Regularization का अच्छा परिचयात्मक लेख पहले से मौजूद है। आगे बढ़ने से पहले आप उसे देखना चाहें तो देख सकते हैं।
सामान्यतः, रेग्युलराइज़ेशन विधियाँ अत्यधिक बड़े मान वाले फीचर-कोएफ़िशिएंट्स पर दंड (penalty) लगाकर त्रुटि घटाने का काम करती हैं। इससे न केवल त्रुटि दर बेहतर होती है, बल्कि मॉडल जटिलता भी घटती है। यह विशेष रूप से तब उपयोगी है जब आप बहुत अधिक फीचर्स वाले डेटासेट से निपट रहे हों, और आपका बेसलाइन मॉडल फीचर्स के महत्व में भेद नहीं कर पा रहा हो (किसी भी डेटासेट के सभी फीचर समान रूप से महत्वपूर्ण नहीं होते, है ना?).
रैखिक प्रतिगमन के लिए रेग्युलराइज़ेशन की दो विधियाँ हैं:
Lasso Regression: इसमें दंड पद जोड़ा जाता है जो गुणांकों के परिमाण (magnitude) के परिमित मान (absolute value) के समतुल्य होता है (इसे L1 regularization भी कहते हैं)। दंड पद इस प्रकार दिखता है: 
जहाँ,
Ridge Regression: इसमें दंड पद जोड़ा जाता है जो गुणांकों के परिमाण के वर्ग के समतुल्य होता है (इसे L2 regularization भी कहते हैं)। दंड पद इस प्रकार दिखता है: 
क्यों नहीं? आपने देखा कि रैखिक प्रतिगमन कितनी खूबी से मशीन लर्निंग की कुछ अहम संकल्पनाएँ—जैसे cost functions, optimization, चरों के संबंध, आदि—परिचित कराता है। ये सारी बातें तब भी महत्वपूर्ण हैं जब आप एक neural network बना रहे हों। लागू होने का तरीका कुछ जगह अलग हो सकता है, पर मूल अवधारणाएँ ज्यों की त्यों रहती हैं। अतः इन बुनियादी बातों को समझे बिना आप यह नहीं समझ पाएँगे कि आपका न्यूरल नेट ठीक से प्रदर्शन क्यों नहीं कर रहा।
साथ ही, चरों के बीच संबंध निकालने जैसी सरल अवधारणा ने असंख्य विचारों को जन्म दिया और सबसे बढ़कर—Generalized Linear Models—नामक एल्गोरिदमों का नया परिवार रचा। अतः एक आकांक्षी Data Science/Machine Learning/Artificial Intelligence प्रैक्टिशनर के लिए यह एल्गोरिदम नज़रअंदाज़ करने लायक नहीं है। यह बात अब तक आप समझ ही चुके होंगे!
अब, आप Python में खुद एक सरल रैखिक प्रतिगमन लागू करेंगे। मज़ा आएगा!
इस केस स्टडी के लिए पहले आप Python की Statsmodel लाइब्रेरी का उपयोग करेंगे। यह एक लोकप्रिय लाइब्रेरी है जो विभिन्न सांख्यिकीय मॉडलों के अनुमान, सांख्यिकीय परीक्षणों और डेटा अन्वेषण के लिए क्लास और फ़ंक्शंस प्रदान करती है। डेटा के लिए, आप प्रसिद्ध Boston House डेटासेट का उपयोग करेंगे। शक्तिशाली scikit-learn के साथ यह डेटासेट आता है, इसलिए आपको इसे अलग से डाउनलोड करने की आवश्यकता नहीं।
आइए statsmodels लाइब्रेरी और अपना डेटासेट इम्पोर्ट करके केस स्टडी शुरू करें:
import statsmodels.api as sm
from sklearn import datasets

data = datasets.load_boston()
Scikit-learn डेटासेट का एक सुविधाजनक विवरण देता है, जिसे आप आसानी से यूँ देख सकते हैं:
print (data.DESCR)
Boston House Prices dataset
===========================

Notes
------
Data Set Characteristics:

    :Number of Instances: 506

    :Number of Attributes: 13 numeric/categorical predictive

    :Median Value (attribute 14) is usually the target

    :Attribute Information (in order):
        - CRIM     per capita crime rate by town
        - ZN       proportion of residential land zoned for lots over 25,000 sq.ft.
        - INDUS    proportion of non-retail business acres per town
        - CHAS     Charles River dummy variable (= 1 if tract bounds river; 0 otherwise)
        - NOX      nitric oxides concentration (parts per 10 million)
        - RM       average number of rooms per dwelling
        - AGE      proportion of owner-occupied units built prior to 1940
        - DIS      weighted distances to five Boston employment centres
        - RAD      index of accessibility to radial highways
        - TAX      full-value property-tax rate per $10,000
        - PTRATIO  pupil-teacher ratio by town
        - B        1000(Bk - 0.63)^2 where Bk is the proportion of blacks by town
        - LSTAT    % lower status of the population
        - MEDV     Median value of owner-occupied homes in $1000's

    :Missing Attribute Values: None

    :Creator: Harrison, D. and Rubinfeld, D.L.

This is a copy of UCI ML housing dataset.
http://archive.ics.uci.edu/ml/datasets/Housing


This dataset was taken from the StatLib library which is maintained at Carnegie Mellon University.

The Boston house-price data of Harrison, D. and Rubinfeld, D.L. 'Hedonic
prices and the demand for clean air', J. Environ. Economics & Management,
vol.5, 81-102, 1978.   Used in Belsley, Kuh & Welsch, 'Regression diagnostics
...', Wiley, 1980.   N.B. Various transformations are used in the table on
pages 244-261 of the latter.

The Boston house-price data has been used in many machine learning papers that address regression
problems.

**References**

   - Belsley, Kuh & Welsch, 'Regression diagnostics: Identifying Influential Data and Sources of Collinearity', Wiley, 1980. 244-261.
   - Quinlan, R. (1993). Combining Instance-Based and Model-Based Learning. In Proceedings on the Tenth International Conference of Machine Learning, 236-243, University of Massachusetts, Amherst. Morgan Kaufmann.
   - many more! (see http://archive.ics.uci.edu/ml/datasets/Housing)
अब, रैखिक प्रतिगमन लागू करने से पहले, आपको डेटा तैयार करना होगा और डेटासेट के फीचर्स और लेबल को अलग करना होगा। इस मामले में MEDV (median home value) लेबल है। आप डेटासेट के फीचर्स को feature_names ऐट्रिब्यूट से एक्सेस कर सकते हैं।
यहाँ थोड़ी-सी pandas जानकारी काम आएगी। बुनियादी pandas अवधारणाओं को ताज़ा करने के लिए यह चीट शीट ज़रूर देखें।
# Pandas और NumPy इम्पोर्ट
import numpy as np
import pandas as pd

# फीचर्स सेट करें
df = pd.DataFrame(data.data, columns=data.feature_names)

# टार्गेट सेट करें
target = pd.DataFrame(data.target, columns=["MEDV"])
इस बिंदु पर, रैखिक प्रतिगमन को डेटा पर लागू करने से पहले आपको कुछ महत्वपूर्ण बातों पर विचार करना होगा। आप इन्हें इससे पहले भी पढ़ सकते थे, पर इन्हें यहीं पढ़ना व्यावहारिक समझ देगा।
अब कुछ हाथ-कलम अभ्यास करें। सरल रखने के लिए आप अभी केवल RM — औसत कमरों की संख्या फीचर लेंगे। ध्यान दें कि Statsmodels डिफ़ॉल्ट रूप से constant पद (याद करें θ0) नहीं जोड़ता। पहले अपने प्रतिगमन मॉडल में बिना constant के देखें:
X = df["RM"]
y = target["MEDV"]

# मॉडल फिट करें और भविष्यवाणियाँ लें
model = sm.OLS(y, X).fit()
predictions = model.predict(X)

# आँकड़े प्रिंट करें
model.summary()

यह आउटपुट क्या है! पहली बार देखने पर यह बहुत बड़ा लग सकता है। आइए चरणबद्ध तरीके से सबसे अहम बिंदुओं को समझें:
OLS विधि इस्तेमाल कर रहे हैं। RM चर 1 से बढ़ता है, तो MEDV का पूर्वानुमानित मान 3.634 से बढ़ेगा। फिलहाल के लिए ये सबसे ज़रूरी बिंदु हैं (और आप चेतावनी को नज़रअंदाज़ कर सकते हैं)।
रैखिक प्रतिगमन मॉडल में constant पद आसानी से जोड़ा जा सकता है—आप X = sm.add_constant(X) कर सकते हैं (X वह डेटाफ़्रेम है जिसमें इनपुट/स्वतंत्र चर हैं)।
X = sm.add_constant(X)

model = sm.OLS(y, X).fit()
predictions = model.predict(X)

model.summary()

स्पष्ट दिखता है कि constant पद जोड़ने का गुणांक पर सीधा असर पड़ा है। बिना constant के आपका मॉडल उद्गम (origin) से गुजर रहा था, पर अब y-अवरोध (-34.67) है। अब RM predictor का ढाल (slope) भी 3.634 से बदलकर 9.1021 (RM का coef) हो गया है।
अब आप एक से अधिक चर के साथ प्रतिगमन मॉडल फिट करेंगे—आप RM के साथ LSTAT (जनसंख्या की निम्न स्थिति का प्रतिशत) भी जोड़ेंगे। मॉडल प्रशिक्षण (फिटिंग) की प्रक्रिया पहले जैसी ही रहेगी:
X = df[["RM", "LSTAT"]]
y = target["MEDV"]

model = sm.OLS(y, X).fit()
predictions = model.predict(X)

model.summary()

अब इसका अर्थ निकालते हैं:
इस मॉडल का R-squared मूल्य काफ़ी अधिक—0.948—है, जिसका मतलब है कि यह मॉडल आश्रित चर में 94.8% विचरण को कैप्चर करता है। अब, RM और LSTAT का median house value से संबंध देखें। जैसे ही RM 1 से बढ़ेगा, MEDV 4.9069 से बढ़ेगा, और जब LSTAT 1 से बढ़ेगा, तो MEDV 0.6557 से घटेगा। यह दर्शाता है कि median house value के पूर्वानुमान (या आकलन) में RM और LSTAT सांख्यिकीय रूप से महत्वपूर्ण हैं।
आप इस संबंध को सरल हिंदी में यूँ भी कह सकते हैं:
अब बात और अर्थपूर्ण लग रही है, है ना?
यह Statsmodels में एकल और बहु-रैखिक प्रतिगमन—दोनों—का उदाहरण था। आपका गृहकार्य है कि अन्य फीचर्स के साथ परिणामों की जाँच और व्याख्या करें।
अब देखते हैं कि आपका अपना scikit-learn उपयोग करके रैखिक प्रतिगमन कैसे लागू किया जा सकता है। आपने डेटासेट पहले ही इम्पोर्ट कर लिया है, पर linear_model क्लास इम्पोर्ट करनी होगी।
from sklearn import linear_model
X = df
y = target["MEDV"]

lm = linear_model.LinearRegression()
model = lm.fit(X,y)
मॉडल प्रशिक्षण पूरा हुआ। यह sklearn इम्प्लीमेंटेशन भी OLS का उपयोग करता है। आइए पहले पाँच नमूनों के लिए MEDV मानों की कुछ भविष्यवाणियाँ करते हैं।
predictions = lm.predict(X)
print(predictions[0:5])
[30.00821269 25.0298606 30.5702317 28.60814055 27.94288232]
यदि आप अपने मॉडल की कुछ और जानकारियाँ (जैसे R-squared, coefficients, आदि) देखना चाहें, तो यह भी आसानी से कर सकते हैं।
lm.score(X,y)
0.7406077428649427
lm.coef_
array([-1.07170557e-01,  4.63952195e-02,  2.08602395e-02,  2.68856140e+00,
       -1.77957587e+01,  3.80475246e+00,  7.51061703e-04, -1.47575880e+00,
        3.05655038e-01, -1.23293463e-02, -9.53463555e-01,  9.39251272e-03,
       -5.25466633e-01])
शानदार! आप अंत तक पहुँच गए। सबसे सरल और बुनियादी एल्गोरिदमों में से एक को कवर करना आसान नहीं था, पर आपने बखूबी किया। आपने न केवल सरल रैखिक प्रतिगमन से परिचय पाया, बल्कि मशीन लर्निंग के कई बुनियादी पहलुओं, शब्दों और कारकों का भी अध्ययन किया। आपने Python में एक गहन केस स्टडी भी की।
यह ट्यूटोरियल आपको Linear Regression को शुरुआत से स्वयं लागू करने की प्रेरणा भी दे सकता है। यदि कोई सचमुच करना चाहे, तो संक्षेप में चरण इस प्रकार हैं:
इस ट्यूटोरियल को तैयार करने में निम्न संदर्भों का उपयोग किया गया:
यदि आप linear classifiers के बारे में और सीखना चाहें, तो DataCamp का Linear Classifiers in Python कोर्स लें।
हमारा Normal Equation for Linear Regression Tutorial भी देखें।
Python कोर्स
कोर्स
कोर्स
कोर्स