Kurs
Python’a Giriş
4 sa
7M
Veri Bilimi alanı eşi benzeri görülmemiş bir hızla ilerledi. İstatistik, Lineer Cebir, Makine Öğrenmesi, Veritabanları gibi pek çok farklı alanı bünyesinde toplar ve bunları mümkün olan en anlamlı şekilde bir araya getirir. Peki, özünde bu alanı bu kadar çarpıcı kılan nedir? - Güçlü istatistiksel algoritmalar
Bu tür çok ilkel istatistiksel algoritmalardan biri Doğrusal Regresyondur. Çok eski olmasına rağmen, sizin gibi yeni yetişen bir veri bilimci için asla görmezden gelinecek kadar eski değildir. Doğrusal regresyonun çalışma prensibini anlamak, Genelleştirilmiş Doğrusal Modeller olarak adlandırılan bir bütün istatistiksel algoritma sınıfının evrimini gerekçelendirmek açısından çok önemlidir. Ayrıca, tipik bir istatistiksel/makine öğrenmesi algoritmasının diğer yönlerini, örneğin maliyet fonksiyonları, katsayılar, optimizasyon vb. anlamanıza da yardımcı olur.
Bu eğitimin başlığının da belirttiği gibi, bu derste Doğrusal Regresyonu ayrıntılı olarak ele alacaksınız. Doğrusal Regresyonun arkasındaki teorilere dalmadan önce, regresyon terimine net bir bakış atalım.
Regresyon, öngörücü/istatistiksel modelleme için kullanılan veri kümelerinin sürekli etiketler içerdiği Denetimli Öğrenme görevleri sınıfına aittir. Ancak, bir regresyon problemini daha matematiksel olarak tanımlayalım.
Aşağıdaki görseli ele alalım:  Kaynak: Andrew Ng’nin ders notları
Yukarıdaki görselde, X çeşitli evlerin yaşam alanlarına karşılık gelen değerler kümesidir (aynı zamanda girdi değerleri uzayı olarak da kabul edilir) ve y ilgili evlerin fiyatıdır; ancak bu değerlerin h tarafından tahmin edildiğine dikkat edin. h, X değerlerini y’ye eşleyen (çoğunlukla öngörücü olarak anılan) bir fonksiyondur. Tarihsel nedenlerle bu h, bir hipotez fonksiyonu olarak anılır. Bu veri kümesinin yalnızca tek bir özelliğe, yani çeşitli evlerin yaşam alanlarına sahip olduğunu ve konuyu anlamak adına bunun bir oyuncak veri kümesi olduğunu aklınızda tutun.
Burada tahmin edilen değerlerin sürekli olduğuna dikkat edin. Dolayısıyla nihai amacınız, bir eğitim seti verildiğinde, h(x)’in y’nin karşılık gelen değeri için “iyi” bir öngörücü olacağı şekilde $h : \mathcal{X} \rightarrow \mathcal{Y}$ fonksiyonunu öğrenmektir. Ayrıca, hem X hem de Y’nin kabul ettiği değerlerin tanım kümesinin tüm reel sayılar olduğunu ve bunu şu şekilde tanımlayabileceğinizi aklınızda bulundurun: $\mathcal{X} = \mathcal{Y} = \mathbb{IR}$; burada $\mathbb{IR}$ tüm reel sayıların kümesidir.
Bir (x(i), y(i)) çifti bir eğitim örneği olarak adlandırılır. Eğitim setini {(x(i), y(i)) ; i = 1,...,m} olarak tanımlayabilirsiniz (eğitim setinin m örnek içerdiği ve veri kümesinde yalnızca bir özellik x olduğu durumda).
En basit şeylerde bile hata yapmamanız için biraz matematik. Han, Kamber ve Pei’ye göre -
"Genel olarak, bu yöntemler, değişkenlerin sayısal olduğu bir veya daha fazla öngörücü (bağımsız) değişkenden bir yanıt (bağımlı) değişkeninin değerini tahmin etmek için kullanılır." - Data Mining: Concepts and Techniques (3. baskı)
İşte bu kadar basit!
Dolayısıyla, tipik bir regresyon problemini anlamaya çalışırken, aynı zamanda onun için bir hipotezin nasıl tanımlanacağını da gördünüz. Harika gidiyorsunuz. Tam havasına girdiniz! Şimdi doğrudan Doğrusal Regresyonun işleyişine dalacaksınız.
Ayrıntılarına girmeden önce, ne zaman keşfedildiğine bir bakmak iyi olmaz mı? Bu, 18. yüzyıla kadar uzanır. Güçlü Carl Friedrich Gauss, istatistiksel regresyonun en temel biçimini ilk öneren kişidir; ancak bununla ilgili pek çok tartışma vardır. Onlara girmeyelim. Yine de Gauss ile Adrien-Marie Legendre arasında bu konuda yaşanan tartışmaları görmek isterseniz, bakabileceğiniz bağlantı burada.
Doğrusal regresyon, istatistik ve makine öğrenmesindeki en bilinen ve en iyi anlaşılan algoritmalardan biridir. Doğrusal regresyon istatistik alanında geliştirilmiş ve girdi ile çıktı sayısal değişkenleri arasındaki ilişkiyi anlamak için bir model olarak incelenmiştir; ancak zamanla modern makine öğrenmesi araç setinin ayrılmaz bir parçası haline gelmiştir.
Bunun için bir oyuncak veri kümesi ele alalım. Aynı konut fiyatı tahmini veri setini inceleyeceksiniz, ancak bu kez iki özellik ile. Görev aynı kalıyor; yani ev fiyatını tahmin etmek.
 Kaynak: Andrew Ng’nin ders notları
Daha önce belirtildiği gibi, artık x’ler iki boyutludur; bu da veri kümenizin iki özellik içerdiği anlamına gelir. Örneğin, x1(i), eğitim setindeki i’inci evin yaşam alanı, x2(i) ise yatak odası sayısıdır.
Regresyon uygulamak için, h’yi nasıl temsil edeceğinize karar vermelisiniz. Başlangıç seçimi olarak, y’yi x’in doğrusal bir fonksiyonu olarak yaklaştırmaya karar verdiğinizi varsayalım:
Burada, θi’ler $\mathcal{X}$ uzayından $\mathcal{Y}$ uzayına eşleyen doğrusal fonksiyonlar uzayını parametreleyen parametrelerdir (ağırlıklar olarak da adlandırılır). Daha basit bir ifadeyle, bu parametreler $\mathcal{X}$’i $\mathcal{Y}$’ye doğru şekilde eşlemek için kullanılır. Ancak anlamayı kolaylaştırmak için hθ(x) ifadesindeki θ alt simgesini düşürecek ve bunu basitçe h(x) olarak yazacaksınız. Gösterimi daha da basitleştirmek için x0 = 1 (bu kesme terimidir) şeklinde bir kural da tanıtacaksınız; böylece

burada sağ tarafta θ ve x’i vektörler olarak ele alıyorsunuz ve n, girdi örneklerinin sayısıdır (x0 hariç).
Ancak bu noktada ortaya çıkan asıl soru, θ parametrelerini nasıl seçeceğiniz veya öğreneceğinizdir. Fiyatları tahmin etmek için girdi örneklerinizi değiştiremezsiniz. Ayarlayabileceğiniz tek şey bu θ parametreleridir.
Öne çıkan yöntemlerden biri, en azından elinizdeki eğitim örnekleri için h(x)’i y’ye yakın yapmaktır. Bunu daha resmi olarak anlamak için, her θ değeri için h(x(i))’lerin karşılık gelen y(i)’lere ne kadar yakın olduğunu belirleyen bir fonksiyon tanımlamayı deneyelim. Fonksiyon aşağıdaki gibi olmalıdır:

Kare terimin mutlak değer yerine alınmasının nedenini anlamak için, bu kare terimini regresyon modelini eğitmek için gerçekleştirilecek sonraki işlemler açısından bir avantaj olarak düşünün. Daha derine inmek isterseniz, buradan devam edebilirsiniz.
Az önce Veri Bilimi/Makine Öğrenmesi/İstatistik dünyasındaki en önemli formüllerden birini gördünüz. Buna maliyet fonksiyonu denir.
Bu, yalnızca doğrusal regresyonun bir sonraki evrimine (En Küçük Kareler) hayat verdiği için değil, aynı zamanda bir bütün doğrusal modelleme algoritmaları sınıfının temellerini attığı için de kritik bir türetmedir (hatırlayın, Genelleştirilmiş Doğrusal Modeller diye bir terime rastlamıştınız).
Şunu not etmek önemlidir: doğrusal regresyon sıklıkla iki temel biçime ayrılabilir:
Bunlar çok basit görünebilir ama sık sık kafa karıştırabilir.
Doğrusal regresyonun temellerini zaten attınız. Şimdi yukarıdaki bölümde gördüğünüz parametreleri tahmin etmenin yolları hakkında daha fazla bilgi edineceksiniz. Bu parametre tahmini esasen doğrusal regresyonun eğitimi olarak bilinir. Doğrusal bir regresyon modelini eğitmenin birden çok yöntemi vardır; bunlar arasında en popüleri En Küçük Kareler (OLS)’tir. Bu nedenle, OLS kullanılarak eğitilmiş bir doğrusal regresyon modeline En Küçük Kareler Doğrusal Regresyonu veya kısaca En Küçük Kareler Regresyonu demek yerinde olur.
Buradaki bağlamda parametrelerin aynı zamanda model katsayıları olarak da adlandırıldığını not edin.
Bir doğrusal regresyon modelini öğrenmek/eğitmek, elinizdeki verilerle gösterimde kullanılan katsayıların/parametrelerin değerlerini tahmin etmek anlamına gelir.
Bu bölümde, bir doğrusal regresyon modelini hazırlamak için bazı tekniklere kısaca göz atacaksınız.
Önceki bölümü, J(θ)'yı en aza indirecek şekilde θ seçme fikriyle bitirmiştiniz. Bunu yapmak için, θ için bazı “başlangıç tahmini” ile başlayan ve θ’yı yinelemeli olarak değiştirerek J(θ)'yı küçülten, umarız J(θ)'yı en aza indiren bir θ değerine yakınsayan bir arama algoritması kullanalım. Özellikle, bazı başlangıç θ ile başlayan ve tekrarlayan şekilde aşağıdaki güncellemeyi yapan gradyan inişi algoritmasını ele alalım:
 Kaynak: Andrew Ng’nin ders notları
(Bu güncelleme j = 0, . . . , n için aynı anda gerçekleştirilir.) Burada α öğrenme oranı olarak adlandırılır. Bu, J’nin en dik azalış yönünde adım atan son derece doğal bir algoritmadır. Bu α terimi, algoritmanızın J’nin azalması yönünde ne kadar dik hareket edeceğini etkin biçimde kontrol eder. Bu, aşağıdaki gibi görsel olarak ifade edilebilir:
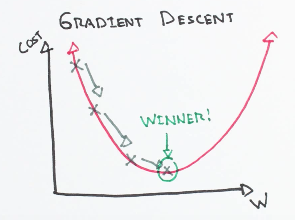 Kaynak: ml-cheatsheet
Sezgisel olarak konuşursak, yukarıdaki formül J’de θj parametresine göre olan küçük değişimi ve bunun θj’nin başlangıç değerini nasıl etkilediğini ifade eder. Ancak dikkat edin, burada uğraşmanız gereken bir kısmi türev var. Tüm türetme süreci bu eğitimin kapsamı dışındadır.
Tek bir eğitim örneği için güncelleme kuralının şu şekilde olduğunu not edin:
 Kaynak: ml-cheatsheet
Bu kurala LMS güncelleme kuralı denir (LMS, “least mean squares”ın kısaltmasıdır) ve Widrow-Hoff öğrenme kuralı olarak da bilinir.
OLS bağlamında birkaç şeyi özetleyelim.
"En Küçük Kareler prosedürü, artıkların karelerinin toplamını en aza indirmeye çalışır. Bu, veri boyunca bir regresyon doğrusu verildiğinde, her veri noktasından regresyon doğrusuna olan mesafeyi hesapladığımız, bunu kareye aldığımız ve tüm kare hataları topladığımız anlamına gelir. En küçük karelerin en aza indirmeye çalıştığı nicelik budur." - Jason Brownlee
Önceki eğitim kuralında, gradyan inişinin bu bağlamda nasıl yer alabileceğine dair fikri zaten edindiniz. Özünde, gradyan inişi, modelinizin eğitim verilerindeki hatayı yinelemeli olarak en aza indirerek katsayı değerlerini optimize etme sürecidir.
Daha kısaca, her katsayı için rastgele değerlerle başlayarak çalışır. Her girdi-çıktı çifti için kare hataların toplamı hesaplanır. Bir öğrenme oranı bir ölçek faktörü olarak kullanılır ve hata en aza inecek yönde katsayılar güncellenir. Bu süreç, en düşük kare hata toplamı elde edilene veya daha fazla iyileşme mümkün olmayana kadar tekrarlanır.
α (öğrenme oranı) terimi burada çok önemlidir; çünkü prosedürün her yinelemesinde yapılacak iyileştirme adımının büyüklüğünü belirler.
Şimdi gradyan inişinin yaygın olarak iki çeşidi vardır:
Bu eğitim için gradyan inişi bu kadar. Şimdi, bir doğrusal regresyon modelini optimize etmenin başka bir yoluna, yani Düzenlileştirmeye bakalım.
DataCamp’te zaten Düzenlileştirme üzerine iyi bir giriş yazısı var. Buna geçmeden önce göz atmak isteyebilirsiniz.
Genel olarak, düzenlileştirme yöntemleri, aşırı büyük değerlere sahip özelliklerin katsayılarını cezalandırarak hatayı azaltmaya çalışır. Bu yalnızca hata oranını iyileştirmekle kalmaz, aynı zamanda model karmaşıklığını da azaltır. Özellikle çok sayıda özelliğe sahip bir veri kümesiyle uğraşırken ve temel modeliniz özelliklerin önemlerini ayırt etmekte zorlanırken faydalıdır (bir veri kümesindeki tüm özellikler eşit derecede önemli değildir, değil mi?).
Doğrusal regresyon için iki düzenlileştirme çeşidi vardır:
Lasso Regresyonu: katsayıların büyüklüğünün mutlak değerine eşdeğer bir ceza terimi ekler ( L1 düzenlileştirme olarak da adlandırılır). Ceza terimi şöyledir: 
burada,
Ridge Regresyonu: katsayıların büyüklüğünün karesine eşdeğer bir ceza terimi ekler (L2 düzenlileştirme olarak da adlandırılır). Ceza terimi şöyledir: 
Değmez mi? Doğrusal regresyonun, maliyet fonksiyonları, optimizasyon, değişken ilişkileri gibi Makine Öğrenmesinin en kritik kavramlarını ne kadar zarif bir şekilde tanıttığını zaten gördünüz. Tüm bu şeyler, bir sinir ağı kuruyor olsanız bile hayati önemdedir. Uygulama bazı yerlerde farklı olabilir, ancak genel kavramlar tam olarak aynıdır. Dolayısıyla bu temel şeyleri anlamadan, sinir ağınızın neden iyi performans göstermediğini asla gerekçelendiremezsiniz.
Dahası, değişkenler arasındaki ilişkileri türetmeye yönelik basit bir kavram, pek çok fikri doğurdu ve en önemlisi yeni bir algoritma ailesi yarattı - Genelleştirilmiş Doğrusal Modeller. Bu nedenle, hevesli bir Veri Bilimi/Makine Öğrenmesi/Yapay Zekâ uygulayıcısı için bu algoritma göz ardı edilemez. Bunu artık anladınız!
Haydi şimdi Python’da basit bir doğrusal regresyonu kendiniz uygulayın. Eğlenceli olacak!
Bu vaka çalışması için önce Python’daki Statsmodel kütüphanesini kullanacaksınız. Pek çok farklı istatistiksel modelin tahmini için sınıflar ve fonksiyonlar sağlayan, ayrıca istatistiksel testler ve istatistiksel veri keşfi sunan çok popüler bir kütüphanedir. Veri olarak ünlü Boston Konut veri setini kullanacaksınız. Güçlü scikit-learn bu veri setiyle birlikte gelir; ayrı indirmenize gerek yok.
Vaka çalışmasına statsmodels kütüphanesini ve veri setinizi içe aktararak başlayalım:
import statsmodels.api as sm
from sklearn import datasets

data = datasets.load_boston()
Scikit-learn, veri kümesinin kullanışlı bir açıklamasını sağlar ve buna kolayca şu şekilde bakılabilir:
print (data.DESCR)
Boston House Prices dataset
===========================

Notes
------
Data Set Characteristics:

    :Number of Instances: 506

    :Number of Attributes: 13 numeric/categorical predictive

    :Median Value (attribute 14) is usually the target

    :Attribute Information (in order):
        - CRIM     per capita crime rate by town
        - ZN       proportion of residential land zoned for lots over 25,000 sq.ft.
        - INDUS    proportion of non-retail business acres per town
        - CHAS     Charles River dummy variable (= 1 if tract bounds river; 0 otherwise)
        - NOX      nitric oxides concentration (parts per 10 million)
        - RM       average number of rooms per dwelling
        - AGE      proportion of owner-occupied units built prior to 1940
        - DIS      weighted distances to five Boston employment centres
        - RAD      index of accessibility to radial highways
        - TAX      full-value property-tax rate per $10,000
        - PTRATIO  pupil-teacher ratio by town
        - B        1000(Bk - 0.63)^2 where Bk is the proportion of blacks by town
        - LSTAT    % lower status of the population
        - MEDV     Median value of owner-occupied homes in $1000's

    :Missing Attribute Values: None

    :Creator: Harrison, D. and Rubinfeld, D.L.

This is a copy of UCI ML housing dataset.
http://archive.ics.uci.edu/ml/datasets/Housing


This dataset was taken from the StatLib library which is maintained at Carnegie Mellon University.

The Boston house-price data of Harrison, D. and Rubinfeld, D.L. 'Hedonic
prices and the demand for clean air', J. Environ. Economics & Management,
vol.5, 81-102, 1978.   Used in Belsley, Kuh & Welsch, 'Regression diagnostics
...', Wiley, 1980.   N.B. Various transformations are used in the table on
pages 244-261 of the latter.

The Boston house-price data has been used in many machine learning papers that address regression
problems.

**References**

   - Belsley, Kuh & Welsch, 'Regression diagnostics: Identifying Influential Data and Sources of Collinearity', Wiley, 1980. 244-261.
   - Quinlan, R. (1993). Combining Instance-Based and Model-Based Learning. In Proceedings on the Tenth International Conference of Machine Learning, 236-243, University of Massachusetts, Amherst. Morgan Kaufmann.
   - many more! (see http://archive.ics.uci.edu/ml/datasets/Housing)
Şimdi, doğrusal regresyonu uygulamadan önce veriyi hazırlamanız ve veri kümesinin özelliklerini ve etiketini ayırmanız gerekecek. Bu durumda etiket MEDV’dir (medyan konut değeri). Veri kümesinin özelliklerine feature_names özniteliğiyle erişebilirsiniz.
Biraz pandas bilgisi burada işinize yarar. Temel pandas kavramlarını tazelemek için bu hızlı başvuru mutlaka görülmeli.
# Pandas and NumPy import
import numpy as np
import pandas as pd

# Set the features
df = pd.DataFrame(data.data, columns=data.feature_names)

# Set the target
target = pd.DataFrame(data.target, columns=["MEDV"])
Bu noktada, doğrusal regresyonu veriye uygulamadan önce dikkate almanız gereken birkaç önemli husus vardır. Bunları daha önce de çalışabilirdiniz; ancak tam bu noktada incelemek, konunun özünü daha iyi hissetmenize yardımcı olacaktır.
Şimdi biraz uygulamalı çalışma yapalım. İşleri basit tutmak için şimdilik yalnızca RM — ortalama oda sayısı özelliğini alacaksınız. Statsmodels’ın varsayılan olarak sabit terimi (theta0 faktörünü hatırlayın) eklemediğine dikkat edin. Önce regresyon modelinizde sabit terim olmadan görelim:
X = df["RM"]
y = target["MEDV"]

# Fit and make the predictions by the model
model = sm.OLS(y, X).fit()
predictions = model.predict(X)

# Print out the statistics
model.summary()

Bu çıktı da ne böyle! İlk kez gördüğünüzde anlamak için fazla büyük. En kritik noktaları adım adım gözden geçirelim:
OLS yöntemini kullandığınıza dair ilk gözlemi yapmalısınız. RM değişkeni 1 artarsa, MEDV’nin tahmin edilen değerinin 3.634 artacağı anlamına gelir. Şimdilik dikkat etmeniz gereken en önemli noktalar bunlar (uyarıyı da görmezden gelebilirsiniz).
Doğrusal regresyon modeline sabit terim eklemek kolaydır. Bunu X = sm.add_constant(X) ile yapabilirsiniz (X, girdi (bağımsız değişkenler) içeren veri çerçevesinin adıdır).
X = sm.add_constant(X)

model = sm.OLS(y, X).fit()
predictions = model.predict(X)

model.summary()

Sabit terimin eklenmesinin katsayı terimi üzerinde doğrudan bir etkisi olduğu açıkça görülüyor. Sabit terim olmadan modeliniz orijinden geçiyordu; ancak şimdi -34.67’de bir y-kesişiminiz var. Ayrıca RM öngörücüsünün eğimi de 3.634’ten 9.1021’e değişti (RM’nin coef değeri).
Şimdi birden fazla değişkenle bir regresyon modeli kuracaksınız — RM değişkenine ek olarak LSTAT’ı (nüfusun düşük statüdeki yüzdesi) ekleyeceksiniz. Model eğitimi (uydurma) prosedürü öncekiyle tamamen aynıdır:
X = df[["RM", "LSTAT"]]
y = target["MEDV"]

model = sm.OLS(y, X).fit()
predictions = model.predict(X)

model.summary()

Şimdi bunu yorumlayalım:
Bu model çok daha yüksek bir R-kare değerine sahiptir — 0.948; bu, modelin bağımlı değişkendeki varyansın %94.8’ini yakaladığı anlamına gelir. Şimdi RM ve LSTAT adlı iki değişken ile medyan konut değeri arasındaki ilişkiyi anlamaya çalışalım. RM 1 arttığında, MEDV 4.9069 artacaktır; LSTAT 1 arttığında ise MEDV 0.6557 azalacaktır. Bu, medyan konut değerini tahmin (veya kestirmek) açısından RM ve LSTAT’ın istatistiksel olarak anlamlı olduğunu gösterir.
Bu ilişkiyi sade bir dille de yorumlayabilirsiniz:
Şimdi daha anlamlı geliyor! Öyle değil mi?
Bu, Statsmodels’da hem tekli hem de çoklu doğrusal regresyona bir örnekti. Ödeviniz, diğer özelliklerle sonuçları incelemek ve yorumlamak olacak.
Şimdi de doğrusal regresyonun scikit-learn ile nasıl uygulanabileceğine bakalım. Veri setini zaten içe aktardınız; ancak linear_model sınıfını içe aktarmanız gerekecek.
from sklearn import linear_model
X = df
y = target["MEDV"]

lm = linear_model.LinearRegression()
model = lm.fit(X,y)
Model eğitimi tamamlandı. Bu sklearn uygulaması da OLS kullanır. İlk beş örnek için MEDV değerleri üzerine bazı tahminler yapalım.
predictions = lm.predict(X)
print(predictions[0:5])
[30.00821269 25.0298606 30.5702317 28.60814055 27.94288232]
Modelinizle ilgili (R-kare, katsayılar vb. gibi) biraz daha ayrıntı öğrenmek isterseniz, bunu kolayca yapabilirsiniz.
lm.score(X,y)
0.7406077428649427
lm.coef_
array([-1.07170557e-01,  4.63952195e-02,  2.08602395e-02,  2.68856140e+00,
       -1.77957587e+01,  3.80475246e+00,  7.51061703e-04, -1.47575880e+00,
        3.05655038e-01, -1.23293463e-02, -9.53463555e-01,  9.39251272e-03,
       -5.25466633e-01])
Harika! Sona ulaştınız. En basit ve en temel algoritmalardan birini ele almak o kadar da kolay değildi; ancak bunu gayet iyi başardınız. Yalın doğrusal regresyona aşina olmakla kalmadınız, aynı zamanda makine öğrenmesinin birçok temel yönünü, terimini ve faktörünü incelediniz. Python’da ayrıntılı bir vaka çalışması da yaptınız.
Bu eğitim, Doğrusal Regresyonu sıfırdan uygulamanız için bir motivasyon olarak da görülebilir. Bunu gerçekten yapmak isteyenler için kısa adımlar şunlardır:
Bu eğitimi hazırlamak için kullanılan bazı kaynaklar aşağıdadır:
Doğrusal sınıflandırıcılar hakkında daha fazla öğrenmek isterseniz, DataCamp’in Python’da Doğrusal Sınıflandırıcılar kursunu alın.
Doğrusal Regresyon için Normal Denklem Eğitimimize göz atın.
Python kursları
Kurs
Kurs
Kurs
blog
Dario Radečić
15 dk.
blog
Abid Ali Awan
14 dk.
Eğitim
Adel Nehme
Eğitim
Kurtis Pykes
8 dk.




