
Last chance! 50% off DataCamp Premium
Sale ends in
Il campo della Data Science è avanzato come poche altre discipline. Integra tantissimi domini diversi come Statistica, Algebra lineare, Machine Learning, Basi di dati e li fonde nel modo più significativo possibile. Ma, al suo interno, cosa rende questa disciplina una delle più straordinarie? - I potenti algoritmi statistici
Uno di questi algoritmi statistici molto primitivi è la Regressione lineare. Per quanto sia datata, non è mai troppo vecchia per essere trascurata da un aspirante data scientist come te. Capire il principio alla base del funzionamento della regressione lineare è fondamentale per spiegare l’evoluzione di un’intera classe di algoritmi statistici chiamata Modelli Lineari Generalizzati. Inoltre, ti aiuterà a comprendere altri aspetti tipici di un algoritmo statistico/di machine learning, ad esempio funzioni di costo, coefficienti, ottimizzazione, ecc.
Come suggerisce il titolo di questo tutorial, qui affronterai in dettaglio la Regressione lineare. Prima di addentrarti nelle teorie dietro la Regressione lineare, facciamo chiarezza sul termine regressione.
La regressione appartiene alla classe dei compiti di Apprendimento supervisionato in cui i dataset usati per la modellazione predittiva/statistica contengono etichette continue. Ma definiamo un problema di regressione in modo più matematico.
Considera la seguente immagine:  Fonte: appunti delle lezioni di Andrew Ng
Quindi, nell’immagine sopra, X è l’insieme dei valori che corrispondono alle superfici abitative di varie case (considerato anche come lo spazio dei valori di input) e y è il prezzo delle rispettive case, ma nota che questi valori sono predetti da h. h è la funzione che mappa i valori di X in y (spesso chiamata predittore). Per ragioni storiche, questa h è chiamata funzione di ipotesi. Tieni presente che questo dataset ha una sola caratteristica, cioè le superfici abitative di varie case, e consideralo come un dataset giocattolo per comprendere i concetti.
Nota che qui i valori predetti sono di natura continua. Quindi, il tuo obiettivo finale è, dato un training set, imparare una funzione $h : \mathcal{X} \rightarrow \mathcal{Y}$ tale che h(x) sia un "buon" predittore del corrispondente valore di y. Tieni anche presente che il dominio dei valori che sia X sia Y accettano è l’insieme dei numeri reali e puoi definirlo così: $\mathcal{X} = \mathcal{Y} = \mathbb{IR}$ dove $\mathbb{IR}$ è l’insieme di tutti i numeri reali.
Una coppia (x(i), y(i)) è chiamata esempio di training. Puoi definire il training set come {(x(i), y(i)) ; i = 1,...,m} (nel caso in cui il training set contenga m istanze e nel dataset ci sia una sola caratteristica x).
Un po’ di matematica per evitare di sbagliare anche nelle cose più semplici. Dunque, secondo Han, Kamber e Pei-
"In generale, questi metodi sono usati per prevedere il valore di una variabile risposta (dipendente) a partire da una o più variabili predittive (indipendenti), dove le variabili sono numeriche." - Data Mining: Concepts and Techniques (3rd edn.)
Semplice, no?
Quindi, nel corso della comprensione di un tipico problema di regressione hai anche visto come definirne un’ipotesi. Ottimo. Hai impostato perfettamente il contesto! Ora passerai direttamente alla meccanica della Regressione lineare.
Prima di entrare nei dettagli, non sarebbe utile dare un’occhiata a quando è stata scoperta? Beh, si torna indietro fino al XVIII secolo. Il grande Carl Friedrich Gauss propose per primo la forma più banale di regressione statistica, anche se su questo ci sono molte discussioni. Non addentriamoci. Ma se ti interessa vedere le argomentazioni tra Gauss e Adrien-Marie Legendre, qui trovi il link.
La regressione lineare è forse uno degli algoritmi più noti e compresi in statistica e machine learning. È stata sviluppata nell’ambito della statistica e studiata come modello per comprendere la relazione tra variabili numeriche di input e output, ma col tempo è diventata parte integrante della cassetta degli attrezzi del machine learning moderno.
Usiamo un dataset giocattolo. Userai lo stesso dataset di previsione del prezzo delle case, ma stavolta con due caratteristiche. Il compito resta lo stesso, cioè prevedere il prezzo della casa.
 Fonte: appunti delle lezioni di Andrew Ng
Come accennato, ora le x sono bidimensionali, il che significa che il tuo dataset contiene due caratteristiche. Per esempio, x1(i) è la superficie abitativa della i-esima casa nel training set e x2(i) è il suo numero di camere da letto.
Per eseguire la regressione, devi decidere come rappresentare h. Come scelta iniziale, supponiamo di approssimare y come funzione lineare di x:
Qui, le θi sono i parametri (anche detti pesi) che parametrizzano lo spazio delle funzioni lineari che mappano da $\mathcal{X}$ a $\mathcal{Y}$. In termini più semplici, questi parametri sono usati per mappare accuratamente $\mathcal{X}$ in $\mathcal{Y}$. Ma per semplicità, ometterai il pedice θ in hθ(x) e lo scriverai semplicemente come h(x). Per semplificare ulteriormente la notazione, introdurrai anche la convenzione di porre x0 = 1 (questo è il termine di intercetta), così che

dove, a destra, consideri θ e x entrambi come vettori, e qui n è il numero di istanze di input (escludendo x0).
Ma la domanda principale che sorge a questo punto è: come scegli o impari i parametri θ? Non puoi cambiare le tue istanze di input per prevedere i prezzi. Hai solo questi parametri θ da regolare.
Un metodo importante sembra essere quello di rendere h(x) vicino a y, almeno per gli esempi di training che hai. Per capirlo più formalmente, proviamo a definire una funzione che determini, per ogni valore delle θ, quanto vicini sono gli h(x(i)) ai corrispondenti y(i). La funzione dovrebbe essere la seguente:

Per capire il motivo per cui si prende il quadrato invece del valore assoluto, considera questo termine al quadrato come un vantaggio per le operazioni future da eseguire nell’addestramento del modello di regressione. Ma se vuoi approfondire, dai un’occhiata qui.
Hai appena visto una delle formule più importanti nel mondo della Data Science/Machine Learning/Statistica. Si chiama funzione di costo.
Questa è una derivazione essenziale perché non solo dà origine alla successiva evoluzione della regressione lineare (Minimi Quadrati Ordinari) ma getta anche le basi di un’intera classe di algoritmi di modellazione lineare (ricordi il termine Modelli Lineari Generalizzati).
È importante notare che la regressione lineare può spesso essere suddivisa in due forme di base:
Queste cose sono molto semplici ma possono spesso creare confusione.
Hai già gettato le basi della regressione lineare. Ora studierai più da vicino i modi per stimare i parametri visti nella sezione precedente. Questa stima dei parametri è essenzialmente nota come addestramento della regressione lineare. Esistono molti metodi per addestrare un modello di regressione lineare, tra cui i Minimi Quadrati Ordinari (OLS), il più popolare. Quindi, è corretto riferirsi a un modello di regressione lineare addestrato con OLS come Regressione lineare a Minimi Quadrati Ordinari o semplicemente Regressione ai Minimi Quadrati.
Nota che i parametri qui, in questo contesto, sono anche chiamati coefficienti del modello.
Imparare/addestrare un modello di regressione lineare significa essenzialmente stimare i valori dei coefficienti/parametri usati nella rappresentazione in base ai dati che hai.
In questa sezione, darai un’occhiata sintetica ad alcune tecniche per preparare un modello di regressione lineare.
Hai concluso la sezione precedente con l’idea di scegliere θ in modo da minimizzare J(θ). Per farlo, usiamo un algoritmo di ricerca che parte da una "ipotesi iniziale" per θ e modifica iterativamente θ per rendere J(θ) più piccolo, finché, si spera, non convergi a un valore di θ che minimizza J(θ). In particolare, consideriamo l’algoritmo del gradiente discendente, che parte da un θ iniziale e ripete l’aggiornamento:
 Fonte: appunti delle lezioni di Andrew Ng
(Questo aggiornamento è eseguito simultaneamente per tutti i valori di j = 0, . . . , n.) Qui, α è il learning rate. È un algoritmo molto naturale che ripetutamente fa un passo nella direzione di massima diminuzione di J. Questo termine α controlla di fatto quanto rapidamente il tuo algoritmo si muove verso la diminuzione di J. Graficamente può essere rappresentato così:
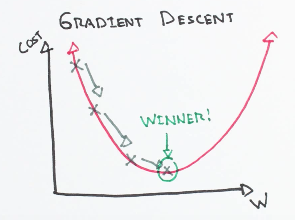 Fonte: ml-cheatsheet
Intuitivamente, la formula sopra indica la piccola variazione che avviene in J rispetto al parametro θj e come questa influisce sul valore iniziale di θj. Ma guarda bene: qui hai a che fare con una derivata parziale. L’intero processo di derivazione è fuori dallo scopo di questo tutorial.
Basta notare che, per un singolo esempio di training, questo fornisce la regola di aggiornamento:
 Fonte: ml-cheatsheet
La regola è chiamata regola di aggiornamento LMS (LMS sta per “least mean squares”) ed è nota anche come regola di apprendimento di Widrow-Hoff.
Ricapitoliamo alcune cose nel contesto degli OLS.
"La procedura dei Minimi Quadrati Ordinari cerca di minimizzare la somma dei residui al quadrato. Questo significa che, data una retta di regressione attraverso i dati, calcoliamo la distanza da ogni punto dati alla retta di regressione, la eleviamo al quadrato e sommiamo tutti gli errori quadratici. Questa è la quantità che i minimi quadrati ordinari cercano di minimizzare." - Jason Brownlee
Nella regola di addestramento precedente, hai già visto come il gradiente discendente possa essere incorporato in questo contesto. In sostanza, il gradiente discendente è un processo per ottimizzare i valori dei coefficienti minimizzando iterativamente l’errore del modello sui dati di training.
Più brevemente, funziona iniziando con valori casuali per ciascun coefficiente. Si calcola la somma degli errori al quadrato per ogni coppia di valori di input e output. Si usa un learning rate come fattore di scala e si aggiornano i coefficienti nella direzione che minimizza l’errore. Il processo si ripete finché non si raggiunge un errore quadratico minimo o non è più possibile migliorare.
Il termine α (learning rate) è molto importante qui perché determina l’ampiezza del passo di miglioramento da compiere a ogni iterazione della procedura.
Esistono comunemente due varianti del gradiente discendente:
Questo è tutto per il gradiente discendente in questo tutorial. Ora vedrai un altro modo per ottimizzare un modello di regressione lineare, ossia la Regolarizzazione.
DataCamp ha già un buon articolo introduttivo sulla Regolarizzazione. Potresti volerlo leggere prima di proseguire.
In generale, i metodi di regolarizzazione funzionano penalizzando i coefficienti delle caratteristiche che hanno valori estremamente grandi, cercando così di ridurre l’errore. Non solo porta a un tasso di errore migliore, ma riduce anche la complessità del modello. Questo è particolarmente utile quando lavori con un dataset che ha un gran numero di caratteristiche e il tuo modello di base non riesce a distinguere l’importanza delle caratteristiche (non tutte le caratteristiche di un dataset sono ugualmente importanti, giusto?).
Esistono due varianti di procedure di regolarizzazione per la regressione lineare:
Regressione Lasso: aggiunge un termine di penalizzazione equivalente al valore assoluto della magnitudine dei coefficienti (chiamata anche regolarizzazione L1). I termini di penalizzazione sono: 
dove,
Regressione Ridge: aggiunge un termine di penalizzazione equivalente al quadrato della magnitudine dei coefficienti (chiamata anche regolarizzazione L2). I termini di penalizzazione sono: 
Come no? Hai già visto quanto elegantemente la regressione lineare introduce alcuni dei concetti più critici del Machine Learning come funzioni di costo, ottimizzazione, relazioni tra variabili e così via. Tutte queste cose sono vitali anche quando costruisci una rete neurale. L’applicabilità può differire in alcuni casi, ma i concetti generali restano gli stessi. Quindi, senza comprendere queste basi, non riuscirai mai a spiegare perché la tua rete neurale non funziona bene.
Inoltre, un semplice concetto di derivare le relazioni tra variabili ha dato vita a tantissimi concetti e, soprattutto, ha creato un’intera nuova famiglia di algoritmi - Modelli Lineari Generalizzati. Per un aspirante professionista di Data Science/Machine Learning/Intelligenza Artificiale, questo algoritmo è qualcosa che non si può trascurare. Ormai lo avrai capito!
Ora implementerai una semplice regressione lineare in Python. Dovrebbe essere divertente!
Per questo case study userai prima la libreria Statsmodel per Python. È una libreria molto popolare che fornisce classi e funzioni per la stima di molti modelli statistici diversi, oltre a test statistici ed esplorazione statistica dei dati. Per i dati, userai il famoso dataset Boston House. Il potente scikit-learn include questo dataset, quindi non serve scaricarlo separatamente.
Iniziamo il case study importando la libreria statsmodels e il dataset:
import statsmodels.api as sm
from sklearn import datasets

data = datasets.load_boston()
Scikit-learn fornisce una comoda descrizione del dataset, che può essere facilmente visualizzata con:
print (data.DESCR)
Boston House Prices dataset
===========================

Notes
------
Data Set Characteristics:

    :Number of Instances: 506

    :Number of Attributes: 13 numeric/categorical predictive

    :Median Value (attribute 14) is usually the target

    :Attribute Information (in order):
        - CRIM     per capita crime rate by town
        - ZN       proportion of residential land zoned for lots over 25,000 sq.ft.
        - INDUS    proportion of non-retail business acres per town
        - CHAS     Charles River dummy variable (= 1 if tract bounds river; 0 otherwise)
        - NOX      nitric oxides concentration (parts per 10 million)
        - RM       average number of rooms per dwelling
        - AGE      proportion of owner-occupied units built prior to 1940
        - DIS      weighted distances to five Boston employment centres
        - RAD      index of accessibility to radial highways
        - TAX      full-value property-tax rate per $10,000
        - PTRATIO  pupil-teacher ratio by town
        - B        1000(Bk - 0.63)^2 where Bk is the proportion of blacks by town
        - LSTAT    % lower status of the population
        - MEDV     Median value of owner-occupied homes in $1000's

    :Missing Attribute Values: None

    :Creator: Harrison, D. and Rubinfeld, D.L.

This is a copy of UCI ML housing dataset.
http://archive.ics.uci.edu/ml/datasets/Housing


This dataset was taken from the StatLib library which is maintained at Carnegie Mellon University.

The Boston house-price data of Harrison, D. and Rubinfeld, D.L. 'Hedonic
prices and the demand for clean air', J. Environ. Economics & Management,
vol.5, 81-102, 1978.   Used in Belsley, Kuh & Welsch, 'Regression diagnostics
...', Wiley, 1980.   N.B. Various transformations are used in the table on
pages 244-261 of the latter.

The Boston house-price data has been used in many machine learning papers that address regression
problems.

**References**

   - Belsley, Kuh & Welsch, 'Regression diagnostics: Identifying Influential Data and Sources of Collinearity', Wiley, 1980. 244-261.
   - Quinlan, R. (1993). Combining Instance-Based and Model-Based Learning. In Proceedings on the Tenth International Conference of Machine Learning, 236-243, University of Massachusetts, Amherst. Morgan Kaufmann.
   - many more! (see http://archive.ics.uci.edu/ml/datasets/Housing)
Ora, prima di applicare la regressione lineare, dovrai preparare i dati e separare le caratteristiche dall’etichetta del dataset. MEDV (valore mediano delle abitazioni) è l’etichetta in questo caso. Puoi accedere alle caratteristiche del dataset usando l’attributo feature_names.
Un po’ di conoscenza di pandas qui torna utile. Questa cheat sheet è imperdibile se vuoi ripassare i concetti base di pandas.
# Pandas e NumPy import
import numpy as np
import pandas as pd

# Imposta le caratteristiche
df = pd.DataFrame(data.data, columns=data.feature_names)

# Imposta il target
target = pd.DataFrame(data.target, columns=["MEDV"])
A questo punto, devi considerare alcune cose importanti sulla regressione lineare prima di applicarla ai dati. Avresti potuto studiarle prima nel tutorial, ma affrontarle adesso ti aiuterà a coglierne davvero il senso.
Passiamo alla pratica. Per semplicità prenderai solo la caratteristica RM — il numero medio di stanze per ora. Nota che Statsmodels non aggiunge di default un termine costante (ricorda il fattore θ0). Vediamolo prima senza il termine costante nel tuo modello di regressione:
X = df["RM"]
y = target["MEDV"]

# Adatta e genera le previsioni dal modello
model = sm.OLS(y, X).fit()
predictions = model.predict(X)

# Stampa le statistiche
model.summary()

Cos’è questo output! È troppo ricco per capirlo subito la prima volta. Vediamo i punti più critici passo dopo passo:
OLS per addestrare il tuo modello di regressione lineare. RM aumenta di 1, il valore previsto di MEDV aumenta di 3,634. Questi sono i punti più importanti a cui fare attenzione per il momento (puoi ignorare anche l’avviso).
Un termine costante può essere facilmente aggiunto al modello di regressione lineare. Puoi farlo con X = sm.add_constant(X) (X è il nome del dataframe contenente le variabili indipendenti di input).
X = sm.add_constant(X)

model = sm.OLS(y, X).fit()
predictions = model.predict(X)

model.summary()

Si vede chiaramente che l’aggiunta del termine costante ha un effetto diretto sul coefficiente. Senza il termine costante, il tuo modello passava per l’origine, ma ora hai un’intercetta y a -34,67. Ora anche la pendenza del predittore RM è cambiata da 3,634 a 9,1021 (coef di RM).
Ora adatterai un modello di regressione con più di una variabile — aggiungerai LSTAT (percentuale di popolazione a stato socioeconomico più basso) insieme alla variabile RM. La procedura di addestramento (fitting) del modello resta esattamente la stessa di prima:
X = df[["RM", "LSTAT"]]
y = target["MEDV"]

model = sm.OLS(y, X).fit()
predictions = model.predict(X)

model.summary()

Interpretiamolo ora:
Questo modello ha un valore di R-squared molto più alto — 0,948, il che significa essenzialmente che questo modello cattura il 94,8% della varianza nella variabile dipendente. Ora proviamo a capire la relazione tra le due variabili RM e LSTAT e il valore mediano delle case. All’aumentare di RM di 1, MEDV aumenterà di 4,9069, e quando LSTAT aumenta di 1, MEDV diminuisce di 0,6557. Questo indica che RM e LSTAT sono statisticamente significative nel prevedere (o stimare) il valore mediano delle case.
Puoi interpretare questa relazione anche in italiano corrente:
Ora ha più senso! Non è così?
Questo è stato l’esempio sia di regressione lineare semplice sia multipla in Statsmodels. Il tuo compito a casa sarà indagare e interpretare i risultati con ulteriori caratteristiche.
Ora vediamo come la regressione lineare può essere implementata usando il tuo scikit-learn. Hai già importato il dataset, ma dovrai importare la classe linear_model.
from sklearn import linear_model
X = df
y = target["MEDV"]

lm = linear_model.LinearRegression()
model = lm.fit(X,y)
L’addestramento del modello è completo. Questa implementazione di sklearn usa anch’essa gli OLS. Facciamo alcune previsioni dei valori di MEDV per i primi cinque campioni.
predictions = lm.predict(X)
print(predictions[0:5])
[30.00821269 25.0298606 30.5702317 28.60814055 27.94288232]
Se vuoi conoscere qualche altro dettaglio (come R-squared, coefficienti, ecc.) del tuo modello, puoi farlo facilmente.
lm.score(X,y)
0.7406077428649427
lm.coef_
array([-1.07170557e-01,  4.63952195e-02,  2.08602395e-02,  2.68856140e+00,
       -1.77957587e+01,  3.80475246e+00,  7.51061703e-04, -1.47575880e+00,
        3.05655038e-01, -1.23293463e-02, -9.53463555e-01,  9.39251272e-03,
       -5.25466633e-01])
Fantastico! Sei arrivato alla fine. Affrontare uno degli algoritmi più semplici e fondamentali non è stato facile, ma te la sei cavata molto bene. Non solo ti sei familiarizzato con la regressione lineare semplice, ma hai anche studiato molti aspetti, termini e fattori fondamentali del machine learning. Hai inoltre svolto un case study approfondito in Python.
Questo tutorial può anche essere uno stimolo per implementare la Regressione lineare da zero. Di seguito i passaggi sintetici per chi volesse farlo davvero:
Di seguito alcune referenze usate per preparare questo tutorial:
Se vuoi saperne di più sui classificatori lineari, segui il corso di DataCamp Linear Classifiers in Python.
Dai un’occhiata al nostro Tutorial sulla Normal Equation per la Regressione lineare.
Corsi Python
{count, plural, one {Corso} other {Corsi}}
{count, plural, one {Corso} other {Corsi}}
{count, plural, one {Corso} other {Corsi}}
{count, plural, one {blog} other {blogs}}
Abid Ali Awan
10 min
{count, plural, one {blog} other {blogs}}
Tim Lu
12 min
{count, plural, one {blog} other {blogs}}
Abid Ali Awan
15 min



