Cursus
Introductie tot Python
4 uur
7.1M
Het vakgebied Data Science heeft zich ontwikkeld als geen ander. Het omvat zoveel verschillende domeinen zoals statistiek, lineaire algebra, machine learning en databases, en brengt die op de meest zinvolle manier samen. Maar wat maakt dit vakgebied in de kern zo bijzonder? - De krachtige statistische algoritmen
Een van die heel basale statistische algoritmen is lineaire regressie. Hoewel het al oud is, is het nooit te oud om te negeren voor een beginnende data scientist zoals jij. Het principe achter de werking van lineaire regressie begrijpen is heel belangrijk om de ontwikkeling te verklaren van een hele klasse statistische algoritmen die Generalized Linear Models (GLM) worden genoemd. Bovendien helpt het je andere aspecten van een typisch statistisch/machine learning-algoritme te begrijpen, zoals kostfuncties, coëfficiënten, optimalisatie, enz.
Zoals de titel van deze tutorial aangeeft, behandel je lineaire regressie hier uitgebreid. Voordat je de theorie achter lineaire regressie induikt, kijken we eerst goed naar de term regressie.
Regressie behoort tot de klasse van supervised learning-taken waarbij de datasets die voor voorspellende/statistische modellering worden gebruikt continue labels bevatten. Maar laten we een regressieprobleem wiskundiger definiëren.
Beschouw de onderstaande afbeelding:  Bron: collegeaantekeningen van Andrew Ng
In de bovenstaande afbeelding is X de verzameling waarden die overeenkomen met de woonoppervlakten van verschillende huizen (ook wel de ruimte van inputwaarden) en is y de prijs van de respectieve huizen, maar let op dat deze waarden worden voorspeld door h. h is de functie die de X-waarden afbeeldt op y (vaak predictor genoemd). Om historische redenen wordt deze h een hypothesefunctie genoemd. Houd er rekening mee dat deze dataset slechts één feature heeft, namelijk de woonoppervlakten van verschillende huizen; beschouw dit als een speeldataset om het principe te begrijpen.
Merk op dat de voorspelde waarden hier van continue aard zijn. Je uiteindelijke doel is dus, gegeven een trainingsset, een functie te leren $h : \mathcal{X} \rightarrow \mathcal{Y}$ zodat h(x) een "goede" voorspeller is voor de corresponderende waarde van y. Houd ook in gedachten dat het domein van waarden dat zowel X als Y accepteren reële getallen zijn en je dit zo kunt definiëren: $\mathcal{X} = \mathcal{Y} = \mathbb{IR}$ waarbij $\mathbb{IR}$ de verzameling van alle reële getallen is.
Een paar (x(i), y(i)) heet een trainingsexample. Je kunt de trainingsset definiëren als {(x(i), y(i)) ; i = 1,...,m} (als de trainingsset m instanties bevat en er slechts één feature x in de dataset is).
Een beetje wiskunde zodat je ook in de simpelste dingen niet de mist ingaat. Volgens Han, Kamber en Pei:
"In het algemeen worden deze methoden gebruikt om de waarde van een respons- (afhankelijke) variabele te voorspellen op basis van één of meer predictor- (onafhankelijke) variabelen, waarbij de variabelen numeriek zijn." - Data Mining: Concepts and Techniques (3e ed.)
Zo simpel is het!
In het begrijpen van een typisch regressieprobleem zag je ook hoe je er een hypothese voor definieert. Goed bezig. Je hebt de toon precies goed gezet! Nu duik je direct in de mechanica van lineaire regressie.
Voor we de details ingaan, is het leuk om te weten wanneer het werd ontdekt. Dat gaat ver terug naar de 18e eeuw. De grote Carl Friedrich Gauss stelde de meest eenvoudige vorm van statistische regressie voor, al zijn daar veel discussies over. Laten we daar niet op ingaan. Maar als je geïnteresseerd bent in de discussie tussen Gauss en Adrien-Marie Legendre, hier is de link.
Lineaire regressie is wellicht een van de meest bekende en best begrepen algoritmen in de statistiek en machine learning. Het is ontwikkeld binnen de statistiek en wordt bestudeerd als een model om de relatie tussen numerieke input- en outputvariabelen te begrijpen, maar in de loop der tijd is het een integraal onderdeel geworden van de moderne machine learning-gereedschapskist.
Laten we een speeldataset nemen. Je gebruikt dezelfde dataset voor het voorspellen van huizenprijzen om dit te onderzoeken, maar dit keer met twee features. De taak blijft hetzelfde, namelijk het voorspellen van de huizenprijs.
 Bron: collegeaantekeningen van Andrew Ng
Zoals eerder vermeld zijn de x’en nu tweedimensionaal, wat betekent dat je dataset twee features bevat. Bijvoorbeeld, x1(i) is de woonoppervlakte van het i-de huis in de trainingsset en x2(i) is het aantal slaapkamers.
Om regressie uit te voeren, moet je beslissen hoe je h gaat representeren. Als eerste keuze stel je y voor als een lineaire functie van x:
Hier zijn de θi’s de parameters (ook wel gewichten) die de ruimte van lineaire functies parameteriseren die van $\mathcal{X}$ naar $\mathcal{Y}$ afbeelden. Simpeler gezegd: deze parameters worden gebruikt om $\mathcal{X}$ nauwkeurig op $\mathcal{Y}$ af te beelden. Maar om het eenvoudig te houden laat je de θ-subscript in hθ(x) weg, en schrijf je gewoon h(x). Om de notatie nog verder te vereenvoudigen, introduceer je de conventie x0 = 1 (dit is de intercept), zodat

waarbij je aan de rechterkant zowel θ als x als vectoren beschouwt, en n het aantal inputinstanties is (x0 niet meegerekend).
Maar de hoofdvraag op dit punt is: hoe kies of leer je de parameters θ? Je kunt je inputinstanties niet veranderen om prijzen te voorspellen. Je hebt alleen deze θ-parameters om af te stemmen.
Een voor de hand liggende methode is om h(x) dicht bij y te brengen, in elk geval voor de trainingsvoorbeelden die je hebt. Om dit formeler te begrijpen, definiëren we een functie die bepaalt, voor elke waarde van de θ’s, hoe dicht de h(x(i))’s bij de corresponderende y(i)’s liggen. De functie ziet er als volgt uit:

Om de reden te begrijpen waarom je het kwadraat neemt in plaats van de absolute waarde: beschouw de kwadraterm als een voordeel voor toekomstige bewerkingen tijdens het trainen van het regressiemodel. Wil je dieper graven, kijk hier.
Je zag zojuist een van de belangrijkste formules in de wereld van Data Science/Machine Learning/Statistiek. Dit heet de kostfunctie.
Dit is een essentiële afleiding, want het geeft niet alleen aanleiding tot de volgende evolutie van lineaire regressie (Ordinary Least Squares), maar vormt ook de basis van een hele klasse lineaire modelleringsalgoritmen (weet je nog, Generalized Linear Models?).
Het is belangrijk op te merken dat lineaire regressie vaak in twee basisvormen kan worden opgedeeld:
Dit is heel rechttoe rechtaan, maar kan toch verwarring veroorzaken.
Je hebt de basis van lineaire regressie al gelegd. Nu ga je meer leren over manieren om de parameters te schatten die je in het bovenstaande deel zag. Deze parameterschatting wordt in wezen het trainen van lineaire regressie genoemd. Er zijn veel methoden om een lineair regressiemodel te trainen, waarbij Ordinary Least Squares (OLS) de populairste is. Het is dus passend om een met OLS getraind lineair regressiemodel aan te duiden als Ordinary Least Squares Linear Regression of gewoon Least Squares Regression.
Merk op dat de parameters hier in deze context ook wel modelcoëfficiënten worden genoemd.
Het leren/ trainen van een lineair regressiemodel betekent in wezen het schatten van de waarden van de coëfficiënten/parameters die in de representatie worden gebruikt met de data die je hebt.
In deze sectie bekijk je kort enkele technieken om een lineair regressiemodel voor te bereiden.
Je sloot het vorige deel af met het idee θ zó te kiezen dat J(θ) minimaal is. Laten we daarvoor een zoekalgoritme gebruiken dat begint met een "initiële gok" voor θ, en θ iteratief wijzigt om J(θ) kleiner te maken, totdat je hopelijk convergeert naar een waarde van θ die J(θ) minimaliseert. Specifiek bekijken we het gradient descent-algoritme, dat start met een initiële θ en herhaaldelijk de update uitvoert:
 Bron: collegeaantekeningen van Andrew Ng
(Deze update wordt gelijktijdig uitgevoerd voor alle waarden j = 0, . . . , n.) Hier heet α de learning rate (leersnelheid). Dit is een heel natuurlijk algoritme dat steeds een stap zet in de richting van de steilste afname van J. Deze term α bepaalt in feite hoe snel je algoritme richting de afname van J beweegt. Dat is grafisch als volgt uit te drukken:
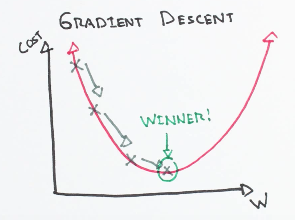 Bron: ml-cheatsheet
Intuïtief geeft de bovenstaande formule de kleine verandering in J aan t.o.v. de parameter θj en hoe die de initiële waarde van θj beïnvloedt. Maar kijk goed: je hebt hier met een partiële afgeleide te maken. De volledige afleiding valt buiten de scope van deze tutorial.
Merk op dat dit voor één trainingsexample de volgende updateregel geeft:
 Bron: ml-cheatsheet
Deze regel heet de LMS-updateregel (LMS staat voor “least mean squares”) en is ook bekend als de Widrow-Hoff-leerregel.
Laten we een paar dingen in de context van OLS samenvatten.
"De Ordinary Least Squares-procedure probeert de som van de gekwadrateerde residuen te minimaliseren. Dat betekent dat we, gegeven een regressielijn door de data, de afstand van elk datapunt tot de regressielijn berekenen, kwadrateren en alle gekwadrateerde fouten bij elkaar optellen. Dit is de grootheid die ordinary least squares probeert te minimaliseren." - Jason Brownlee
In de vorige leerregel zag je al hoe gradient descent in deze context kan worden toegepast. In wezen is gradient descent een proces om de waarden van de coëfficiënten te optimaliseren door iteratief de fout van het model op je trainingsdata te minimaliseren.
Kort gezegd werkt het door te beginnen met willekeurige waarden voor elke coëfficiënt. De som van de gekwadrateerde fouten wordt berekend voor elk paar input- en outputwaarden. Een learning rate wordt gebruikt als schaalfactor en de coëfficiënten worden bijgewerkt in de richting van het minimaliseren van de fout. Dit proces wordt herhaald totdat een minimale som van gekwadrateerde fouten is bereikt of verdere verbetering niet mogelijk is.
De term α (learning rate) is hier erg belangrijk, omdat die de grootte van de verbeteringsstap bij elke iteratie bepaalt.
Er zijn twee gangbare varianten van gradient descent:
Dat is het voor gradient descent in deze tutorial. Nu bekijken we een andere manier om een lineair regressiemodel te optimaliseren, namelijk regularisatie.
DataCamp heeft al een goed inleidend artikel over regularisatie. Dat kun je doornemen voordat je hiermee verdergaat.
In het algemeen werken regularisatiemethoden door de coëfficiënten van features met extreem grote waarden te bestraffen en zo de fout te proberen te verkleinen. Dat levert niet alleen een lagere fout op, maar vermindert ook de modelcomplexiteit. Dit is vooral nuttig wanneer je met een dataset met veel features werkt en je basismodel het belang van de features niet goed weet te onderscheiden (niet alle features in een dataset zijn even belangrijk, toch?).
Er zijn twee varianten van regularisatieprocedures voor lineaire regressie:
Lasso-regressie: voegt een strafterm toe die gelijk is aan de absolute waarde van de grootte van de coëfficiënten (ook wel L1-regularisatie genoemd). De strafterm ziet er zo uit: 
waarbij,
Ridge-regressie: voegt een strafterm toe die gelijk is aan het kwadraat van de grootte van de coëfficiënten (ook wel L2-regularisatie genoemd). De strafterm ziet er zo uit: 
Waarom niet? Je zag al hoe lineaire regressie sommige van de meest cruciale concepten van machine learning mooi introduceert, zoals kostfuncties, optimalisatie, variablerelaties en wat al niet meer. Al deze zaken zijn essentieel, zelfs als je een neuraal netwerk bouwt. De toepasbaarheid kan op sommige punten verschillen, maar de algemene concepten blijven precies hetzelfde. Zonder deze basisdingen te begrijpen, zul je nooit kunnen beredeneren waarom je neural net niet goed presteert.
Bovendien heeft een eenvoudig concept om relaties tussen variabelen af te leiden tot veel ideeën geleid en vooral een hele nieuwe familie algoritmen gecreëerd: Generalized Linear Models. Voor een ambitieuze Data Science/Machine Learning/Artificial Intelligence-practicus is dit algoritme dus iets dat je niet kunt negeren. Dat heb je inmiddels wel begrepen!
Nee, je gaat nu zelf een eenvoudige lineaire regressie in Python implementeren. Dat wordt leuk!
Voor deze casestudy gebruik je eerst de Statsmodel-bibliotheek voor Python. Dit is een zeer populaire bibliotheek die klassen en functies biedt voor de schatting van veel verschillende statistische modellen, evenals voor het uitvoeren van statistische tests en statistische data-exploratie. Voor de data gebruik je de beroemde Boston House-dataset. De machtige scikit-learn wordt geleverd met deze dataset, dus je hoeft die niet apart te downloaden.
Laten we de casestudy starten door de bibliotheek statsmodels en je dataset te importeren:
import statsmodels.api as sm
from sklearn import datasets

data = datasets.load_boston()
Scikit-learn geeft een handige beschrijving van de dataset, die je eenvoudig kunt bekijken met:
print (data.DESCR)
Boston House Prices dataset
===========================

Notes
------
Data Set Characteristics:

    :Number of Instances: 506

    :Number of Attributes: 13 numeric/categorical predictive

    :Median Value (attribute 14) is usually the target

    :Attribute Information (in order):
        - CRIM     per capita crime rate by town
        - ZN       proportion of residential land zoned for lots over 25,000 sq.ft.
        - INDUS    proportion of non-retail business acres per town
        - CHAS     Charles River dummy variable (= 1 if tract bounds river; 0 otherwise)
        - NOX      nitric oxides concentration (parts per 10 million)
        - RM       average number of rooms per dwelling
        - AGE      proportion of owner-occupied units built prior to 1940
        - DIS      weighted distances to five Boston employment centres
        - RAD      index of accessibility to radial highways
        - TAX      full-value property-tax rate per $10,000
        - PTRATIO  pupil-teacher ratio by town
        - B        1000(Bk - 0.63)^2 where Bk is the proportion of blacks by town
        - LSTAT    % lower status of the population
        - MEDV     Median value of owner-occupied homes in $1000's

    :Missing Attribute Values: None

    :Creator: Harrison, D. and Rubinfeld, D.L.

This is a copy of UCI ML housing dataset.
http://archive.ics.uci.edu/ml/datasets/Housing


This dataset was taken from the StatLib library which is maintained at Carnegie Mellon University.

The Boston house-price data of Harrison, D. and Rubinfeld, D.L. 'Hedonic
prices and the demand for clean air', J. Environ. Economics & Management,
vol.5, 81-102, 1978.   Used in Belsley, Kuh & Welsch, 'Regression diagnostics
...', Wiley, 1980.   N.B. Various transformations are used in the table on
pages 244-261 of the latter.

The Boston house-price data has been used in many machine learning papers that address regression
problems.

**References**

   - Belsley, Kuh & Welsch, 'Regression diagnostics: Identifying Influential Data and Sources of Collinearity', Wiley, 1980. 244-261.
   - Quinlan, R. (1993). Combining Instance-Based and Model-Based Learning. In Proceedings on the Tenth International Conference of Machine Learning, 236-243, University of Massachusetts, Amherst. Morgan Kaufmann.
   - many more! (see http://archive.ics.uci.edu/ml/datasets/Housing)
Voordat je lineaire regressie toepast, moet je de data voorbereiden en de features en het label van de dataset scheiden. MEDV (median home value) is hier het label. Je krijgt toegang tot de features van de dataset via het attribuut feature_names.
Een beetje pandas-kennis is hier handig. Deze cheat sheet is een must als je je basisconcepten van pandas wilt opfrissen.
# Pandas and NumPy import
import numpy as np
import pandas as pd

# Set the features
df = pd.DataFrame(data.data, columns=data.feature_names)

# Set the target
target = pd.DataFrame(data.target, columns=["MEDV"])
Op dit punt moet je een paar belangrijke dingen over lineaire regressie overwegen voordat je het op de data toepast. Je had dit eerder in de tutorial kunnen bestuderen, maar deze factoren juist nu doornemen helpt om het echt te laten landen.
Laten we nu praktisch aan de slag gaan. Om het simpel te houden neem je alleen de feature RM — het gemiddelde aantal kamers. Merk op dat Statsmodels standaard geen constante term toevoegt (denk aan de factor θ0). Laten we het eerst zonder de constante term in je regressiemodel bekijken:
X = df["RM"]
y = target["MEDV"]

# Fit and make the predictions by the model
model = sm.OLS(y, X).fit()
predictions = model.predict(X)

# Print out the statistics
model.summary()

Wat is dit voor output! Het is veel te groot om in één keer te begrijpen als je het voor het eerst ziet. Laten we stap voor stap door de belangrijkste punten gaan:
OLS gebruikt om je lineaire regressiemodel te trainen. RM met 1 toeneemt, de voorspelde waarde van MEDV met 3,634 toeneemt. Dit zijn de belangrijkste punten om voorlopig op te letten (en je kunt de waarschuwing ook negeren).
Een constante term kan eenvoudig aan het lineaire regressiemodel worden toegevoegd. Dat kan met X = sm.add_constant(X) (X is de naam van de dataframe met de input/afhankelijke variabelen).
X = sm.add_constant(X)

model = sm.OLS(y, X).fit()
predictions = model.predict(X)

model.summary()

Je ziet duidelijk dat het toevoegen van de constante term een direct effect heeft op de coëfficiënt. Zonder de constante term ging je model door de oorsprong, maar nu heb je een y-intercept op -34,67. De helling van de RM-predictor is nu ook veranderd van 3,634 naar 9,1021 (coef van RM).
Nu ga je een regressiemodel met meer dan één variabele fitten — je voegt LSTAT (percentage lagere sociaaleconomische status) toe naast de variabele RM. De trainingsprocedure (fitten) blijft exact hetzelfde als eerder:
X = df[["RM", "LSTAT"]]
y = target["MEDV"]

model = sm.OLS(y, X).fit()
predictions = model.predict(X)

model.summary()

Laten we deze nu interpreteren:
Dit model heeft een veel hogere R-squared-waarde — 0,948, wat in feite betekent dat dit model 94,8% van de variantie in de afhankelijke variabele verklaart. Laten we nu proberen de relatie tussen de twee variabelen RM en LSTAT en de mediane huizenwaarde te achterhalen. Als RM met 1 toeneemt, zal MEDV met 4,9069 toenemen, en wanneer LSTAT met 1 toeneemt, zal MEDV met 0,6557 afnemen. Dit geeft aan dat RM en LSTAT statistisch significant zijn in het voorspellen (of schatten) van de mediane huizenwaarde.
Je kunt deze relatie ook in gewoon Nederlands verwoorden:
Dat klinkt logischer nu! Toch?
Dit was het voorbeeld van zowel enkelvoudige als meervoudige lineaire regressie in Statsmodels. Je huiswerk is om de resultaten verder te onderzoeken en te interpreteren met extra features.
Vervolgens bekijken we hoe lineaire regressie kan worden geïmplementeerd met je eigen scikit-learn. Je hebt de dataset al geïmporteerd, maar je moet nog de klasse linear_model importeren.
from sklearn import linear_model
X = df
y = target["MEDV"]

lm = linear_model.LinearRegression()
model = lm.fit(X,y)
De modeltraining is voltooid. Deze sklearn-implementatie gebruikt ook OLS. Laten we wat voorspellingen van MEDV-waarden maken voor de eerste vijf samples.
predictions = lm.predict(X)
print(predictions[0:5])
[30.00821269 25.0298606 30.5702317 28.60814055 27.94288232]
Als je meer details (zoals de R-squared, coëfficiënten, enz.) over je model wilt weten, kan dat eenvoudig.
lm.score(X,y)
0.7406077428649427
lm.coef_
array([-1.07170557e-01,  4.63952195e-02,  2.08602395e-02,  2.68856140e+00,
       -1.77957587e+01,  3.80475246e+00,  7.51061703e-04, -1.47575880e+00,
        3.05655038e-01, -1.23293463e-02, -9.53463555e-01,  9.39251272e-03,
       -5.25466633e-01])
Mooi! Je bent tot het einde gekomen. Een van de simpelste en meest fundamentele algoritmen behandelen was niet makkelijk, maar je hebt het prima gedaan. Je raakte niet alleen vertrouwd met eenvoudige lineaire regressie, maar je bestudeerde ook veel fundamentele aspecten, termen en factoren van machine learning. Je deed bovendien een diepgaande casestudy in Python.
Deze tutorial kan ook dienen als motivatie om lineaire regressie from scratch te implementeren. Hieronder de beknopte stappen voor wie dat echt wil doen:
Hieronder enkele referenties die zijn gebruikt bij het voorbereiden van deze tutorial:
Wil je meer leren over lineaire classificatoren, volg dan de cursus Linear Classifiers in Python van DataCamp.
Bekijk ook onze Tutorial over de normale vergelijking voor lineaire regressie.
Python-cursussen
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min

