{count, plural, one {Kursus} other {Kursus}}
Memahami Machine Learning
{hours} jam
312K
Pada dua tutorial Kaggle sebelumnya, Anda telah mempelajari cara menyiapkan data untuk membangun model machine learning pertama Anda, menggunakan Analisis Data Eksploratif dan model machine learning baseline. Selanjutnya, Anda berhasil membangun model machine learning pertama Anda, yaitu decision tree classifier. Anda mengirimkan semua model ini ke Kaggle dan menafsirkan akurasinya.
Dalam tutorial ketiga ini, Anda akan mempelajari lebih lanjut tentang rekayasa fitur (feature engineering), sebuah proses di mana Anda menggunakan pengetahuan domain atas data Anda untuk membuat fitur-fitur relevan tambahan yang meningkatkan daya prediksi algoritme pembelajaran dan membuat model machine learning Anda berkinerja lebih baik!
Secara lebih spesifik,
Sebelum mulai, Anda akan melakukan seluruh import seperti pada tutorial sebelumnya, menggunakan magic IPython untuk memastikan gambar dihasilkan inline di Jupyter Notebook dan mengatur gaya visualisasi. Selanjutnya, Anda dapat mengimpor data dan memastikan variabel target dari data pelatihan disimpan di tempat yang aman. Setelah itu, Anda menggabungkan set data train dan test (kecuali kolom 'Survived' dari df_train) dan menyimpan hasilnya di data.
Ingat Anda melakukan ini karena ingin memastikan setiap pra-pemrosesan yang Anda lakukan pada data tercermin di kedua set train dan test!
Terakhir, Anda menggunakan metode .info() untuk melihat data Anda:
# Imports
import pandas as pd
import matplotlib.pyplot as plt
import seaborn as sns
import re
import numpy as np
from sklearn import tree
from sklearn.model_selection import GridSearchCV

# Figures inline and set visualization style
%matplotlib inline
sns.set()

# Import data
df_train = pd.read_csv('data/train.csv')
df_test = pd.read_csv('data/test.csv')

# Store target variable of training data in a safe place
survived_train = df_train.Survived

# Concatenate training and test sets
data = pd.concat([df_train.drop(['Survived'], axis=1), df_test])

# View head
data.info()
<class 'pandas.core.frame.DataFrame'>
Int64Index: 1309 entries, 0 to 417
Data columns (total 11 columns):
PassengerId    1309 non-null int64
Pclass         1309 non-null int64
Name           1309 non-null object
Sex            1309 non-null object
Age            1046 non-null float64
SibSp          1309 non-null int64
Parch          1309 non-null int64
Ticket         1309 non-null object
Fare           1308 non-null float64
Cabin          295 non-null object
Embarked       1307 non-null object
dtypes: float64(2), int64(4), object(5)
memory usage: 122.7+ KBAnda melakukan rekayasa fitur untuk mengekstrak lebih banyak informasi dari data, sehingga Anda dapat meningkatkan performa saat membangun model.
Mari kita lihat contohnya. Periksa kolom 'Name' dengan bantuan metode .tail(), yang membantu Anda melihat lima baris terakhir dari data:
# View head of 'Name' column
data.Name.tail()
413              Spector, Mr. Woolf
414    Oliva y Ocana, Dona. Fermina
415    Saether, Mr. Simon Sivertsen
416             Ware, Mr. Frederick
417        Peter, Master. Michael J
Name: Name, dtype: object
Tiba-tiba, Anda melihat gelar yang berbeda-beda muncul! Dengan kata lain, kolom ini berisi string atau teks yang memuat gelar, seperti 'Mr', 'Master', dan 'Dona'.
Gelar ini tentu memberi informasi tentang status sosial, pekerjaan, dan sebagainya, yang pada akhirnya dapat memberi petunjuk lebih lanjut tentang peluang selamat.
Sekilas, memisahkan nama dari gelar tampak sulit, tetapi jangan panik! Ingat, Anda dapat dengan mudah menggunakan regular expression untuk mengekstrak gelar dan menyimpannya di kolom baru 'Title':
# Extract Title from Name, store in column and plot barplot
data['Title'] = data.Name.apply(lambda x: re.search(' ([A-Z][a-z]+)\.', x).group(1))
sns.countplot(x='Title', data=data);
plt.xticks(rotation=45);
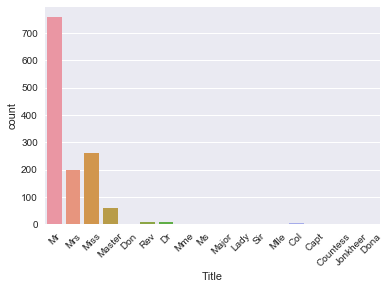
Catatan bahwa kolom baru 'Title' ini sebenarnya adalah fitur baru untuk set data Anda!
Tip: untuk mempelajari lebih lanjut tentang regular expression, lihat tulisan saya tentang acara FB Live code along kami sebelumnya atau lihat Tutorial Regular Expression Python dari DataCamp.
Anda dapat melihat ada beberapa gelar pada plot di atas dan banyak yang tidak terlalu sering muncul. Jadi, masuk akal untuk mengelompokkannya menjadi lebih sedikit kategori.
Misalnya, Anda mungkin ingin mengganti 'Mlle' dan 'Ms' menjadi 'Miss' serta 'Mme' menjadi 'Mrs', karena ini adalah gelar dalam bahasa Prancis dan idealnya Anda menginginkan semua data dalam satu bahasa. Selanjutnya, Anda juga mengelompokkan sejumlah gelar yang tidak dapat segera dikategorikan ke dalam satu kelompok bernama 'Special'.
Tip: cobalah bereksperimen untuk melihat bagaimana kinerja algoritme Anda sebagai fungsinya!
Berikutnya, Anda menampilkan barplot dari hasilnya dengan bantuan metode .countplot():
data['Title'] = data['Title'].replace({'Mlle':'Miss', 'Mme':'Mrs', 'Ms':'Miss'})
data['Title'] = data['Title'].replace(['Don', 'Dona', 'Rev', 'Dr',
                                            'Major', 'Lady', 'Sir', 'Col', 'Capt', 'Countess', 'Jonkheer'],'Special')
sns.countplot(x='Title', data=data);
plt.xticks(rotation=45);
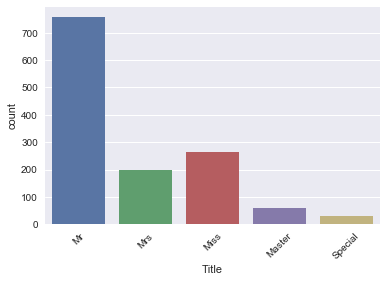
Inilah tampilan fitur baru hasil rekayasa Anda, yaitu 'Title'!
Sekarang, pastikan Anda memiliki kolom 'Title' dan periksa lagi data Anda dengan metode .tail():
# View head of data
data.tail()
| PassengerId | Pclass | Name | Sex | Age | SibSp | Parch | Ticket | Fare | Cabin | Embarked | Title | |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 413 | 1305 | 3 | Spector, Mr. Woolf | male | NaN | 0 | 0 | A.5. 3236 | 8.0500 | NaN | S | Mr |
| 414 | 1306 | 1 | Oliva y Ocana, Dona. Fermina | female | 39.0 | 0 | 0 | PC 17758 | 108.9000 | C105 | C | Special |
| 415 | 1307 | 3 | Saether, Mr. Simon Sivertsen | male | 38.5 | 0 | 0 | SOTON/O.Q. 3101262 | 7.2500 | NaN | S | Mr |
| 416 | 1308 | 3 | Ware, Mr. Frederick | male | NaN | 0 | 0 | 359309 | 8.0500 | NaN | S | Mr |
| 417 | 1309 | 3 | Peter, Master. Michael J | male | NaN | 1 | 1 | 2668 | 22.3583 | NaN | C | Master |
Saat Anda memuat data dan memeriksanya, Anda melihat ada beberapa NaN atau nilai hilang di kolom 'Cabin'.
Masuk akal untuk mengasumsikan bahwa mereka yang NaN tidak memiliki kabin, yang dapat memberi informasi tentang 'Survival'. Jadi, mari kita buat kolom baru 'Has_Cabin' yang mengodekan informasi ini dan memberi tahu apakah penumpang memiliki kabin atau tidak.
Catatan bahwa Anda menggunakan metode .isnull() pada cuplikan kode di bawah, yang akan mengembalikan True jika penumpang tidak memiliki kabin dan False jika sebaliknya. Namun, karena Anda ingin menyimpan hasilnya di kolom 'Has_Cabin', Anda sebenarnya ingin membalik hasilnya: Anda ingin mengembalikan True jika penumpang memiliki kabin. Itulah mengapa Anda menggunakan tilde ~.
# Did they have a Cabin?
data['Has_Cabin'] = ~data.Cabin.isnull()

# View head of data
data.head()
| PassengerId | Pclass | Name | Sex | Age | SibSp | Parch | Ticket | Fare | Cabin | Embarked | Title | Has_Cabin | |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 0 | 1 | 3 | Braund, Mr. Owen Harris | male | 22.0 | 1 | 0 | A/5 21171 | 7.2500 | NaN | S | Mr | False |
| 1 | 2 | 1 | Cumings, Mrs. John Bradley (Florence Briggs Th... | female | 38.0 | 1 | 0 | PC 17599 | 71.2833 | C85 | C | Mrs | True |
| 2 | 3 | 3 | Heikkinen, Miss. Laina | female | 26.0 | 0 | 0 | STON/O2. 3101282 | 7.9250 | NaN | S | Miss | False |
| 3 | 4 | 1 | Futrelle, Mrs. Jacques Heath (Lily May Peel) | female | 35.0 | 1 | 0 | 113803 | 53.1000 | C123 | S | Mrs | True |
| 4 | 5 | 3 | Allen, Mr. William Henry | male | 35.0 | 0 | 0 | 373450 | 8.0500 | NaN | S | Mr | False |
Yang ingin Anda lakukan sekarang adalah menghapus sejumlah kolom yang tidak lagi memuat informasi berguna (atau yang tidak yakin cara menanganinya). Dalam hal ini, Anda melihat kolom seperti ['Cabin', 'Name', 'PassengerId', 'Ticket'], karena
'Has_Cabin';'Name';'PassengerId' dan 'Ticket' karena kemungkinan besar tidak memberikan informasi tambahan tentang peluang selamat penumpang Titanic.Tip bisa jadi ada lebih banyak informasi dalam kolom 'Cabin', tetapi untuk tutorial ini, Anda mengasumsikan tidak ada!
Untuk menghapus kolom-kolom ini dari DataFrame data Anda, pastikan menggunakan argumen inplace pada metode .drop() dan set ke True:
# Drop columns and view head
data.drop(['Cabin', 'Name', 'PassengerId', 'Ticket'], axis=1, inplace=True)
data.head()
| Pclass | Sex | Age | SibSp | Parch | Fare | Embarked | Title | Has_Cabin | |
|---|---|---|---|---|---|---|---|---|---|
| 0 | 3 | male | 22.0 | 1 | 0 | 7.2500 | S | Mr | False |
| 1 | 1 | female | 38.0 | 1 | 0 | 71.2833 | C | Mrs | True |
| 2 | 3 | female | 26.0 | 0 | 0 | 7.9250 | S | Miss | False |
| 3 | 1 | female | 35.0 | 1 | 0 | 53.1000 | S | Mrs | True |
| 4 | 3 | male | 35.0 | 0 | 0 | 8.0500 | S | Mr | False |
Selamat! Anda telah berhasil merekayasa beberapa fitur baru seperti 'Title' dan 'Has_Cabin' serta memastikan fitur-fitur yang tidak menambah informasi berguna bagi model machine learning kini dihapus dari DataFrame Anda!
Berikutnya, Anda ingin menangani nilai hilang, melakukan pembinningan pada data numerik, dan mengubah semua fitur menjadi variabel numerik menggunakan .get_dummies() lagi. Terakhir, Anda akan membangun model final untuk tutorial ini. Lihat bagaimana semua ini dilakukan pada bagian selanjutnya!
Dengan semua perubahan yang Anda lakukan pada DataFrame data asli, ada baiknya memeriksa apakah masih ada nilai hilang dengan .info():
data.info()
<class 'pandas.core.frame.DataFrame'>
Int64Index: 1309 entries, 0 to 417
Data columns (total 9 columns):
Pclass       1309 non-null int64
Sex          1309 non-null object
Age          1046 non-null float64
SibSp        1309 non-null int64
Parch        1309 non-null int64
Fare         1308 non-null float64
Embarked     1307 non-null object
Title        1309 non-null object
Has_Cabin    1309 non-null bool
dtypes: bool(1), float64(2), int64(3), object(3)
memory usage: 133.3+ KB
Hasil dari baris kode di atas memberi tahu Anda bahwa ada nilai hilang pada 'Age', 'Fare', dan 'Embarked'.
Ingat Anda dapat dengan mudah melihat ini dengan terlebih dahulu melihat jumlah total entri (1309) lalu memeriksa jumlah nilai non-null pada kolom-kolom yang tercantum oleh .info(). Dalam kasus ini, Anda melihat 'Age' memiliki 1046 nilai non-null, yang berarti ada 263 nilai hilang. Demikian pula, 'Fare' hanya memiliki satu nilai hilang dan 'Embarked' memiliki dua nilai hilang.
Sama seperti pada tutorial sebelumnya, Anda akan melakukan imputasi nilai hilang dengan bantuan .fillna():
Catatan bahwa sekali lagi Anda menggunakan median untuk mengisi kolom 'Age' dan 'Fare' karena cocok untuk menangani outlier. Cara lain untuk mengimputasi nilai hilang adalah menggunakan mean, yang dapat diperoleh dengan menjumlahkan semua titik data dan membaginya dengan jumlah titik data, atau mode, yaitu angka yang paling sering muncul.
Anda mengisi dua nilai hilang pada kolom 'Embarked' dengan 'S', yang merupakan singkatan dari Southampton, karena nilai ini paling umum di antara semua nilai pada kolom tersebut.
Tip: Anda dapat memeriksa ulang dengan melakukan lebih banyak Analisis Data Eksploratif!
# Impute missing values for Age, Fare, Embarked
data['Age'] = data.Age.fillna(data.Age.median())
data['Fare'] = data.Fare.fillna(data.Fare.median())
data['Embarked'] = data['Embarked'].fillna('S')
data.info()
<class 'pandas.core.frame.DataFrame'>
Int64Index: 1309 entries, 0 to 417
Data columns (total 9 columns):
Pclass       1309 non-null int64
Sex          1309 non-null object
Age          1309 non-null float64
SibSp        1309 non-null int64
Parch        1309 non-null int64
Fare         1309 non-null float64
Embarked     1309 non-null object
Title        1309 non-null object
Has_Cabin    1309 non-null bool
dtypes: bool(1), float64(2), int64(3), object(3)
memory usage: 133.3+ KB
data.head()
| Pclass | Sex | Age | SibSp | Parch | Fare | Embarked | Title | Has_Cabin | |
|---|---|---|---|---|---|---|---|---|---|
| 0 | 3 | male | 22.0 | 1 | 0 | 7.2500 | S | Mr | False |
| 1 | 1 | female | 38.0 | 1 | 0 | 71.2833 | C | Mrs | True |
| 2 | 3 | female | 26.0 | 0 | 0 | 7.9250 | S | Miss | False |
| 3 | 1 | female | 35.0 | 1 | 0 | 53.1000 | S | Mrs | True |
| 4 | 3 | male | 35.0 | 0 | 0 | 8.0500 | S | Mr | False |
Berikutnya, Anda ingin melakukan binning pada data numerik, karena Anda memiliki rentang usia dan tarif (fare). Namun, bisa jadi ada fluktuasi pada angka-angka tersebut yang tidak mencerminkan pola pada data, yang mungkin merupakan noise. Itulah mengapa Anda akan menempatkan orang-orang dalam rentang usia atau tarif tertentu ke dalam bin yang sama. Anda dapat melakukannya dengan menggunakan fungsi pandas qcut() untuk melakukan binning data numerik:
# Binning numerical columns
data['CatAge'] = pd.qcut(data.Age, q=4, labels=False )
data['CatFare']= pd.qcut(data.Fare, q=4, labels=False)
data.head()
| Pclass | Sex | Age | SibSp | Parch | Fare | Embarked | Title | Has_Cabin | CatAge | CatFare | |
|---|---|---|---|---|---|---|---|---|---|---|---|
| 0 | 3 | male | 22.0 | 1 | 0 | 7.2500 | S | Mr | False | 0 | 0 |
| 1 | 1 | female | 38.0 | 1 | 0 | 71.2833 | C | Mrs | True | 3 | 3 |
| 2 | 3 | female | 26.0 | 0 | 0 | 7.9250 | S | Miss | False | 1 | 1 |
| 3 | 1 | female | 35.0 | 1 | 0 | 53.1000 | S | Mrs | True | 2 | 3 |
| 4 | 3 | male | 35.0 | 0 | 0 | 8.0500 | S | Mr | False | 2 | 1 |
Catatan bahwa Anda memasukkan data sebagai Series, data.Age dan data.Fare, kemudian menentukan jumlah kuantil, q=4. Terakhir, Anda mengatur argumen labels ke False untuk mengodekan bin sebagai angka.
Sekarang setelah semua informasi berada dalam bin, Anda dapat dengan aman menghapus kolom 'Age' dan 'Fare'. Jangan lupa untuk memeriksa lima baris pertama data Anda!
data = data.drop(['Age', 'Fare'], axis=1)
data.head()
| Pclass | Sex | SibSp | Parch | Embarked | Title | Has_Cabin | CatAge | CatFare | |
|---|---|---|---|---|---|---|---|---|---|
| 0 | 3 | male | 1 | 0 | S | Mr | False | 0 | 0 |
| 1 | 1 | female | 1 | 0 | C | Mrs | True | 3 | 3 |
| 2 | 3 | female | 0 | 0 | S | Miss | False | 1 | 1 |
| 3 | 1 | female | 1 | 0 | S | Mrs | True | 2 | 3 |
| 4 | 3 | male | 0 | 0 | S | Mr | False | 2 | 1 |
Hal berikutnya yang dapat Anda lakukan adalah membuat kolom baru, yaitu jumlah anggota keluarga yang berada di atas kapal Titanic. Dalam tutorial ini, Anda tidak akan masuk ke bagian ini dan melihat bagaimana model berkinerja tanpa kolom tersebut. Jika Anda ingin memeriksa bagaimana kinerja model dengan kolom tambahan ini, jalankan baris kode berikut:
# Create column of number of Family members onboard
data['Fam_Size'] = data.Parch + data.SibSp
Untuk saat ini, Anda akan langsung menghapus kolom 'SibSp' dan 'Parch' dari DataFrame Anda:
# Drop columns
data = data.drop(['SibSp','Parch'], axis=1)
data.head()
| Pclass | Sex | Embarked | Title | Has_Cabin | CatAge | CatFare | |
|---|---|---|---|---|---|---|---|
| 0 | 3 | male | S | Mr | False | 0 | 0 |
| 1 | 1 | female | C | Mrs | True | 3 | 3 |
| 2 | 3 | female | S | Miss | False | 1 | 1 |
| 3 | 1 | female | S | Mrs | True | 2 | 3 |
| 4 | 3 | male | S | Mr | False | 2 | 1 |
Sekarang Anda telah merekayasa lebih banyak fitur, seperti 'Title' dan 'Has_Cabin', serta menangani nilai hilang, melakukan binning pada data numerik, saatnya mengubah semua variabel menjadi numerik. Anda melakukannya karena model machine learning umumnya menerima input numerik.
Seperti yang telah Anda lakukan sebelumnya, Anda akan menggunakan .get_dummies() untuk melakukannya:
# Transform into binary variables
data_dum = pd.get_dummies(data, drop_first=True)
data_dum.head()
| Pclass | Has_Cabin | CatAge | CatFare | Sex_male | Embarked_Q | Embarked_S | Title_Miss | Title_Mr | Title_Mrs | Title_Special | |
|---|---|---|---|---|---|---|---|---|---|---|---|
| 0 | 3 | False | 0 | 0 | 1 | 0 | 1 | 0 | 1 | 0 | 0 |
| 1 | 1 | True | 3 | 3 | 0 | 0 | 0 | 0 | 0 | 1 | 0 |
| 2 | 3 | False | 1 | 1 | 0 | 0 | 1 | 1 | 0 | 0 | 0 |
| 3 | 1 | True | 2 | 3 | 0 | 0 | 1 | 0 | 0 | 1 | 0 |
| 4 | 3 | False | 2 | 1 | 1 | 0 | 1 | 0 | 1 | 0 | 0 |
Dengan semua ini selesai, saatnya membangun model final Anda!
Seperti sebelumnya, Anda akan terlebih dahulu membagi kembali data menjadi set pelatihan dan pengujian. Lalu, Anda mengubahnya menjadi array:
# Split into test.train
data_train = data_dum.iloc[:891]
data_test = data_dum.iloc[891:]

# Transform into arrays for scikit-learn
X = data_train.values
test = data_test.values
y = survived_train.values
Sekarang Anda akan membangun decision tree pada dataset baru hasil rekayasa fitur Anda. Untuk memilih hyperparameter max_depth, Anda akan menggunakan variasi dari pemisahan train-test yang disebut "cross validation".
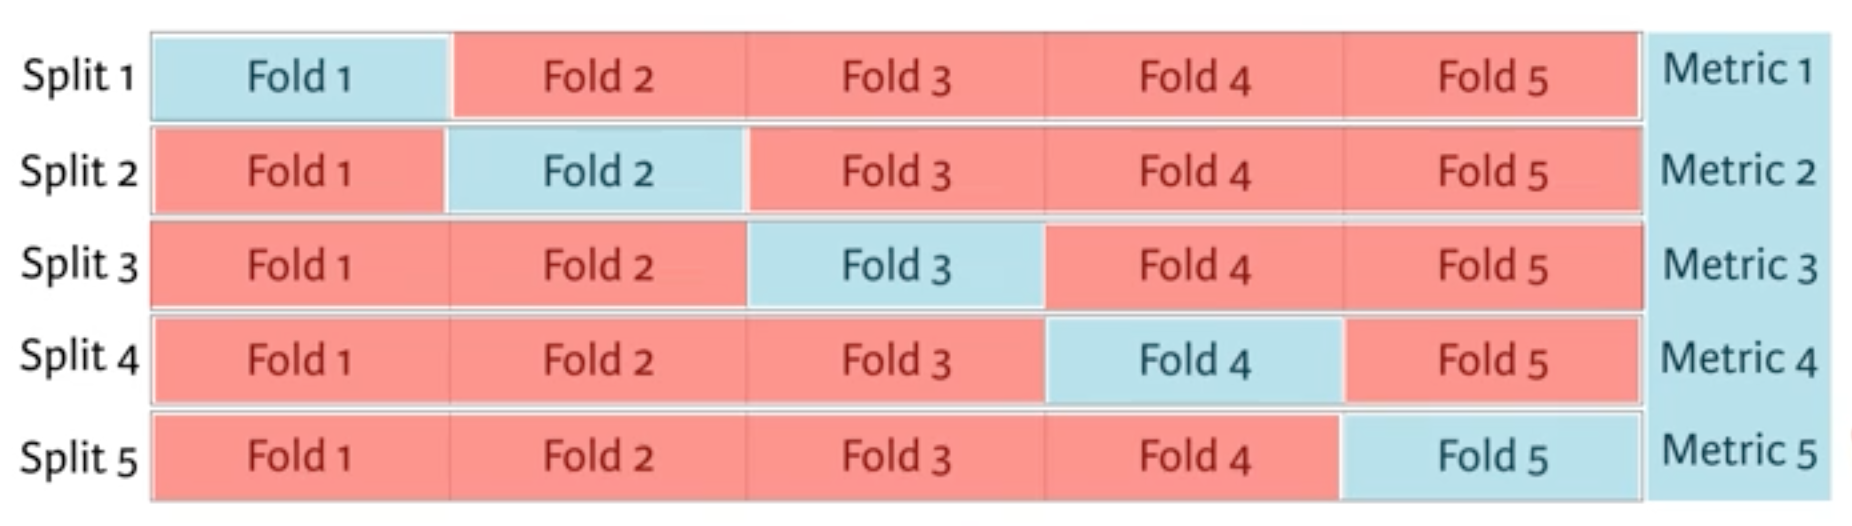
Anda mulai dengan membagi dataset menjadi 5 grup atau fold. Lalu Anda menyisihkan fold pertama sebagai set uji, melatih model pada empat fold lainnya, memprediksi pada set uji, dan menghitung metrik yang diminati. Berikutnya, Anda menyisihkan fold kedua sebagai set uji, melatih pada sisa data, memprediksi pada set uji, dan menghitung metriknya. Lalu demikian pula untuk fold ketiga, keempat, dan kelima.
Hasilnya, Anda mendapatkan lima nilai akurasi, dari mana Anda dapat menghitung statistik yang diminati, seperti median dan/atau mean serta interval kepercayaan 95%.
Anda melakukan ini untuk setiap nilai dari setiap hyperparameter yang Anda tuning dan memilih set hyperparameter yang berkinerja terbaik. Ini disebut grid search.
Cukup tentang itu untuk saat ini, mari lanjut!
Pada bagian berikut, Anda akan menggunakan cross validation dan grid search untuk memilih max_depth terbaik untuk dataset baru hasil rekayasa fitur Anda:
# Setup the hyperparameter grid
dep = np.arange(1,9)
param_grid = {'max_depth' : dep}

# Instantiate a decision tree classifier: clf
clf = tree.DecisionTreeClassifier()

# Instantiate the GridSearchCV object: clf_cv
clf_cv = GridSearchCV(clf, param_grid=param_grid, cv=5)

# Fit it to the data
clf_cv.fit(X, y)

# Print the tuned parameter and score
print("Tuned Decision Tree Parameters: {}".format(clf_cv.best_params_))
print("Best score is {}".format(clf_cv.best_score_))
Tuned Decision Tree Parameters: {'max_depth': 3}
Best score is 0.8103254769921436
Sekarang, Anda dapat membuat prediksi pada set uji, membuat kolom baru 'Survived' dan menyimpan prediksi Anda di dalamnya. Jangan lupa untuk menyimpan kolom 'PassengerId' dan 'Survived' dari df_test ke .csv dan mengirimkannya ke Kaggle!
Y_pred = clf_cv.predict(test)
df_test['Survived'] = Y_pred
df_test[['PassengerId', 'Survived']].to_csv('data/predictions/dec_tree_feat_eng.csv', index=False)
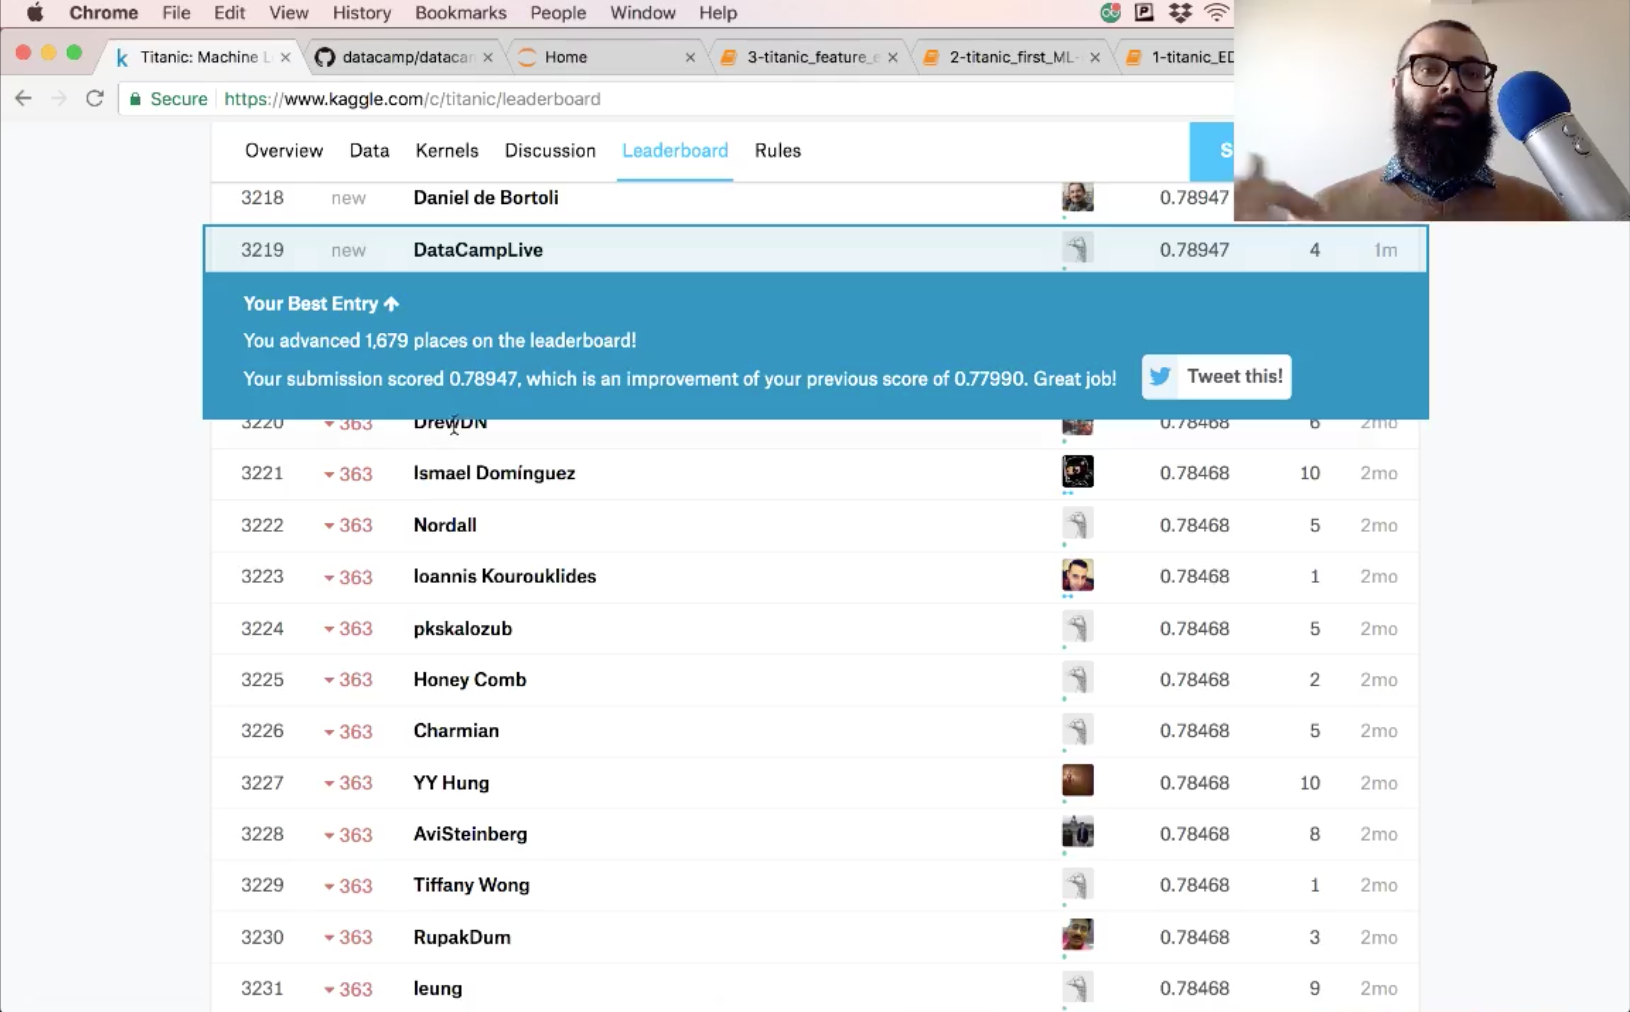
Akurasi kiriman Anda adalah 78,9.
Cobalah melakukan lebih banyak rekayasa fitur dan uji beberapa model baru untuk meningkatkan skor ini. Notebook ini, bersama dengan dua sebelumnya, diposting di GitHub dan akan sangat bagus jika Anda semua dapat meningkatkan model-model ini.
Masih banyak pra-pemrosesan lain yang ingin Anda pelajari, seperti penskalaan data. Anda juga akan menemukan pipeline scikit-learn sangat berguna. Lihat kursus Supervised Learning dengan scikit-learn kami dan dokumentasi scikit-learn untuk semua ini dan lebih banyak lagi.
Kursus Machine Learning
{count, plural, one {Kursus} other {Kursus}}
{count, plural, one {Kursus} other {Kursus}}
{count, plural, one {Kursus} other {Kursus}}
{count, plural, one {blog} other {blogs}}
David Woods
13 mnt
{count, plural, one {blog} other {blogs}}
Hugo Bowne-Anderson
13 mnt
{count, plural, one {blog} other {blogs}}
Dario Radečić
15 mnt
{count, plural, one {blog} other {blogs}}
Javier Canales Luna
14 mnt



