Curso
Comprender el machine learning
2 h
308K
En los dos tutoriales anteriores de Kaggle, aprendiste a dejar tus datos listos para construir tu primer modelo de machine learning usando análisis exploratorio de datos y modelos base de machine learning. Después, conseguiste construir tu primer modelo, un clasificador de árbol de decisión. Enviaste todos estos modelos a Kaggle e interpretaste su accuracy.
En este tercer tutorial, verás en detalle la ingeniería de características, un proceso en el que usas el conocimiento del dominio de tus datos para crear características adicionales relevantes que aumenten el poder predictivo del algoritmo y hagan que tus modelos de machine learning rindan aún mejor.
En concreto,
Antes de nada, harás todas las importaciones, igual que en el tutorial anterior, usarás algo de magia de IPython para asegurarte de que las figuras se generan inline en el Jupyter Notebook y establecerás el estilo de visualización. A continuación, importarás tus datos y te asegurarás de guardar la variable objetivo del conjunto de entrenamiento en un lugar seguro. Después, fusionarás los conjuntos de train y test (a excepción de la columna 'Survived' de df_train) y guardarás el resultado en data.
Recuerda que haces esto para que cualquier preprocesado que apliques se refleje tanto en train como en test.
Por último, usa el método .info() para echar un vistazo a tus datos:
# Imports
import pandas as pd
import matplotlib.pyplot as plt
import seaborn as sns
import re
import numpy as np
from sklearn import tree
from sklearn.model_selection import GridSearchCV

# Figures inline and set visualization style
%matplotlib inline
sns.set()

# Import data
df_train = pd.read_csv('data/train.csv')
df_test = pd.read_csv('data/test.csv')

# Store target variable of training data in a safe place
survived_train = df_train.Survived

# Concatenate training and test sets
data = pd.concat([df_train.drop(['Survived'], axis=1), df_test])

# View head
data.info()
<class 'pandas.core.frame.DataFrame'>
Int64Index: 1309 entries, 0 to 417
Data columns (total 11 columns):
PassengerId    1309 non-null int64
Pclass         1309 non-null int64
Name           1309 non-null object
Sex            1309 non-null object
Age            1046 non-null float64
SibSp          1309 non-null int64
Parch          1309 non-null int64
Ticket         1309 non-null object
Fare           1308 non-null float64
Cabin          295 non-null object
Embarked       1307 non-null object
dtypes: float64(2), int64(4), object(5)
memory usage: 122.7+ KBHaces ingeniería de características para extraer más información de tus datos y así llevar la delantera a la hora de construir modelos.
Veámoslo con un ejemplo. Echa un ojo a la columna 'Name' con .tail(), que te muestra las cinco últimas filas de tus datos:
# View head of 'Name' column
data.Name.tail()
413              Spector, Mr. Woolf
414    Oliva y Ocana, Dona. Fermina
415    Saether, Mr. Simon Sivertsen
416             Ware, Mr. Frederick
417        Peter, Master. Michael J
Name: Name, dtype: object
De repente aparecen distintos títulos. Es decir, esta columna contiene textos con títulos como "Mr", "Master" o "Dona".
Estos títulos aportan información sobre el estatus social, la profesión, etc., que al final podrían decirte algo sobre la supervivencia.
A primera vista, podría parecer complicado separar nombres y títulos, pero no te preocupes. Puedes usar expresiones regulares para extraer el título y guardarlo en una nueva columna 'Title':
# Extract Title from Name, store in column and plot barplot
data['Title'] = data.Name.apply(lambda x: re.search(' ([A-Z][a-z]+)\.', x).group(1))
sns.countplot(x='Title', data=data);
plt.xticks(rotation=45);
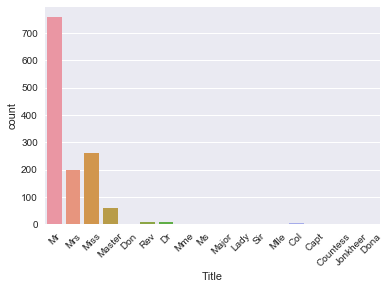
Nota: esta nueva columna 'Title' es en realidad una nueva característica para tu dataset.
Consejo: si quieres aprender más sobre expresiones regulares, echa un vistazo a mi resumen de nuestro último evento FB Live de code along o al tutorial de expresiones regulares en Python de DataCamp.
Como ves, hay varios títulos en el gráfico y muchos aparecen muy pocas veces. Tiene sentido agruparlos en menos categorías.
Por ejemplo, probablemente quieras sustituir 'Mlle' y 'Ms' por 'Miss' y 'Mme' por 'Mrs', ya que son títulos franceses y, en ideal, quieres tus datos en un solo idioma. Después, puedes agrupar un conjunto de títulos difíciles de categorizar en una categoría 'Special'.
Consejo: prueba distintas agrupaciones para ver cómo cambia el rendimiento del algoritmo.
Ahora, visualiza el resultado con .countplot():
data['Title'] = data['Title'].replace({'Mlle':'Miss', 'Mme':'Mrs', 'Ms':'Miss'})
data['Title'] = data['Title'].replace(['Don', 'Dona', 'Rev', 'Dr',
                                            'Major', 'Lady', 'Sir', 'Col', 'Capt', 'Countess', 'Jonkheer'],'Special')
sns.countplot(x='Title', data=data);
plt.xticks(rotation=45);
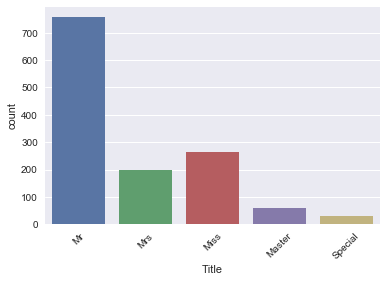
Así queda tu nueva característica 'Title'.
Ahora asegúrate de que tienes la columna 'Title' y vuelve a revisar tus datos con .tail():
# View head of data
data.tail()
| PassengerId | Pclass | Name | Sex | Age | SibSp | Parch | Ticket | Fare | Cabin | Embarked | Title | |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 413 | 1305 | 3 | Spector, Mr. Woolf | male | NaN | 0 | 0 | A.5. 3236 | 8.0500 | NaN | S | Mr |
| 414 | 1306 | 1 | Oliva y Ocana, Dona. Fermina | female | 39.0 | 0 | 0 | PC 17758 | 108.9000 | C105 | C | Special |
| 415 | 1307 | 3 | Saether, Mr. Simon Sivertsen | male | 38.5 | 0 | 0 | SOTON/O.Q. 3101262 | 7.2500 | NaN | S | Mr |
| 416 | 1308 | 3 | Ware, Mr. Frederick | male | NaN | 0 | 0 | 359309 | 8.0500 | NaN | S | Mr |
| 417 | 1309 | 3 | Peter, Master. Michael J | male | NaN | 1 | 1 | 2668 | 22.3583 | NaN | C | Master |
Cuando cargaste los datos y los inspeccionaste, viste que había varios NaN o valores ausentes en la columna 'Cabin'.
Es razonable suponer que esos NaN corresponden a personas sin camarote, lo cual podría decirte algo sobre 'Survival'. Así que vamos a crear una nueva columna 'Has_Cabin' que codifique si los pasajeros tenían camarote o no.
Nota: en el siguiente fragmento usas .isnull(), que devuelve True si el pasajero no tiene camarote y False en caso contrario. Pero como quieres guardar el resultado en 'Has_Cabin', te interesa invertirlo: quieres True si el pasajero tiene camarote. Por eso se utiliza la virgulilla ~.
# Did they have a Cabin?
data['Has_Cabin'] = ~data.Cabin.isnull()

# View head of data
data.head()
| PassengerId | Pclass | Name | Sex | Age | SibSp | Parch | Ticket | Fare | Cabin | Embarked | Title | Has_Cabin | |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 0 | 1 | 3 | Braund, Mr. Owen Harris | male | 22.0 | 1 | 0 | A/5 21171 | 7.2500 | NaN | S | Mr | False |
| 1 | 2 | 1 | Cumings, Mrs. John Bradley (Florence Briggs Th... | female | 38.0 | 1 | 0 | PC 17599 | 71.2833 | C85 | C | Mrs | True |
| 2 | 3 | 3 | Heikkinen, Miss. Laina | female | 26.0 | 0 | 0 | STON/O2. 3101282 | 7.9250 | NaN | S | Miss | False |
| 3 | 4 | 1 | Futrelle, Mrs. Jacques Heath (Lily May Peel) | female | 35.0 | 1 | 0 | 113803 | 53.1000 | C123 | S | Mrs | True |
| 4 | 5 | 3 | Allen, Mr. William Henry | male | 35.0 | 0 | 0 | 373450 | 8.0500 | NaN | S | Mr | False |
Ahora quieres eliminar un conjunto de columnas que ya no aportan información útil (o que no sabes bien cómo aprovechar). En este caso, piensas en ['Cabin', 'Name', 'PassengerId', 'Ticket'], porque
'Has_Cabin';'Name';'PassengerId' y 'Ticket' probablemente no aporten nada sobre la supervivencia de los pasajeros del Titanic.Consejo: podría haber más información útil en 'Cabin', pero para este tutorial asumimos que no.
Para eliminar estas columnas del DataFrame data, usa el argumento inplace en .drop() y ponlo a True:
# Drop columns and view head
data.drop(['Cabin', 'Name', 'PassengerId', 'Ticket'], axis=1, inplace=True)
data.head()
| Pclass | Sex | Age | SibSp | Parch | Fare | Embarked | Title | Has_Cabin | |
|---|---|---|---|---|---|---|---|---|---|
| 0 | 3 | male | 22.0 | 1 | 0 | 7.2500 | S | Mr | False |
| 1 | 1 | female | 38.0 | 1 | 0 | 71.2833 | C | Mrs | True |
| 2 | 3 | female | 26.0 | 0 | 0 | 7.9250 | S | Miss | False |
| 3 | 1 | female | 35.0 | 1 | 0 | 53.1000 | S | Mrs | True |
| 4 | 3 | male | 35.0 | 0 | 0 | 8.0500 | S | Mr | False |
¡Bien hecho! Has creado nuevas características como 'Title' y 'Has_Cabin' y te has deshecho de las que no aportan información útil para tu modelo.
Ahora toca tratar los valores ausentes, agrupar en rangos tus variables numéricas y transformar todas las características en variables numéricas con .get_dummies(). Por último, construirás el modelo final del tutorial. ¡Vamos a ello!
Con todos los cambios aplicados al DataFrame data, es buena idea comprobar si quedan valores ausentes con .info():
data.info()
<class 'pandas.core.frame.DataFrame'>
Int64Index: 1309 entries, 0 to 417
Data columns (total 9 columns):
Pclass       1309 non-null int64
Sex          1309 non-null object
Age          1046 non-null float64
SibSp        1309 non-null int64
Parch        1309 non-null int64
Fare         1308 non-null float64
Embarked     1307 non-null object
Title        1309 non-null object
Has_Cabin    1309 non-null bool
dtypes: bool(1), float64(2), int64(3), object(3)
memory usage: 133.3+ KB
El resultado indica que hay valores ausentes en 'Age', 'Fare' y 'Embarked'.
Recuerda que puedes detectarlo fácilmente comparando el número total de filas (1309) con el número de valores no nulos en cada columna que muestra .info(). Aquí, 'Age' tiene 1046 valores no nulos, así que faltan 263. 'Fare' solo tiene un valor ausente y 'Embarked' tiene dos.
Como en el tutorial anterior, vas a imputar estos valores con .fillna():
Nota: de nuevo usas la mediana para rellenar 'Age' y 'Fare' porque es ideal cuando hay valores atípicos. Otras opciones serían la media o la moda.
Rellenas los dos valores ausentes de 'Embarked' con 'S' (Southampton), que es el valor más común en esa columna.
Consejo: puedes comprobarlo con algo más de análisis exploratorio.
# Impute missing values for Age, Fare, Embarked
data['Age'] = data.Age.fillna(data.Age.median())
data['Fare'] = data.Fare.fillna(data.Fare.median())
data['Embarked'] = data['Embarked'].fillna('S')
data.info()
<class 'pandas.core.frame.DataFrame'>
Int64Index: 1309 entries, 0 to 417
Data columns (total 9 columns):
Pclass       1309 non-null int64
Sex          1309 non-null object
Age          1309 non-null float64
SibSp        1309 non-null int64
Parch        1309 non-null int64
Fare         1309 non-null float64
Embarked     1309 non-null object
Title        1309 non-null object
Has_Cabin    1309 non-null bool
dtypes: bool(1), float64(2), int64(3), object(3)
memory usage: 133.3+ KB
data.head()
| Pclass | Sex | Age | SibSp | Parch | Fare | Embarked | Title | Has_Cabin | |
|---|---|---|---|---|---|---|---|---|---|
| 0 | 3 | male | 22.0 | 1 | 0 | 7.2500 | S | Mr | False |
| 1 | 1 | female | 38.0 | 1 | 0 | 71.2833 | C | Mrs | True |
| 2 | 3 | female | 26.0 | 0 | 0 | 7.9250 | S | Miss | False |
| 3 | 1 | female | 35.0 | 1 | 0 | 53.1000 | S | Mrs | True |
| 4 | 3 | male | 35.0 | 0 | 0 | 8.0500 | S | Mr | False |
Ahora quieres agrupar los valores numéricos, porque tienes rangos de edades y tarifas. Puede haber fluctuaciones que no reflejen patrones reales (ruido). Por eso vas a asignar a las personas dentro de ciertos rangos de edad o tarifa al mismo grupo. Puedes hacerlo con pandas y su función qcut():
# Binning numerical columns
data['CatAge'] = pd.qcut(data.Age, q=4, labels=False )
data['CatFare']= pd.qcut(data.Fare, q=4, labels=False)
data.head()
| Pclass | Sex | Age | SibSp | Parch | Fare | Embarked | Title | Has_Cabin | CatAge | CatFare | |
|---|---|---|---|---|---|---|---|---|---|---|---|
| 0 | 3 | male | 22.0 | 1 | 0 | 7.2500 | S | Mr | False | 0 | 0 |
| 1 | 1 | female | 38.0 | 1 | 0 | 71.2833 | C | Mrs | True | 3 | 3 |
| 2 | 3 | female | 26.0 | 0 | 0 | 7.9250 | S | Miss | False | 1 | 1 |
| 3 | 1 | female | 35.0 | 1 | 0 | 53.1000 | S | Mrs | True | 2 | 3 |
| 4 | 3 | male | 35.0 | 0 | 0 | 8.0500 | S | Mr | False | 2 | 1 |
Nota: pasas los datos como Series, data.Age y data.Fare, especificas el número de cuantiles q=4 y estableces labels=False para codificar los grupos como números.
Con esa información en grupos, ya puedes eliminar con seguridad las columnas 'Age' y 'Fare'. No olvides revisar las primeras filas.
data = data.drop(['Age', 'Fare'], axis=1)
data.head()
| Pclass | Sex | SibSp | Parch | Embarked | Title | Has_Cabin | CatAge | CatFare | |
|---|---|---|---|---|---|---|---|---|---|
| 0 | 3 | male | 1 | 0 | S | Mr | False | 0 | 0 |
| 1 | 1 | female | 1 | 0 | C | Mrs | True | 3 | 3 |
| 2 | 3 | female | 0 | 0 | S | Miss | False | 1 | 1 |
| 3 | 1 | female | 1 | 0 | S | Mrs | True | 2 | 3 |
| 4 | 3 | male | 0 | 0 | S | Mr | False | 2 | 1 |
Lo siguiente que puedes hacer es crear una nueva columna con el número de miembros de la familia que iban a bordo del Titanic. En este tutorial no la usaremos para ver cómo rinde el modelo sin ella. Si quieres probar cómo afecta esta columna adicional, ejecuta la siguiente línea:
# Create column of number of Family members onboard
data['Fam_Size'] = data.Parch + data.SibSp
Por ahora, simplemente elimina las columnas 'SibSp' y 'Parch' del DataFrame:
# Drop columns
data = data.drop(['SibSp','Parch'], axis=1)
data.head()
| Pclass | Sex | Embarked | Title | Has_Cabin | CatAge | CatFare | |
|---|---|---|---|---|---|---|---|
| 0 | 3 | male | S | Mr | False | 0 | 0 |
| 1 | 1 | female | C | Mrs | True | 3 | 3 |
| 2 | 3 | female | S | Miss | False | 1 | 1 |
| 3 | 1 | female | S | Mrs | True | 2 | 3 |
| 4 | 3 | male | S | Mr | False | 2 | 1 |
Ahora que has creado más características (como 'Title' y 'Has_Cabin'), has tratado los valores ausentes y has agrupado las numéricas, toca transformar todas las variables a numéricas. Esto es importante porque, en general, los modelos de machine learning aceptan entradas numéricas.
Como antes, usarás .get_dummies():
# Transform into binary variables
data_dum = pd.get_dummies(data, drop_first=True)
data_dum.head()
| Pclass | Has_Cabin | CatAge | CatFare | Sex_male | Embarked_Q | Embarked_S | Title_Miss | Title_Mr | Title_Mrs | Title_Special | |
|---|---|---|---|---|---|---|---|---|---|---|---|
| 0 | 3 | False | 0 | 0 | 1 | 0 | 1 | 0 | 1 | 0 | 0 |
| 1 | 1 | True | 3 | 3 | 0 | 0 | 0 | 0 | 0 | 1 | 0 |
| 2 | 3 | False | 1 | 1 | 0 | 0 | 1 | 1 | 0 | 0 | 0 |
| 3 | 1 | True | 2 | 3 | 0 | 0 | 1 | 0 | 0 | 1 | 0 |
| 4 | 3 | False | 2 | 1 | 1 | 0 | 1 | 0 | 1 | 0 | 0 |
Con todo listo, es hora de construir el modelo final.
Como antes, primero dividirás data de nuevo en train y test. Luego las transformarás en arrays:
# Split into test.train
data_train = data_dum.iloc[:891]
data_test = data_dum.iloc[891:]

# Transform into arrays for scikit-learn
X = data_train.values
test = data_test.values
y = survived_train.values
Ahora vas a entrenar un árbol de decisión sobre tu dataset con características ingenierizadas. Para elegir el hiperparámetro max_depth, usarás una variante de train/test split llamada «validación cruzada».
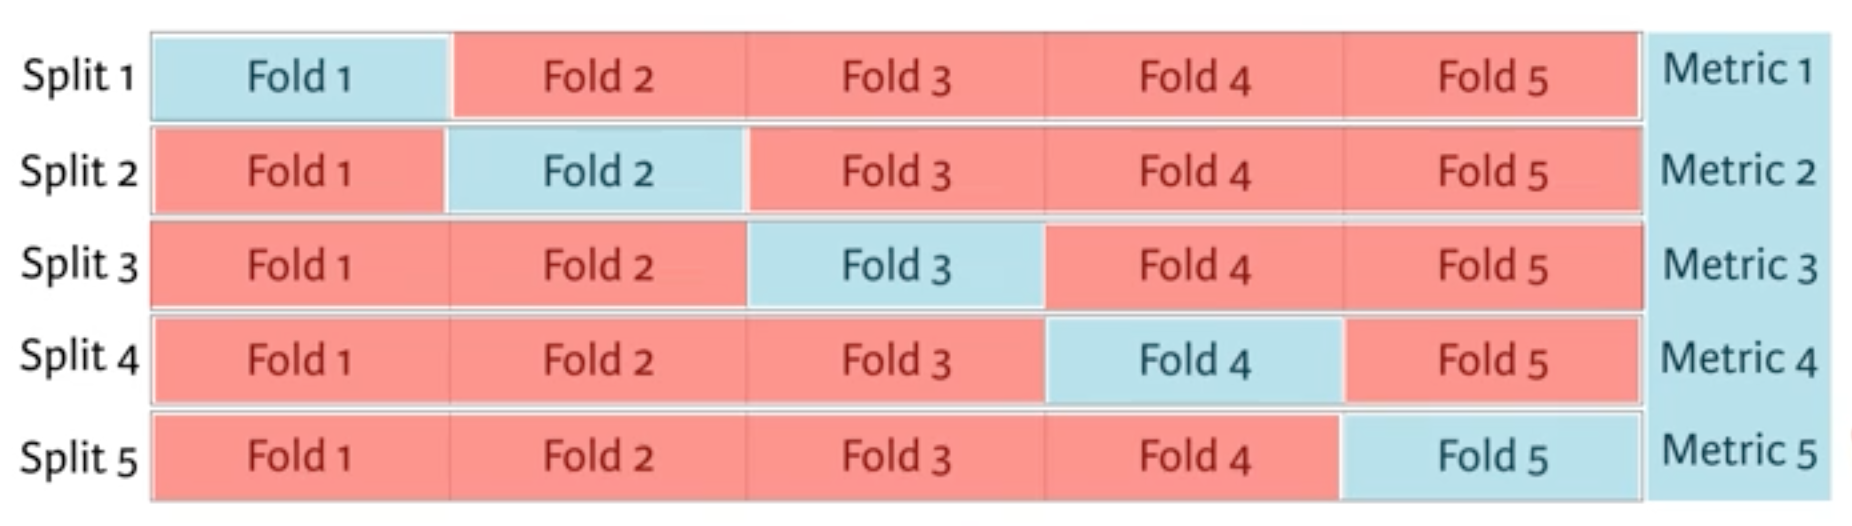
Empiezas dividiendo el dataset en 5 grupos o folds. Mantienes el primero como conjunto de prueba, ajustas el modelo con los otros cuatro, predices sobre el de prueba y calculas la métrica de interés. Luego repites usando el segundo como prueba, y así con el tercero, cuarto y quinto.
Como resultado, obtienes cinco valores de accuracy, de los que puedes calcular estadísticas como la mediana y/o la media y los intervalos de confianza al 95%.
Repites esto para cada valor de cada hiperparámetro que estés ajustando y eliges la combinación que mejor rinde. Esto se llama búsqueda en rejilla (grid search).
Basta de teoría, ¡vamos a ello!
A continuación, usarás validación cruzada y grid search para elegir el mejor max_depth para tu dataset:
# Setup the hyperparameter grid
dep = np.arange(1,9)
param_grid = {'max_depth' : dep}

# Instantiate a decision tree classifier: clf
clf = tree.DecisionTreeClassifier()

# Instantiate the GridSearchCV object: clf_cv
clf_cv = GridSearchCV(clf, param_grid=param_grid, cv=5)

# Fit it to the data
clf_cv.fit(X, y)

# Print the tuned parameter and score
print("Tuned Decision Tree Parameters: {}".format(clf_cv.best_params_))
print("Best score is {}".format(clf_cv.best_score_))
Tuned Decision Tree Parameters: {'max_depth': 3}
Best score is 0.8103254769921436
Ahora puedes predecir sobre tu conjunto de test, crear una nueva columna 'Survived' y guardar ahí tus predicciones. No olvides exportar las columnas 'PassengerId' y 'Survived' de df_test a un .csv y subirlo a Kaggle.
Y_pred = clf_cv.predict(test)
df_test['Survived'] = Y_pred
df_test[['PassengerId', 'Survived']].to_csv('data/predictions/dec_tree_feat_eng.csv', index=False)
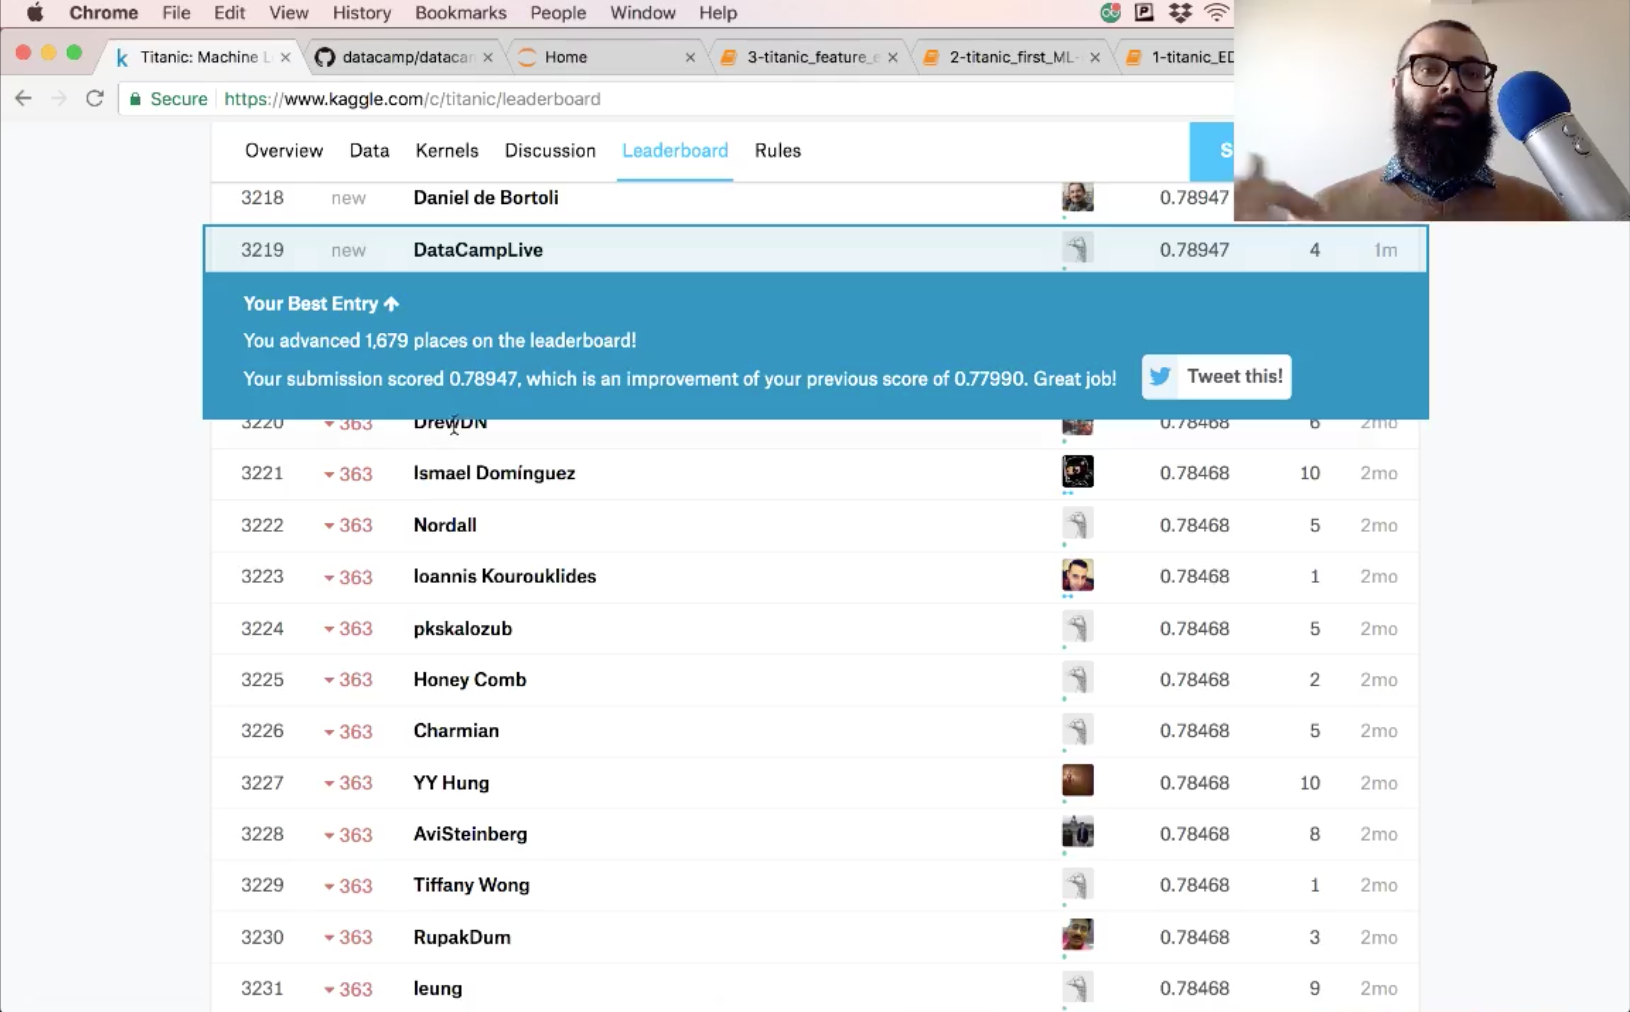
La accuracy de tu envío es 78,9.
Prueba a hacer más ingeniería de características y a entrenar modelos nuevos para mejorar esta puntuación. Este notebook, junto con los dos anteriores, está publicado en GitHub y nos encantaría ver cómo mejoras estos modelos.
Hay mucho más preprocesado que puedes aprender, como el escalado de datos. También verás que las pipelines de scikit-learn son súper útiles. Échale un ojo a nuestro curso Supervised Learning with scikit-learn y a la documentación de scikit-learn para todo esto y más.
Cursos de machine learning
Curso
Curso
Curso
blog
Zoumana Keita
14 min
blog
Matt Crabtree
14 min
blog
Natassha Selvaraj
15 min
Tutorial
Abid Ali Awan
15 min
Tutorial
Kevin Babitz
8 min
Tutorial
Abid Ali Awan
9 min






