
Kursus
Pengantar Python
4 jam
7M
Dengan Exploratory Data Analysis (EDA) dan model baseline yang sudah siap, Anda bisa mulai mengerjakan model Machine Learning pertama yang sesungguhnya.
Catatan bahwa tutorial ini didasarkan pada sesi code along Facebook Live; Anda bisa menontonnya kembali di sini:
Sebelum mulai, impor semua pustaka yang diperlukan:
# Import modules
import pandas as pd
import matplotlib.pyplot as plt
import seaborn as sns
import re
import numpy as np
from sklearn import tree
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LogisticRegression
from sklearn.model_selection import GridSearchCV

# Figures inline and set visualization style
%matplotlib inline
sns.set()

# Import data
df_train = pd.read_csv('data/train.csv')
df_test = pd.read_csv('data/test.csv')
data yang terdiri dari gabungan set pelatihan dan set uji. Anda melakukan ini karena Anda ingin melakukan prapemrosesan data sedikit dan memastikan bahwa operasi apa pun yang Anda lakukan pada set pelatihan juga dilakukan pada set data uji.# Store target variable of training data in a safe place
survived_train = df_train.Survived
# Concatenate training and test sets
data = pd.concat([df_train.drop(['Survived'], axis=1), df_test])
data yang baru dengan metode info().data.info()
<class 'pandas.core.frame.DataFrame'>
Int64Index: 1309 entries, 0 to 417
Data columns (total 11 columns):
PassengerId    1309 non-null int64
Pclass         1309 non-null int64
Name           1309 non-null object
Sex            1309 non-null object
Age            1046 non-null float64
SibSp          1309 non-null int64
Parch          1309 non-null int64
Ticket         1309 non-null object
Fare           1308 non-null float64
Cabin          295 non-null object
Embarked       1307 non-null object
dtypes: float64(2), int64(4), object(5)
memory usage: 122.7+ KB
Ada 2 variabel numerik yang memiliki nilai hilang.
Apa saja?
Betul, Anda kehilangan nilai untuk kolom 'Age' dan 'Fare'! Anda melihat pada hasil metode .info() di atas bahwa Anda kehilangan 263 nilai untuk kolom pertama, karena hanya ada 1046 nilai non-null dari total 1309 entri DataFrame Anda. Idealnya, tentu Anda ingin semua 1309 entri tersebut memiliki nilai non-null, tetapi tidak demikian halnya di sini!
Untungnya, Anda hanya kehilangan satu nilai untuk kolom Fare. Perhatikan juga bahwa 'Cabin' dan 'Embarked' juga memiliki nilai hilang dan Anda juga perlu menanganinya di suatu titik.
Namun, sekarang Anda akan fokus memperbaiki variabel numerik: Anda akan melakukan imputasi atau mengisi nilai hilang untuk kolom 'Age' dan 'Fare' menggunakan median dari variabel-variabel ini pada data yang tersedia.
Catatan bahwa dalam kasus ini, Anda menggunakan median karena sangat cocok untuk menangani outlier. Dengan kata lain, median berguna ketika distribusi data miring. Cara lain untuk melakukan imputasi nilai hilang adalah menggunakan mean, yang diperoleh dengan menjumlahkan semua titik data dan membaginya dengan jumlah titik data, atau mode, yaitu angka yang paling sering muncul.
# Impute missing numerical variables
data['Age'] = data.Age.fillna(data.Age.median())
data['Fare'] = data.Fare.fillna(data.Fare.median())

# Check out info of data
data.info()
<class 'pandas.core.frame.DataFrame'>
Int64Index: 1309 entries, 0 to 417
Data columns (total 11 columns):
PassengerId    1309 non-null int64
Pclass         1309 non-null int64
Name           1309 non-null object
Sex            1309 non-null object
Age            1309 non-null float64
SibSp          1309 non-null int64
Parch          1309 non-null int64
Ticket         1309 non-null object
Fare           1309 non-null float64
Cabin          295 non-null object
Embarked       1307 non-null object
dtypes: float64(2), int64(4), object(5)
memory usage: 122.7+ KB
Itu sudah terlihat jauh lebih baik, bukan!
Perhatikan juga bahwa, dalam tutorial sebelumnya dan notebook, Anda memiliki sejumlah fitur yang ingin digunakan untuk prediksi karena dari analisis eksploratori Anda terlihat bahwa fitur-fitur tersebut penting untuk 'Survived' atau tidak. Salah satu fiturnya adalah 'Fare', tetapi 'Age' dan 'Sex' juga demikian!
Tetapi Anda ingin mengenkode data dengan angka, jadi Anda akan mengubah 'male' dan 'female' menjadi angka. Anda melakukan ini karena sebagian besar model machine learning bekerja dengan fitur masukan numerik. Anda bisa menggunakan fungsi pandas .get_dummies() untuk melakukannya:
data = pd.get_dummies(data, columns=['Sex'], drop_first=True)
data.head()
| PassengerId | Pclass | Name | Age | SibSp | Parch | Ticket | Fare | Cabin | Embarked | Sex_male | |
|---|---|---|---|---|---|---|---|---|---|---|---|
| 0 | 1 | 3 | Braund, Mr. Owen Harris | 22.0 | 1 | 0 | A/5 21171 | 7.2500 | NaN | S | 1 |
| 1 | 2 | 1 | Cumings, Mrs. John Bradley (Florence Briggs Th... | 38.0 | 1 | 0 | PC 17599 | 71.2833 | C85 | C | 0 |
| 2 | 3 | 3 | Heikkinen, Miss. Laina | 26.0 | 0 | 0 | STON/O2. 3101282 | 7.9250 | NaN | S | 0 |
| 3 | 4 | 1 | Futrelle, Mrs. Jacques Heath (Lily May Peel) | 35.0 | 1 | 0 | 113803 | 53.1000 | C123 | S | 0 |
| 4 | 5 | 3 | Allen, Mr. William Henry | 35.0 | 0 | 0 | 373450 | 8.0500 | NaN | S | 1 |
.get_dummies() memungkinkan Anda membuat kolom baru untuk setiap opsi dalam 'Sex'. Jadi, ia membuat kolom baru untuk female, bernama 'Sex_female', lalu kolom baru untuk 'Sex_male', yang mengodekan apakah baris tersebut laki-laki atau perempuan.
Sekarang, karena Anda menambahkan argumen drop_first pada baris kode di atas, Anda menghapus 'Sex_female' karena, pada dasarnya, kolom-kolom baru 'Sex_female' dan 'Sex_male' mengodekan informasi yang sama.
Jadi yang Anda lakukan hanyalah membuat kolom baru 'Sex_male', yang berisi 1 jika baris tersebut laki-laki – dan 0 jika baris tersebut perempuan.
.get_dummies() akan menjadi salah satu sahabat terbaik Anda saat melakukan manipulasi data untuk machine learning!
['Sex_male', 'Fare', 'Age','Pclass', 'SibSp'] dari DataFrame untuk membangun model machine learning pertama Anda:# Select columns and view head
data = data[['Sex_male', 'Fare', 'Age','Pclass', 'SibSp']]
data.head()
| Sex_male | Fare | Age | Pclass | SibSp | |
|---|---|---|---|---|---|
| 0 | 1 | 7.2500 | 22.0 | 3 | 1 |
| 1 | 0 | 71.2833 | 38.0 | 1 | 1 |
| 2 | 0 | 7.9250 | 26.0 | 3 | 0 |
| 3 | 0 | 53.1000 | 35.0 | 1 | 1 |
| 4 | 1 | 8.0500 | 35.0 | 3 | 0 |
.info() untuk memeriksa data:data.info()
<class 'pandas.core.frame.DataFrame'>
Int64Index: 1309 entries, 0 to 417
Data columns (total 5 columns):
Sex_male    1309 non-null uint8
Fare        1309 non-null float64
Age         1309 non-null float64
Pclass      1309 non-null int64
SibSp       1309 non-null int64
dtypes: float64(2), int64(2), uint8(1)
memory usage: 52.4 KB
Semua entri sekarang non-null. Kerja bagus!
Sampai titik ini, Anda telah menyiapkan data untuk membangun model machine learning pertama. Artinya Anda akhirnya bisa membangun model machine learning pertama Anda!
Untuk mempelajari lebih lanjut tentang pandas, lihat Data Manipulation with Python track kami.
Apa itu decision tree classifier? Ini adalah pohon yang memungkinkan Anda mengklasifikasikan titik data, yang juga dikenal sebagai variabel target, berdasarkan variabel fitur.
Contohnya, pohon di bawah ini memiliki node akar yang memaksa Anda membuat keputusan pertama, berdasarkan pertanyaan: "Apakah 'Sex_male' kurang dari 0,5?" Dengan kata lain, apakah titik data tersebut perempuan. Jika jawabannya True, Anda turun ke kiri dan memperoleh 'Survived'. Jika False, Anda turun ke kanan dan memperoleh 'Dead'.
Untuk saat ini, Anda tidak perlu khawatir tentang semua informasi tambahan yang Anda lihat di node, seperti gini, samples, atau value. Anda bisa memeriksanya nanti!
'Male' menghasilkan prediksi 'Dead'.Catatan bahwa sebenarnya koefisien gini yang digunakan untuk membuat keputusan ini. Pada titik ini, Anda tidak akan membahas lebih dalam hal tersebut.
data Anda, pisahkan kembali menjadi set pelatihan dan set uji:data_train = data.iloc[:891]
data_test = data.iloc[891:]
scikit-learn, yang membutuhkan data Anda dalam bentuk array, bukan DataFrame, jadi ubahlah:X = data_train.values
test = data_test.values
y = survived_train.values
max_depth=3 lalu latih pada data Anda. Catatan bahwa Anda menamai model Anda clf, singkatan dari "Classifier".# Instantiate model and fit to data
clf = tree.DecisionTreeClassifier(max_depth=3)
clf.fit(X, y)
DecisionTreeClassifier(class_weight=None, criterion='gini', max_depth=3,
            max_features=None, max_leaf_nodes=None,
            min_impurity_decrease=0.0, min_impurity_split=None,
            min_samples_leaf=1, min_samples_split=2,
            min_weight_fraction_leaf=0.0, presort=False, random_state=None,
            splitter='best')
Variabel fitur X adalah argumen pertama yang Anda berikan ke metode .fit(), sedangkan variabel target, y, adalah argumen kedua.
Keluaran memberi tahu Anda semua yang perlu diketahui tentang Decision Tree Classifier yang baru saja Anda bangun: misalnya, Anda melihat bahwa max depth ditetapkan pada 3.
'Survived' dan menyimpan prediksi Anda di dalamnya. Simpan kolom 'PassengerId' dan 'Survived' dari df_test ke .csv dan kirimkan ke Kaggle.# Make predictions and store in 'Survived' column of df_test
Y_pred = clf.predict(test)
df_test['Survived'] = Y_pred
df_test[['PassengerId', 'Survived']].to_csv('data/predictions/1st_dec_tree.csv', index=False)
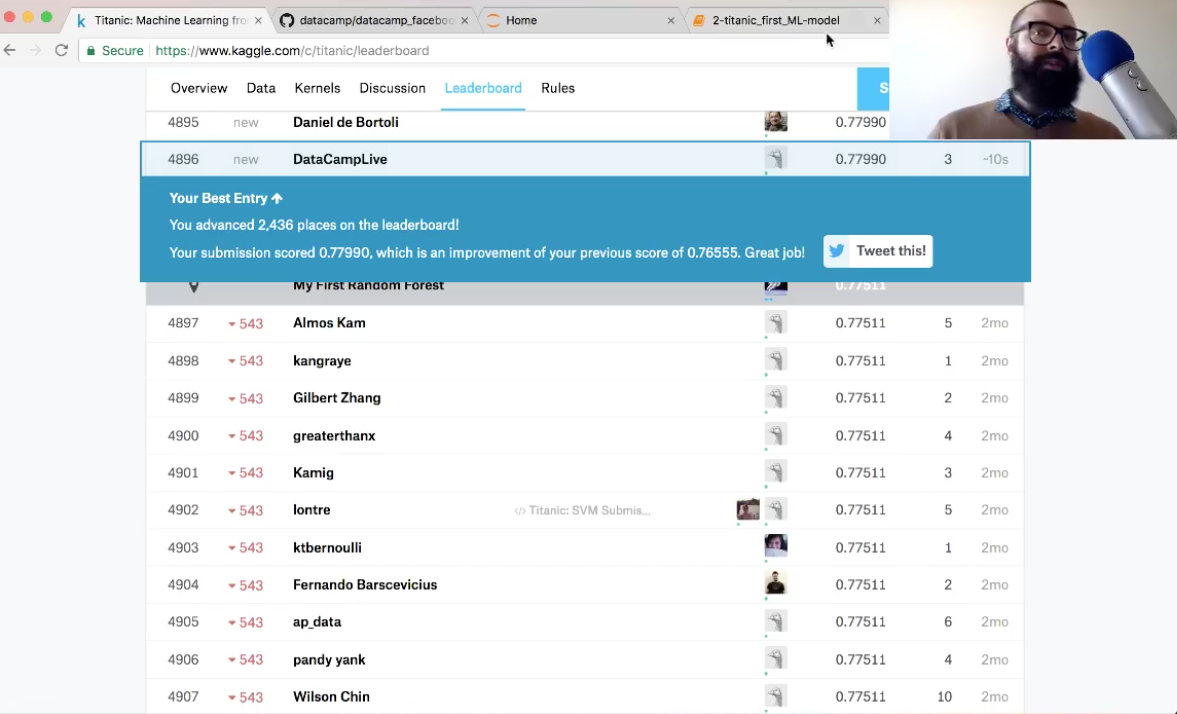
Akurasi adalah 78%. Anda naik lebih dari 2.000 peringkat!
Selamat, Anda telah menyiapkan data untuk membangun model machine learning pertama. Selain itu, Anda juga telah membangun model machine learning pertama Anda: sebuah decision tree classifier.
Sekarang, Anda akan mencari tahu apa itu argumen max_depth, mengapa Anda memilihnya, dan mengeksplorasi train_test_split.
Untuk mempelajari lebih lanjut tentang scikit-learn, lihat kursus Supervised Learning with scikit-learn kami.
Decision Tree Classifier yang baru saja Anda bangun memiliki max_depth=3 dan tampilannya seperti ini:
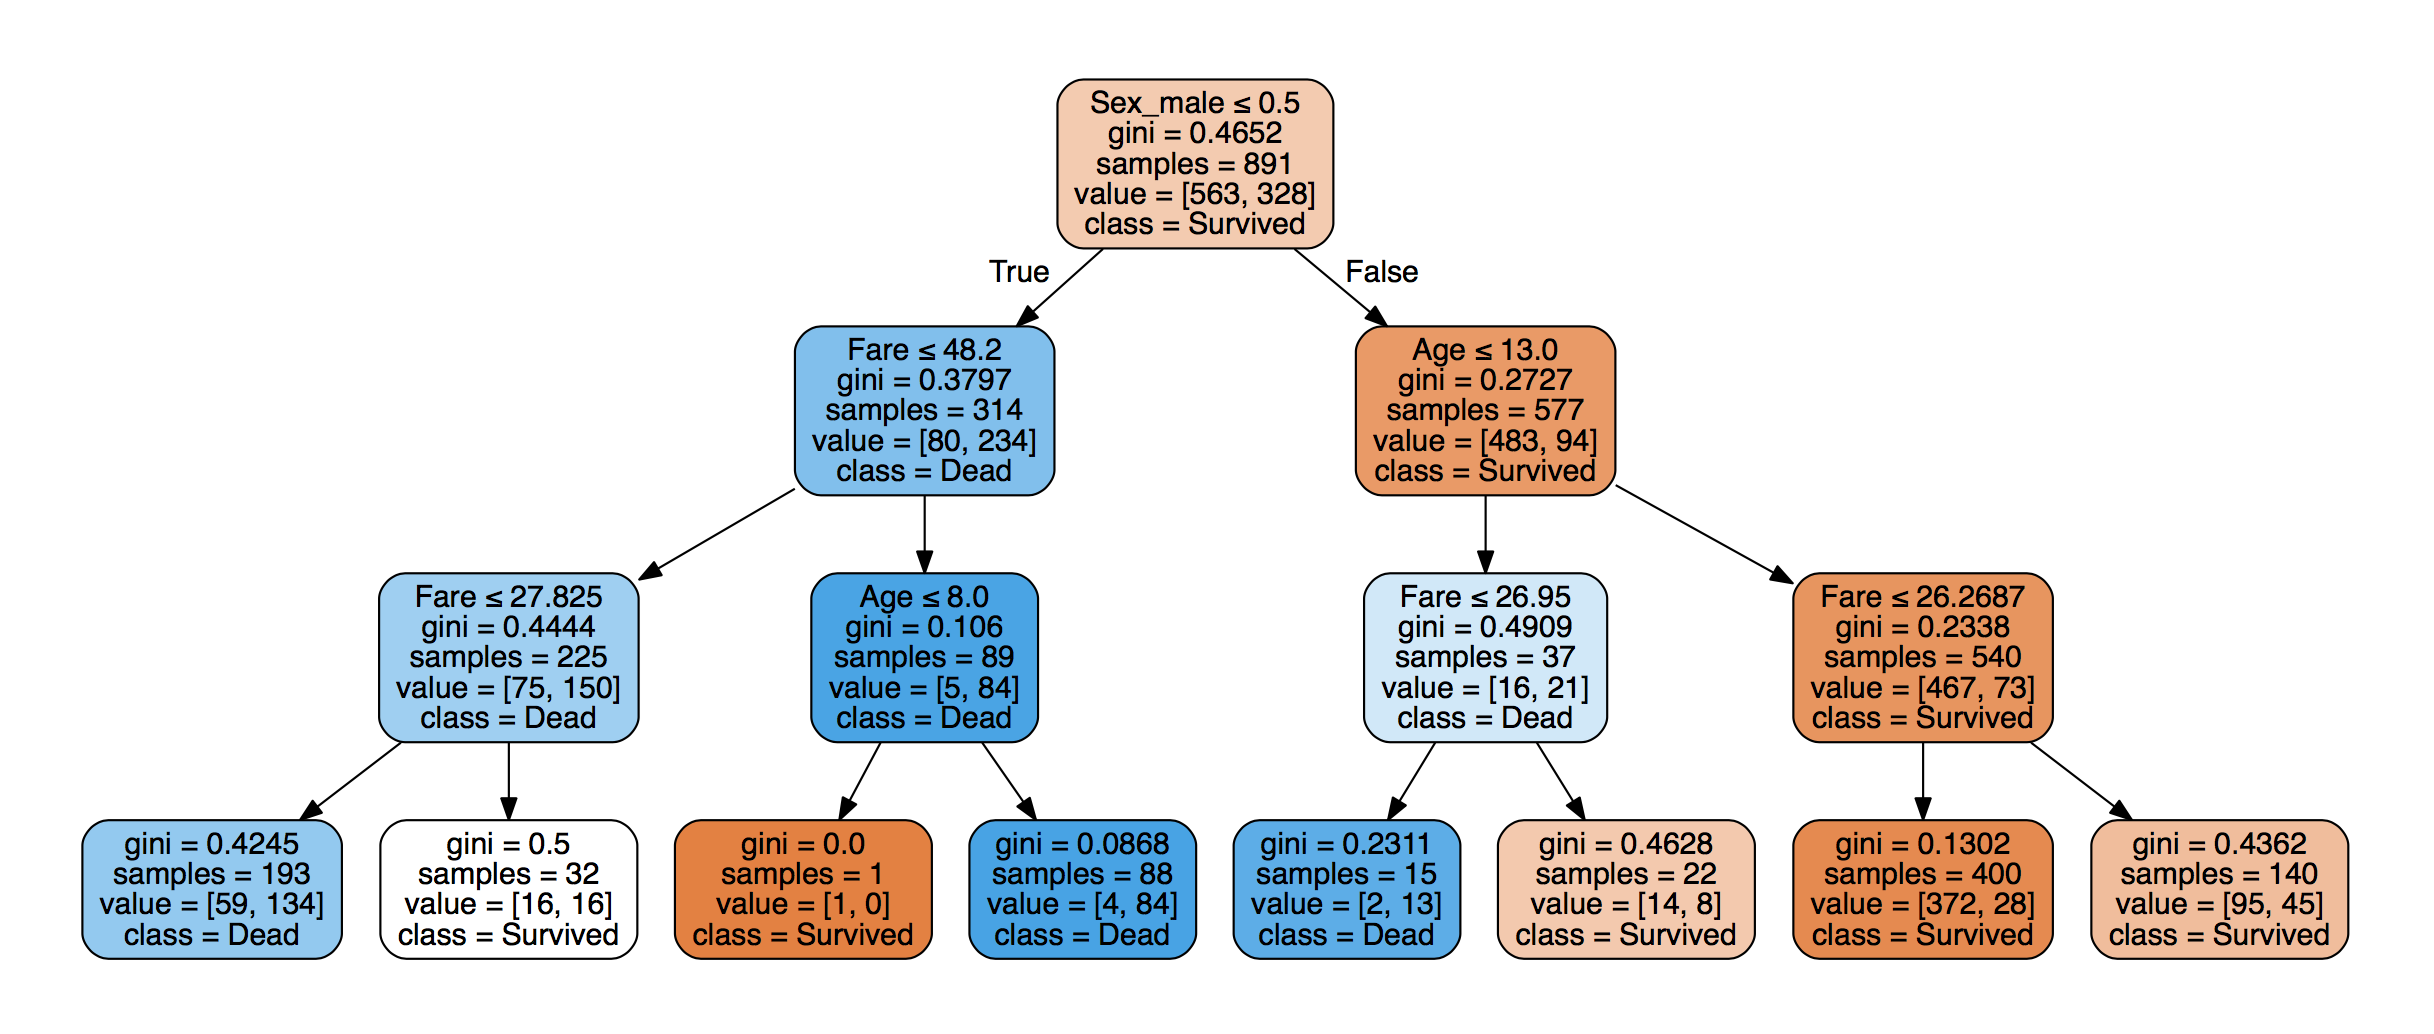
Jarak maksimal antara keputusan pertama dan terakhir adalah 3, jadi itulah max_depth=3.
Catatan: Anda bisa menggunakan graphviz untuk membuat gambar seperti ini. Lihat dokumentasi scikit-learn di sini untuk detail lebih lanjut.
Dalam membangun model ini, pada dasarnya Anda membuat batas keputusan (decision boundary) dalam ruang variabel fitur, misalnya (gambar dari sini):
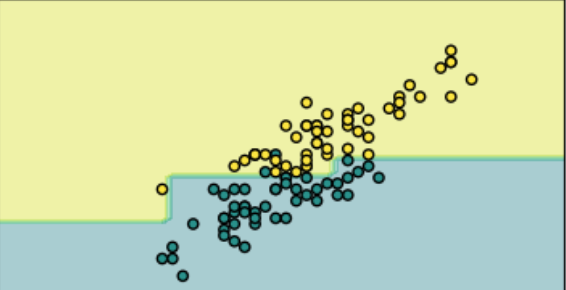
max_depth=3?Kedalaman pohon dikenal sebagai hiperparameter, yaitu parameter yang perlu Anda tentukan sebelum melatih model pada data. Jika Anda memilih max_depth yang lebih besar, Anda akan mendapatkan batas keputusan yang lebih kompleks.
Jika batas keputusan Anda terlalu kompleks, Anda bisa mengalami overfitting pada data, yang berarti model Anda akan menggambarkan noise sekaligus sinyal.
Jika max_depth Anda terlalu kecil, Anda bisa mengalami underfitting pada data, artinya model Anda tidak cukup menangkap sinyalnya.
Lalu bagaimana cara mengetahui apakah Anda overfitting atau underfitting?
Catatan: ini juga disebut sebagai bias-variance trade-off; kita tidak akan membahas detailnya di sini, hanya disebutkan untuk melengkapi!
Salah satu caranya adalah menahan sebagian data sebagai set uji dari data pelatihan Anda. Anda kemudian dapat melatih model pada data pelatihan, membuat prediksi pada set uji, dan melihat seberapa baik prediksi Anda pada set uji.
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.33, random_state=42, stratify=y)
max_depth dari 1 hingga 9 dan memplot akurasi model pada set pelatihan dan uji:# Setup arrays to store train and test accuracies
dep = np.arange(1, 9)
train_accuracy = np.empty(len(dep))
test_accuracy = np.empty(len(dep))
# Loop over different values of k
for i, k in enumerate(dep):
# Setup a Decision Tree Classifier
clf = tree.DecisionTreeClassifier(max_depth=k)
# Fit the classifier to the training data
clf.fit(X_train, y_train)
#Compute accuracy on the training set
train_accuracy[i] = clf.score(X_train, y_train)
#Compute accuracy on the testing set
test_accuracy[i] = clf.score(X_test, y_test)
# Generate plot
plt.title('clf: Varying depth of tree')
plt.plot(dep, test_accuracy, label = 'Testing Accuracy')
plt.plot(dep, train_accuracy, label = 'Training Accuracy')
plt.legend()
plt.xlabel('Depth of tree')
plt.ylabel('Accuracy')
plt.show()
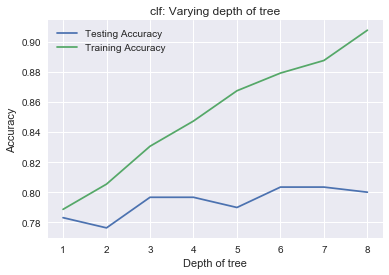
Seiring Anda meningkatkan max_depth, Anda akan semakin baik menyesuaikan diri dengan data pelatihan karena Anda membuat keputusan yang menggambarkan data pelatihan. Akurasi untuk data pelatihan akan terus naik, tetapi Anda melihat hal ini tidak terjadi pada data uji: Anda mengalami overfitting.
Itulah mengapa Anda memilih max_depth=3.
Dalam tutorial ini, Anda telah menyiapkan data untuk membangun model machine learning pertama. Selanjutnya, Anda juga telah membangun model machine learning pertama: sebuah decision tree classifier. Terakhir, Anda mempelajari tentang train_test_split dan bagaimana hal itu membantu kita memilih hiperparameter model ML.
Pada tutorial berikutnya, yang akan hadir di DataCamp Community pada 10 Januari 2018, Anda akan mempelajari cara merekayasa fitur baru dan membangun beberapa model baru!
Sementara itu, jika Anda ingin menggali lebih jauh tentang scikit-learn, lihat kursus Supervised Learning with scikit-learn dari DataCamp.
Kursus Machine Learning
Kursus
Kursus
blogs
David Woods
13 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
Dario Radečić
15 mnt
blogs
Javier Canales Luna
14 mnt



