Kurs
Machine Learning'i Anlamak
2 sa
313.7K
Önceki iki Kaggle eğitiminde, Keşifsel Veri Analizi ve temel makine öğrenmesi modelleri kullanarak verinizi ilk makine öğrenmesi modelinizi kuracak forma getirmeyi öğrendiniz. Ardından, başarıyla ilk makine öğrenmesi modelinizi, bir karar ağacı sınıflandırıcısını kurdunuz. Tüm bu modelleri Kaggle'a gönderdiniz ve doğruluklarını yorumladınız.
Bu üçüncü eğitimde, verinizle ilgili alan bilginizi kullanarak öğrenme algoritmasının öngörü gücünü artıran ve makine öğrenmesi modellerinizi daha da iyi hale getiren ek ilgili öznitelikler oluşturduğunuz bir süreç olan öznitelik mühendisliği hakkında daha fazla bilgi edineceksiniz!
Daha özel olarak,
Başlamadan önce, tıpkı önceki eğitimde yaptığınız gibi, tüm içe aktarmaları yapacak, Jupyter Notebook'ta şekillerin satır içi oluşturulduğundan emin olmak için biraz IPython sihri kullanacak ve görselleştirme stilini ayarlayacaksınız. Sonra verinizi içe aktarabilir ve eğitim verisinin hedef değişkenini güvenli bir yerde sakladığınızdan emin olabilirsiniz. Ardından, eğitim ve test veri setlerini (df_train içindeki 'Survived' sütunu hariç) birleştirip sonucu data içinde saklarsınız.
Unutmayın, bunu yapmanızın nedeni, veri üzerinde yaptığınız herhangi bir ön işlemenin hem eğitim hem de test setlerinde yansıdığından emin olmak istemenizdir!
Son olarak, verinize göz atmak için .info() metodunu kullanırsınız:
# Imports
import pandas as pd
import matplotlib.pyplot as plt
import seaborn as sns
import re
import numpy as np
from sklearn import tree
from sklearn.model_selection import GridSearchCV

# Figures inline and set visualization style
%matplotlib inline
sns.set()

# Import data
df_train = pd.read_csv('data/train.csv')
df_test = pd.read_csv('data/test.csv')

# Store target variable of training data in a safe place
survived_train = df_train.Survived

# Concatenate training and test sets
data = pd.concat([df_train.drop(['Survived'], axis=1), df_test])

# View head
data.info()
<class 'pandas.core.frame.DataFrame'>
Int64Index: 1309 entries, 0 to 417
Data columns (total 11 columns):
PassengerId    1309 non-null int64
Pclass         1309 non-null int64
Name           1309 non-null object
Sex            1309 non-null object
Age            1046 non-null float64
SibSp          1309 non-null int64
Parch          1309 non-null int64
Ticket         1309 non-null object
Fare           1308 non-null float64
Cabin          295 non-null object
Embarked       1307 non-null object
dtypes: float64(2), int64(4), object(5)
memory usage: 122.7+ KBModeller kurarken seviyenizi yükseltebilmek için verinizden daha fazla bilgi çıkarmak üzere öznitelik mühendisliği yaparsınız.
Bir örneğe bakarak bunun neyle ilgili olduğuna göz atalım. Verinizin son beş satırını görmenize yardımcı olan .tail() metodunun yardımıyla 'Name' sütununu inceleyelim:
# View head of 'Name' column
data.Name.tail()
413              Spector, Mr. Woolf
414    Oliva y Ocana, Dona. Fermina
415    Saether, Mr. Simon Sivertsen
416             Ware, Mr. Frederick
417        Peter, Master. Michael J
Name: Name, dtype: object
Birden farklı ünvanların ortaya çıktığını görüyorsunuz! Başka bir deyişle, bu sütun, 'Mr', 'Master' ve 'Dona' gibi ünvanları içeren dizgeler veya metinler barındırıyor.
Bu ünvanlar elbette sosyal statü, meslek vb. hakkında bilgi verir; bu da sonuçta hayatta kalma hakkında size daha fazla şey söyleyebilir.
İlk bakışta, isimleri ünvanlardan ayırmak zor bir görev gibi görünebilir, ancak panik yapmayın! Düzenli ifadeleri kullanarak ünvanı kolayca çıkarabileceğinizi ve onu yeni bir 'Title' sütununda saklayabileceğinizi unutmayın:
# Extract Title from Name, store in column and plot barplot
data['Title'] = data.Name.apply(lambda x: re.search(' ([A-Z][a-z]+)\.', x).group(1))
sns.countplot(x='Title', data=data);
plt.xticks(rotation=45);
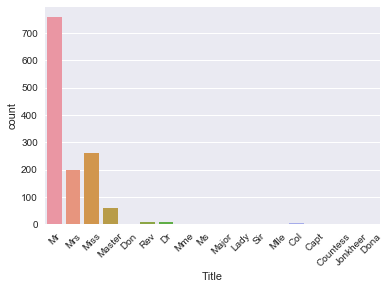
Not bu yeni 'Title' sütununun aslında veri kümeniz için yeni bir öznitelik olduğudur!
İpucu: düzenli ifadeler hakkında daha fazla bilgi edinmek için son FB Live birlikte kodlama etkinliğimiz yazımı veya DataCamp'in Python Düzenli İfadeler Eğitimi'ni inceleyin.
Yukarıdaki grafikte birkaç ünvan bulunduğunu ve sık geçmeyen birçok ünvan olduğunu görüyorsunuz. Bu yüzden onları daha az sayıda kategoriye koymak mantıklıdır.
Örneğin, muhtemelen 'Mlle' ve 'Ms''i 'Miss' ile ve 'Mme''yi 'Mrs' ile değiştirmek istersiniz; çünkü bunlar Fransızca ünvanlardır ve ideal olarak tüm verinizin tek bir dilde olmasını istersiniz. Sonra, hemen kategorize edemediğiniz bir dizi ünvanı alır ve onları 'Special' adlı bir kategoriye koyarsınız.
İpucu: bununla oynayarak algoritmanızın bu değişikliklere bağlı olarak nasıl performans gösterdiğini görün!
Ardından, sonucu .countplot() metodunun yardımıyla bir çubuk grafikte görüntülersiniz:
data['Title'] = data['Title'].replace({'Mlle':'Miss', 'Mme':'Mrs', 'Ms':'Miss'})
data['Title'] = data['Title'].replace(['Don', 'Dona', 'Rev', 'Dr',
                                            'Major', 'Lady', 'Sir', 'Col', 'Capt', 'Countess', 'Jonkheer'],'Special')
sns.countplot(x='Title', data=data);
plt.xticks(rotation=45);
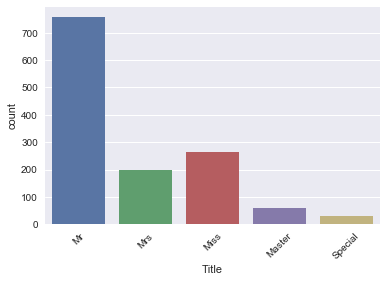
Yeni tasarladığınız 'Title' özniteliği böyle görünüyor!
Şimdi bir 'Title' sütununuz olduğundan emin olun ve .tail() metoduyla verinizi tekrar inceleyin:
# View head of data
data.tail()
| PassengerId | Pclass | Name | Sex | Age | SibSp | Parch | Ticket | Fare | Cabin | Embarked | Title | |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 413 | 1305 | 3 | Spector, Mr. Woolf | male | NaN | 0 | 0 | A.5. 3236 | 8.0500 | NaN | S | Mr |
| 414 | 1306 | 1 | Oliva y Ocana, Dona. Fermina | female | 39.0 | 0 | 0 | PC 17758 | 108.9000 | C105 | C | Special |
| 415 | 1307 | 3 | Saether, Mr. Simon Sivertsen | male | 38.5 | 0 | 0 | SOTON/O.Q. 3101262 | 7.2500 | NaN | S | Mr |
| 416 | 1308 | 3 | Ware, Mr. Frederick | male | NaN | 0 | 0 | 359309 | 8.0500 | NaN | S | Mr |
| 417 | 1309 | 3 | Peter, Master. Michael J | male | NaN | 1 | 1 | 2668 | 22.3583 | NaN | C | Master |
Veriyi yüklediğinizde ve incelediğinizde, 'Cabin' sütununda birkaç NaN ya da eksik değer olduğunu gördünüz.
Bu NaN değerlerin kamarası olmayanları ifade ettiğini varsaymak makul olabilir; bu da size 'Survival' hakkında bir şeyler söyleyebilir. Öyleyse şimdi bu bilgiyi kodlayan ve yolcuların kamarası olup olmadığını belirten yeni bir 'Has_Cabin' sütunu oluşturalım.
Not aşağıdaki kod parçasında kullandığınız .isnull() metodunun, yolcunun kamarası yoksa True, aksi halde False döndüreceğini unutmayın. Ancak sonucu 'Has_Cabin' sütununda saklamak istediğiniz için aslında sonucu tersine çevirmek istiyorsunuz: yolcunun kamarası varsa True döndürmek istiyorsunuz. Bu yüzden tilda ~ kullanıyorsunuz.
# Did they have a Cabin?
data['Has_Cabin'] = ~data.Cabin.isnull()

# View head of data
data.head()
| PassengerId | Pclass | Name | Sex | Age | SibSp | Parch | Ticket | Fare | Cabin | Embarked | Title | Has_Cabin | |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 0 | 1 | 3 | Braund, Mr. Owen Harris | male | 22.0 | 1 | 0 | A/5 21171 | 7.2500 | NaN | S | Mr | False |
| 1 | 2 | 1 | Cumings, Mrs. John Bradley (Florence Briggs Th... | female | 38.0 | 1 | 0 | PC 17599 | 71.2833 | C85 | C | Mrs | True |
| 2 | 3 | 3 | Heikkinen, Miss. Laina | female | 26.0 | 0 | 0 | STON/O2. 3101282 | 7.9250 | NaN | S | Miss | False |
| 3 | 4 | 1 | Futrelle, Mrs. Jacques Heath (Lily May Peel) | female | 35.0 | 1 | 0 | 113803 | 53.1000 | C123 | S | Mrs | True |
| 4 | 5 | 3 | Allen, Mr. William Henry | male | 35.0 | 0 | 0 | 373450 | 8.0500 | NaN | S | Mr | False |
Şimdi yapmak istediğiniz şey, daha fazla faydalı bilgi içermeyen (ya da ne yapacağımızdan emin olmadığımız) bir dizi sütunu atmak. Bu durumda, şu sütunlara bakıyorsunuz: ['Cabin', 'Name', 'PassengerId', 'Ticket'], çünkü
'Has_Cabin' sütununda yolcunun kamarası olup olmadığına dair bilgiyi zaten çıkardınız;'Name' sütunundan ünvanları zaten çıkardınız;'PassengerId' ve 'Ticket' sütunlarını da atıyorsunuz; çünkü bunlar muhtemelen Titanic yolcularının hayatta kalışı hakkında size başka bir şey söylemeyecektir.İpucu 'Cabin' sütununda daha fazla bilgi olabilir, ancak bu eğitim için olmadığını varsayıyorsunuz!
Bu sütunları gerçek data DataFrame'inizden atmak için, .drop() metodunda inplace argümanını kullanıp True olarak ayarladığınızdan emin olun:
# Drop columns and view head
data.drop(['Cabin', 'Name', 'PassengerId', 'Ticket'], axis=1, inplace=True)
data.head()
| Pclass | Sex | Age | SibSp | Parch | Fare | Embarked | Title | Has_Cabin | |
|---|---|---|---|---|---|---|---|---|---|
| 0 | 3 | male | 22.0 | 1 | 0 | 7.2500 | S | Mr | False |
| 1 | 1 | female | 38.0 | 1 | 0 | 71.2833 | C | Mrs | True |
| 2 | 3 | female | 26.0 | 0 | 0 | 7.9250 | S | Miss | False |
| 3 | 1 | female | 35.0 | 1 | 0 | 53.1000 | S | Mrs | True |
| 4 | 3 | male | 35.0 | 0 | 0 | 8.0500 | S | Mr | False |
Tebrikler! 'Title' ve 'Has_Cabin' gibi bazı yeni öznitelikleri başarıyla tasarladınız ve makine öğrenmesi modelinize daha fazla faydalı bilgi eklemeyen özniteliklerin DataFrame'inizden çıkarıldığından emin oldunuz!
Şimdi, eksik değerlerle ilgilenmek, sayısal verinizi bölmelere ayırmak ve tüm öznitelikleri yine .get_dummies() kullanarak sayısal değişkenlere dönüştürmek istiyorsunuz. Son olarak, bu eğitim için nihai modelinizi kuracaksınız. Tüm bunların nasıl yapıldığını sonraki bölümlerde görün!
Orijinal data DataFrame'inizde yaptığınız tüm değişikliklerle, .info() ile hâlâ eksik değer kalıp kalmadığını anlamak iyi bir fikirdir:
data.info()
<class 'pandas.core.frame.DataFrame'>
Int64Index: 1309 entries, 0 to 417
Data columns (total 9 columns):
Pclass       1309 non-null int64
Sex          1309 non-null object
Age          1046 non-null float64
SibSp        1309 non-null int64
Parch        1309 non-null int64
Fare         1308 non-null float64
Embarked     1307 non-null object
Title        1309 non-null object
Has_Cabin    1309 non-null bool
dtypes: bool(1), float64(2), int64(3), object(3)
memory usage: 133.3+ KB
Yukarıdaki kod satırının sonucu size 'Age', 'Fare' ve 'Embarked' sütunlarında eksik değerleriniz olduğunu söylüyor.
Unutmayın bunu, önce toplam giriş sayısına (1309) bakıp ardından .info()'nun listelediği sütunlardaki null olmayan değer sayısını kontrol ederek kolayca fark edebilirsiniz. Bu durumda, 'Age' sütununda 1046 null olmayan değer olduğunu görüyorsunuz; bu da 263 eksik değeriniz olduğu anlamına geliyor. Benzer şekilde, 'Fare' sadece bir eksik değere ve 'Embarked' iki eksik değere sahip.
Tıpkı önceki eğitimde yaptığınız gibi, bu eksik değerleri .fillna() yardımıyla atayacaksınız:
Not bir kez daha, 'Age' ve 'Fare' sütunlarını doldurmak için medyanı kullanıyorsunuz; çünkü aykırı değerlerle başa çıkmak için idealdir. Eksik değerleri atamanın diğer yolları, tüm veri noktalarını toplayıp veri noktası sayısına bölerek bulabileceğiniz ortalamayı veya en sık görülen değeri ifade eden modu kullanmaktır.
'Embarked' sütunundaki iki eksik değeri, bu sütunda en yaygın bulduğunuz değer olduğu için Southampton'ı temsil eden 'S' ile dolduruyorsunuz.
İpucu: Bunu biraz daha Keşifsel Veri Analizi yaparak tekrar kontrol edebilirsiniz!
# Impute missing values for Age, Fare, Embarked
data['Age'] = data.Age.fillna(data.Age.median())
data['Fare'] = data.Fare.fillna(data.Fare.median())
data['Embarked'] = data['Embarked'].fillna('S')
data.info()
<class 'pandas.core.frame.DataFrame'>
Int64Index: 1309 entries, 0 to 417
Data columns (total 9 columns):
Pclass       1309 non-null int64
Sex          1309 non-null object
Age          1309 non-null float64
SibSp        1309 non-null int64
Parch        1309 non-null int64
Fare         1309 non-null float64
Embarked     1309 non-null object
Title        1309 non-null object
Has_Cabin    1309 non-null bool
dtypes: bool(1), float64(2), int64(3), object(3)
memory usage: 133.3+ KB
data.head()
| Pclass | Sex | Age | SibSp | Parch | Fare | Embarked | Title | Has_Cabin | |
|---|---|---|---|---|---|---|---|---|---|
| 0 | 3 | male | 22.0 | 1 | 0 | 7.2500 | S | Mr | False |
| 1 | 1 | female | 38.0 | 1 | 0 | 71.2833 | C | Mrs | True |
| 2 | 3 | female | 26.0 | 0 | 0 | 7.9250 | S | Miss | False |
| 3 | 1 | female | 35.0 | 1 | 0 | 53.1000 | S | Mrs | True |
| 4 | 3 | male | 35.0 | 0 | 0 | 8.0500 | S | Mr | False |
Sonrasında sayısal verileri bölmelere ayırmak istiyorsunuz; çünkü çeşitli yaşlar ve ücretler aralığınız var. Ancak bu sayılarda, verideki örüntüleri yansıtmayan ve gürültü olabilecek dalgalanmalar olabilir. Bu yüzden belirli bir yaş veya ücret aralığındaki kişileri aynı bölmeye koyacaksınız. Bunu, sayısal verilerinizi bölmek için pandas fonksiyonu qcut() kullanarak yapabilirsiniz:
# Binning numerical columns
data['CatAge'] = pd.qcut(data.Age, q=4, labels=False )
data['CatFare']= pd.qcut(data.Fare, q=4, labels=False)
data.head()
| Pclass | Sex | Age | SibSp | Parch | Fare | Embarked | Title | Has_Cabin | CatAge | CatFare | |
|---|---|---|---|---|---|---|---|---|---|---|---|
| 0 | 3 | male | 22.0 | 1 | 0 | 7.2500 | S | Mr | False | 0 | 0 |
| 1 | 1 | female | 38.0 | 1 | 0 | 71.2833 | C | Mrs | True | 3 | 3 |
| 2 | 3 | female | 26.0 | 0 | 0 | 7.9250 | S | Miss | False | 1 | 1 |
| 3 | 1 | female | 35.0 | 1 | 0 | 53.1000 | S | Mrs | True | 2 | 3 |
| 4 | 3 | male | 35.0 | 0 | 0 | 8.0500 | S | Mr | False | 2 | 1 |
Not veriyi bir Seri olarak, data.Age ve data.Fare şeklinde gönderdiğinizi; ardından da çeyrek sayısını q=4 olarak belirttiğinizi unutmayın. Son olarak, bölmeleri sayılarla kodlamak için labels argümanını False olarak ayarlıyorsunuz.
Artık tüm bu bilgileri bölmelere ayırdığınıza göre, 'Age' ve 'Fare' sütunlarını güvenle atabilirsiniz. İlk beş satırı kontrol etmeyi unutmayın!
data = data.drop(['Age', 'Fare'], axis=1)
data.head()
| Pclass | Sex | SibSp | Parch | Embarked | Title | Has_Cabin | CatAge | CatFare | |
|---|---|---|---|---|---|---|---|---|---|
| 0 | 3 | male | 1 | 0 | S | Mr | False | 0 | 0 |
| 1 | 1 | female | 1 | 0 | C | Mrs | True | 3 | 3 |
| 2 | 3 | female | 0 | 0 | S | Miss | False | 1 | 1 |
| 3 | 1 | female | 1 | 0 | S | Mrs | True | 2 | 3 |
| 4 | 3 | male | 0 | 0 | S | Mr | False | 2 | 1 |
Gemiye Binen Aile Üye Sayısı
Bir sonraki yapabileceğiniz şey, Titanic'e binen ailelerdeki üye sayısını içeren yeni bir sütun oluşturmaktır. Bu eğitimde buna girmeyecek ve modelin bunu olmadan nasıl performans gösterdiğine bakacağız. Bu ek sütunla modelin nasıl sonuç vereceğini görmek isterseniz, aşağıdaki kod satırını çalıştırın:
# Create column of number of Family members onboard
data['Fam_Size'] = data.Parch + data.SibSp
Şimdilik, 'SibSp' ve 'Parch' sütunlarını DataFrame'inizden atmaya devam edeceksiniz:
# Drop columns
data = data.drop(['SibSp','Parch'], axis=1)
data.head()
| Pclass | Sex | Embarked | Title | Has_Cabin | CatAge | CatFare | |
|---|---|---|---|---|---|---|---|
| 0 | 3 | male | S | Mr | False | 0 | 0 |
| 1 | 1 | female | C | Mrs | True | 3 | 3 |
| 2 | 3 | female | S | Miss | False | 1 | 1 |
| 3 | 1 | female | S | Mrs | True | 2 | 3 |
| 4 | 3 | male | S | Mr | False | 2 | 1 |
'Title' ve 'Has_Cabin' gibi daha fazla öznitelik türettiğinize, eksik değerlerle ilgilendiğinize ve sayısal verinizi bölmelere ayırdığınıza göre, şimdi tüm değişkenleri sayısal olanlara dönüştürme zamanı. Bunu yapmanızın nedeni, makine öğrenmesi modellerinin genellikle sayısal girdi almasıdır.
Daha önce yaptığınız gibi, bunu yapmak için .get_dummies() kullanacaksınız:
# Transform into binary variables
data_dum = pd.get_dummies(data, drop_first=True)
data_dum.head()
| Pclass | Has_Cabin | CatAge | CatFare | Sex_male | Embarked_Q | Embarked_S | Title_Miss | Title_Mr | Title_Mrs | Title_Special | |
|---|---|---|---|---|---|---|---|---|---|---|---|
| 0 | 3 | False | 0 | 0 | 1 | 0 | 1 | 0 | 1 | 0 | 0 |
| 1 | 1 | True | 3 | 3 | 0 | 0 | 0 | 0 | 0 | 1 | 0 |
| 2 | 3 | False | 1 | 1 | 0 | 0 | 1 | 1 | 0 | 0 | 0 |
| 3 | 1 | True | 2 | 3 | 0 | 0 | 1 | 0 | 0 | 1 | 0 |
| 4 | 3 | False | 2 | 1 | 1 | 0 | 1 | 0 | 1 | 0 | 0 |
Tüm bunlar tamamlandığına göre, artık nihai modelinizi kurma zamanı!
Daha önce olduğu gibi, önce data'yı tekrar eğitim ve test setlerine böleceksiniz. Ardından, bunları dizilere dönüştüreceksiniz:
# Split into test.train
data_train = data_dum.iloc[:891]
data_test = data_dum.iloc[891:]

# Transform into arrays for scikit-learn
X = data_train.values
test = data_test.values
y = survived_train.values
Şimdi yepyeni, öznitelik mühendisliği uygulanmış veri kümeniz üzerinde bir karar ağacı kuracaksınız. Hiperparametre max_depth'ü seçmek için, test-train ayırımının bir çeşidi olan "çapraz doğrulama" kullanacaksınız.
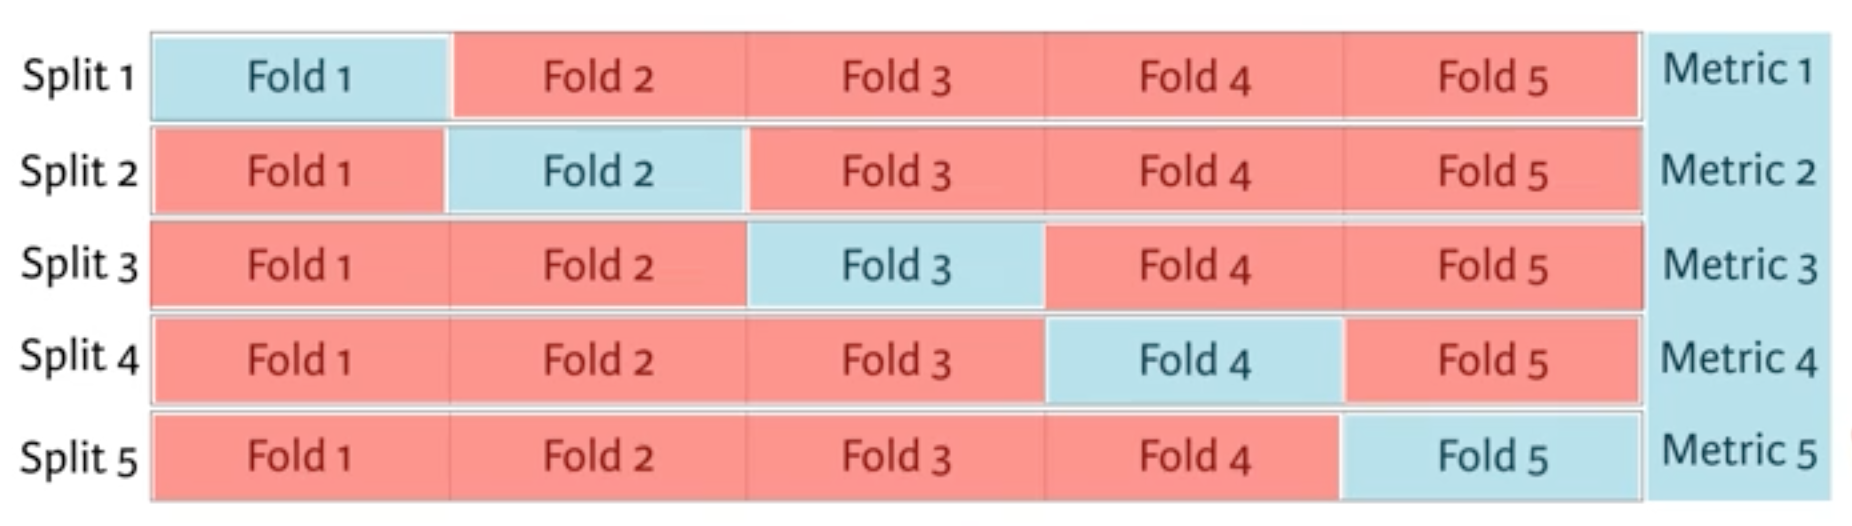
Önce veri kümesini 5 gruba veya fold'a ayırırsınız. Sonra ilk fold'u test seti olarak ayırır, modeli kalan dört fold üzerinde fit eder, test setinde tahmin yapar ve ilgili metriği hesaplarsınız. Ardından ikinci fold'u test setiniz olarak ayırır, kalan veri üzerinde fit eder, test setinde tahmin yapar ve metriği hesaplarsınız. Benzer şekilde üçüncü, dördüncü ve beşinci ile devam edersiniz.
Sonuç olarak, ilgi duyduğunuz istatistikleri, örneğin medyan ve/veya ortalama ile %95 güven aralıklarını hesaplayabileceğiniz beş doğruluk değeri elde edersiniz.
Bunu, ayarladığınız her hiperparametrenin her değeri için yapar ve en iyi performans gösteren hiperparametre kümesini seçersiniz. Buna ızgara araması (grid search) denir.
Şimdilik bu kadar yeter, haydi başlayalım!
Aşağıda, yeni öznitelik mühendisliği uygulanmış veri kümeniz için en iyi max_depth'ü seçmek amacıyla çapraz doğrulama ve ızgara aramasını kullanacaksınız:
# Setup the hyperparameter grid
dep = np.arange(1,9)
param_grid = {'max_depth' : dep}

# Instantiate a decision tree classifier: clf
clf = tree.DecisionTreeClassifier()

# Instantiate the GridSearchCV object: clf_cv
clf_cv = GridSearchCV(clf, param_grid=param_grid, cv=5)

# Fit it to the data
clf_cv.fit(X, y)

# Print the tuned parameter and score
print("Tuned Decision Tree Parameters: {}".format(clf_cv.best_params_))
print("Best score is {}".format(clf_cv.best_score_))
Tuned Decision Tree Parameters: {'max_depth': 3}
Best score is 0.8103254769921436
Artık test setinizde tahminler yapabilir, yeni bir 'Survived' sütunu oluşturup tahminlerinizi burada saklayabilirsiniz. df_test içindeki 'PassengerId' ve 'Survived' sütunlarını bir .csv dosyasına kaydedip Kaggle'a göndermeyi unutmayın!
Y_pred = clf_cv.predict(test)
df_test['Survived'] = Y_pred
df_test[['PassengerId', 'Survived']].to_csv('data/predictions/dec_tree_feat_eng.csv', index=False)
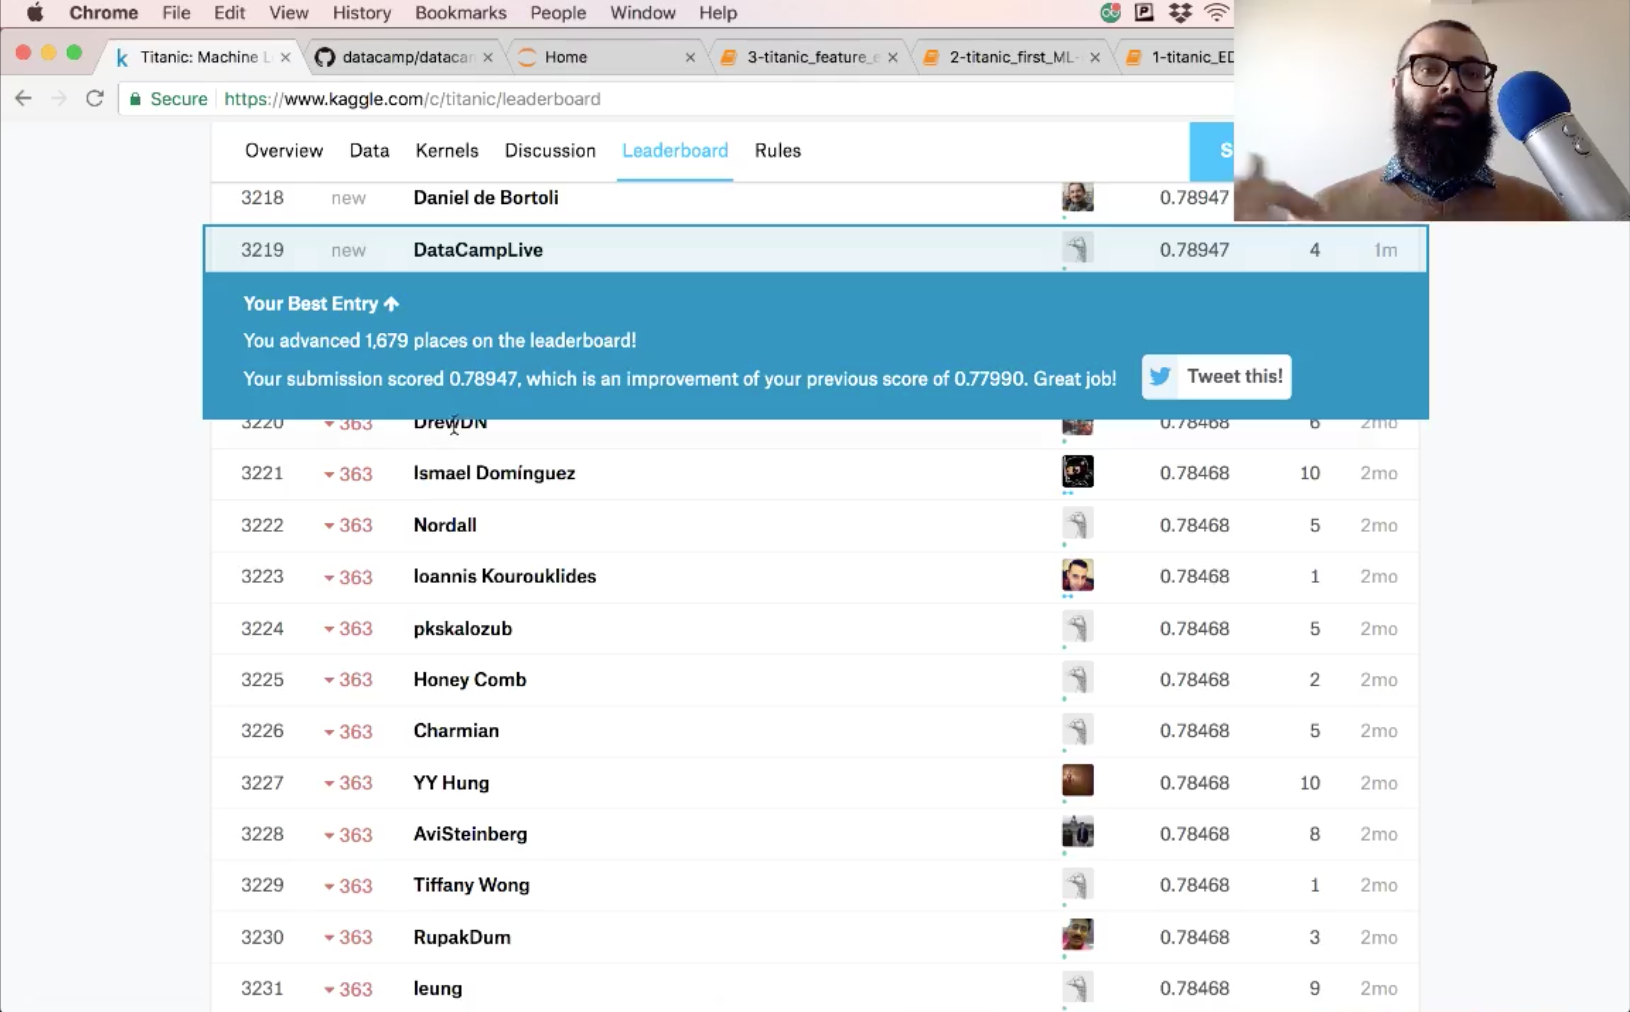
Gönderiminizin doğruluğu 78,9.
Biraz daha öznitelik mühendisliği yapıp bazı yeni modeller deneyerek bu puanı iyileştirip iyileştiremeyeceğinize bakın. Bu not defteri, önceki iki taneyle birlikte GitHub'da yayımlandı ve hepinizin bu modelleri geliştirdiğini görmek harika olur.
Verinizi ölçeklendirmek gibi öğrenmek isteyeceğiniz çok daha fazla ön işleme tekniği var. scikit-learn boru hatlarını da son derece faydalı bulacaksınız. Tüm bunlar ve daha fazlası için scikit-learn ile Denetimli Öğrenme kursumuza ve scikit-learn dokümanlarına göz atın.
Makine Öğrenmesi Kursları
Kurs
Kurs
Kurs
blog
Dario Radečić
15 dk.
blog
Abid Ali Awan
14 dk.
Eğitim
Adel Nehme
Eğitim
Kurtis Pykes
8 dk.




