Kurs
Machine Learning verstehen
2 Std.
308K
In den zwei vorherigen Kaggle-Tutorials hast du gelernt, wie du deine Daten in die richtige Form bringst, um dein erstes Machine-Learning-Modell zu bauen – mithilfe von Exploratory Data Analysis und Baseline-Modellen. Anschließend hast du erfolgreich dein erstes Machine-Learning-Modell erstellt, einen Decision-Tree-Classifier. Du hast all diese Modelle bei Kaggle eingereicht und ihre Accuracy interpretiert.
In diesem dritten Tutorial lernst du mehr über Feature Engineering – also den Prozess, bei dem du Domänenwissen über deine Daten nutzt, um zusätzliche relevante Merkmale zu erstellen, die die Vorhersagekraft des Lernalgorithmus erhöhen und deine Machine-Learning-Modelle noch besser performen lassen!
Im Detail:
Bevor du startest, führst du wie im letzten Tutorial alle Imports aus, nutzt etwas IPython-Magie, damit Grafiken inline im Jupyter Notebook dargestellt werden, und setzt den Visualisierungsstil. Danach importierst du die Daten und sorgst dafür, dass du die Zielvariable der Trainingsdaten sicher ablegst. Anschließend führst du Train- und Testdaten zusammen (mit Ausnahme der Spalte 'Survived' aus df_train) und speicherst das Ergebnis in data.
Merke: Das machst du, damit jede Vorverarbeitung, die du auf die Daten anwendest, sowohl im Train- als auch im Test-Set abgebildet wird!
Zum Schluss nutzt du die Methode .info(), um dir deine Daten anzuschauen:
# Imports
import pandas as pd
import matplotlib.pyplot as plt
import seaborn as sns
import re
import numpy as np
from sklearn import tree
from sklearn.model_selection import GridSearchCV

# Figures inline and set visualization style
%matplotlib inline
sns.set()

# Import data
df_train = pd.read_csv('data/train.csv')
df_test = pd.read_csv('data/test.csv')

# Store target variable of training data in a safe place
survived_train = df_train.Survived

# Concatenate training and test sets
data = pd.concat([df_train.drop(['Survived'], axis=1), df_test])

# View head
data.info()
<class 'pandas.core.frame.DataFrame'>
Int64Index: 1309 entries, 0 to 417
Data columns (total 11 columns):
PassengerId    1309 non-null int64
Pclass         1309 non-null int64
Name           1309 non-null object
Sex            1309 non-null object
Age            1046 non-null float64
SibSp          1309 non-null int64
Parch          1309 non-null int64
Ticket         1309 non-null object
Fare           1308 non-null float64
Cabin          295 non-null object
Embarked       1307 non-null object
dtypes: float64(2), int64(4), object(5)
memory usage: 122.7+ KBMit Feature Engineering holst du mehr Information aus deinen Daten heraus – und holst beim Modellieren mehr aus deinen Modellen.
Schauen wir uns das an einem Beispiel an. Sieh dir die Spalte 'Name' mit der Methode .tail() an, die dir die letzten fünf Zeilen deiner Daten zeigt:
# View head of 'Name' column
data.Name.tail()
413              Spector, Mr. Woolf
414    Oliva y Ocana, Dona. Fermina
415    Saether, Mr. Simon Sivertsen
416             Ware, Mr. Frederick
417        Peter, Master. Michael J
Name: Name, dtype: object
Plötzlich tauchen unterschiedliche Anreden auf! Diese Spalte enthält also Zeichenketten bzw. Text mit Titeln wie "Mr", "Master" oder "Dona".
Diese Titel liefern Hinweise auf sozialen Status, Beruf etc. – und könnten damit etwas über das Überleben aussagen.
Auf den ersten Blick scheint es schwierig, Namen und Titel zu trennen – keine Panik! Mit regulären Ausdrücken kannst du den Titel extrahieren und in einer neuen Spalte 'Title' speichern:
# Extract Title from Name, store in column and plot barplot
data['Title'] = data.Name.apply(lambda x: re.search(' ([A-Z][a-z]+)\.', x).group(1))
sns.countplot(x='Title', data=data);
plt.xticks(rotation=45);
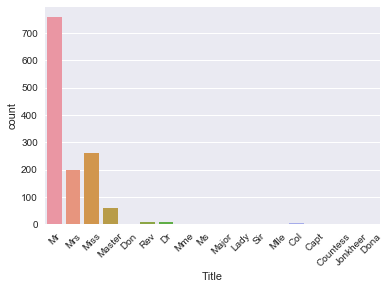
Hinweis: Diese neue Spalte 'Title' ist ein neu entwickeltes Feature für deinen Datensatz!
Tipp: Wenn du mehr zu regulären Ausdrücken lernen willst, lies meinen Beitrag zu unserem letzten FB Live Code-Along oder schau dir DataCamps Python Regular Expressions Tutorial an.
Im Plot oben gibt es mehrere Titel, einige kommen selten vor. Es ergibt Sinn, sie in weniger Klassen zusammenzufassen.
Zum Beispiel kannst du 'Mlle' und 'Ms' durch 'Miss' ersetzen und 'Mme' durch 'Mrs', da es französische Titel sind – idealerweise ist alles in einer Sprache. Außerdem bündelst du einige schwer zuzuordnende Titel in einer Kategorie 'Special'.
Tipp: Probiere aus, wie sich diese Gruppierung auf die Performance deines Algorithmus auswirkt!
Anschließend visualisierst du das Ergebnis erneut mit .countplot():
data['Title'] = data['Title'].replace({'Mlle':'Miss', 'Mme':'Mrs', 'Ms':'Miss'})
data['Title'] = data['Title'].replace(['Don', 'Dona', 'Rev', 'Dr',
                                            'Major', 'Lady', 'Sir', 'Col', 'Capt', 'Countess', 'Jonkheer'],'Special')
sns.countplot(x='Title', data=data);
plt.xticks(rotation=45);
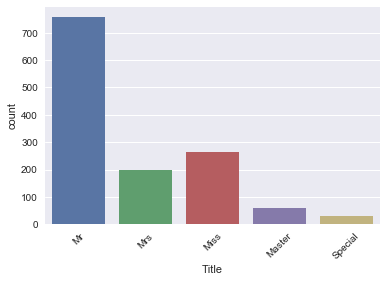
So sieht dein neu entwickeltes Feature 'Title' jetzt aus!
Überprüfe nun, dass du eine Spalte 'Title' hast, und wirf mit .tail() erneut einen Blick auf die Daten:
# View head of data
data.tail()
| PassengerId | Pclass | Name | Sex | Age | SibSp | Parch | Ticket | Fare | Cabin | Embarked | Title | |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 413 | 1305 | 3 | Spector, Mr. Woolf | male | NaN | 0 | 0 | A.5. 3236 | 8.0500 | NaN | S | Mr |
| 414 | 1306 | 1 | Oliva y Ocana, Dona. Fermina | female | 39.0 | 0 | 0 | PC 17758 | 108.9000 | C105 | C | Special |
| 415 | 1307 | 3 | Saether, Mr. Simon Sivertsen | male | 38.5 | 0 | 0 | SOTON/O.Q. 3101262 | 7.2500 | NaN | S | Mr |
| 416 | 1308 | 3 | Ware, Mr. Frederick | male | NaN | 0 | 0 | 359309 | 8.0500 | NaN | S | Mr |
| 417 | 1309 | 3 | Peter, Master. Michael J | male | NaN | 1 | 1 | 2668 | 22.3583 | NaN | C | Master |
Beim Laden und Prüfen der Daten hast du gesehen, dass es in der Spalte 'Cabin' mehrere NaN-Werte bzw. fehlende Werte gibt.
Es ist plausibel anzunehmen, dass diese NaN-Werte bedeuten, dass die Personen keine Kabine hatten – was wiederum etwas über 'Survival' aussagen könnte. Erstelle daher eine neue Spalte 'Has_Cabin', die kodiert, ob eine Person eine Kabine hatte oder nicht.
Hinweis: In dem folgenden Code verwendest du .isnull(). Das ergibt True, wenn die Person keine Kabine hat, und False, wenn doch. Da du das Ergebnis aber in 'Has_Cabin' speichern möchtest, drehst du das Ergebnis mit der Tilde ~ um: Du willst True zurückgeben, wenn eine Kabine vorhanden ist.
# Did they have a Cabin?
data['Has_Cabin'] = ~data.Cabin.isnull()

# View head of data
data.head()
| PassengerId | Pclass | Name | Sex | Age | SibSp | Parch | Ticket | Fare | Cabin | Embarked | Title | Has_Cabin | |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 0 | 1 | 3 | Braund, Mr. Owen Harris | male | 22.0 | 1 | 0 | A/5 21171 | 7.2500 | NaN | S | Mr | False |
| 1 | 2 | 1 | Cumings, Mrs. John Bradley (Florence Briggs Th... | female | 38.0 | 1 | 0 | PC 17599 | 71.2833 | C85 | C | Mrs | True |
| 2 | 3 | 3 | Heikkinen, Miss. Laina | female | 26.0 | 0 | 0 | STON/O2. 3101282 | 7.9250 | NaN | S | Miss | False |
| 3 | 4 | 1 | Futrelle, Mrs. Jacques Heath (Lily May Peel) | female | 35.0 | 1 | 0 | 113803 | 53.1000 | C123 | S | Mrs | True |
| 4 | 5 | 3 | Allen, Mr. William Henry | male | 35.0 | 0 | 0 | 373450 | 8.0500 | NaN | S | Mr | False |
Als Nächstes wirfst du einige Spalten heraus, die keinen weiteren Mehrwert liefern (oder bei denen unklar ist, wie man sie nutzt). Hier betrifft das ['Cabin', 'Name', 'PassengerId', 'Ticket'], denn:
'Has_Cabin' kodiert, ob eine Person eine Kabine hatte;'Name' extrahiert;'PassengerId' und 'Ticket' liefern vermutlich keinen Erkenntnisgewinn für das Überleben der Titanic-Passagiere.Tipp: In 'Cabin' könnte noch mehr Information stecken, aber für dieses Tutorial nehmen wir an, dass das nicht der Fall ist.
Um diese Spalten im DataFrame data zu löschen, nutze das Argument inplace in .drop() und setze es auf True:
# Drop columns and view head
data.drop(['Cabin', 'Name', 'PassengerId', 'Ticket'], axis=1, inplace=True)
data.head()
| Pclass | Sex | Age | SibSp | Parch | Fare | Embarked | Title | Has_Cabin | |
|---|---|---|---|---|---|---|---|---|---|
| 0 | 3 | male | 22.0 | 1 | 0 | 7.2500 | S | Mr | False |
| 1 | 1 | female | 38.0 | 1 | 0 | 71.2833 | C | Mrs | True |
| 2 | 3 | female | 26.0 | 0 | 0 | 7.9250 | S | Miss | False |
| 3 | 1 | female | 35.0 | 1 | 0 | 53.1000 | S | Mrs | True |
| 4 | 3 | male | 35.0 | 0 | 0 | 8.0500 | S | Mr | False |
Glückwunsch! Du hast erfolgreich neue Features wie 'Title' und 'Has_Cabin' entwickelt und Spalten entfernt, die deinem Modell keinen zusätzlichen Nutzen bringen.
Als Nächstes gehst du fehlende Werte an, bildest Bins für numerische Daten und wandelst anschließend alle Features mit .get_dummies() in numerische Variablen um. Zum Schluss baust du das finale Modell für dieses Tutorial. Wie das geht, siehst du in den nächsten Abschnitten!
Nach all den Änderungen am ursprünglichen DataFrame data ist es sinnvoll, mit .info() zu prüfen, ob noch fehlende Werte übrig sind:
data.info()
<class 'pandas.core.frame.DataFrame'>
Int64Index: 1309 entries, 0 to 417
Data columns (total 9 columns):
Pclass       1309 non-null int64
Sex          1309 non-null object
Age          1046 non-null float64
SibSp        1309 non-null int64
Parch        1309 non-null int64
Fare         1308 non-null float64
Embarked     1307 non-null object
Title        1309 non-null object
Has_Cabin    1309 non-null bool
dtypes: bool(1), float64(2), int64(3), object(3)
memory usage: 133.3+ KB
Das Ergebnis zeigt fehlende Werte in 'Age', 'Fare' und 'Embarked'.
Merke: Du erkennst das, indem du zuerst auf die Gesamtanzahl der Einträge (1309) schaust und dann die Anzahl der Non-Null-Werte in den jeweiligen Spalten prüfst. 'Age' hat 1046 Non-Null-Werte, also fehlen 263. 'Fare' fehlt ein Wert, 'Embarked' fehlen zwei.
Wie im vorherigen Tutorial imputest du die fehlenden Werte mit .fillna():
Hinweis: Für 'Age' und 'Fare' nutzt du wieder den Median, da er gut mit Ausreißern umgeht. Alternativen wären der Mittelwert (Summe aller Werte geteilt durch die Anzahl) oder der Modus (der am häufigsten vorkommende Wert).
Die zwei fehlenden Werte in 'Embarked' füllst du mit 'S' (Southampton), da dieser Wert in der Spalte am häufigsten vorkommt.
Tipp: Das kannst du mit etwas Exploratory Data Analysis leicht nachprüfen!
# Impute missing values for Age, Fare, Embarked
data['Age'] = data.Age.fillna(data.Age.median())
data['Fare'] = data.Fare.fillna(data.Fare.median())
data['Embarked'] = data['Embarked'].fillna('S')
data.info()
<class 'pandas.core.frame.DataFrame'>
Int64Index: 1309 entries, 0 to 417
Data columns (total 9 columns):
Pclass       1309 non-null int64
Sex          1309 non-null object
Age          1309 non-null float64
SibSp        1309 non-null int64
Parch        1309 non-null int64
Fare         1309 non-null float64
Embarked     1309 non-null object
Title        1309 non-null object
Has_Cabin    1309 non-null bool
dtypes: bool(1), float64(2), int64(3), object(3)
memory usage: 133.3+ KB
data.head()
| Pclass | Sex | Age | SibSp | Parch | Fare | Embarked | Title | Has_Cabin | |
|---|---|---|---|---|---|---|---|---|---|
| 0 | 3 | male | 22.0 | 1 | 0 | 7.2500 | S | Mr | False |
| 1 | 1 | female | 38.0 | 1 | 0 | 71.2833 | C | Mrs | True |
| 2 | 3 | female | 26.0 | 0 | 0 | 7.9250 | S | Miss | False |
| 3 | 1 | female | 35.0 | 1 | 0 | 53.1000 | S | Mrs | True |
| 4 | 3 | male | 35.0 | 0 | 0 | 8.0500 | S | Mr | False |
Als Nächstes bündelst du die numerischen Daten, da es Bereiche bei Alter und Fahrpreis gibt. In diesen Bereichen können Schwankungen stecken, die keine Muster widerspiegeln, sondern Rauschen sind. Deshalb legst du Personen innerhalb bestimmter Alters- oder Fahrpreisbereiche in die gleichen Bins. Das geht mit der pandas-Funktion qcut():
# Binning numerical columns
data['CatAge'] = pd.qcut(data.Age, q=4, labels=False )
data['CatFare']= pd.qcut(data.Fare, q=4, labels=False)
data.head()
| Pclass | Sex | Age | SibSp | Parch | Fare | Embarked | Title | Has_Cabin | CatAge | CatFare | |
|---|---|---|---|---|---|---|---|---|---|---|---|
| 0 | 3 | male | 22.0 | 1 | 0 | 7.2500 | S | Mr | False | 0 | 0 |
| 1 | 1 | female | 38.0 | 1 | 0 | 71.2833 | C | Mrs | True | 3 | 3 |
| 2 | 3 | female | 26.0 | 0 | 0 | 7.9250 | S | Miss | False | 1 | 1 |
| 3 | 1 | female | 35.0 | 1 | 0 | 53.1000 | S | Mrs | True | 2 | 3 |
| 4 | 3 | male | 35.0 | 0 | 0 | 8.0500 | S | Mr | False | 2 | 1 |
Hinweis: Du übergibst die Daten als Series (data.Age und data.Fare), setzt die Anzahl der Quantile mit q=4 und stellst labels=False ein, damit die Bins als Zahlen kodiert werden.
Da nun alles gebinnt ist, kannst du die Spalten 'Age' und 'Fare' entfernen. Vergiss nicht, dir die ersten fünf Zeilen anzusehen!
data = data.drop(['Age', 'Fare'], axis=1)
data.head()
| Pclass | Sex | SibSp | Parch | Embarked | Title | Has_Cabin | CatAge | CatFare | |
|---|---|---|---|---|---|---|---|---|---|
| 0 | 3 | male | 1 | 0 | S | Mr | False | 0 | 0 |
| 1 | 1 | female | 1 | 0 | C | Mrs | True | 3 | 3 |
| 2 | 3 | female | 0 | 0 | S | Miss | False | 1 | 1 |
| 3 | 1 | female | 1 | 0 | S | Mrs | True | 2 | 3 |
| 4 | 3 | male | 0 | 0 | S | Mr | False | 2 | 1 |
Als Nächstes könntest du eine neue Spalte erstellen, die die Anzahl der Familienmitglieder an Bord enthält. In diesem Tutorial lassen wir das außen vor und schauen, wie das Modell ohne diese Spalte performt. Wenn du testen willst, wie sich die zusätzliche Spalte auswirkt, führe folgende Zeile aus:
# Create column of number of Family members onboard
data['Fam_Size'] = data.Parch + data.SibSp
Wirf für den Moment die Spalten 'SibSp' und 'Parch' aus deinem DataFrame:
# Drop columns
data = data.drop(['SibSp','Parch'], axis=1)
data.head()
| Pclass | Sex | Embarked | Title | Has_Cabin | CatAge | CatFare | |
|---|---|---|---|---|---|---|---|
| 0 | 3 | male | S | Mr | False | 0 | 0 |
| 1 | 1 | female | C | Mrs | True | 3 | 3 |
| 2 | 3 | female | S | Miss | False | 1 | 1 |
| 3 | 1 | female | S | Mrs | True | 2 | 3 |
| 4 | 3 | male | S | Mr | False | 2 | 1 |
Jetzt, da du weitere Features wie 'Title' und 'Has_Cabin' entwickelt, fehlende Werte behandelt und numerische Daten gebinnt hast, ist es Zeit, alle Variablen in numerische zu überführen. Das ist nötig, weil Machine-Learning-Modelle in der Regel numerische Eingaben erwarten.
Wie zuvor nutzt du dazu .get_dummies():
# Transform into binary variables
data_dum = pd.get_dummies(data, drop_first=True)
data_dum.head()
| Pclass | Has_Cabin | CatAge | CatFare | Sex_male | Embarked_Q | Embarked_S | Title_Miss | Title_Mr | Title_Mrs | Title_Special | |
|---|---|---|---|---|---|---|---|---|---|---|---|
| 0 | 3 | False | 0 | 0 | 1 | 0 | 1 | 0 | 1 | 0 | 0 |
| 1 | 1 | True | 3 | 3 | 0 | 0 | 0 | 0 | 0 | 1 | 0 |
| 2 | 3 | False | 1 | 1 | 0 | 0 | 1 | 1 | 0 | 0 | 0 |
| 3 | 1 | True | 2 | 3 | 0 | 0 | 1 | 0 | 0 | 1 | 0 |
| 4 | 3 | False | 2 | 1 | 1 | 0 | 1 | 0 | 1 | 0 | 0 |
Damit ist alles vorbereitet – Zeit für dein finales Modell!
Wie zuvor teilst du data wieder in Trainings- und Testdaten auf und wandelst sie in Arrays um:
# Split into test.train
data_train = data_dum.iloc[:891]
data_test = data_dum.iloc[891:]

# Transform into arrays for scikit-learn
X = data_train.values
test = data_test.values
y = survived_train.values
Jetzt baust du einen Decision Tree auf deinem neu feature-entwickelten Datensatz. Um den Hyperparameter max_depth zu wählen, nutzt du eine Variante des Train-Test-Splits namens „Cross-Validation“.
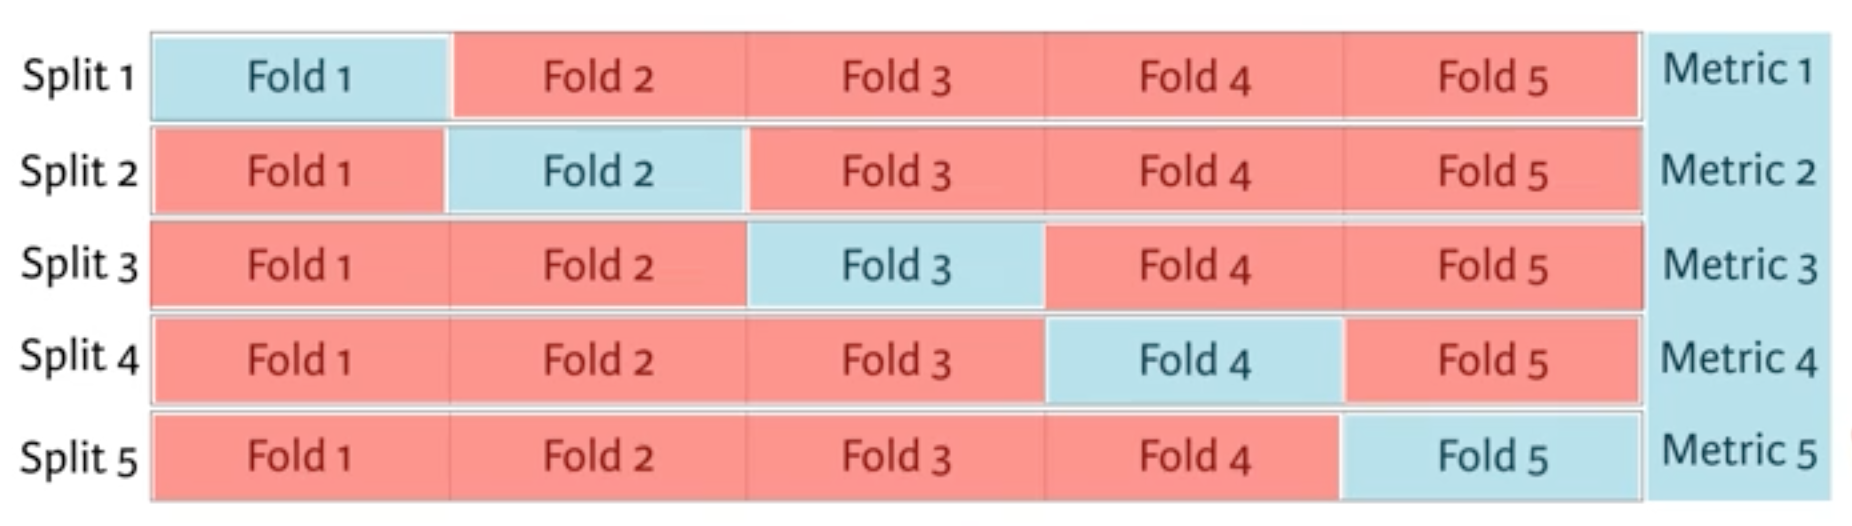
Du teilst den Datensatz zunächst in 5 Gruppen oder Folds. Dann hältst du den ersten Fold als Testmenge zurück, trainierst dein Modell auf den verbleibenden vier Folds, sagst auf dem Testfold voraus und berechnest die Metrik. Danach hältst du den zweiten Fold zurück, trainierst auf den restlichen Daten, sagst voraus und berechnest die Metrik – und so weiter für den dritten, vierten und fünften.
Am Ende hast du fünf Accuracy-Werte, aus denen du interessante Statistiken berechnen kannst, z. B. Median, Mittelwert und 95%-Konfidenzintervalle.
Das machst du für jede Kombination der zu tunenden Hyperparameter und wählst das Set, das am besten abschneidet. Das nennt man Grid Search.
Genug Theorie – los geht's!
Im Folgenden nutzt du Cross-Validation und Grid Search, um das beste max_depth für deinen neuen Datensatz zu wählen:
# Setup the hyperparameter grid
dep = np.arange(1,9)
param_grid = {'max_depth' : dep}

# Instantiate a decision tree classifier: clf
clf = tree.DecisionTreeClassifier()

# Instantiate the GridSearchCV object: clf_cv
clf_cv = GridSearchCV(clf, param_grid=param_grid, cv=5)

# Fit it to the data
clf_cv.fit(X, y)

# Print the tuned parameter and score
print("Tuned Decision Tree Parameters: {}".format(clf_cv.best_params_))
print("Best score is {}".format(clf_cv.best_score_))
Tuned Decision Tree Parameters: {'max_depth': 3}
Best score is 0.8103254769921436
Jetzt kannst du Vorhersagen für dein Test-Set machen, eine neue Spalte 'Survived' anlegen und deine Predictions darin speichern. Vergiss nicht, die Spalten 'PassengerId' und 'Survived' aus df_test als .csv zu speichern und bei Kaggle einzureichen!
Y_pred = clf_cv.predict(test)
df_test['Survived'] = Y_pred
df_test[['PassengerId', 'Survived']].to_csv('data/predictions/dec_tree_feat_eng.csv', index=False)
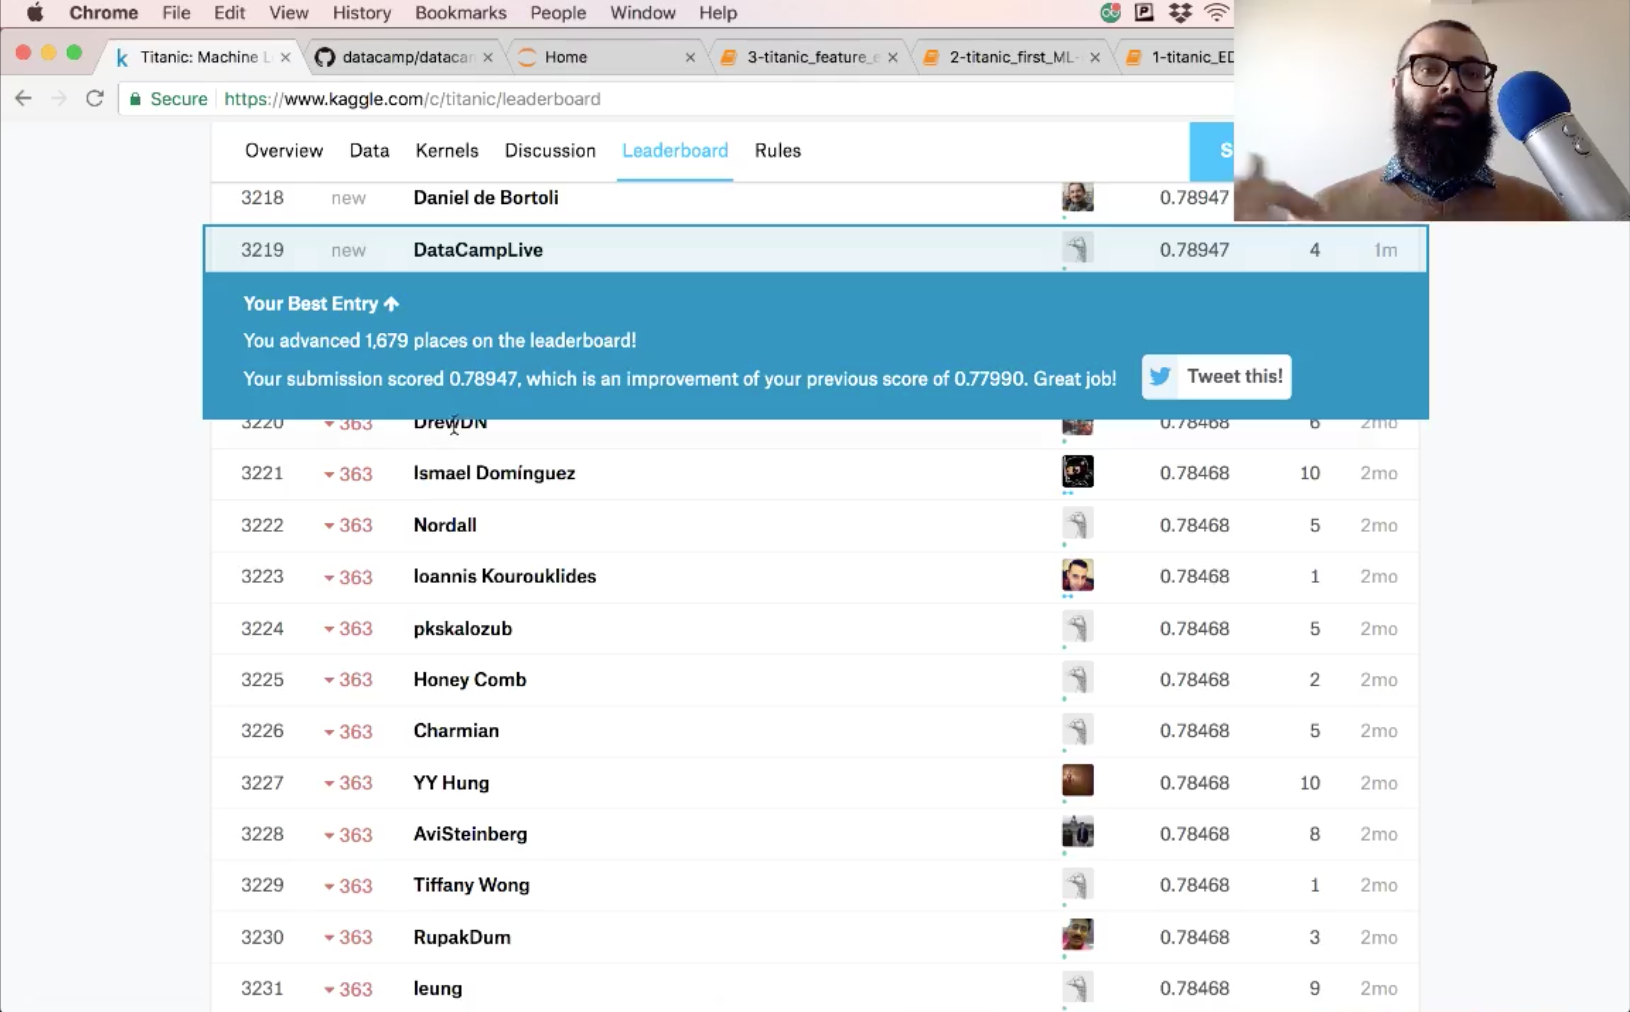
Die Accuracy deiner Einreichung beträgt 78,9.
Schau, ob du noch mehr Feature Engineering betreiben und neue Modelle ausprobieren kannst, um diesen Score zu verbessern. Dieses Notebook – zusammen mit den beiden vorherigen – findest du auf GitHub. Es wäre großartig zu sehen, wie ihr die Modelle noch weiter verbessert.
Es gibt noch viel mehr Preprocessing zu lernen, etwa das Skalieren von Daten. Außerdem sind scikit-learn-Pipelines extrem hilfreich. Sieh dir unseren Kurs Supervised Learning with scikit-learn und die scikit-learn-Dokumentation an – für all das und mehr.
Machine-Learning-Kurse
Kurs
Kurs
Kurs