Curso
Entendendo Machine Learning
2 h
308K
Nos dois tutoriais anteriores de Kaggle, você viu como preparar seus dados para criar seu primeiro modelo de machine learning, usando análise exploratória de dados e modelos básicos. Em seguida, você conseguiu construir seu primeiro modelo, um classificador de árvore de decisão. Você enviou esses modelos para o Kaggle e interpretou a acurácia.
Neste terceiro tutorial, você vai aprender mais sobre feature engineering, um processo em que você usa o conhecimento do domínio dos seus dados para criar recursos adicionais relevantes que aumentam o poder preditivo do algoritmo e fazem seus modelos de machine learning performarem ainda melhor!
Mais especificamente,
Antes de começar, faça os imports como no tutorial anterior, use um pouco de magia do IPython para garantir que as figuras sejam geradas inline no Jupyter Notebook e defina o estilo de visualização. Em seguida, importe seus dados e armazene a variável alvo do conjunto de treino em um lugar seguro. Depois, una os conjuntos de treino e teste (com exceção da coluna 'Survived' de df_train) e guarde o resultado em data.
Lembre-se de que isso garante que qualquer pré-processamento feito nos dados seja refletido tanto no treino quanto no teste!
Por fim, use o método .info() para dar uma olhada nos seus dados:
# Imports
import pandas as pd
import matplotlib.pyplot as plt
import seaborn as sns
import re
import numpy as np
from sklearn import tree
from sklearn.model_selection import GridSearchCV

# Figures inline and set visualization style
%matplotlib inline
sns.set()

# Import data
df_train = pd.read_csv('data/train.csv')
df_test = pd.read_csv('data/test.csv')

# Store target variable of training data in a safe place
survived_train = df_train.Survived

# Concatenate training and test sets
data = pd.concat([df_train.drop(['Survived'], axis=1), df_test])

# View head
data.info()
<class 'pandas.core.frame.DataFrame'>
Int64Index: 1309 entries, 0 to 417
Data columns (total 11 columns):
PassengerId    1309 non-null int64
Pclass         1309 non-null int64
Name           1309 non-null object
Sex            1309 non-null object
Age            1046 non-null float64
SibSp          1309 non-null int64
Parch          1309 non-null int64
Ticket         1309 non-null object
Fare           1308 non-null float64
Cabin          295 non-null object
Embarked       1307 non-null object
dtypes: float64(2), int64(4), object(5)
memory usage: 122.7+ KBVocê faz feature engineering para extrair mais informação dos seus dados e, assim, elevar o nível quando estiver construindo modelos.
Vamos ver um exemplo. Dê uma olhada na coluna 'Name' com a ajuda do método .tail(), que mostra as últimas cinco linhas dos seus dados:
# View head of 'Name' column
data.Name.tail()
413              Spector, Mr. Woolf
414    Oliva y Ocana, Dona. Fermina
415    Saether, Mr. Simon Sivertsen
416             Ware, Mr. Frederick
417        Peter, Master. Michael J
Name: Name, dtype: object
De repente, aparecem diferentes títulos! Ou seja, essa coluna contém textos com títulos como "Mr", "Master" e "Dona".
Esses títulos informam status social, profissão etc., o que no fim pode dizer algo sobre a sobrevivência.
À primeira vista, pode parecer difícil separar nomes de títulos, mas calma! Você pode usar expressões regulares para extrair o título e armazená-lo em uma nova coluna 'Title':
# Extract Title from Name, store in column and plot barplot
data['Title'] = data.Name.apply(lambda x: re.search(' ([A-Z][a-z]+)\.', x).group(1))
sns.countplot(x='Title', data=data);
plt.xticks(rotation=45);
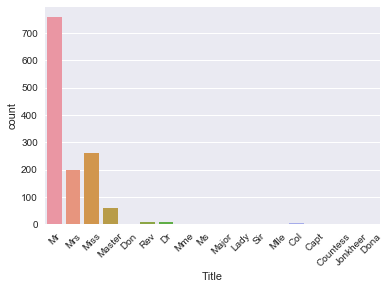
Observação: essa nova coluna 'Title' é um novo feature do seu conjunto de dados!
Dica: para aprender mais sobre expressões regulares, confira meu artigo sobre nosso último evento de code along no FB Live ou o tutorial de expressões regulares em Python da DataCamp.
Você pode ver que há vários títulos no gráfico acima, e muitos aparecem raramente. Faz sentido agrupá-los em menos categorias.
Por exemplo, você provavelmente quer substituir 'Mlle' e 'Ms' por 'Miss' e 'Mme' por 'Mrs', pois são títulos franceses e, idealmente, você quer os dados em um único idioma. Em seguida, reúna títulos que não dá para categorizar de imediato e coloque-os em um grupo chamado 'Special'.
Dica: teste variações e veja como o algoritmo se comporta!
Depois, visualize o resultado com um barplot usando o método .countplot():
data['Title'] = data['Title'].replace({'Mlle':'Miss', 'Mme':'Mrs', 'Ms':'Miss'})
data['Title'] = data['Title'].replace(['Don', 'Dona', 'Rev', 'Dr',
                                            'Major', 'Lady', 'Sir', 'Col', 'Capt', 'Countess', 'Jonkheer'],'Special')
sns.countplot(x='Title', data=data);
plt.xticks(rotation=45);
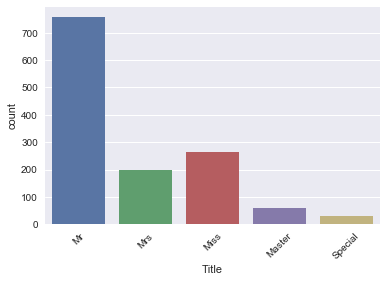
É assim que fica seu feature recém-criado, 'Title'!
Agora, garanta que a coluna 'Title' existe e confira os dados novamente com o método .tail():
# View head of data
data.tail()
| PassengerId | Pclass | Name | Sex | Age | SibSp | Parch | Ticket | Fare | Cabin | Embarked | Title | |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 413 | 1305 | 3 | Spector, Mr. Woolf | male | NaN | 0 | 0 | A.5. 3236 | 8.0500 | NaN | S | Mr |
| 414 | 1306 | 1 | Oliva y Ocana, Dona. Fermina | female | 39.0 | 0 | 0 | PC 17758 | 108.9000 | C105 | C | Special |
| 415 | 1307 | 3 | Saether, Mr. Simon Sivertsen | male | 38.5 | 0 | 0 | SOTON/O.Q. 3101262 | 7.2500 | NaN | S | Mr |
| 416 | 1308 | 3 | Ware, Mr. Frederick | male | NaN | 0 | 0 | 359309 | 8.0500 | NaN | S | Mr |
| 417 | 1309 | 3 | Peter, Master. Michael J | male | NaN | 1 | 1 | 2668 | 22.3583 | NaN | C | Master |
Quando você carregou e inspecionou os dados, percebeu vários NaN ou valores ausentes na coluna 'Cabin'.
É razoável supor que esses NaN indiquem que a pessoa não tinha cabine, o que pode dizer algo sobre 'Survival'. Então, vamos criar a coluna 'Has_Cabin' para indicar se o passageiro tinha cabine ou não.
Observação: no código abaixo, o método .isnull() retorna True se o passageiro não tem cabine e False caso contrário. Mas como queremos armazenar em 'Has_Cabin' se o passageiro tem cabine, invertemos o resultado usando o til (~).
# Did they have a Cabin?
data['Has_Cabin'] = ~data.Cabin.isnull()

# View head of data
data.head()
| PassengerId | Pclass | Name | Sex | Age | SibSp | Parch | Ticket | Fare | Cabin | Embarked | Title | Has_Cabin | |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 0 | 1 | 3 | Braund, Mr. Owen Harris | male | 22.0 | 1 | 0 | A/5 21171 | 7.2500 | NaN | S | Mr | False |
| 1 | 2 | 1 | Cumings, Mrs. John Bradley (Florence Briggs Th... | female | 38.0 | 1 | 0 | PC 17599 | 71.2833 | C85 | C | Mrs | True |
| 2 | 3 | 3 | Heikkinen, Miss. Laina | female | 26.0 | 0 | 0 | STON/O2. 3101282 | 7.9250 | NaN | S | Miss | False |
| 3 | 4 | 1 | Futrelle, Mrs. Jacques Heath (Lily May Peel) | female | 35.0 | 1 | 0 | 113803 | 53.1000 | C123 | S | Mrs | True |
| 4 | 5 | 3 | Allen, Mr. William Henry | male | 35.0 | 0 | 0 | 373450 | 8.0500 | NaN | S | Mr | False |
Agora, você vai remover algumas colunas que não trazem mais informação útil (ou que não sabemos como usar). Neste caso, estamos olhando para ['Cabin', 'Name', 'PassengerId', 'Ticket'], porque
'Has_Cabin';'Name';'PassengerId' e 'Ticket' porque provavelmente não dizem nada sobre a sobrevivência dos passageiros do Titanic.Dica: pode haver mais informação na coluna 'Cabin', mas, para este tutorial, vamos assumir que não!
Para remover essas colunas do seu DataFrame data, use o argumento inplace do método .drop() e defina como True:
# Drop columns and view head
data.drop(['Cabin', 'Name', 'PassengerId', 'Ticket'], axis=1, inplace=True)
data.head()
| Pclass | Sex | Age | SibSp | Parch | Fare | Embarked | Title | Has_Cabin | |
|---|---|---|---|---|---|---|---|---|---|
| 0 | 3 | male | 22.0 | 1 | 0 | 7.2500 | S | Mr | False |
| 1 | 1 | female | 38.0 | 1 | 0 | 71.2833 | C | Mrs | True |
| 2 | 3 | female | 26.0 | 0 | 0 | 7.9250 | S | Miss | False |
| 3 | 1 | female | 35.0 | 1 | 0 | 53.1000 | S | Mrs | True |
| 4 | 3 | male | 35.0 | 0 | 0 | 8.0500 | S | Mr | False |
Parabéns! Você criou novos features como 'Title' e 'Has_Cabin' e removeu o que não agregava valor ao seu modelo!
Agora, vamos tratar valores ausentes, criar faixas para dados numéricos e transformar todos os recursos em variáveis numéricas usando .get_dummies() novamente. Por fim, você vai construir o modelo final deste tutorial. Confira nas próximas seções!
Com todas as mudanças feitas no DataFrame data, é bom verificar se ainda restam valores ausentes com .info():
data.info()
<class 'pandas.core.frame.DataFrame'>
Int64Index: 1309 entries, 0 to 417
Data columns (total 9 columns):
Pclass       1309 non-null int64
Sex          1309 non-null object
Age          1046 non-null float64
SibSp        1309 non-null int64
Parch        1309 non-null int64
Fare         1308 non-null float64
Embarked     1307 non-null object
Title        1309 non-null object
Has_Cabin    1309 non-null bool
dtypes: bool(1), float64(2), int64(3), object(3)
memory usage: 133.3+ KB
O resultado mostra valores ausentes em 'Age', 'Fare' e 'Embarked'.
Lembre-se: dá para ver isso comparando o total de entradas (1309) com o número de valores não nulos listados por .info(). Aqui, 'Age' tem 1046 valores não nulos (263 ausentes). 'Fare' tem apenas um ausente e 'Embarked' tem dois.
Como no tutorial anterior, vamos imputar esses valores com .fillna():
Observação: usaremos a mediana para preencher 'Age' e 'Fare' por ser mais robusta a outliers. Outras opções são média ou moda.
Os dois valores ausentes de 'Embarked' serão preenchidos com 'S' (Southampton), o valor mais comum na coluna.
Dica: confirme isso fazendo um pouco mais de análise exploratória!
# Impute missing values for Age, Fare, Embarked
data['Age'] = data.Age.fillna(data.Age.median())
data['Fare'] = data.Fare.fillna(data.Fare.median())
data['Embarked'] = data['Embarked'].fillna('S')
data.info()
<class 'pandas.core.frame.DataFrame'>
Int64Index: 1309 entries, 0 to 417
Data columns (total 9 columns):
Pclass       1309 non-null int64
Sex          1309 non-null object
Age          1309 non-null float64
SibSp        1309 non-null int64
Parch        1309 non-null int64
Fare         1309 non-null float64
Embarked     1309 non-null object
Title        1309 non-null object
Has_Cabin    1309 non-null bool
dtypes: bool(1), float64(2), int64(3), object(3)
memory usage: 133.3+ KB
data.head()
| Pclass | Sex | Age | SibSp | Parch | Fare | Embarked | Title | Has_Cabin | |
|---|---|---|---|---|---|---|---|---|---|
| 0 | 3 | male | 22.0 | 1 | 0 | 7.2500 | S | Mr | False |
| 1 | 1 | female | 38.0 | 1 | 0 | 71.2833 | C | Mrs | True |
| 2 | 3 | female | 26.0 | 0 | 0 | 7.9250 | S | Miss | False |
| 3 | 1 | female | 35.0 | 1 | 0 | 53.1000 | S | Mrs | True |
| 4 | 3 | male | 35.0 | 0 | 0 | 8.0500 | S | Mr | False |
Agora vamos discretizar os dados numéricos, pois há uma faixa contínua de idades e tarifas. Pode haver flutuações que não refletem padrões reais e apenas ruído. Por isso, colocaremos pessoas dentro de determinadas faixas de idade ou tarifa no mesmo bin. Use a função qcut() do pandas para isso:
# Binning numerical columns
data['CatAge'] = pd.qcut(data.Age, q=4, labels=False )
data['CatFare']= pd.qcut(data.Fare, q=4, labels=False)
data.head()
| Pclass | Sex | Age | SibSp | Parch | Fare | Embarked | Title | Has_Cabin | CatAge | CatFare | |
|---|---|---|---|---|---|---|---|---|---|---|---|
| 0 | 3 | male | 22.0 | 1 | 0 | 7.2500 | S | Mr | False | 0 | 0 |
| 1 | 1 | female | 38.0 | 1 | 0 | 71.2833 | C | Mrs | True | 3 | 3 |
| 2 | 3 | female | 26.0 | 0 | 0 | 7.9250 | S | Miss | False | 1 | 1 |
| 3 | 1 | female | 35.0 | 1 | 0 | 53.1000 | S | Mrs | True | 2 | 3 |
| 4 | 3 | male | 35.0 | 0 | 0 | 8.0500 | S | Mr | False | 2 | 1 |
Observação: passamos as séries data.Age e data.Fare, definimos o número de quantis q=4 e usamos labels=False para codificar os bins como números.
Com as informações discretizadas, podemos remover as colunas 'Age' e 'Fare'. Não esqueça de conferir as primeiras linhas!
data = data.drop(['Age', 'Fare'], axis=1)
data.head()
| Pclass | Sex | SibSp | Parch | Embarked | Title | Has_Cabin | CatAge | CatFare | |
|---|---|---|---|---|---|---|---|---|---|
| 0 | 3 | male | 1 | 0 | S | Mr | False | 0 | 0 |
| 1 | 1 | female | 1 | 0 | C | Mrs | True | 3 | 3 |
| 2 | 3 | female | 0 | 0 | S | Miss | False | 1 | 1 |
| 3 | 1 | female | 1 | 0 | S | Mrs | True | 2 | 3 |
| 4 | 3 | male | 0 | 0 | S | Mr | False | 2 | 1 |
Outra ideia é criar uma nova coluna com o número de membros da família que estavam a bordo do Titanic. Neste tutorial, não vamos usá-la para avaliar o desempenho do modelo. Se quiser testar, execute a linha abaixo:
# Create column of number of Family members onboard
data['Fam_Size'] = data.Parch + data.SibSp
Por enquanto, vamos apenas remover as colunas 'SibSp' e 'Parch' do DataFrame:
# Drop columns
data = data.drop(['SibSp','Parch'], axis=1)
data.head()
| Pclass | Sex | Embarked | Title | Has_Cabin | CatAge | CatFare | |
|---|---|---|---|---|---|---|---|
| 0 | 3 | male | S | Mr | False | 0 | 0 |
| 1 | 1 | female | C | Mrs | True | 3 | 3 |
| 2 | 3 | female | S | Miss | False | 1 | 1 |
| 3 | 1 | female | S | Mrs | True | 2 | 3 |
| 4 | 3 | male | S | Mr | False | 2 | 1 |
Agora que você criou recursos como 'Title' e 'Has_Cabin', tratou valores ausentes e discretizou os dados, é hora de transformar tudo em variáveis numéricas. Modelos de machine learning geralmente recebem entradas numéricas.
Como antes, use .get_dummies() para isso:
# Transform into binary variables
data_dum = pd.get_dummies(data, drop_first=True)
data_dum.head()
| Pclass | Has_Cabin | CatAge | CatFare | Sex_male | Embarked_Q | Embarked_S | Title_Miss | Title_Mr | Title_Mrs | Title_Special | |
|---|---|---|---|---|---|---|---|---|---|---|---|
| 0 | 3 | False | 0 | 0 | 1 | 0 | 1 | 0 | 1 | 0 | 0 |
| 1 | 1 | True | 3 | 3 | 0 | 0 | 0 | 0 | 0 | 1 | 0 |
| 2 | 3 | False | 1 | 1 | 0 | 0 | 1 | 1 | 0 | 0 | 0 |
| 3 | 1 | True | 2 | 3 | 0 | 0 | 1 | 0 | 0 | 1 | 0 |
| 4 | 3 | False | 2 | 1 | 1 | 0 | 1 | 0 | 1 | 0 | 0 |
Com tudo pronto, é hora de construir o modelo final!
Como antes, primeiro separe o data novamente em treino e teste. Depois, transforme-os em arrays:
# Split into test.train
data_train = data_dum.iloc[:891]
data_test = data_dum.iloc[891:]

# Transform into arrays for scikit-learn
X = data_train.values
test = data_test.values
y = survived_train.values
Agora, vamos treinar uma árvore de decisão no seu novo dataset com features engenheirados. Para escolher o hiperparâmetro max_depth, vamos usar uma variação do train-test split chamada "validação cruzada".
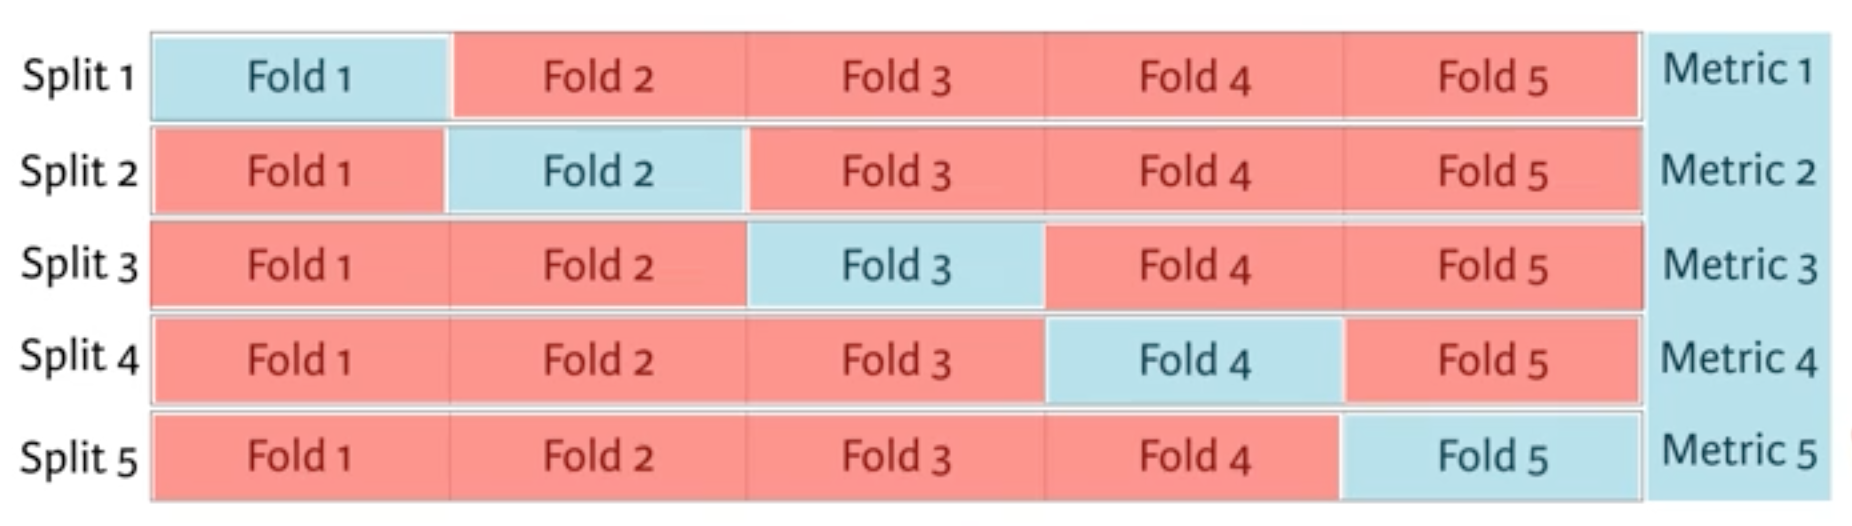
Você começa dividindo o dataset em 5 grupos ou folds. Segura o primeiro fold como teste, ajusta o modelo nos quatro restantes, prevê no teste e calcula a métrica de interesse. Depois, repete segurando o segundo fold, e assim por diante com o terceiro, quarto e quinto.
Como resultado, você obtém cinco valores de acurácia, a partir dos quais pode calcular estatísticas como mediana, média e intervalos de confiança de 95%.
Você faz isso para cada valor de cada hiperparâmetro em ajuste e escolhe o conjunto que tem melhor desempenho. Isso é chamado de grid search.
Chega de teoria, vamos ao que interessa!
No próximo passo, você vai usar validação cruzada e grid search para escolher o melhor max_depth para o seu dataset com features engenheirados:
# Setup the hyperparameter grid
dep = np.arange(1,9)
param_grid = {'max_depth' : dep}

# Instantiate a decision tree classifier: clf
clf = tree.DecisionTreeClassifier()

# Instantiate the GridSearchCV object: clf_cv
clf_cv = GridSearchCV(clf, param_grid=param_grid, cv=5)

# Fit it to the data
clf_cv.fit(X, y)

# Print the tuned parameter and score
print("Tuned Decision Tree Parameters: {}".format(clf_cv.best_params_))
print("Best score is {}".format(clf_cv.best_score_))
Tuned Decision Tree Parameters: {'max_depth': 3}
Best score is 0.8103254769921436
Agora, faça previsões no conjunto de teste, crie a coluna 'Survived' e armazene suas previsões. Não esqueça de salvar as colunas 'PassengerId' e 'Survived' de df_test em um .csv e enviar ao Kaggle!
Y_pred = clf_cv.predict(test)
df_test['Survived'] = Y_pred
df_test[['PassengerId', 'Survived']].to_csv('data/predictions/dec_tree_feat_eng.csv', index=False)
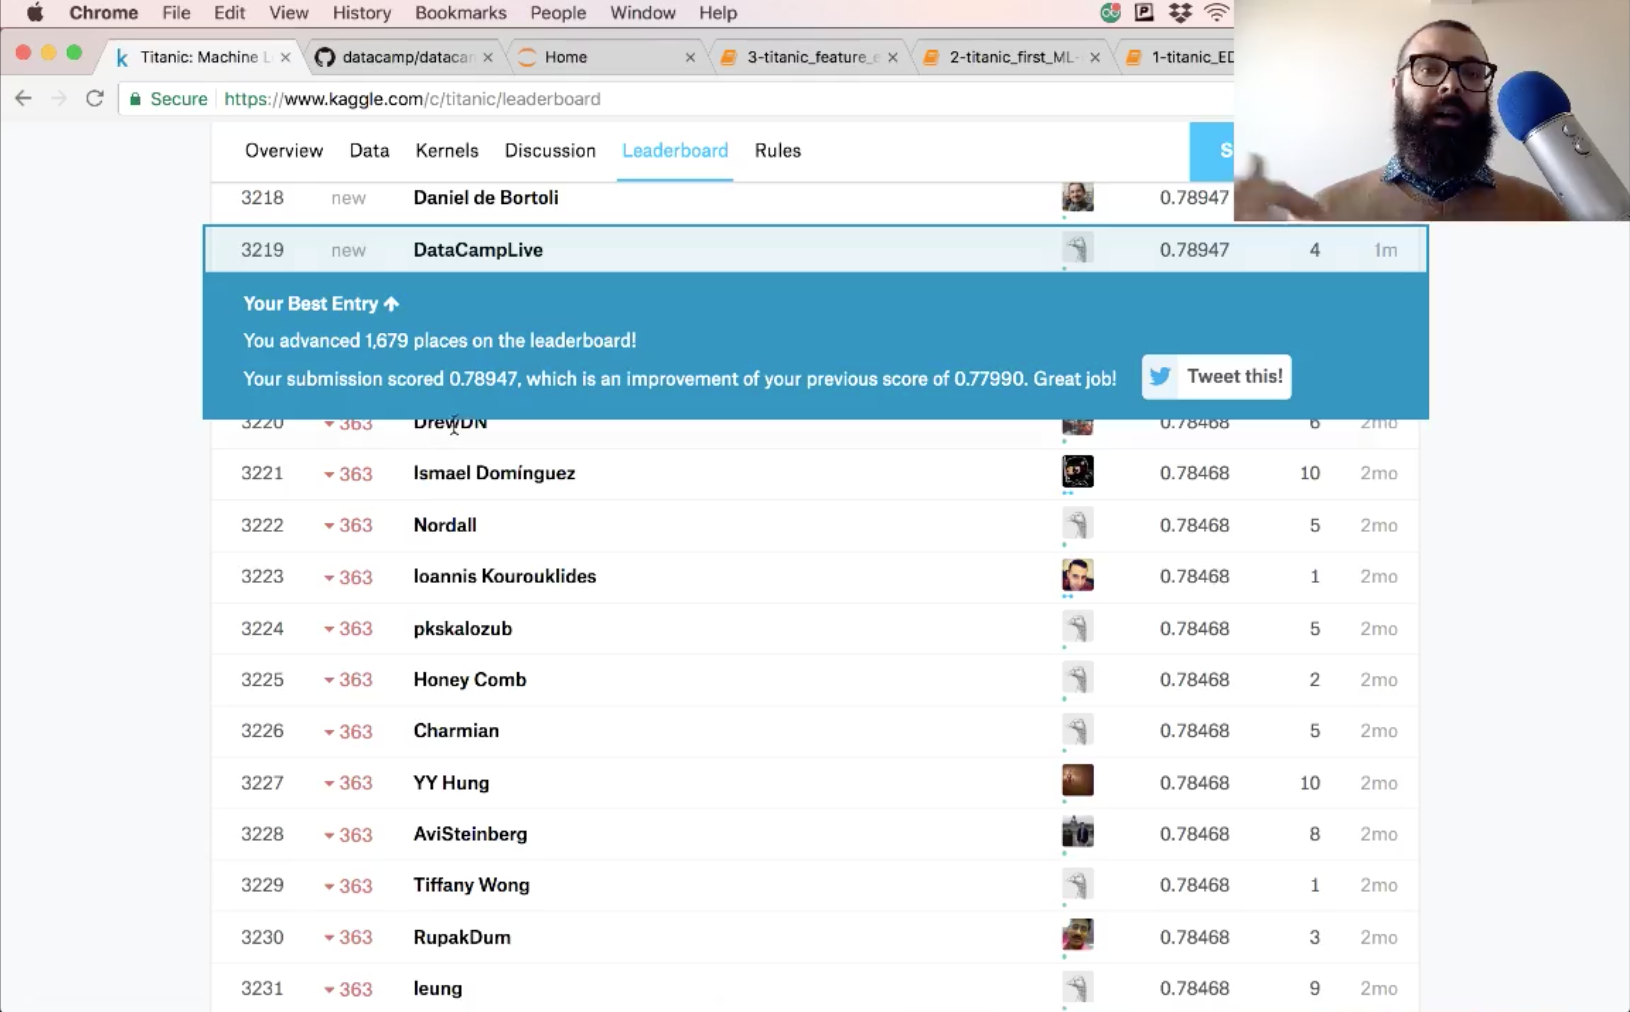
A acurácia do seu envio é 78,9.
Veja se você consegue fazer mais feature engineering e testar novos modelos para melhorar essa pontuação. Este notebook, junto com os dois anteriores, está no GitHub. Seria ótimo ver você aprimorando esses modelos.
Há muito mais pré-processamento para aprender, como escalonamento dos dados. Os pipelines do scikit-learn também são super úteis. Confira nosso curso Supervised Learning with scikit-learn e a documentação do scikit-learn para isso e muito mais.
Cursos de machine learning
Curso
Curso
Curso
blog
Çağlar Uslu
15 min
blog
Abid Ali Awan
11 min
Tutorial
Moez Ali
14 min
Tutorial
Kevin Babitz
8 min
Tutorial
Abid Ali Awan
11 min
Tutorial
Arjun Sarkar
15 min