Khóa học
Tìm hiểu Machine Learning
2 giờ
313.7K
Trong hai hướng dẫn Kaggle trước, bạn đã học cách chuẩn bị dữ liệu để xây dựng mô hình học máy đầu tiên bằng Phân tích Khám phá Dữ liệu và các mô hình học máy nền tảng. Tiếp đó, bạn đã xây dựng mô hình học máy đầu tiên, một bộ phân loại cây quyết định. Bạn đã nộp tất cả các mô hình này lên Kaggle và diễn giải độ chính xác của chúng.
Trong hướng dẫn thứ ba này, bạn sẽ tìm hiểu sâu hơn về kỹ thuật đặc trưng, một quy trình trong đó bạn dùng kiến thức miền của dữ liệu để tạo thêm các đặc trưng phù hợp, giúp tăng sức mạnh dự đoán của thuật toán học và khiến mô hình học máy của bạn hoạt động tốt hơn nữa!
Cụ thể hơn,
Trước khi bắt tay vào làm, bạn sẽ import tất cả các thư viện giống như ở hướng dẫn trước, dùng một chút magic của IPython để đảm bảo các hình được hiển thị inline trong Jupyter Notebook và đặt kiểu trực quan hóa. Tiếp theo, bạn import dữ liệu và đảm bảo lưu biến mục tiêu của dữ liệu huấn luyện ở nơi an toàn. Sau đó, bạn gộp tập train và test (ngoại trừ cột 'Survived' của df_train) và lưu kết quả vào data.
Hãy nhớ bạn làm vậy để đảm bảo mọi tiền xử lý bạn thực hiện trên dữ liệu đều được phản ánh ở cả tập train và test!
Cuối cùng, bạn dùng phương thức .info() để xem qua dữ liệu:
# Imports
import pandas as pd
import matplotlib.pyplot as plt
import seaborn as sns
import re
import numpy as np
from sklearn import tree
from sklearn.model_selection import GridSearchCV

# Figures inline and set visualization style
%matplotlib inline
sns.set()

# Import data
df_train = pd.read_csv('data/train.csv')
df_test = pd.read_csv('data/test.csv')

# Store target variable of training data in a safe place
survived_train = df_train.Survived

# Concatenate training and test sets
data = pd.concat([df_train.drop(['Survived'], axis=1), df_test])

# View head
data.info()
<class 'pandas.core.frame.DataFrame'>
Int64Index: 1309 entries, 0 to 417
Data columns (total 11 columns):
PassengerId    1309 non-null int64
Pclass         1309 non-null int64
Name           1309 non-null object
Sex            1309 non-null object
Age            1046 non-null float64
SibSp          1309 non-null int64
Parch          1309 non-null int64
Ticket         1309 non-null object
Fare           1308 non-null float64
Cabin          295 non-null object
Embarked       1307 non-null object
dtypes: float64(2), int64(4), object(5)
memory usage: 122.7+ KBBạn thực hiện kỹ thuật đặc trưng để khai thác thêm thông tin từ dữ liệu, nhằm nâng cao hiệu quả khi xây dựng mô hình.
Hãy xem ví dụ để hiểu rõ hơn. Hãy kiểm tra cột 'Name' với phương thức .tail(), giúp bạn xem 5 hàng cuối của dữ liệu:
# View head of 'Name' column
data.Name.tail()
413              Spector, Mr. Woolf
414    Oliva y Ocana, Dona. Fermina
415    Saether, Mr. Simon Sivertsen
416             Ware, Mr. Frederick
417        Peter, Master. Michael J
Name: Name, dtype: object
Bạn sẽ thấy xuất hiện các danh xưng khác nhau! Nói cách khác, cột này chứa chuỗi văn bản có kèm danh xưng như 'Mr', 'Master' và 'Dona'.
Những danh xưng này cung cấp thông tin về địa vị xã hội, nghề nghiệp, v.v., và cuối cùng có thể liên quan đến khả năng sống sót.
Ban đầu, việc tách tên khỏi danh xưng có vẻ khó, nhưng đừng lo! Hãy nhớ bạn có thể dùng biểu thức chính quy để trích xuất danh xưng và lưu vào cột mới 'Title':
# Extract Title from Name, store in column and plot barplot
data['Title'] = data.Name.apply(lambda x: re.search(' ([A-Z][a-z]+)\.', x).group(1))
sns.countplot(x='Title', data=data);
plt.xticks(rotation=45);
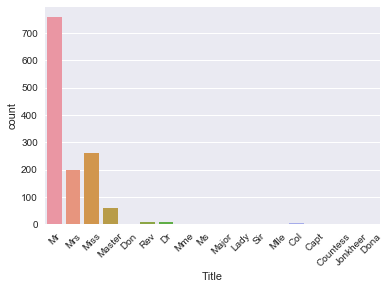
Lưu ý cột 'Title' mới này thực chất là một đặc trưng mới cho bộ dữ liệu của bạn!
Mẹo: để tìm hiểu thêm về biểu thức chính quy, hãy xem bài viết của tôi về sự kiện code along FB Live gần đây hoặc tham khảo Hướng dẫn Biểu thức chính quy trong Python của DataCamp.
Bạn có thể thấy có nhiều danh xưng trong biểu đồ trên và một số ít xuất hiện không thường xuyên. Vì vậy, gom chúng vào ít nhóm hơn là hợp lý.
Ví dụ, bạn có thể muốn thay 'Mlle' và 'Ms' bằng 'Miss' và 'Mme' bằng 'Mrs', vì đây là danh xưng tiếng Pháp và lý tưởng nhất là bạn muốn dữ liệu thống nhất một ngôn ngữ. Tiếp theo, bạn gom một loạt danh xưng khó phân loại ngay vào nhóm 'Special'.
Mẹo: hãy thử nghiệm để xem thuật toán hoạt động ra sao khi thay đổi cách gom nhóm!
Tiếp theo, bạn vẽ biểu đồ cột của kết quả với phương thức .countplot():
data['Title'] = data['Title'].replace({'Mlle':'Miss', 'Mme':'Mrs', 'Ms':'Miss'})
data['Title'] = data['Title'].replace(['Don', 'Dona', 'Rev', 'Dr',
                                            'Major', 'Lady', 'Sir', 'Col', 'Capt', 'Countess', 'Jonkheer'],'Special')
sns.countplot(x='Title', data=data);
plt.xticks(rotation=45);
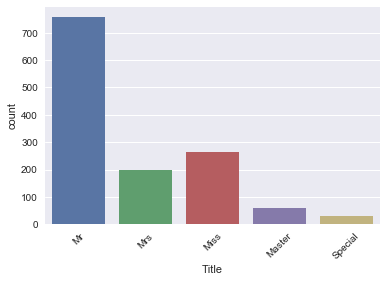
Đây là diện mạo của đặc trưng mới 'Title' của bạn!
Bây giờ, hãy đảm bảo bạn đã có cột 'Title' và xem lại dữ liệu với phương thức .tail():
# View head of data
data.tail()
| PassengerId | Pclass | Name | Sex | Age | SibSp | Parch | Ticket | Fare | Cabin | Embarked | Title | |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 413 | 1305 | 3 | Spector, Mr. Woolf | male | NaN | 0 | 0 | A.5. 3236 | 8.0500 | NaN | S | Mr |
| 414 | 1306 | 1 | Oliva y Ocana, Dona. Fermina | female | 39.0 | 0 | 0 | PC 17758 | 108.9000 | C105 | C | Special |
| 415 | 1307 | 3 | Saether, Mr. Simon Sivertsen | male | 38.5 | 0 | 0 | SOTON/O.Q. 3101262 | 7.2500 | NaN | S | Mr |
| 416 | 1308 | 3 | Ware, Mr. Frederick | male | NaN | 0 | 0 | 359309 | 8.0500 | NaN | S | Mr |
| 417 | 1309 | 3 | Peter, Master. Michael J | male | NaN | 1 | 1 | 2668 | 22.3583 | NaN | C | Master |
Khi nạp dữ liệu và kiểm tra, bạn thấy có nhiều giá trị NaN hoặc khuyết trong cột 'Cabin'.
Có thể suy đoán hợp lý rằng những NaN đó là hành khách không có khoang, điều này có thể cho bạn biết điều gì đó về 'Survival'. Vậy hãy tạo cột mới 'Has_Cabin' để mã hóa thông tin này, cho biết hành khách có khoang hay không.
Lưu ý bạn dùng phương thức .isnull() trong đoạn mã dưới, phương thức sẽ trả về True nếu hành khách không có khoang và False nếu ngược lại. Tuy nhiên, vì bạn muốn lưu kết quả vào cột 'Has_Cabin', bạn muốn đảo kết quả: trả về True nếu hành khách có khoang. Đó là lý do bạn dùng dấu ngã ~.
# Did they have a Cabin?
data['Has_Cabin'] = ~data.Cabin.isnull()

# View head of data
data.head()
| PassengerId | Pclass | Name | Sex | Age | SibSp | Parch | Ticket | Fare | Cabin | Embarked | Title | Has_Cabin | |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 0 | 1 | 3 | Braund, Mr. Owen Harris | male | 22.0 | 1 | 0 | A/5 21171 | 7.2500 | NaN | S | Mr | False |
| 1 | 2 | 1 | Cumings, Mrs. John Bradley (Florence Briggs Th... | female | 38.0 | 1 | 0 | PC 17599 | 71.2833 | C85 | C | Mrs | True |
| 2 | 3 | 3 | Heikkinen, Miss. Laina | female | 26.0 | 0 | 0 | STON/O2. 3101282 | 7.9250 | NaN | S | Miss | False |
| 3 | 4 | 1 | Futrelle, Mrs. Jacques Heath (Lily May Peel) | female | 35.0 | 1 | 0 | 113803 | 53.1000 | C123 | S | Mrs | True |
| 4 | 5 | 3 | Allen, Mr. William Henry | male | 35.0 | 0 | 0 | 373450 | 8.0500 | NaN | S | Mr | False |
Giờ bạn muốn loại bỏ một loạt cột không còn hữu ích (hoặc chưa rõ dùng thế nào). Ở đây, bạn đang xem các cột như ['Cabin', 'Name', 'PassengerId', 'Ticket'], bởi vì
'Has_Cabin' mới;'Name';'PassengerId' và 'Ticket' vì nhiều khả năng chúng không cho biết thêm điều gì về khả năng sống sót của hành khách Titanic.Mẹo có thể vẫn còn thông tin trong cột 'Cabin', nhưng trong hướng dẫn này, bạn giả định là không có!
Để xóa các cột này trong DataFrame data, hãy dùng tham số inplace của phương thức .drop() và đặt là True:
# Drop columns and view head
data.drop(['Cabin', 'Name', 'PassengerId', 'Ticket'], axis=1, inplace=True)
data.head()
| Pclass | Sex | Age | SibSp | Parch | Fare | Embarked | Title | Has_Cabin | |
|---|---|---|---|---|---|---|---|---|---|
| 0 | 3 | male | 22.0 | 1 | 0 | 7.2500 | S | Mr | False |
| 1 | 1 | female | 38.0 | 1 | 0 | 71.2833 | C | Mrs | True |
| 2 | 3 | female | 26.0 | 0 | 0 | 7.9250 | S | Miss | False |
| 3 | 1 | female | 35.0 | 1 | 0 | 53.1000 | S | Mrs | True |
| 4 | 3 | male | 35.0 | 0 | 0 | 8.0500 | S | Mr | False |
Chúc mừng! Bạn đã tạo thành công một số đặc trưng mới như 'Title' và 'Has_Cabin' và đảm bảo các đặc trưng không còn hữu ích cho mô hình đã được loại khỏi DataFrame!
Tiếp theo, bạn sẽ xử lý giá trị khuyết, phân lớp (bin) dữ liệu số, và biến đổi tất cả đặc trưng thành biến số bằng .get_dummies(). Cuối cùng, bạn sẽ xây dựng mô hình cuối cùng cho hướng dẫn này. Xem cách thực hiện trong các phần tiếp theo!
Với tất cả thay đổi bạn đã thực hiện trên DataFrame data gốc, tốt nhất là kiểm tra xem còn giá trị khuyết nào không với .info():
data.info()
<class 'pandas.core.frame.DataFrame'>
Int64Index: 1309 entries, 0 to 417
Data columns (total 9 columns):
Pclass       1309 non-null int64
Sex          1309 non-null object
Age          1046 non-null float64
SibSp        1309 non-null int64
Parch        1309 non-null int64
Fare         1308 non-null float64
Embarked     1307 non-null object
Title        1309 non-null object
Has_Cabin    1309 non-null bool
dtypes: bool(1), float64(2), int64(3), object(3)
memory usage: 133.3+ KB
Kết quả cho biết bạn còn giá trị khuyết ở 'Age', 'Fare' và 'Embarked'.
Nhớ rằng bạn có thể nhanh chóng nhận ra điều này bằng cách xem tổng số bản ghi (1309) rồi kiểm tra số lượng giá trị non-null ở các cột mà .info() liệt kê. Ở đây, 'Age' có 1046 giá trị non-null, nghĩa là có 263 giá trị khuyết. Tương tự, 'Fare' chỉ thiếu một giá trị và 'Embarked' thiếu hai giá trị.
Giống như ở hướng dẫn trước, bạn sẽ nội suy (impute) những giá trị khuyết này với .fillna():
Lưu ý một lần nữa, bạn dùng trung vị để điền cho 'Age' và 'Fare' vì trung vị xử lý ngoại lệ tốt. Cách khác để nội suy là dùng trung bình (cộng tất cả điểm dữ liệu rồi chia cho số lượng điểm) hoặc mode (giá trị xuất hiện nhiều nhất).
Bạn điền hai giá trị khuyết trong cột 'Embarked' bằng 'S', viết tắt của Southampton, vì đây là giá trị phổ biến nhất trong cột.
Mẹo: bạn có thể kiểm chứng bằng một chút Phân tích Khám phá Dữ liệu!
# Impute missing values for Age, Fare, Embarked
data['Age'] = data.Age.fillna(data.Age.median())
data['Fare'] = data.Fare.fillna(data.Fare.median())
data['Embarked'] = data['Embarked'].fillna('S')
data.info()
<class 'pandas.core.frame.DataFrame'>
Int64Index: 1309 entries, 0 to 417
Data columns (total 9 columns):
Pclass       1309 non-null int64
Sex          1309 non-null object
Age          1309 non-null float64
SibSp        1309 non-null int64
Parch        1309 non-null int64
Fare         1309 non-null float64
Embarked     1309 non-null object
Title        1309 non-null object
Has_Cabin    1309 non-null bool
dtypes: bool(1), float64(2), int64(3), object(3)
memory usage: 133.3+ KB
data.head()
| Pclass | Sex | Age | SibSp | Parch | Fare | Embarked | Title | Has_Cabin | |
|---|---|---|---|---|---|---|---|---|---|
| 0 | 3 | male | 22.0 | 1 | 0 | 7.2500 | S | Mr | False |
| 1 | 1 | female | 38.0 | 1 | 0 | 71.2833 | C | Mrs | True |
| 2 | 3 | female | 26.0 | 0 | 0 | 7.9250 | S | Miss | False |
| 3 | 1 | female | 35.0 | 1 | 0 | 53.1000 | S | Mrs | True |
| 4 | 3 | male | 35.0 | 0 | 0 | 8.0500 | S | Mr | False |
Tiếp theo, bạn muốn phân lớp dữ liệu số, vì bạn có một dải độ tuổi và giá vé. Tuy nhiên, có thể có những dao động không phản ánh mẫu trong dữ liệu, tức là nhiễu. Đó là lý do bạn sẽ đưa những người trong một khoảng tuổi hoặc giá vé nhất định vào cùng một lớp. Bạn có thể làm điều này bằng hàm qcut() của pandas để phân lớp dữ liệu số:
# Binning numerical columns
data['CatAge'] = pd.qcut(data.Age, q=4, labels=False )
data['CatFare']= pd.qcut(data.Fare, q=4, labels=False)
data.head()
| Pclass | Sex | Age | SibSp | Parch | Fare | Embarked | Title | Has_Cabin | CatAge | CatFare | |
|---|---|---|---|---|---|---|---|---|---|---|---|
| 0 | 3 | male | 22.0 | 1 | 0 | 7.2500 | S | Mr | False | 0 | 0 |
| 1 | 1 | female | 38.0 | 1 | 0 | 71.2833 | C | Mrs | True | 3 | 3 |
| 2 | 3 | female | 26.0 | 0 | 0 | 7.9250 | S | Miss | False | 1 | 1 |
| 3 | 1 | female | 35.0 | 1 | 0 | 53.1000 | S | Mrs | True | 2 | 3 |
| 4 | 3 | male | 35.0 | 0 | 0 | 8.0500 | S | Mr | False | 2 | 1 |
Lưu ý bạn truyền dữ liệu dạng Series, data.Age và data.Fare, sau đó chỉ định số lượng phân vị, q=4. Cuối cùng, bạn đặt tham số labels là False để mã hóa các lớp bằng số.
Giờ khi đã có thông tin trong các lớp, bạn có thể xóa an toàn các cột 'Age' và 'Fare'. Đừng quên kiểm tra 5 hàng đầu tiên của dữ liệu!
data = data.drop(['Age', 'Fare'], axis=1)
data.head()
| Pclass | Sex | SibSp | Parch | Embarked | Title | Has_Cabin | CatAge | CatFare | |
|---|---|---|---|---|---|---|---|---|---|
| 0 | 3 | male | 1 | 0 | S | Mr | False | 0 | 0 |
| 1 | 1 | female | 1 | 0 | C | Mrs | True | 3 | 3 |
| 2 | 3 | female | 0 | 0 | S | Miss | False | 1 | 1 |
| 3 | 1 | female | 1 | 0 | S | Mrs | True | 2 | 3 |
| 4 | 3 | male | 0 | 0 | S | Mr | False | 2 | 1 |
Tiếp theo, bạn có thể tạo một cột mới là số thành viên trong gia đình có mặt trên tàu Titanic. Trong hướng dẫn này, bạn sẽ không đi sâu vào phần này và xem mô hình hoạt động thế nào khi không có nó. Nếu bạn muốn kiểm tra mô hình với cột bổ sung này, hãy chạy dòng mã sau:
# Create column of number of Family members onboard
data['Fam_Size'] = data.Parch + data.SibSp
Hiện tại, bạn sẽ tiếp tục và loại bỏ các cột 'SibSp' và 'Parch' khỏi DataFrame:
# Drop columns
data = data.drop(['SibSp','Parch'], axis=1)
data.head()
| Pclass | Sex | Embarked | Title | Has_Cabin | CatAge | CatFare | |
|---|---|---|---|---|---|---|---|
| 0 | 3 | male | S | Mr | False | 0 | 0 |
| 1 | 1 | female | C | Mrs | True | 3 | 3 |
| 2 | 3 | female | S | Miss | False | 1 | 1 |
| 3 | 1 | female | S | Mrs | True | 2 | 3 |
| 4 | 3 | male | S | Mr | False | 2 | 1 |
Giờ đây bạn đã tạo thêm một số đặc trưng như 'Title' và 'Has_Cabin', xử lý giá trị khuyết, phân lớp dữ liệu số, đã đến lúc biến đổi tất cả biến thành dạng số. Bạn làm vậy vì các mô hình học máy thường nhận đầu vào là số.
Như trước đây, bạn sẽ dùng .get_dummies() để thực hiện:
# Transform into binary variables
data_dum = pd.get_dummies(data, drop_first=True)
data_dum.head()
| Pclass | Has_Cabin | CatAge | CatFare | Sex_male | Embarked_Q | Embarked_S | Title_Miss | Title_Mr | Title_Mrs | Title_Special | |
|---|---|---|---|---|---|---|---|---|---|---|---|
| 0 | 3 | False | 0 | 0 | 1 | 0 | 1 | 0 | 1 | 0 | 0 |
| 1 | 1 | True | 3 | 3 | 0 | 0 | 0 | 0 | 0 | 1 | 0 |
| 2 | 3 | False | 1 | 1 | 0 | 0 | 1 | 1 | 0 | 0 | 0 |
| 3 | 1 | True | 2 | 3 | 0 | 0 | 1 | 0 | 0 | 1 | 0 |
| 4 | 3 | False | 2 | 1 | 1 | 0 | 1 | 0 | 1 | 0 | 0 |
Với mọi thứ đã xong, đã đến lúc xây dựng mô hình cuối cùng!
Như trước, bạn sẽ tách data trở lại thành tập huấn luyện và kiểm tra. Sau đó, bạn biến chúng thành mảng:
# Split into test.train
data_train = data_dum.iloc[:891]
data_test = data_dum.iloc[891:]

# Transform into arrays for scikit-learn
X = data_train.values
test = data_test.values
y = survived_train.values
Bây giờ bạn sẽ xây dựng một cây quyết định trên bộ dữ liệu đã kỹ thuật đặc trưng mới toanh. Để chọn siêu tham số max_depth, bạn sẽ dùng một biến thể của phép chia train-test gọi là "cross validation".
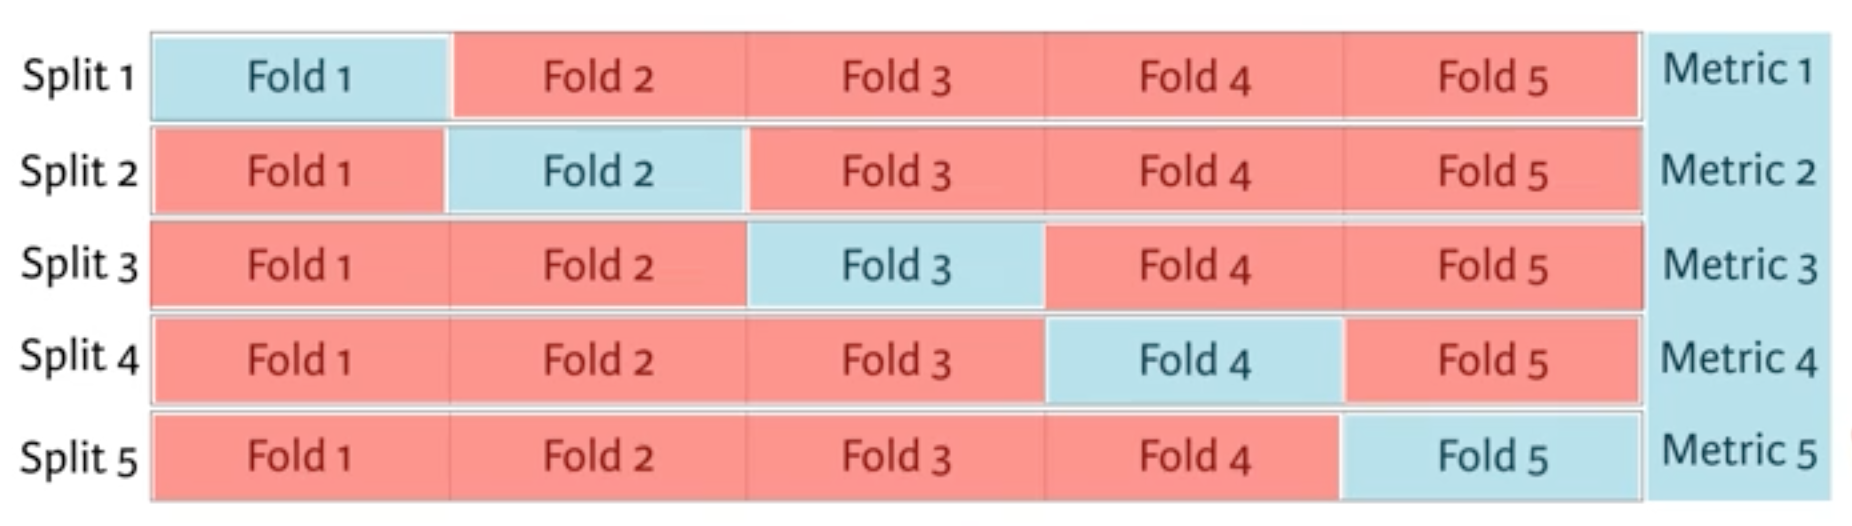
Bạn bắt đầu bằng cách chia bộ dữ liệu thành 5 nhóm hay fold. Sau đó bạn giữ lại fold đầu tiên làm tập kiểm tra, fit mô hình trên bốn fold còn lại, dự đoán trên tập kiểm tra và tính metric quan tâm. Tiếp theo, bạn giữ lại fold thứ hai làm tập kiểm tra, fit trên dữ liệu còn lại, dự đoán và tính metric. Tương tự với fold thứ ba, tư và năm.
Kết quả là bạn có năm giá trị độ chính xác, từ đó có thể tính các thống kê quan tâm như trung vị và/hoặc trung bình và khoảng tin cậy 95%.
Bạn thực hiện điều này cho mỗi giá trị của từng siêu tham số đang tinh chỉnh và chọn bộ siêu tham số hoạt động tốt nhất. Điều này gọi là grid search.
Tạm đủ lý thuyết, bắt tay vào làm thôi!
Trong phần sau, bạn sẽ dùng cross validation và grid search để chọn max_depth tốt nhất cho bộ dữ liệu đã kỹ thuật đặc trưng mới:
# Setup the hyperparameter grid
dep = np.arange(1,9)
param_grid = {'max_depth' : dep}

# Instantiate a decision tree classifier: clf
clf = tree.DecisionTreeClassifier()

# Instantiate the GridSearchCV object: clf_cv
clf_cv = GridSearchCV(clf, param_grid=param_grid, cv=5)

# Fit it to the data
clf_cv.fit(X, y)

# Print the tuned parameter and score
print("Tuned Decision Tree Parameters: {}".format(clf_cv.best_params_))
print("Best score is {}".format(clf_cv.best_score_))
Tuned Decision Tree Parameters: {'max_depth': 3}
Best score is 0.8103254769921436
Bây giờ, bạn có thể dự đoán trên tập kiểm tra, tạo cột 'Survived' và lưu dự đoán vào đó. Đừng quên lưu các cột 'PassengerId' và 'Survived' của df_test thành file .csv và nộp lên Kaggle!
Y_pred = clf_cv.predict(test)
df_test['Survived'] = Y_pred
df_test[['PassengerId', 'Survived']].to_csv('data/predictions/dec_tree_feat_eng.csv', index=False)
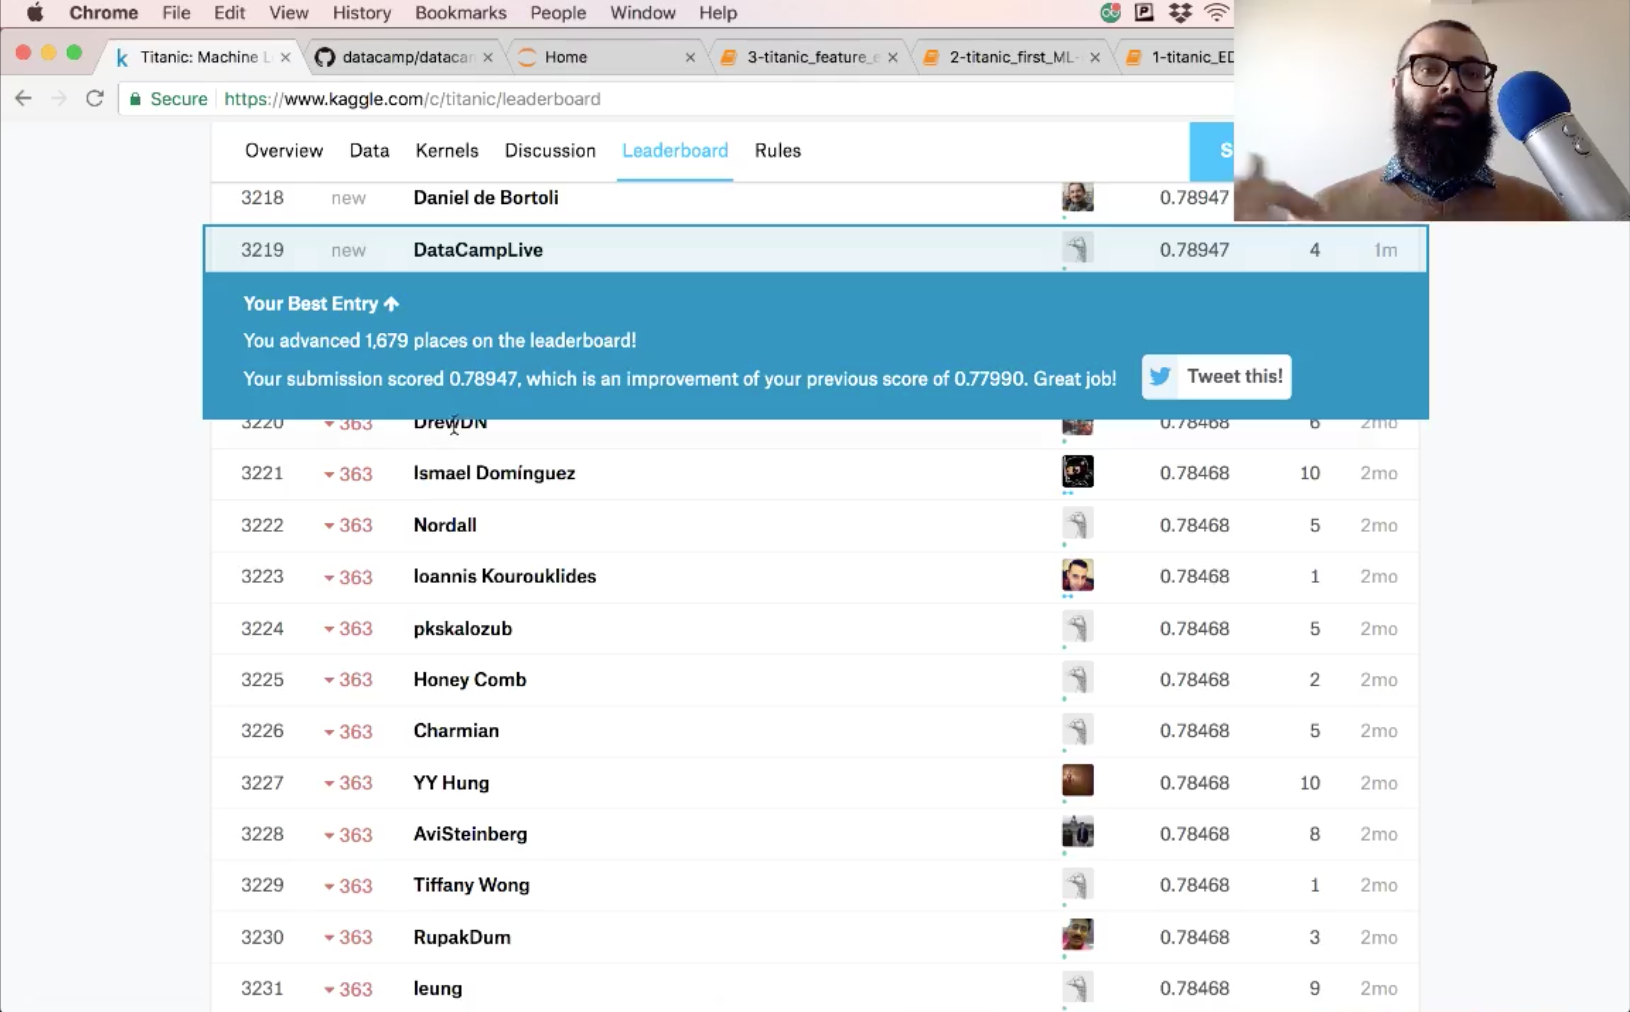
Độ chính xác của bài nộp của bạn là 78,9.
Hãy thử thêm kỹ thuật đặc trưng và thử các mô hình mới để cải thiện điểm số này. Notebook này, cùng với hai notebook trước, được đăng trên GitHub và sẽ thật tuyệt nếu thấy mọi người cải thiện các mô hình này.
Còn rất nhiều bước tiền xử lý khác mà bạn có thể học, như chuẩn hóa dữ liệu. Bạn cũng sẽ thấy pipeline của scikit-learn rất hữu ích. Hãy xem khóa học Học có giám sát với scikit-learn và tài liệu scikit-learn để tìm hiểu tất cả những điều này và hơn thế nữa.
Các khóa học Machine Learning
Khóa học
Khóa học
Khóa học
blog
Matt Crabtree
10 phút
