{count, plural, one {कोर्स} other {कोर्स}}
Understanding Machine Learning
{hours} घंटा
312K
पिछले दो Kaggle ट्यूटोरियल्स में, आपने सीखा कि Exploratory Data Analysis और बेसलाइन मशीन लर्निंग मॉडल्स का उपयोग करके अपने डेटा को पहले मशीन लर्निंग मॉडल के लिए कैसे तैयार किया जाए। इसके बाद, आपने अपना पहला मशीन लर्निंग मॉडल, एक डिसीजन ट्री क्लासिफायर, सफलतापूर्वक बनाया। आपने इन सभी मॉडलों को Kaggle पर सबमिट किया और उनकी एक्यूरेसी को समझा।
इस तीसरे ट्यूटोरियल में, आप फीचर इंजीनियरिंग के बारे में और अधिक सीखेंगे—एक ऐसी प्रक्रिया जिसमें आप अपने डेटा के डोमेन ज्ञान का उपयोग करके अतिरिक्त प्रासंगिक फीचर्स बनाते हैं, जो लर्निंग एल्गोरिद्म की भविष्यवाणी क्षमता बढ़ाते हैं और आपके मशीन लर्निंग मॉडल्स को और बेहतर प्रदर्शन करने में मदद करते हैं!
विशेष रूप से,
शुरू करने से पहले, आप पिछले ट्यूटोरियल की तरह सभी इम्पोर्ट्स करेंगे, Jupyter Notebook में फिगर्स को इनलाइन जेनरेट कराने के लिए कुछ IPython मैजिक का उपयोग करेंगे और विज़ुअलाइज़ेशन स्टाइल सेट करेंगे। इसके बाद, आप अपना डेटा इम्पोर्ट करेंगे और सुनिश्चित करेंगे कि ट्रेनिंग डेटा के टारगेट वेरिएबल को सुरक्षित जगह पर स्टोर किया गया है। फिर, आप ट्रेन और टेस्ट डेटा सेट्स को (सिवाय 'Survived' कॉलम के, जो df_train में है) मर्ज करेंगे और परिणाम को data में स्टोर करेंगे।
याद रखें कि आप यह सब इसलिए करते हैं ताकि आपके द्वारा किए गए किसी भी प्रीप्रोसेसिंग की झलक ट्रेन और टेस्ट दोनों सेट्स में दिखे!
अंत में, आप अपने डेटा पर नज़र डालने के लिए .info() मेथड का उपयोग करेंगे:
# Imports
import pandas as pd
import matplotlib.pyplot as plt
import seaborn as sns
import re
import numpy as np
from sklearn import tree
from sklearn.model_selection import GridSearchCV

# Figures inline and set visualization style
%matplotlib inline
sns.set()

# Import data
df_train = pd.read_csv('data/train.csv')
df_test = pd.read_csv('data/test.csv')

# Store target variable of training data in a safe place
survived_train = df_train.Survived

# Concatenate training and test sets
data = pd.concat([df_train.drop(['Survived'], axis=1), df_test])

# View head
data.info()
<class 'pandas.core.frame.DataFrame'>
Int64Index: 1309 entries, 0 to 417
Data columns (total 11 columns):
PassengerId    1309 non-null int64
Pclass         1309 non-null int64
Name           1309 non-null object
Sex            1309 non-null object
Age            1046 non-null float64
SibSp          1309 non-null int64
Parch          1309 non-null int64
Ticket         1309 non-null object
Fare           1308 non-null float64
Cabin          295 non-null object
Embarked       1307 non-null object
dtypes: float64(2), int64(4), object(5)
memory usage: 122.7+ KBआप फीचर इंजीनियरिंग इसीलिए करते हैं ताकि अपने डेटा से और जानकारी निकाली जा सके, जिससे मॉडल बनाते समय आपका प्रदर्शन बेहतर हो।
आइए एक उदाहरण देखकर समझते हैं। 'Name' कॉलम को .tail() मेथड की मदद से देखें, जो आपके डेटा की अंतिम पाँच पंक्तियाँ दिखाता है:
# View head of 'Name' column
data.Name.tail()
413              Spector, Mr. Woolf
414    Oliva y Ocana, Dona. Fermina
415    Saether, Mr. Simon Sivertsen
416             Ware, Mr. Frederick
417        Peter, Master. Michael J
Name: Name, dtype: object
यहाँ अलग-अलग टाइटल्स दिख रहे हैं! यानी, इस कॉलम में ऐसे स्ट्रिंग्स हैं जिनमें 'Mr', 'Master' और 'Dona' जैसे टाइटल्स शामिल हैं।
ये टाइटल्स सामाजिक स्थिति, पेशे आदि के बारे में जानकारी दे सकते हैं, जो अंततः सर्वाइवल के बारे में कुछ संकेत दे सकते हैं।
पहली नज़र में नामों से टाइटल्स अलग करना मुश्किल लग सकता है, पर घबराएँ नहीं! याद रखें, आप रेगुलर एक्सप्रेशन्स का उपयोग करके आसानी से टाइटल निकालकर उसे नए कॉलम 'Title' में स्टोर कर सकते हैं:
# Extract Title from Name, store in column and plot barplot
data['Title'] = data.Name.apply(lambda x: re.search(' ([A-Z][a-z]+)\.', x).group(1))
sns.countplot(x='Title', data=data);
plt.xticks(rotation=45);
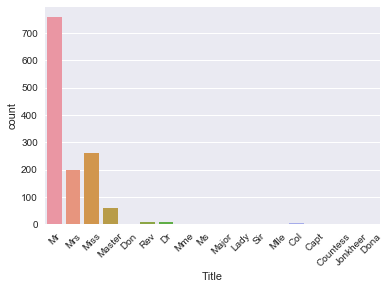
ध्यान दें कि नया कॉलम 'Title' वास्तव में आपके डेटा सेट का नया फीचर है!
टिप: रेगुलर एक्सप्रेशन्स के बारे में और जानने के लिए, मेरा पिछला FB Live कोड-अलॉन्ग इवेंट का लेख देखें या DataCamp का Python Regular Expressions Tutorial देखें।
ऊपर के प्लॉट में कई टाइटल्स हैं, और कुछ बहुत कम बार आते हैं। इसलिए इन्हें कम बकेट्स में रखना समझदारी होगी।
उदाहरण के लिए, आप शायद 'Mlle' और 'Ms' को 'Miss' और 'Mme' को 'Mrs' से बदलना चाहेंगे, क्योंकि ये फ्रेंच टाइटल्स हैं और आदर्श रूप से आप चाहते हैं कि आपका सारा डेटा एक ही भाषा में हो। अगला कदम, वे टाइटल्स जिन्हें आप तुरंत श्रेणीबद्ध नहीं कर पाते, उन्हें 'Special' नाम के बकेट में डाल दें।
टिप: इसके साथ खेलें और देखें कि आपके एल्गोरिद्म का प्रदर्शन इसमें बदलाव के साथ कैसे बदलता है!
अब, .countplot() मेथड की मदद से परिणाम का बारप्लॉट देखें:
data['Title'] = data['Title'].replace({'Mlle':'Miss', 'Mme':'Mrs', 'Ms':'Miss'})
data['Title'] = data['Title'].replace(['Don', 'Dona', 'Rev', 'Dr',
                                            'Major', 'Lady', 'Sir', 'Col', 'Capt', 'Countess', 'Jonkheer'],'Special')
sns.countplot(x='Title', data=data);
plt.xticks(rotation=45);
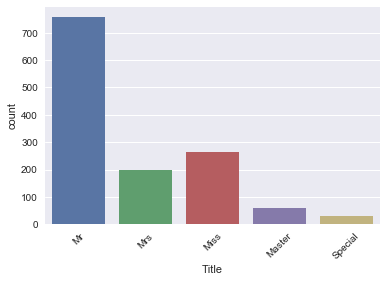
यह है आपका नया इंजीनियर किया हुआ फीचर 'Title'!
अब सुनिश्चित करें कि आपके पास 'Title' कॉलम है और .tail() मेथड से डेटा फिर देखें:
# View head of data
data.tail()
| PassengerId | Pclass | Name | Sex | Age | SibSp | Parch | Ticket | Fare | Cabin | Embarked | Title | |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 413 | 1305 | 3 | Spector, Mr. Woolf | male | NaN | 0 | 0 | A.5. 3236 | 8.0500 | NaN | S | Mr |
| 414 | 1306 | 1 | Oliva y Ocana, Dona. Fermina | female | 39.0 | 0 | 0 | PC 17758 | 108.9000 | C105 | C | Special |
| 415 | 1307 | 3 | Saether, Mr. Simon Sivertsen | male | 38.5 | 0 | 0 | SOTON/O.Q. 3101262 | 7.2500 | NaN | S | Mr |
| 416 | 1308 | 3 | Ware, Mr. Frederick | male | NaN | 0 | 0 | 359309 | 8.0500 | NaN | S | Mr |
| 417 | 1309 | 3 | Peter, Master. Michael J | male | NaN | 1 | 1 | 2668 | 22.3583 | NaN | C | Master |
जब आपने डेटा लोड कर निरीक्षण किया, तो देखा कि 'Cabin' कॉलम में कई NaN या मिसिंग वैल्यूज़ हैं।
यह मानना वाजिब है कि जिनके पास NaN है, उनके पास केबिन नहीं था, जो 'Survival' के बारे में कुछ बता सकता है। तो चलिए, एक नया कॉलम 'Has_Cabin' बनाते हैं जो बताता है कि यात्री के पास केबिन था या नहीं।
ध्यान दें कि आप नीचे दिए गए कोड में .isnull() मेथड का उपयोग करते हैं, जो तब True लौटाता है जब यात्री के पास केबिन नहीं है, और False जब है। लेकिन चूँकि आप परिणाम को 'Has_Cabin' कॉलम में स्टोर करना चाहते हैं, आपको परिणाम को उलटना है: आप True तब चाहते हैं जब यात्री के पास केबिन हो। इसलिए आप टिल्डा ~ का उपयोग करते हैं।
# Did they have a Cabin?
data['Has_Cabin'] = ~data.Cabin.isnull()

# View head of data
data.head()
| PassengerId | Pclass | Name | Sex | Age | SibSp | Parch | Ticket | Fare | Cabin | Embarked | Title | Has_Cabin | |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 0 | 1 | 3 | Braund, Mr. Owen Harris | male | 22.0 | 1 | 0 | A/5 21171 | 7.2500 | NaN | S | Mr | False |
| 1 | 2 | 1 | Cumings, Mrs. John Bradley (Florence Briggs Th... | female | 38.0 | 1 | 0 | PC 17599 | 71.2833 | C85 | C | Mrs | True |
| 2 | 3 | 3 | Heikkinen, Miss. Laina | female | 26.0 | 0 | 0 | STON/O2. 3101282 | 7.9250 | NaN | S | Miss | False |
| 3 | 4 | 1 | Futrelle, Mrs. Jacques Heath (Lily May Peel) | female | 35.0 | 1 | 0 | 113803 | 53.1000 | C123 | S | Mrs | True |
| 4 | 5 | 3 | Allen, Mr. William Henry | male | 35.0 | 0 | 0 | 373450 | 8.0500 | NaN | S | Mr | False |
अब आप वे कॉलम्स हटाना चाहते हैं जिनमें अब कोई उपयोगी जानकारी नहीं बची (या जिनके बारे में पक्का नहीं है कि क्या करना है)। इस मामले में आप ['Cabin', 'Name', 'PassengerId', 'Ticket'] जैसे कॉलम्स देख रहे हैं, क्योंकि
'Has_Cabin' कॉलम में निकाल चुके हैं;'Name' कॉलम से टाइटल्स भी आप निकाल चुके हैं;'PassengerId' और 'Ticket' कॉलम्स भी शायद टाइटैनिक यात्रियों के सर्वाइवल के बारे में और कुछ न बताएं, इसलिए इन्हें भी हटा दें।टिप 'Cabin' कॉलम में और जानकारी हो सकती है, पर इस ट्यूटोरियल के लिए हम मान लेते हैं कि नहीं है!
इन कॉलम्स को अपने वास्तविक data DataFrame से हटाने के लिए, .drop() में inplace आर्गुमेंट का उपयोग करें और उसे True सेट करें:
# Drop columns and view head
data.drop(['Cabin', 'Name', 'PassengerId', 'Ticket'], axis=1, inplace=True)
data.head()
| Pclass | Sex | Age | SibSp | Parch | Fare | Embarked | Title | Has_Cabin | |
|---|---|---|---|---|---|---|---|---|---|
| 0 | 3 | male | 22.0 | 1 | 0 | 7.2500 | S | Mr | False |
| 1 | 1 | female | 38.0 | 1 | 0 | 71.2833 | C | Mrs | True |
| 2 | 3 | female | 26.0 | 0 | 0 | 7.9250 | S | Miss | False |
| 3 | 1 | female | 35.0 | 1 | 0 | 53.1000 | S | Mrs | True |
| 4 | 3 | male | 35.0 | 0 | 0 | 8.0500 | S | Mr | False |
बधाई! आपने 'Title' और 'Has_Cabin' जैसे नए फीचर्स सफलतापूर्वक इंजीनियर कर लिए हैं और वे फीचर्स हटा दिए हैं जो आपके मशीन लर्निंग मॉडल के लिए कोई अतिरिक्त उपयोगी जानकारी नहीं देते थे!
अब आगे आप मिसिंग वैल्यूज़ हैंडल करेंगे, न्यूमेरिकल डेटा को बिन करेंगे, और सभी फीचर्स को फिर से .get_dummies() की मदद से न्यूमेरिक वेरिएबल्स में ट्रांसफॉर्म करेंगे। अंत में, आप इस ट्यूटोरियल के लिए अपना फाइनल मॉडल बनाएंगे। अगले सेक्शंस में देखें यह सब कैसे होता है!
आपने अपने मूल data DataFrame में जो भी बदलाव किए हैं, उनके बाद .info() के जरिए यह देख लेना अच्छा रहेगा कि क्या कोई मिसिंग वैल्यू बची है:
data.info()
<class 'pandas.core.frame.DataFrame'>
Int64Index: 1309 entries, 0 to 417
Data columns (total 9 columns):
Pclass       1309 non-null int64
Sex          1309 non-null object
Age          1046 non-null float64
SibSp        1309 non-null int64
Parch        1309 non-null int64
Fare         1308 non-null float64
Embarked     1307 non-null object
Title        1309 non-null object
Has_Cabin    1309 non-null bool
dtypes: bool(1), float64(2), int64(3), object(3)
memory usage: 133.3+ KB
ऊपर की लाइन का परिणाम बताता है कि 'Age', 'Fare' और 'Embarked' में मिसिंग वैल्यूज़ हैं।
याद रखें आप यह आसानी से ऐसे पकड़ सकते हैं: पहले कुल एंट्रीज़ (1309) देखें और फिर .info() में सूचीबद्ध कॉलम्स में non-null वैल्यूज़ की संख्या देखें। यहाँ 'Age' में 1046 non-null वैल्यूज़ हैं, यानी 263 मिसिंग वैल्यूज़ हैं। इसी तरह, 'Fare' में सिर्फ एक मिसिंग वैल्यू है और 'Embarked' में दो।
पिछले ट्यूटोरियल की तरह, आप .fillna() की मदद से इन मिसिंग वैल्यूज़ को इम्प्यूट करेंगे:
ध्यान दें कि एक बार फिर आप 'Age' और 'Fare' कॉलम्स को भरने के लिए median का उपयोग करते हैं क्योंकि यह आउटलायर्स के साथ बेहतर काम करता है। अन्य तरीकों में mean (सभी डेटा पॉइंट्स का औसत) या mode (जो मान सबसे अधिक बार आता है) शामिल हैं।
'Embarked' कॉलम की दो मिसिंग वैल्यूज़ को आप 'S' से भरते हैं, जो Southampton के लिए है, क्योंकि यह इस कॉलम में सबसे आम मान है।
टिप: इसे आप और EDA करके डबल-चेक कर सकते हैं!
# Impute missing values for Age, Fare, Embarked
data['Age'] = data.Age.fillna(data.Age.median())
data['Fare'] = data.Fare.fillna(data.Fare.median())
data['Embarked'] = data['Embarked'].fillna('S')
data.info()
<class 'pandas.core.frame.DataFrame'>
Int64Index: 1309 entries, 0 to 417
Data columns (total 9 columns):
Pclass       1309 non-null int64
Sex          1309 non-null object
Age          1309 non-null float64
SibSp        1309 non-null int64
Parch        1309 non-null int64
Fare         1309 non-null float64
Embarked     1309 non-null object
Title        1309 non-null object
Has_Cabin    1309 non-null bool
dtypes: bool(1), float64(2), int64(3), object(3)
memory usage: 133.3+ KB
data.head()
| Pclass | Sex | Age | SibSp | Parch | Fare | Embarked | Title | Has_Cabin | |
|---|---|---|---|---|---|---|---|---|---|
| 0 | 3 | male | 22.0 | 1 | 0 | 7.2500 | S | Mr | False |
| 1 | 1 | female | 38.0 | 1 | 0 | 71.2833 | C | Mrs | True |
| 2 | 3 | female | 26.0 | 0 | 0 | 7.9250 | S | Miss | False |
| 3 | 1 | female | 35.0 | 1 | 0 | 53.1000 | S | Mrs | True |
| 4 | 3 | male | 35.0 | 0 | 0 | 8.0500 | S | Mr | False |
अब आप न्यूमेरिकल डेटा को बिन करना चाहेंगे, क्योंकि उम्र और किराए (fare) दोनों रेंज में हैं। इन संख्याओं में ऐसे उतार-चढ़ाव हो सकते हैं जो वास्तविक पैटर्न नहीं बल्कि शोर हों। इसलिए आप एक निश्चित उम्र या किराए की रेंज के लोगों को एक ही बिन में रखेंगे। इसके लिए आप pandas की qcut() फंक्शन का उपयोग कर सकते हैं:
# Binning numerical columns
data['CatAge'] = pd.qcut(data.Age, q=4, labels=False )
data['CatFare']= pd.qcut(data.Fare, q=4, labels=False)
data.head()
| Pclass | Sex | Age | SibSp | Parch | Fare | Embarked | Title | Has_Cabin | CatAge | CatFare | |
|---|---|---|---|---|---|---|---|---|---|---|---|
| 0 | 3 | male | 22.0 | 1 | 0 | 7.2500 | S | Mr | False | 0 | 0 |
| 1 | 1 | female | 38.0 | 1 | 0 | 71.2833 | C | Mrs | True | 3 | 3 |
| 2 | 3 | female | 26.0 | 0 | 0 | 7.9250 | S | Miss | False | 1 | 1 |
| 3 | 1 | female | 35.0 | 1 | 0 | 53.1000 | S | Mrs | True | 2 | 3 |
| 4 | 3 | male | 35.0 | 0 | 0 | 8.0500 | S | Mr | False | 2 | 1 |
ध्यान दें कि आप डेटा को Series के रूप में पास करते हैं, data.Age और data.Fare, फिर quantiles की संख्या q=4 बताते हैं। अंत में, labels आर्गुमेंट को False सेट करते हैं ताकि बिन्स को नंबरों के रूप में एन्कोड किया जाए।
अब जब जानकारी बिन्स में आ गई है, आप 'Age' और 'Fare' कॉलम्स को सुरक्षित रूप से ड्रॉप कर सकते हैं। पहले पाँच रो देखना न भूलें!
data = data.drop(['Age', 'Fare'], axis=1)
data.head()
| Pclass | Sex | SibSp | Parch | Embarked | Title | Has_Cabin | CatAge | CatFare | |
|---|---|---|---|---|---|---|---|---|---|
| 0 | 3 | male | 1 | 0 | S | Mr | False | 0 | 0 |
| 1 | 1 | female | 1 | 0 | C | Mrs | True | 3 | 3 |
| 2 | 3 | female | 0 | 0 | S | Miss | False | 1 | 1 |
| 3 | 1 | female | 1 | 0 | S | Mrs | True | 2 | 3 |
| 4 | 3 | male | 0 | 0 | S | Mr | False | 2 | 1 |
अगला काम आप एक नया कॉलम बनाकर कर सकते हैं, जो टाइटैनिक पर सवार परिवार के सदस्यों की संख्या दिखाता है। इस ट्यूटोरियल में, हम इसे शामिल नहीं करेंगे और देखेंगे कि मॉडल इसके बिना कैसा करता है। यदि आप देखना चाहें कि इस अतिरिक्त कॉलम के साथ मॉडल कैसा करेगा, तो नीचे की लाइन चलाएँ:
# Create column of number of Family members onboard
data['Fam_Size'] = data.Parch + data.SibSp
फिलहाल, आप अपने DataFrame से 'SibSp' और 'Parch' कॉलम्स को हटा देंगे:
# Drop columns
data = data.drop(['SibSp','Parch'], axis=1)
data.head()
| Pclass | Sex | Embarked | Title | Has_Cabin | CatAge | CatFare | |
|---|---|---|---|---|---|---|---|
| 0 | 3 | male | S | Mr | False | 0 | 0 |
| 1 | 1 | female | C | Mrs | True | 3 | 3 |
| 2 | 3 | female | S | Miss | False | 1 | 1 |
| 3 | 1 | female | S | Mrs | True | 2 | 3 |
| 4 | 3 | male | S | Mr | False | 2 | 1 |
अब जब आपने 'Title' और 'Has_Cabin' जैसे कुछ और फीचर्स इंजीनियर कर लिए हैं, मिसिंग वैल्यूज़ संभाल ली हैं, और न्यूमेरिकल डेटा को बिन कर लिया है, तो समय है कि सभी वेरिएबल्स को न्यूमेरिक में बदला जाए। ऐसा इसलिए क्योंकि मशीन लर्निंग मॉडल्स आमतौर पर न्यूमेरिक इनपुट लेते हैं।
जैसा कि आपने पहले किया था, आप .get_dummies() का उपयोग करेंगे:
# Transform into binary variables
data_dum = pd.get_dummies(data, drop_first=True)
data_dum.head()
| Pclass | Has_Cabin | CatAge | CatFare | Sex_male | Embarked_Q | Embarked_S | Title_Miss | Title_Mr | Title_Mrs | Title_Special | |
|---|---|---|---|---|---|---|---|---|---|---|---|
| 0 | 3 | False | 0 | 0 | 1 | 0 | 1 | 0 | 1 | 0 | 0 |
| 1 | 1 | True | 3 | 3 | 0 | 0 | 0 | 0 | 0 | 1 | 0 |
| 2 | 3 | False | 1 | 1 | 0 | 0 | 1 | 1 | 0 | 0 | 0 |
| 3 | 1 | True | 2 | 3 | 0 | 0 | 1 | 0 | 0 | 1 | 0 |
| 4 | 3 | False | 2 | 1 | 1 | 0 | 1 | 0 | 1 | 0 | 0 |
यह सब हो जाने के बाद, अब आपके फाइनल मॉडल का समय है!
पहले की तरह, आप अपने data को फिर से ट्रेनिंग और टेस्ट सेट्स में बाँटेंगे। फिर, उन्हें एरेज़ में बदलेंगे:
# Split into test.train
data_train = data_dum.iloc[:891]
data_test = data_dum.iloc[891:]

# Transform into arrays for scikit-learn
X = data_train.values
test = data_test.values
y = survived_train.values
अब आप अपने बिल्कुल नए फीचर-इंजीनियर किए गए डेटा सेट पर एक डिसीजन ट्री बनाएंगे। अपने हाइपरपैरामीटर max_depth का चुनाव करने के लिए आप "क्रॉस वेलिडेशन" नामक टेस्ट-ट्रेन स्प्लिट का एक रूप इस्तेमाल करेंगे।
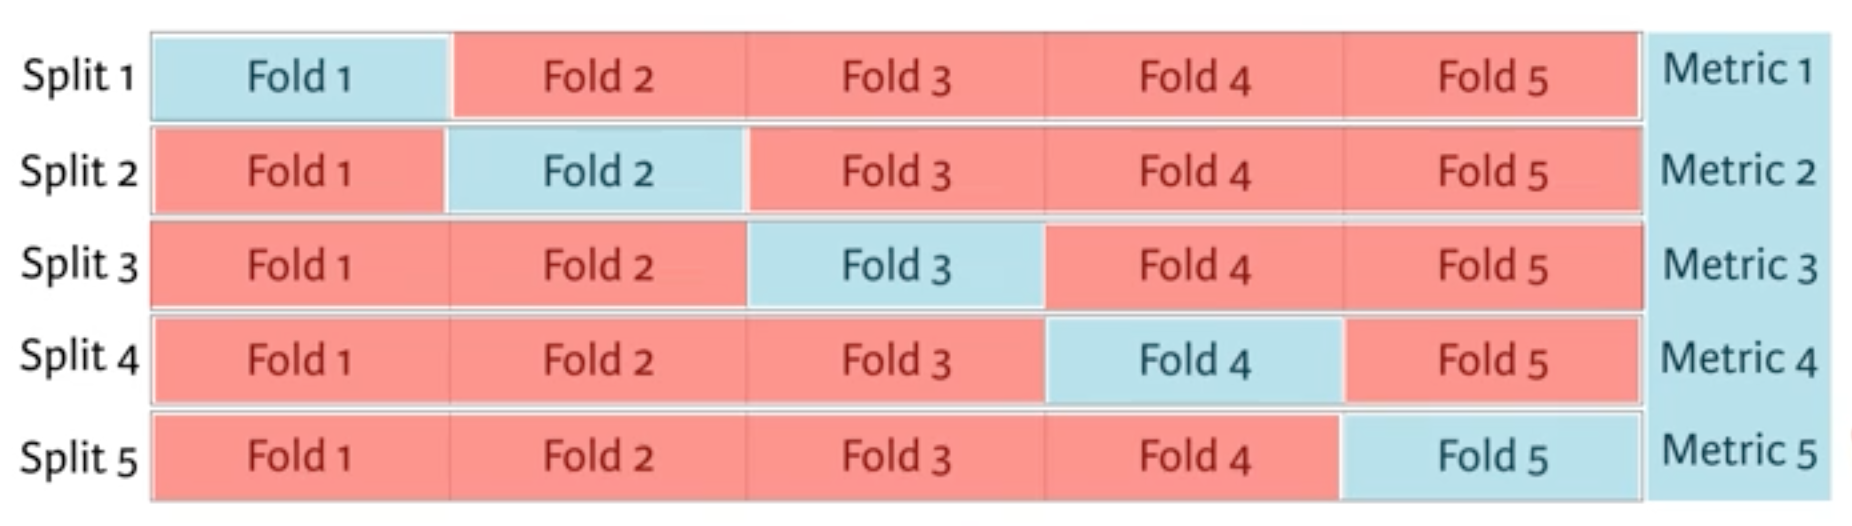
आप डेटा सेट को 5 समूहों या फोल्ड्स में बाँटकर शुरू करते हैं। फिर पहले फोल्ड को टेस्ट सेट की तरह अलग रखते हैं, शेष चार फोल्ड्स पर मॉडल फिट करते हैं, टेस्ट सेट पर प्रेडिक्ट करते हैं और इच्छित मेट्रिक निकालते हैं। अगला, दूसरे फोल्ड को टेस्ट सेट बनाते हैं, बाकी पर फिट करते हैं, टेस्ट पर प्रेडिक्ट करते हैं और मेट्रिक निकालते हैं। इसी तरह तीसरे, चौथे और पाँचवें फोल्ड के साथ।
नतीजतन, आपको एक्यूरेसी के पाँच मान मिलते हैं, जिनसे आप median/mean और 95% कॉन्फिडेंस इंटरवल जैसी सांख्यिकीय सार-सूचनाएँ निकाल सकते हैं।
आप यह प्रक्रिया हर उस हाइपरपैरामीटर के हर मान के लिए करते हैं जिसे आप ट्यून कर रहे हैं, और उस सेट का चुनाव करते हैं जो सबसे अच्छा प्रदर्शन करता है। इसे ग्रिड सर्च कहते हैं।
फिलहाल इतना काफी है—आइए शुरू करें!
अब आप क्रॉस वेलिडेशन और ग्रिड सर्च का उपयोग करके अपने नए फीचर-इंजीनियर किए गए डेटा सेट के लिए सबसे अच्छा max_depth चुनेंगे:
# Setup the hyperparameter grid
dep = np.arange(1,9)
param_grid = {'max_depth' : dep}

# Instantiate a decision tree classifier: clf
clf = tree.DecisionTreeClassifier()

# Instantiate the GridSearchCV object: clf_cv
clf_cv = GridSearchCV(clf, param_grid=param_grid, cv=5)

# Fit it to the data
clf_cv.fit(X, y)

# Print the tuned parameter and score
print("Tuned Decision Tree Parameters: {}".format(clf_cv.best_params_))
print("Best score is {}".format(clf_cv.best_score_))
Tuned Decision Tree Parameters: {'max_depth': 3}
Best score is 0.8103254769921436
अब आप अपने टेस्ट सेट पर प्रेडिक्शंस बना सकते हैं, एक नया कॉलम 'Survived' बना सकते हैं और उसमें अपने प्रेडिक्शंस स्टोर कर सकते हैं। df_test के 'PassengerId' और 'Survived' कॉलम्स को .csv में सेव करना और Kaggle पर सबमिट करना न भूलें!
Y_pred = clf_cv.predict(test)
df_test['Survived'] = Y_pred
df_test[['PassengerId', 'Survived']].to_csv('data/predictions/dec_tree_feat_eng.csv', index=False)
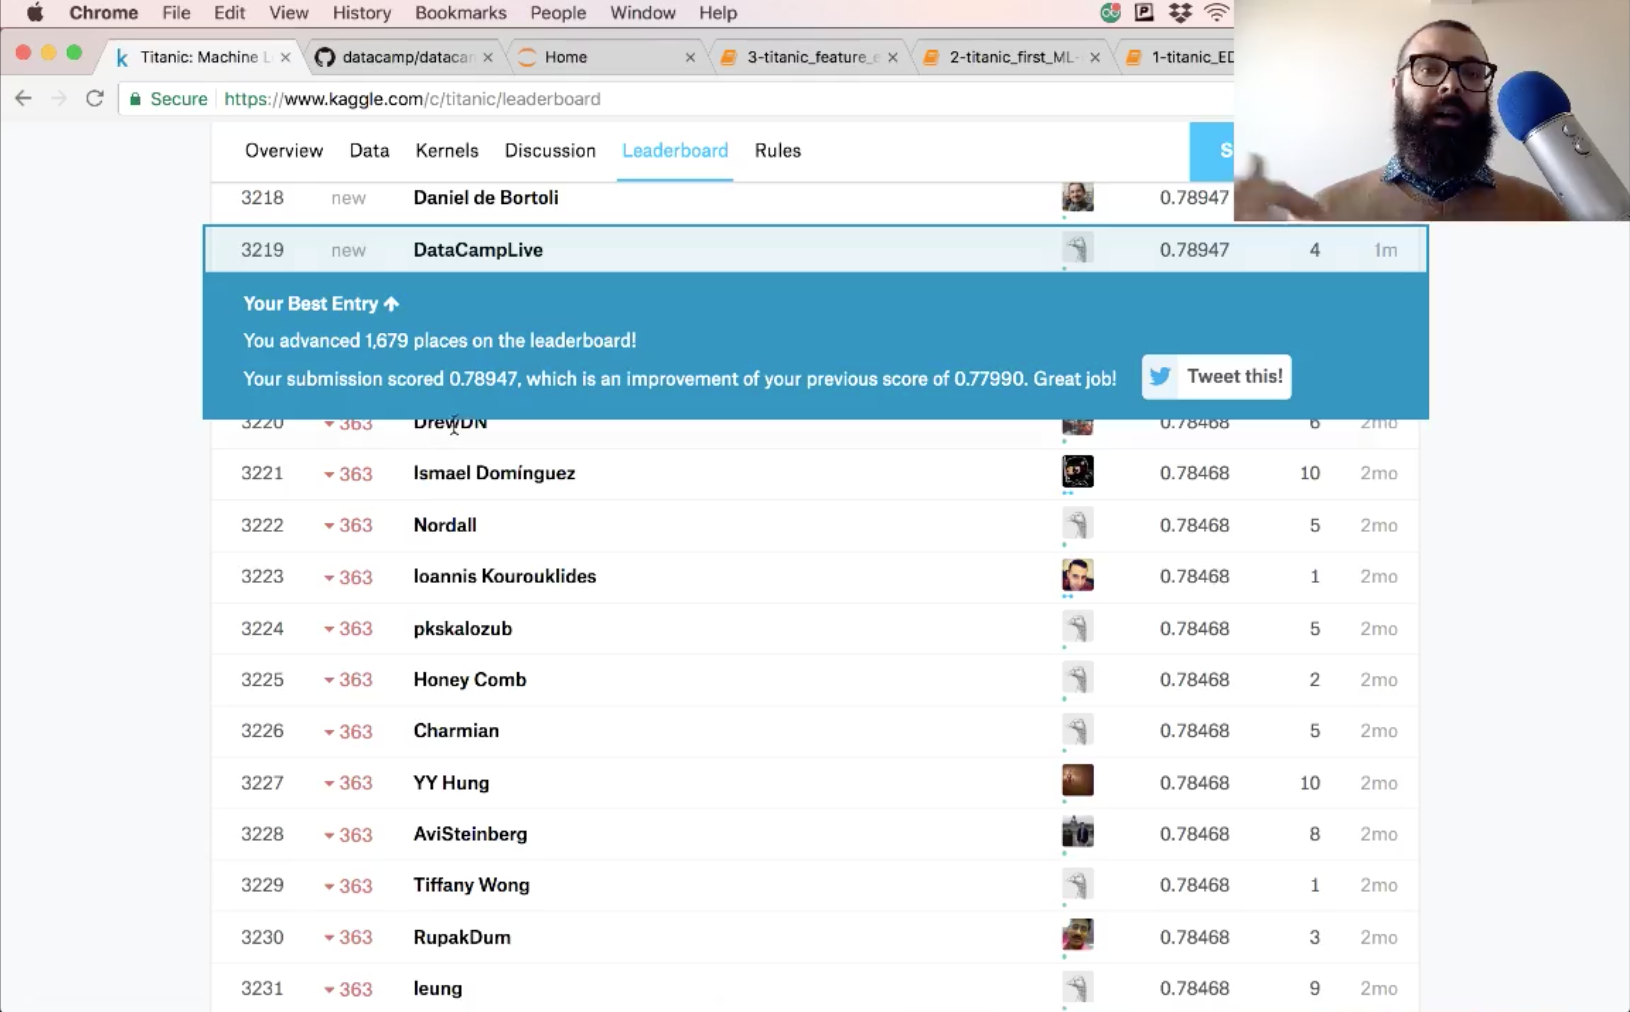
आपके सबमिशन की एक्यूरेसी 78.9 है।
देखें कि क्या आप और फीचर इंजीनियरिंग कर सकते हैं और कुछ नए मॉडल आज़मा सकते हैं, ताकि इस स्कोर में सुधार हो। यह नोटबुक, पिछले दो के साथ, GitHub पर पोस्ट है—आप सभी द्वारा इन मॉडलों में सुधार देखना शानदार होगा।
प्री-प्रोसेसिंग में सीखने के लिए और भी बहुत कुछ है, जैसे डेटा स्केलिंग। आपको scikit-learn पाइपलाइंस भी बेहद उपयोगी लगेंगी। इन सबके लिए हमारा Supervised Learning with scikit-learn कोर्स और scikit-learn डॉक्स देखें।
मशीन लर्निंग कोर्सेज़
{count, plural, one {कोर्स} other {कोर्स}}
{count, plural, one {कोर्स} other {कोर्स}}
{count, plural, one {कोर्स} other {कोर्स}}