Cursus
Inzicht in Machine Learning
2 uur
311.3K
In de twee vorige Kaggle-tutorials heb je geleerd hoe je je data klaarmaakt om je eerste machine learning-model te bouwen, met behulp van Exploratory Data Analysis en baseline-machine learning-modellen. Daarna is het je gelukt om je eerste machine learning-model te bouwen, een decision tree-classifier. Je hebt al deze modellen ingediend bij Kaggle en hun nauwkeurigheid geïnterpreteerd.
In deze derde tutorial leer je meer over feature engineering: een proces waarbij je domeinkennis over je data gebruikt om extra relevante features te creëren die de voorspellende kracht van het leeralgoritme vergroten en je machine learning-modellen nog beter laten presteren!
Specifieker,
Voordat je begint, doe je alle imports, net als in de vorige tutorial, gebruik je wat IPython-magic om ervoor te zorgen dat figuren inline in de Jupyter Notebook worden gegenereerd en stel je de visualisatiestijl in. Vervolgens importeer je je data en zorg je dat je de targetvariabele van de trainingsdata op een veilige plek bewaart. Daarna voeg je de train- en testsets samen (met uitzondering van de 'Survived'-kolom van df_train) en sla je het resultaat op in data.
Onthoud dat je dit doet zodat elke preprocessing die je op de data toepast, terugkomt in zowel de train- als de testset!
Tot slot gebruik je de .info()-methode om een kijkje te nemen in je data:
# Imports
import pandas as pd
import matplotlib.pyplot as plt
import seaborn as sns
import re
import numpy as np
from sklearn import tree
from sklearn.model_selection import GridSearchCV

# Figures inline and set visualization style
%matplotlib inline
sns.set()

# Import data
df_train = pd.read_csv('data/train.csv')
df_test = pd.read_csv('data/test.csv')

# Store target variable of training data in a safe place
survived_train = df_train.Survived

# Concatenate training and test sets
data = pd.concat([df_train.drop(['Survived'], axis=1), df_test])

# View head
data.info()
<class 'pandas.core.frame.DataFrame'>
Int64Index: 1309 entries, 0 to 417
Data columns (total 11 columns):
PassengerId    1309 non-null int64
Pclass         1309 non-null int64
Name           1309 non-null object
Sex            1309 non-null object
Age            1046 non-null float64
SibSp          1309 non-null int64
Parch          1309 non-null int64
Ticket         1309 non-null object
Fare           1308 non-null float64
Cabin          295 non-null object
Embarked       1307 non-null object
dtypes: float64(2), int64(4), object(5)
memory usage: 122.7+ KBJe doet feature engineering om meer informatie uit je data te halen, zodat je je modellen naar een hoger niveau kunt tillen.
Laten we dit verkennen met een voorbeeld. Bekijk de kolom 'Name' met de .tail()-methode, waarmee je de laatste vijf rijen van je data ziet:
# View head of 'Name' column
data.Name.tail()
413              Spector, Mr. Woolf
414    Oliva y Ocana, Dona. Fermina
415    Saether, Mr. Simon Sivertsen
416             Ware, Mr. Frederick
417        Peter, Master. Michael J
Name: Name, dtype: object
Ineens zie je verschillende titels opduiken! Met andere woorden, deze kolom bevat strings of tekst die titels bevatten, zoals 'Mr', 'Master' en 'Dona'.
Die titels geven natuurlijk informatie over sociale status, beroep, enzovoort, wat uiteindelijk iets kan zeggen over overleving.
Op het eerste gezicht lijkt het misschien lastig om de namen van de titels te scheiden, maar geen paniek! Je kunt eenvoudig reguliere expressies gebruiken om de titel te extraheren en op te slaan in een nieuwe kolom 'Title':
# Extract Title from Name, store in column and plot barplot
data['Title'] = data.Name.apply(lambda x: re.search(' ([A-Z][a-z]+)\.', x).group(1))
sns.countplot(x='Title', data=data);
plt.xticks(rotation=45);
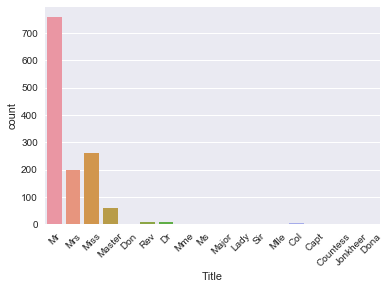
Let op dat deze nieuwe kolom 'Title' feitelijk een nieuwe feature is voor je dataset!
Tip: wil je meer leren over reguliere expressies, bekijk dan mijn verslag van ons laatste FB Live code along-evenement of de Python Regular Expressions Tutorial van DataCamp.
Je ziet in de plot hierboven verschillende titels, waarvan sommige weinig voorkomen. Het is dus logisch om ze te clusteren in minder categorieën.
Zo wil je bijvoorbeeld 'Mlle' en 'Ms' vervangen door 'Miss' en 'Mme' door 'Mrs', omdat dit Franse titels zijn en je idealiter alle data in één taal wilt. Vervolgens neem je een aantal titels die je niet direct kunt categoriseren en zet je ze in een bakje 'Special'.
Tip: experimenteer hiermee en kijk hoe je algoritme presteert als functie daarvan!
Daarna bekijk je een staafdiagram van het resultaat met de methode .countplot():
data['Title'] = data['Title'].replace({'Mlle':'Miss', 'Mme':'Mrs', 'Ms':'Miss'})
data['Title'] = data['Title'].replace(['Don', 'Dona', 'Rev', 'Dr',
                                            'Major', 'Lady', 'Sir', 'Col', 'Capt', 'Countess', 'Jonkheer'],'Special')
sns.countplot(x='Title', data=data);
plt.xticks(rotation=45);
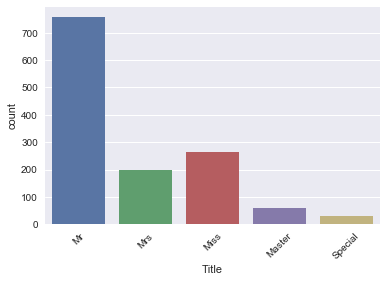
Zo ziet je nieuw geengineerde feature 'Title' eruit!
Controleer nu of je een 'Title'-kolom hebt en bekijk je data opnieuw met de .tail()-methode:
# View head of data
data.tail()
| PassengerId | Pclass | Name | Sex | Age | SibSp | Parch | Ticket | Fare | Cabin | Embarked | Title | |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 413 | 1305 | 3 | Spector, Mr. Woolf | male | NaN | 0 | 0 | A.5. 3236 | 8.0500 | NaN | S | Mr |
| 414 | 1306 | 1 | Oliva y Ocana, Dona. Fermina | female | 39.0 | 0 | 0 | PC 17758 | 108.9000 | C105 | C | Special |
| 415 | 1307 | 3 | Saether, Mr. Simon Sivertsen | male | 38.5 | 0 | 0 | SOTON/O.Q. 3101262 | 7.2500 | NaN | S | Mr |
| 416 | 1308 | 3 | Ware, Mr. Frederick | male | NaN | 0 | 0 | 359309 | 8.0500 | NaN | S | Mr |
| 417 | 1309 | 3 | Peter, Master. Michael J | male | NaN | 1 | 1 | 2668 | 22.3583 | NaN | C | Master |
Toen je de data inlaadde en inspecteerde, zag je dat er meerdere NaN's of missende waarden in de kolom 'Cabin' staan.
Het is redelijk om aan te nemen dat die NaN's geen hut hadden, wat je iets kan vertellen over 'Survival'. Laten we dus een nieuwe kolom 'Has_Cabin' maken die dit encodet en aangeeft of passagiers een hut hadden of niet.
Let op dat je hieronder de methode .isnull() gebruikt, die True teruggeeft als de passagier geen hut heeft en False als dat niet zo is. Maar omdat je het resultaat wilt opslaan in de kolom 'Has_Cabin', wil je het eigenlijk omdraaien: je wilt True teruggeven als de passagier wél een hut heeft. Daarom gebruik je de tilde ~.
# Did they have a Cabin?
data['Has_Cabin'] = ~data.Cabin.isnull()

# View head of data
data.head()
| PassengerId | Pclass | Name | Sex | Age | SibSp | Parch | Ticket | Fare | Cabin | Embarked | Title | Has_Cabin | |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 0 | 1 | 3 | Braund, Mr. Owen Harris | male | 22.0 | 1 | 0 | A/5 21171 | 7.2500 | NaN | S | Mr | False |
| 1 | 2 | 1 | Cumings, Mrs. John Bradley (Florence Briggs Th... | female | 38.0 | 1 | 0 | PC 17599 | 71.2833 | C85 | C | Mrs | True |
| 2 | 3 | 3 | Heikkinen, Miss. Laina | female | 26.0 | 0 | 0 | STON/O2. 3101282 | 7.9250 | NaN | S | Miss | False |
| 3 | 4 | 1 | Futrelle, Mrs. Jacques Heath (Lily May Peel) | female | 35.0 | 1 | 0 | 113803 | 53.1000 | C123 | S | Mrs | True |
| 4 | 5 | 3 | Allen, Mr. William Henry | male | 35.0 | 0 | 0 | 373450 | 8.0500 | NaN | S | Mr | False |
Nu wil je een aantal kolommen laten vallen die geen nuttige informatie meer bevatten (of waarvan we niet weten wat we ermee moeten). In dit geval kijk je naar kolommen zoals ['Cabin', 'Name', 'PassengerId', 'Ticket'], omdat
'Has_Cabin';'Name' hebt gehaald;'PassengerId' en 'Ticket' ook laat vallen omdat die waarschijnlijk niets zinnigs zeggen over de overleving van de Titanic-passagiers.Tip er zou meer informatie in de kolom 'Cabin' kunnen zitten, maar voor deze tutorial gaan we ervan uit van niet!
Om deze kolommen in je data-DataFrame te droppen, gebruik je het argument inplace in de methode .drop() en zet je dat op True:
# Drop columns and view head
data.drop(['Cabin', 'Name', 'PassengerId', 'Ticket'], axis=1, inplace=True)
data.head()
| Pclass | Sex | Age | SibSp | Parch | Fare | Embarked | Title | Has_Cabin | |
|---|---|---|---|---|---|---|---|---|---|
| 0 | 3 | male | 22.0 | 1 | 0 | 7.2500 | S | Mr | False |
| 1 | 1 | female | 38.0 | 1 | 0 | 71.2833 | C | Mrs | True |
| 2 | 3 | female | 26.0 | 0 | 0 | 7.9250 | S | Miss | False |
| 3 | 1 | female | 35.0 | 1 | 0 | 53.1000 | S | Mrs | True |
| 4 | 3 | male | 35.0 | 0 | 0 | 8.0500 | S | Mr | False |
Gefeliciteerd! Je hebt met succes nieuwe features geengineerd zoals 'Title' en 'Has_Cabin' en gezorgd dat features die geen nuttige informatie meer toevoegen voor je machine learning-model nu uit je DataFrame zijn verwijderd!
Vervolgens ga je omgaan met missende waarden, je numerieke data indelen in bins en alle features opnieuw transformeren naar numerieke variabelen met .get_dummies(). Tot slot bouw je je eindmodel voor deze tutorial. Bekijk in de volgende secties hoe je dit allemaal doet!
Met alle wijzigingen die je in je oorspronkelijke data-DataFrame hebt aangebracht, is het een goed idee om met .info() te checken of er nog missende waarden over zijn:
data.info()
<class 'pandas.core.frame.DataFrame'>
Int64Index: 1309 entries, 0 to 417
Data columns (total 9 columns):
Pclass       1309 non-null int64
Sex          1309 non-null object
Age          1046 non-null float64
SibSp        1309 non-null int64
Parch        1309 non-null int64
Fare         1308 non-null float64
Embarked     1307 non-null object
Title        1309 non-null object
Has_Cabin    1309 non-null bool
dtypes: bool(1), float64(2), int64(3), object(3)
memory usage: 133.3+ KB
Hieruit blijkt dat je missende waarden hebt in 'Age', 'Fare' en 'Embarked'.
Onthoud dat je dit makkelijk spot door eerst het totale aantal rijen (1309) te bekijken en daarna te checken hoeveel non-null waarden er in de kolommen staan die .info() laat zien. In dit geval heeft 'Age' 1046 non-null waarden, dus heb je 263 missende waarden. Op dezelfde manier heeft 'Fare' slechts één missende waarde en 'Embarked' twee.
Net als in de vorige tutorial, ga je deze missende waarden imputeren met .fillna():
Let op dat je opnieuw de mediaan gebruikt om de kolommen 'Age' en 'Fare' in te vullen, omdat die goed werkt bij uitschieters. Andere manieren om missende waarden te imputeren zijn het gemiddelde (alle punten optellen en delen door het aantal) of de modus (de meest voorkomende waarde).
De twee missende waarden in de kolom 'Embarked' vul je in met 'S', wat staat voor Southampton, omdat dit de meest voorkomende waarde in deze kolom is.
Tip: je kunt dit dubbelchecken door wat extra Exploratory Data Analysis te doen!
# Impute missing values for Age, Fare, Embarked
data['Age'] = data.Age.fillna(data.Age.median())
data['Fare'] = data.Fare.fillna(data.Fare.median())
data['Embarked'] = data['Embarked'].fillna('S')
data.info()
<class 'pandas.core.frame.DataFrame'>
Int64Index: 1309 entries, 0 to 417
Data columns (total 9 columns):
Pclass       1309 non-null int64
Sex          1309 non-null object
Age          1309 non-null float64
SibSp        1309 non-null int64
Parch        1309 non-null int64
Fare         1309 non-null float64
Embarked     1309 non-null object
Title        1309 non-null object
Has_Cabin    1309 non-null bool
dtypes: bool(1), float64(2), int64(3), object(3)
memory usage: 133.3+ KB
data.head()
| Pclass | Sex | Age | SibSp | Parch | Fare | Embarked | Title | Has_Cabin | |
|---|---|---|---|---|---|---|---|---|---|
| 0 | 3 | male | 22.0 | 1 | 0 | 7.2500 | S | Mr | False |
| 1 | 1 | female | 38.0 | 1 | 0 | 71.2833 | C | Mrs | True |
| 2 | 3 | female | 26.0 | 0 | 0 | 7.9250 | S | Miss | False |
| 3 | 1 | female | 35.0 | 1 | 0 | 53.1000 | S | Mrs | True |
| 4 | 3 | male | 35.0 | 0 | 0 | 8.0500 | S | Mr | False |
Vervolgens wil je de numerieke data in bins indelen, omdat je een reeks leeftijden en prijzen hebt. Er kunnen echter fluctuaties in die getallen zitten die geen patronen weerspiegelen, maar ruis zijn. Daarom zet je mensen binnen een bepaalde range van leeftijd of prijs in dezelfde bin. Dit kan met de pandas-functie qcut():
# Binning numerical columns
data['CatAge'] = pd.qcut(data.Age, q=4, labels=False )
data['CatFare']= pd.qcut(data.Fare, q=4, labels=False)
data.head()
| Pclass | Sex | Age | SibSp | Parch | Fare | Embarked | Title | Has_Cabin | CatAge | CatFare | |
|---|---|---|---|---|---|---|---|---|---|---|---|
| 0 | 3 | male | 22.0 | 1 | 0 | 7.2500 | S | Mr | False | 0 | 0 |
| 1 | 1 | female | 38.0 | 1 | 0 | 71.2833 | C | Mrs | True | 3 | 3 |
| 2 | 3 | female | 26.0 | 0 | 0 | 7.9250 | S | Miss | False | 1 | 1 |
| 3 | 1 | female | 35.0 | 1 | 0 | 53.1000 | S | Mrs | True | 2 | 3 |
| 4 | 3 | male | 35.0 | 0 | 0 | 8.0500 | S | Mr | False | 2 | 1 |
Let op dat je de data als Series doorgeeft, data.Age en data.Fare, waarna je het aantal kwantielen specificeert, q=4. Tot slot zet je het argument labels op False om de bins als nummers te coderen.
Nu je al die informatie in bins hebt, kun je de kolommen 'Age' en 'Fare' veilig laten vallen. Vergeet niet de eerste vijf rijen van je data te bekijken!
data = data.drop(['Age', 'Fare'], axis=1)
data.head()
| Pclass | Sex | SibSp | Parch | Embarked | Title | Has_Cabin | CatAge | CatFare | |
|---|---|---|---|---|---|---|---|---|---|
| 0 | 3 | male | 1 | 0 | S | Mr | False | 0 | 0 |
| 1 | 1 | female | 1 | 0 | C | Mrs | True | 3 | 3 |
| 2 | 3 | female | 0 | 0 | S | Miss | False | 1 | 1 |
| 3 | 1 | female | 1 | 0 | S | Mrs | True | 2 | 3 |
| 4 | 3 | male | 0 | 0 | S | Mr | False | 2 | 1 |
Het volgende dat je kunt doen, is een nieuwe kolom maken met het aantal familieleden dat aan boord van de Titanic was. In deze tutorial gaan we hier niet op in en bekijken we hoe het model presteert zonder deze kolom. Wil je wel zien hoe het model het doet mét deze extra kolom, voer dan de volgende regel code uit:
# Create column of number of Family members onboard
data['Fam_Size'] = data.Parch + data.SibSp
Voor nu gaan we gewoon door en laten we de kolommen 'SibSp' en 'Parch' uit je DataFrame vallen:
# Drop columns
data = data.drop(['SibSp','Parch'], axis=1)
data.head()
| Pclass | Sex | Embarked | Title | Has_Cabin | CatAge | CatFare | |
|---|---|---|---|---|---|---|---|
| 0 | 3 | male | S | Mr | False | 0 | 0 |
| 1 | 1 | female | C | Mrs | True | 3 | 3 |
| 2 | 3 | female | S | Miss | False | 1 | 1 |
| 3 | 1 | female | S | Mrs | True | 2 | 3 |
| 4 | 3 | male | S | Mr | False | 2 | 1 |
Nu je meer features hebt geengineerd, zoals 'Title' en 'Has_Cabin', en je missende waarden hebt afgehandeld en je numerieke data hebt gebind, is het tijd om alle variabelen naar numeriek om te zetten. Dat doe je omdat machine learning-modellen doorgaans numerieke input verwachten.
Zoals je eerder hebt gedaan, gebruik je hiervoor .get_dummies():
# Transform into binary variables
data_dum = pd.get_dummies(data, drop_first=True)
data_dum.head()
| Pclass | Has_Cabin | CatAge | CatFare | Sex_male | Embarked_Q | Embarked_S | Title_Miss | Title_Mr | Title_Mrs | Title_Special | |
|---|---|---|---|---|---|---|---|---|---|---|---|
| 0 | 3 | False | 0 | 0 | 1 | 0 | 1 | 0 | 1 | 0 | 0 |
| 1 | 1 | True | 3 | 3 | 0 | 0 | 0 | 0 | 0 | 1 | 0 |
| 2 | 3 | False | 1 | 1 | 0 | 0 | 1 | 1 | 0 | 0 | 0 |
| 3 | 1 | True | 2 | 3 | 0 | 0 | 1 | 0 | 0 | 1 | 0 |
| 4 | 3 | False | 2 | 1 | 1 | 0 | 1 | 0 | 1 | 0 | 0 |
Met dit alles gedaan is het tijd om je eindmodel te bouwen!
Zoals eerder splits je je data eerst weer op in train- en testset. Daarna zet je ze om naar arrays:
# Split into test.train
data_train = data_dum.iloc[:891]
data_test = data_dum.iloc[891:]

# Transform into arrays for scikit-learn
X = data_train.values
test = data_test.values
y = survived_train.values
Je gaat nu een decision tree bouwen op je gloednieuwe, feature-geengineerde dataset. Om je hyperparameter max_depth te kiezen, gebruik je een variant op train-test split, namelijk "cross-validation".
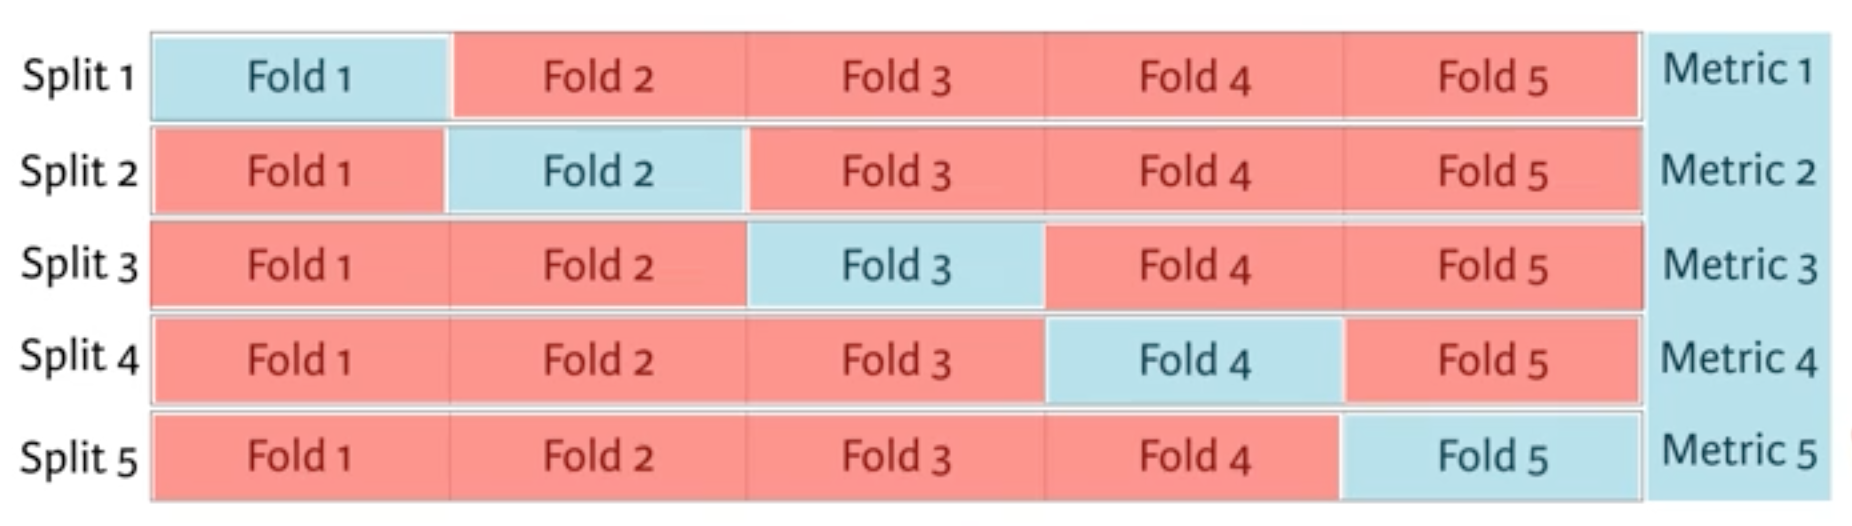
Je splitst de dataset in 5 groepen of folds. Vervolgens houd je de eerste fold apart als testset, fit je je model op de overgebleven vier folds, voorspel je op de testset en bereken je de gewenste metriek. Daarna houd je de tweede fold apart als testset, fit je op de rest, voorspel je op de testset en bereken je de metriek. En zo verder met de derde, vierde en vijfde.
Zo krijg je vijf waarden voor de accuracy, waarvan je statistieken kunt berekenen, zoals de mediaan en/of het gemiddelde en 95%-betrouwbaarheidsintervallen.
Dit doe je voor elke waarde van elke hyperparameter die je afstemt en je kiest de set hyperparameters die het best presteert. Dit heet grid search.
Genoeg theorie, aan de slag!
Hieronder gebruik je cross-validation en grid search om de beste max_depth te kiezen voor je nieuwe feature-geengineerde dataset:
# Setup the hyperparameter grid
dep = np.arange(1,9)
param_grid = {'max_depth' : dep}

# Instantiate a decision tree classifier: clf
clf = tree.DecisionTreeClassifier()

# Instantiate the GridSearchCV object: clf_cv
clf_cv = GridSearchCV(clf, param_grid=param_grid, cv=5)

# Fit it to the data
clf_cv.fit(X, y)

# Print the tuned parameter and score
print("Tuned Decision Tree Parameters: {}".format(clf_cv.best_params_))
print("Best score is {}".format(clf_cv.best_score_))
Tuned Decision Tree Parameters: {'max_depth': 3}
Best score is 0.8103254769921436
Nu kun je voorspellingen maken op je testset, een nieuwe kolom 'Survived' aanmaken en je voorspellingen daarin opslaan. Vergeet niet de kolommen 'PassengerId' en 'Survived' van df_test naar een .csv te schrijven en in te dienen bij Kaggle!
Y_pred = clf_cv.predict(test)
df_test['Survived'] = Y_pred
df_test[['PassengerId', 'Survived']].to_csv('data/predictions/dec_tree_feat_eng.csv', index=False)
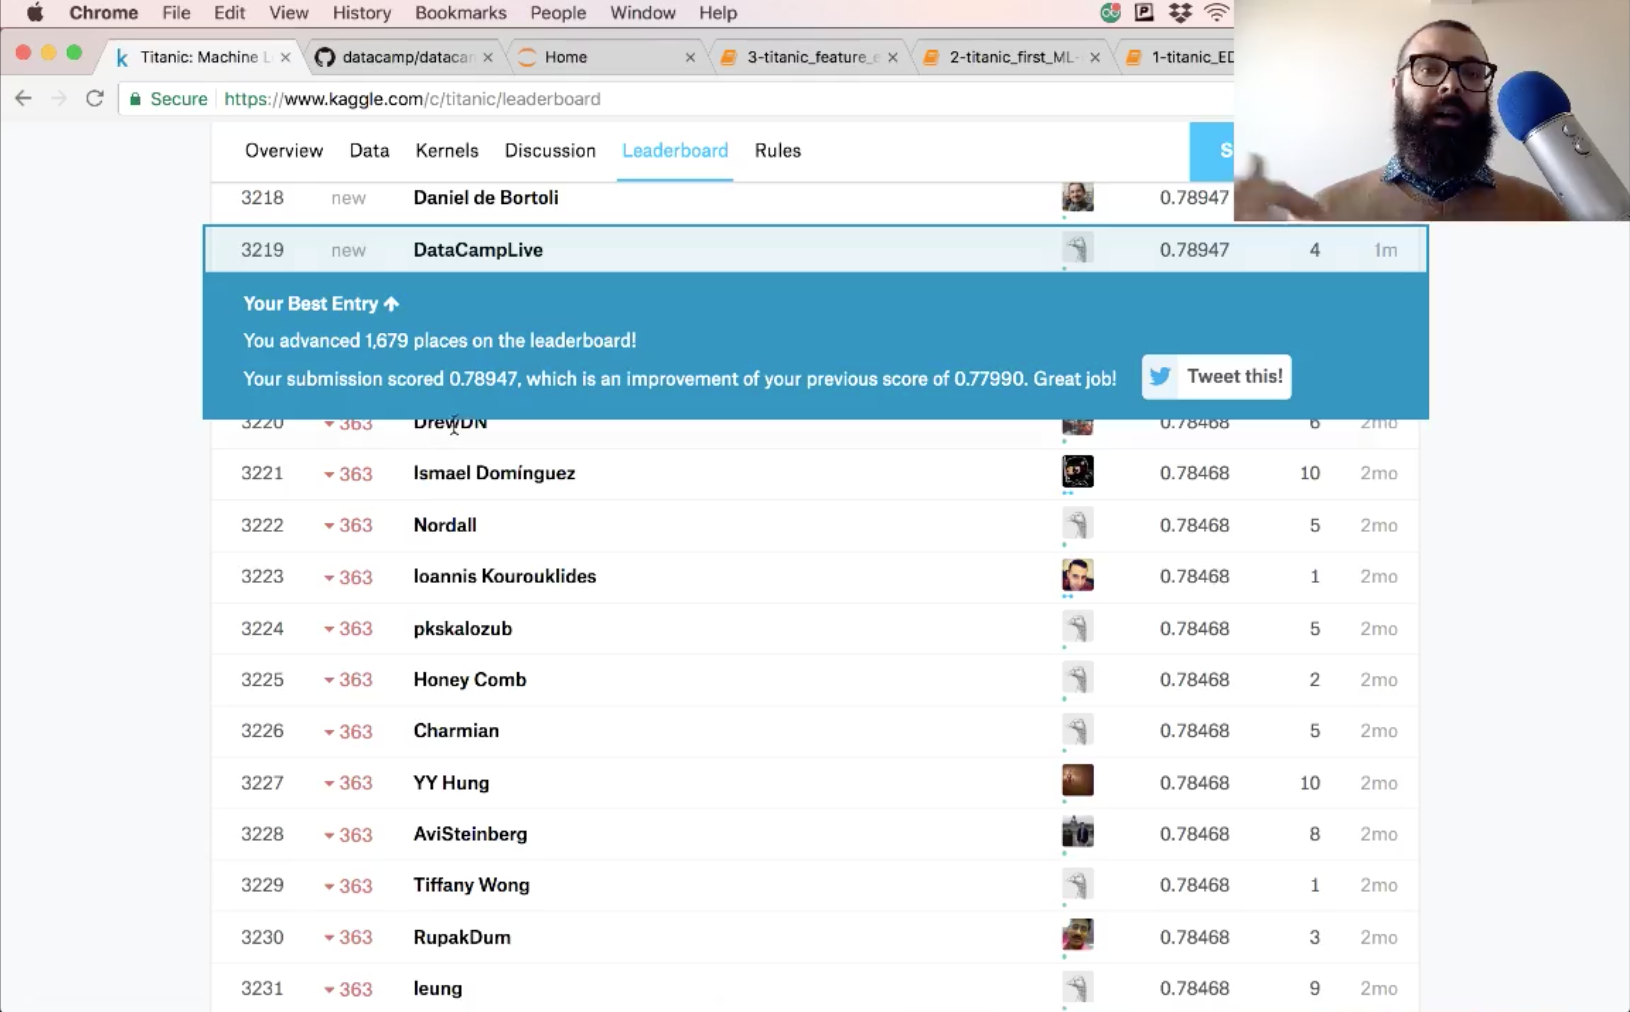
De nauwkeurigheid van je inzending is 78,9.
Kijk of je nog meer feature engineering kunt doen en probeer nieuwe modellen uit om deze score te verbeteren. Deze notebook, samen met de vorige twee, staat op GitHub en het zou geweldig zijn om te zien hoe jullie deze modellen verbeteren.
Er is nog veel meer preprocessing om te leren, zoals het schalen van je data. Ook scikit-learn pipelines zijn superhandig. Bekijk onze cursus Supervised Learning met scikit-learn en de scikit-learn docs voor dit en meer.
Machine learning-cursussen
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min

