Cours
Comprendre le Machine Learning
2 h
308.2K
Dans les deux tutoriels Kaggle précédents, vous avez vu comment préparer vos données pour construire un premier modèle de machine learning, en utilisant l'analyse exploratoire des données et des modèles de base. Ensuite, vous avez réussi à construire votre premier modèle, un arbre de décision. Vous avez envoyé ces modèles sur Kaggle et interprété leur précision.
Dans ce troisième tutoriel, vous allez plus loin avec le feature engineering, c’est-à-dire l’exploitation de votre connaissance métier et du contexte des données pour créer des variables pertinentes supplémentaires, afin d’augmenter le pouvoir prédictif de l’algorithme et d’améliorer les performances de vos modèles !
Plus précisément :
Avant de démarrer, effectuez les imports comme dans le tutoriel précédent, activez la magie IPython pour afficher les figures directement dans le notebook Jupyter et définissez le style de visualisation. Ensuite, importez vos données et mettez de côté la variable cible du jeu d’entraînement. Enfin, fusionnez les jeux d’entraînement et de test (à l’exception de la colonne 'Survived' de df_train) et stockez le tout dans data.
Rappel : vous faites cela pour garantir que tout prétraitement appliqué aux données soit répercuté à la fois sur l’entraînement et le test.
Pour finir, utilisez la méthode .info() pour inspecter vos données :
# Imports
import pandas as pd
import matplotlib.pyplot as plt
import seaborn as sns
import re
import numpy as np
from sklearn import tree
from sklearn.model_selection import GridSearchCV

# Figures inline and set visualization style
%matplotlib inline
sns.set()

# Import data
df_train = pd.read_csv('data/train.csv')
df_test = pd.read_csv('data/test.csv')

# Store target variable of training data in a safe place
survived_train = df_train.Survived

# Concatenate training and test sets
data = pd.concat([df_train.drop(['Survived'], axis=1), df_test])

# View head
data.info()
<class 'pandas.core.frame.DataFrame'>
Int64Index: 1309 entries, 0 to 417
Data columns (total 11 columns):
PassengerId    1309 non-null int64
Pclass         1309 non-null int64
Name           1309 non-null object
Sex            1309 non-null object
Age            1046 non-null float64
SibSp          1309 non-null int64
Parch          1309 non-null int64
Ticket         1309 non-null object
Fare           1308 non-null float64
Cabin          295 non-null object
Embarked       1307 non-null object
dtypes: float64(2), int64(4), object(5)
memory usage: 122.7+ KBLe feature engineering permet d’extraire davantage d’information de vos données afin de gagner en performance lors de la construction de modèles.
Voyons cela avec un exemple. Inspectez la colonne 'Name' avec la méthode .tail(), qui affiche les cinq dernières lignes :
# View head of 'Name' column
data.Name.tail()
413              Spector, Mr. Woolf
414    Oliva y Ocana, Dona. Fermina
415    Saether, Mr. Simon Sivertsen
416             Ware, Mr. Frederick
417        Peter, Master. Michael J
Name: Name, dtype: object
On distingue aussitôt des titres ! Autrement dit, cette colonne contient du texte avec des titres comme « Mr », « Master » ou « Dona ».
Ces titres renseignent sur le statut social, la profession, etc., ce qui peut être lié à la survie.
À première vue, extraire les titres des noms peut sembler complexe, mais pas de panique ! Vous pouvez utiliser des expressions régulières pour extraire le titre et le stocker dans une nouvelle colonne 'Title' :
# Extract Title from Name, store in column and plot barplot
data['Title'] = data.Name.apply(lambda x: re.search(' ([A-Z][a-z]+)\.', x).group(1))
sns.countplot(x='Title', data=data);
plt.xticks(rotation=45);
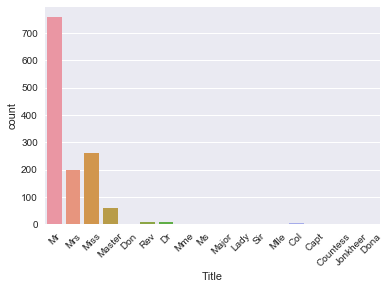
Remarque : cette nouvelle colonne 'Title' constitue bien une nouvelle caractéristique pour votre jeu de données.
Astuce : pour en savoir plus sur les expressions régulières, consultez mon compte rendu de notre dernier FB Live code along ou le tutoriel sur les expressions régulières en Python de DataCamp.
On observe de nombreux titres, dont certains apparaissent très rarement. Il est donc pertinent de les regrouper.
Par exemple, vous pouvez remplacer 'Mlle' et 'Ms' par 'Miss' et 'Mme' par 'Mrs', afin d’uniformiser la langue. Ensuite, regroupez les titres difficiles à catégoriser dans un ensemble 'Special'.
Astuce : testez différentes règles et observez l’impact sur les performances.
Visualisez ensuite le résultat avec .countplot() :
data['Title'] = data['Title'].replace({'Mlle':'Miss', 'Mme':'Mrs', 'Ms':'Miss'})
data['Title'] = data['Title'].replace(['Don', 'Dona', 'Rev', 'Dr',
                                            'Major', 'Lady', 'Sir', 'Col', 'Capt', 'Countess', 'Jonkheer'],'Special')
sns.countplot(x='Title', data=data);
plt.xticks(rotation=45);
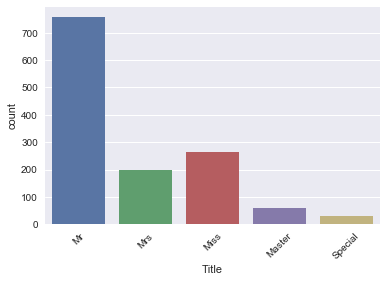
Voici à quoi ressemble votre variable dérivée 'Title' !
Vérifiez maintenant la présence de la colonne 'Title' et réinspectez les données avec .tail() :
# View head of data
data.tail()
| PassengerId | Pclass | Name | Sex | Age | SibSp | Parch | Ticket | Fare | Cabin | Embarked | Title | |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 413 | 1305 | 3 | Spector, Mr. Woolf | male | NaN | 0 | 0 | A.5. 3236 | 8.0500 | NaN | S | Mr |
| 414 | 1306 | 1 | Oliva y Ocana, Dona. Fermina | female | 39.0 | 0 | 0 | PC 17758 | 108.9000 | C105 | C | Special |
| 415 | 1307 | 3 | Saether, Mr. Simon Sivertsen | male | 38.5 | 0 | 0 | SOTON/O.Q. 3101262 | 7.2500 | NaN | S | Mr |
| 416 | 1308 | 3 | Ware, Mr. Frederick | male | NaN | 0 | 0 | 359309 | 8.0500 | NaN | S | Mr |
| 417 | 1309 | 3 | Peter, Master. Michael J | male | NaN | 1 | 1 | 2668 | 22.3583 | NaN | C | Master |
En chargeant et en inspectant les données, vous avez constaté de nombreuses valeurs NaN (manquantes) dans la colonne 'Cabin'.
On peut raisonnablement supposer que ces NaN correspondent à l’absence de cabine, information potentiellement liée à la variable 'Survival'. Créons donc une nouvelle colonne 'Has_Cabin' indiquant si les passagers avaient une cabine.
Remarque : la méthode .isnull() renvoie True si le passager n’a pas de cabine et False sinon. Or, pour 'Has_Cabin', on veut l’inverse : True si une cabine est renseignée. D’où l’utilisation du tilde ~.
# Did they have a Cabin?
data['Has_Cabin'] = ~data.Cabin.isnull()

# View head of data
data.head()
| PassengerId | Pclass | Name | Sex | Age | SibSp | Parch | Ticket | Fare | Cabin | Embarked | Title | Has_Cabin | |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 0 | 1 | 3 | Braund, Mr. Owen Harris | male | 22.0 | 1 | 0 | A/5 21171 | 7.2500 | NaN | S | Mr | False |
| 1 | 2 | 1 | Cumings, Mrs. John Bradley (Florence Briggs Th... | female | 38.0 | 1 | 0 | PC 17599 | 71.2833 | C85 | C | Mrs | True |
| 2 | 3 | 3 | Heikkinen, Miss. Laina | female | 26.0 | 0 | 0 | STON/O2. 3101282 | 7.9250 | NaN | S | Miss | False |
| 3 | 4 | 1 | Futrelle, Mrs. Jacques Heath (Lily May Peel) | female | 35.0 | 1 | 0 | 113803 | 53.1000 | C123 | S | Mrs | True |
| 4 | 5 | 3 | Allen, Mr. William Henry | male | 35.0 | 0 | 0 | 373450 | 8.0500 | NaN | S | Mr | False |
Vous allez maintenant supprimer plusieurs colonnes qui n’apportent plus d’information utile (ou dont l’usage est incertain), à savoir ['Cabin', 'Name', 'PassengerId', 'Ticket'], car :
'Has_Cabin' ;'Name' ;'PassengerId' et 'Ticket' ont peu de chances d’expliquer la survie.Astuce : il peut rester de l’information dans 'Cabin', mais pour ce tutoriel, nous ferons l’impasse.
Pour supprimer ces colonnes dans le DataFrame data, utilisez l’argument inplace=True de .drop() :
# Drop columns and view head
data.drop(['Cabin', 'Name', 'PassengerId', 'Ticket'], axis=1, inplace=True)
data.head()
| Pclass | Sex | Age | SibSp | Parch | Fare | Embarked | Title | Has_Cabin | |
|---|---|---|---|---|---|---|---|---|---|
| 0 | 3 | male | 22.0 | 1 | 0 | 7.2500 | S | Mr | False |
| 1 | 1 | female | 38.0 | 1 | 0 | 71.2833 | C | Mrs | True |
| 2 | 3 | female | 26.0 | 0 | 0 | 7.9250 | S | Miss | False |
| 3 | 1 | female | 35.0 | 1 | 0 | 53.1000 | S | Mrs | True |
| 4 | 3 | male | 35.0 | 0 | 0 | 8.0500 | S | Mr | False |
Bravo ! Vous avez créé de nouvelles variables comme 'Title' et 'Has_Cabin' et retiré celles qui n’apportaient pas de valeur pour votre modèle.
Ensuite, vous allez traiter les valeurs manquantes, discrétiser vos variables numériques et transformer toutes les caractéristiques en variables numériques via .get_dummies(). Enfin, vous construirez le modèle final du tutoriel. Voyez tout cela ci-dessous.
Après ces modifications, vérifiez les valeurs manquantes restantes avec .info() :
data.info()
<class 'pandas.core.frame.DataFrame'>
Int64Index: 1309 entries, 0 to 417
Data columns (total 9 columns):
Pclass       1309 non-null int64
Sex          1309 non-null object
Age          1046 non-null float64
SibSp        1309 non-null int64
Parch        1309 non-null int64
Fare         1308 non-null float64
Embarked     1307 non-null object
Title        1309 non-null object
Has_Cabin    1309 non-null bool
dtypes: bool(1), float64(2), int64(3), object(3)
memory usage: 133.3+ KB
Il reste des valeurs manquantes dans 'Age', 'Fare' et 'Embarked'.
Rappel : comparez le nombre total d’entrées (1309) avec le nombre de valeurs non nulles par colonne. Ici, 'Age' a 1046 valeurs non nulles, soit 263 manquantes. 'Fare' en a une seule manquante et 'Embarked' deux.
Comme dans le tutoriel précédent, vous allez les imputer avec .fillna() :
Remarque : on utilise la médiane pour 'Age' et 'Fare', plus robuste aux valeurs extrêmes. D’autres options existent : moyenne (somme/compte) ou mode (valeur la plus fréquente).
Pour 'Embarked', on remplit les deux valeurs manquantes avec 'S' (Southampton), la modalité la plus fréquente.
Astuce : vous pouvez valider ce choix via une analyse exploratoire.
# Impute missing values for Age, Fare, Embarked
data['Age'] = data.Age.fillna(data.Age.median())
data['Fare'] = data.Fare.fillna(data.Fare.median())
data['Embarked'] = data['Embarked'].fillna('S')
data.info()
<class 'pandas.core.frame.DataFrame'>
Int64Index: 1309 entries, 0 to 417
Data columns (total 9 columns):
Pclass       1309 non-null int64
Sex          1309 non-null object
Age          1309 non-null float64
SibSp        1309 non-null int64
Parch        1309 non-null int64
Fare         1309 non-null float64
Embarked     1309 non-null object
Title        1309 non-null object
Has_Cabin    1309 non-null bool
dtypes: bool(1), float64(2), int64(3), object(3)
memory usage: 133.3+ KB
data.head()
| Pclass | Sex | Age | SibSp | Parch | Fare | Embarked | Title | Has_Cabin | |
|---|---|---|---|---|---|---|---|---|---|
| 0 | 3 | male | 22.0 | 1 | 0 | 7.2500 | S | Mr | False |
| 1 | 1 | female | 38.0 | 1 | 0 | 71.2833 | C | Mrs | True |
| 2 | 3 | female | 26.0 | 0 | 0 | 7.9250 | S | Miss | False |
| 3 | 1 | female | 35.0 | 1 | 0 | 53.1000 | S | Mrs | True |
| 4 | 3 | male | 35.0 | 0 | 0 | 8.0500 | S | Mr | False |
Vous allez ensuite discrétiser l’âge et le prix du billet. Ces variables continues peuvent contenir des fluctuations qui ne reflètent pas des motifs réels (du bruit). En regroupant les valeurs par intervalles (bins), on réduit ce bruit. Utilisez la fonction pandas qcut() :
# Binning numerical columns
data['CatAge'] = pd.qcut(data.Age, q=4, labels=False )
data['CatFare']= pd.qcut(data.Fare, q=4, labels=False)
data.head()
| Pclass | Sex | Age | SibSp | Parch | Fare | Embarked | Title | Has_Cabin | CatAge | CatFare | |
|---|---|---|---|---|---|---|---|---|---|---|---|
| 0 | 3 | male | 22.0 | 1 | 0 | 7.2500 | S | Mr | False | 0 | 0 |
| 1 | 1 | female | 38.0 | 1 | 0 | 71.2833 | C | Mrs | True | 3 | 3 |
| 2 | 3 | female | 26.0 | 0 | 0 | 7.9250 | S | Miss | False | 1 | 1 |
| 3 | 1 | female | 35.0 | 1 | 0 | 53.1000 | S | Mrs | True | 2 | 3 |
| 4 | 3 | male | 35.0 | 0 | 0 | 8.0500 | S | Mr | False | 2 | 1 |
Remarque : vous passez une Series (data.Age, data.Fare), vous fixez le nombre de quantiles avec q=4, et labels=False pour encoder les classes en nombres.
Maintenant que ces informations sont discrétisées, vous pouvez supprimer 'Age' et 'Fare'. N’oubliez pas d’afficher les cinq premières lignes !
data = data.drop(['Age', 'Fare'], axis=1)
data.head()
| Pclass | Sex | SibSp | Parch | Embarked | Title | Has_Cabin | CatAge | CatFare | |
|---|---|---|---|---|---|---|---|---|---|
| 0 | 3 | male | 1 | 0 | S | Mr | False | 0 | 0 |
| 1 | 1 | female | 1 | 0 | C | Mrs | True | 3 | 3 |
| 2 | 3 | female | 0 | 0 | S | Miss | False | 1 | 1 |
| 3 | 1 | female | 1 | 0 | S | Mrs | True | 2 | 3 |
| 4 | 3 | male | 0 | 0 | S | Mr | False | 2 | 1 |
Vous pouvez aussi créer une nouvelle colonne représentant la taille de la famille présente à bord du Titanic. Dans ce tutoriel, nous n’irons pas plus loin et observerons les performances sans cette variable. Si vous souhaitez tester avec, exécutez :
# Create column of number of Family members onboard
data['Fam_Size'] = data.Parch + data.SibSp
Pour l’instant, nous allons simplement supprimer les colonnes 'SibSp' et 'Parch' du DataFrame :
# Drop columns
data = data.drop(['SibSp','Parch'], axis=1)
data.head()
| Pclass | Sex | Embarked | Title | Has_Cabin | CatAge | CatFare | |
|---|---|---|---|---|---|---|---|
| 0 | 3 | male | S | Mr | False | 0 | 0 |
| 1 | 1 | female | C | Mrs | True | 3 | 3 |
| 2 | 3 | female | S | Miss | False | 1 | 1 |
| 3 | 1 | female | S | Mrs | True | 2 | 3 |
| 4 | 3 | male | S | Mr | False | 2 | 1 |
Maintenant que vous avez enrichi vos données (avec 'Title', 'Has_Cabin', etc.), traité les valeurs manquantes et discrétisé les numériques, il est temps de convertir toutes les variables en numérique. Les modèles de machine learning consomment généralement des entrées numériques.
Comme précédemment, utilisez .get_dummies() :
# Transform into binary variables
data_dum = pd.get_dummies(data, drop_first=True)
data_dum.head()
| Pclass | Has_Cabin | CatAge | CatFare | Sex_male | Embarked_Q | Embarked_S | Title_Miss | Title_Mr | Title_Mrs | Title_Special | |
|---|---|---|---|---|---|---|---|---|---|---|---|
| 0 | 3 | False | 0 | 0 | 1 | 0 | 1 | 0 | 1 | 0 | 0 |
| 1 | 1 | True | 3 | 3 | 0 | 0 | 0 | 0 | 0 | 1 | 0 |
| 2 | 3 | False | 1 | 1 | 0 | 0 | 1 | 1 | 0 | 0 | 0 |
| 3 | 1 | True | 2 | 3 | 0 | 0 | 1 | 0 | 0 | 1 | 0 |
| 4 | 3 | False | 2 | 1 | 1 | 0 | 1 | 0 | 1 | 0 | 0 |
Tout est prêt : construisons le modèle final.
Comme précédemment, scindez data en ensembles d’entraînement et de test, puis transformez-les en tableaux :
# Split into test.train
data_train = data_dum.iloc[:891]
data_test = data_dum.iloc[891:]

# Transform into arrays for scikit-learn
X = data_train.values
test = data_test.values
y = survived_train.values
Vous allez entraîner un arbre de décision sur votre jeu de données enrichi. Pour choisir l’hyperparamètre max_depth, vous utiliserez une variante de la séparation entraînement/test appelée « validation croisée ».
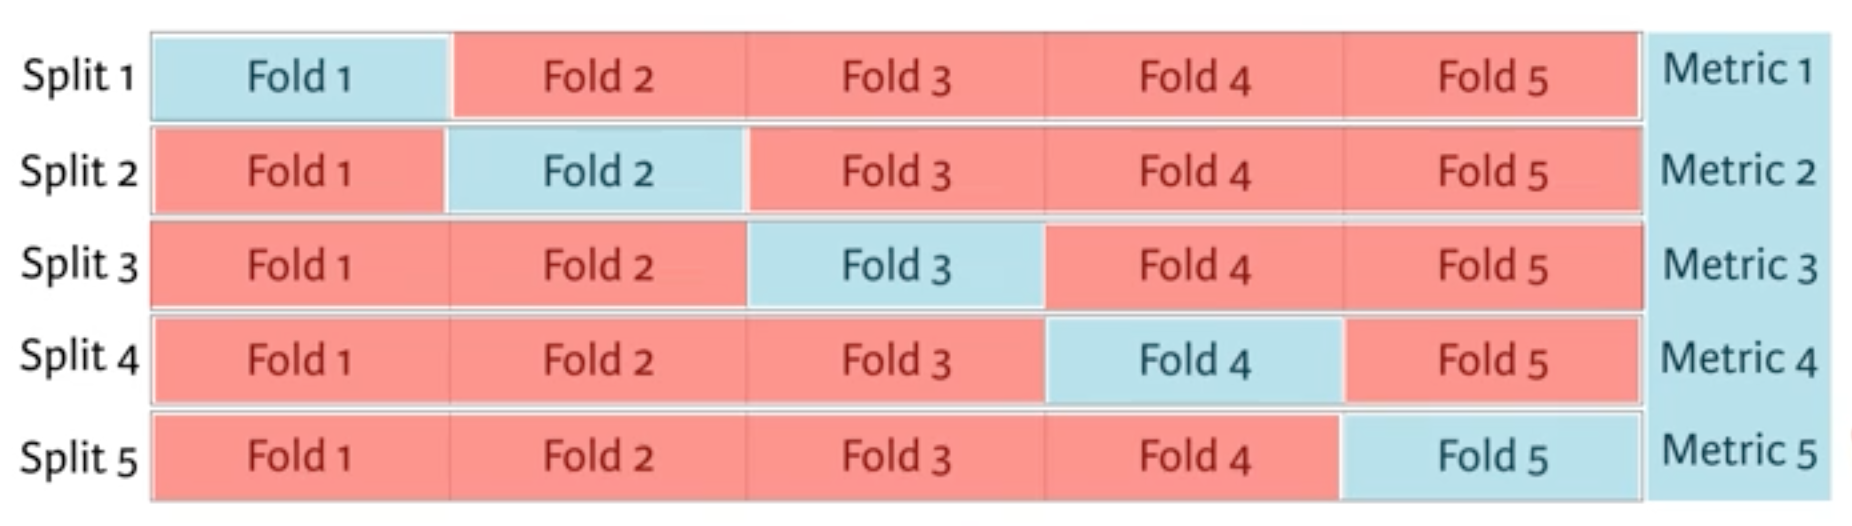
Le principe : vous divisez le jeu en 5 groupes (ou folds). Vous mettez de côté le premier fold comme test, entraînez le modèle sur les quatre restants, prédisez sur le test et calculez la métrique. Puis vous répétez le processus en tenant de côté successivement le 2e, 3e, 4e et 5e fold.
Vous obtenez ainsi cinq valeurs de précision, à partir desquelles calculer moyenne, médiane, voire un intervalle de confiance à 95 %.
Vous répétez l’opération pour chaque combinaison d’hyperparamètres et retenez celle qui performe le mieux : c’est la recherche sur grille (grid search).
Place à la pratique !
Ci-dessous, utilisez validation croisée et grid search pour choisir le meilleur max_depth pour votre jeu de données :
# Setup the hyperparameter grid
dep = np.arange(1,9)
param_grid = {'max_depth' : dep}

# Instantiate a decision tree classifier: clf
clf = tree.DecisionTreeClassifier()

# Instantiate the GridSearchCV object: clf_cv
clf_cv = GridSearchCV(clf, param_grid=param_grid, cv=5)

# Fit it to the data
clf_cv.fit(X, y)

# Print the tuned parameter and score
print("Tuned Decision Tree Parameters: {}".format(clf_cv.best_params_))
print("Best score is {}".format(clf_cv.best_score_))
Tuned Decision Tree Parameters: {'max_depth': 3}
Best score is 0.8103254769921436
Il ne reste plus qu’à prédire sur le jeu de test, créer la colonne 'Survived' et y stocker vos prédictions. N’oubliez pas d’exporter les colonnes 'PassengerId' et 'Survived' de df_test en .csv et de soumettre sur Kaggle !
Y_pred = clf_cv.predict(test)
df_test['Survived'] = Y_pred
df_test[['PassengerId', 'Survived']].to_csv('data/predictions/dec_tree_feat_eng.csv', index=False)
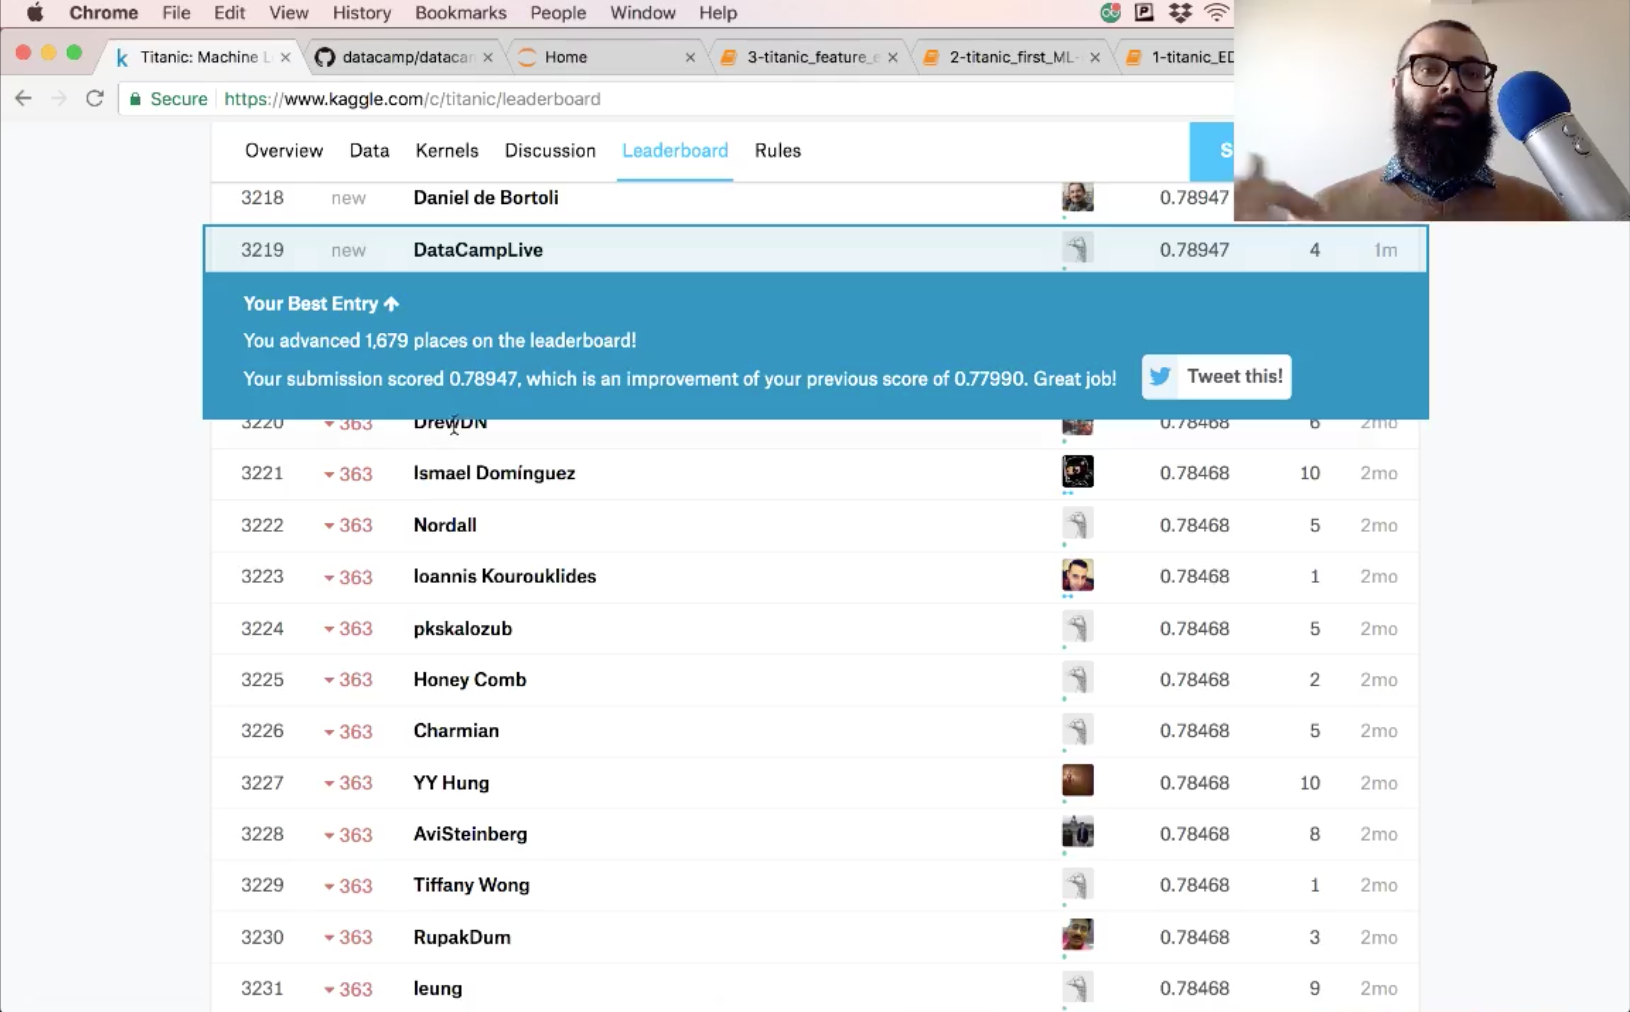
La précision de votre soumission est de 78,9.
Essayez de nouvelles idées de feature engineering et d’autres modèles pour améliorer ce score. Ce notebook, ainsi que les deux précédents, est disponible sur GitHub : nous serions ravis de voir vos améliorations.
Il existe bien d’autres techniques de prétraitement utiles, comme la mise à l’échelle. Les pipelines scikit-learn sont également très pratiques. Découvrez notre cours Supervised Learning with scikit-learn et la documentation scikit-learn pour aller plus loin.
Cours de machine learning
Cours
Cours
Cours